LightOnOCR-3 4B 已在EmpirioLabs上可用。 它是LightOn的文档OCR模型:发送PDF或图片,它以Markdown格式返回每页,文本按阅读顺序、标题、列表、表格、LaTeX数学和图表作为数据点的表格。每个页面还会返回其布局:页面上每个块的类型和位置。它运行于 /v1/ocr后,在API和Playground中。
基准测试。 LightOn 报告称,LightOnOCR-3 4B 的 olmOCR-Bench 整体评分为 86.3 发布公告 2026年10月8日。
内容如下
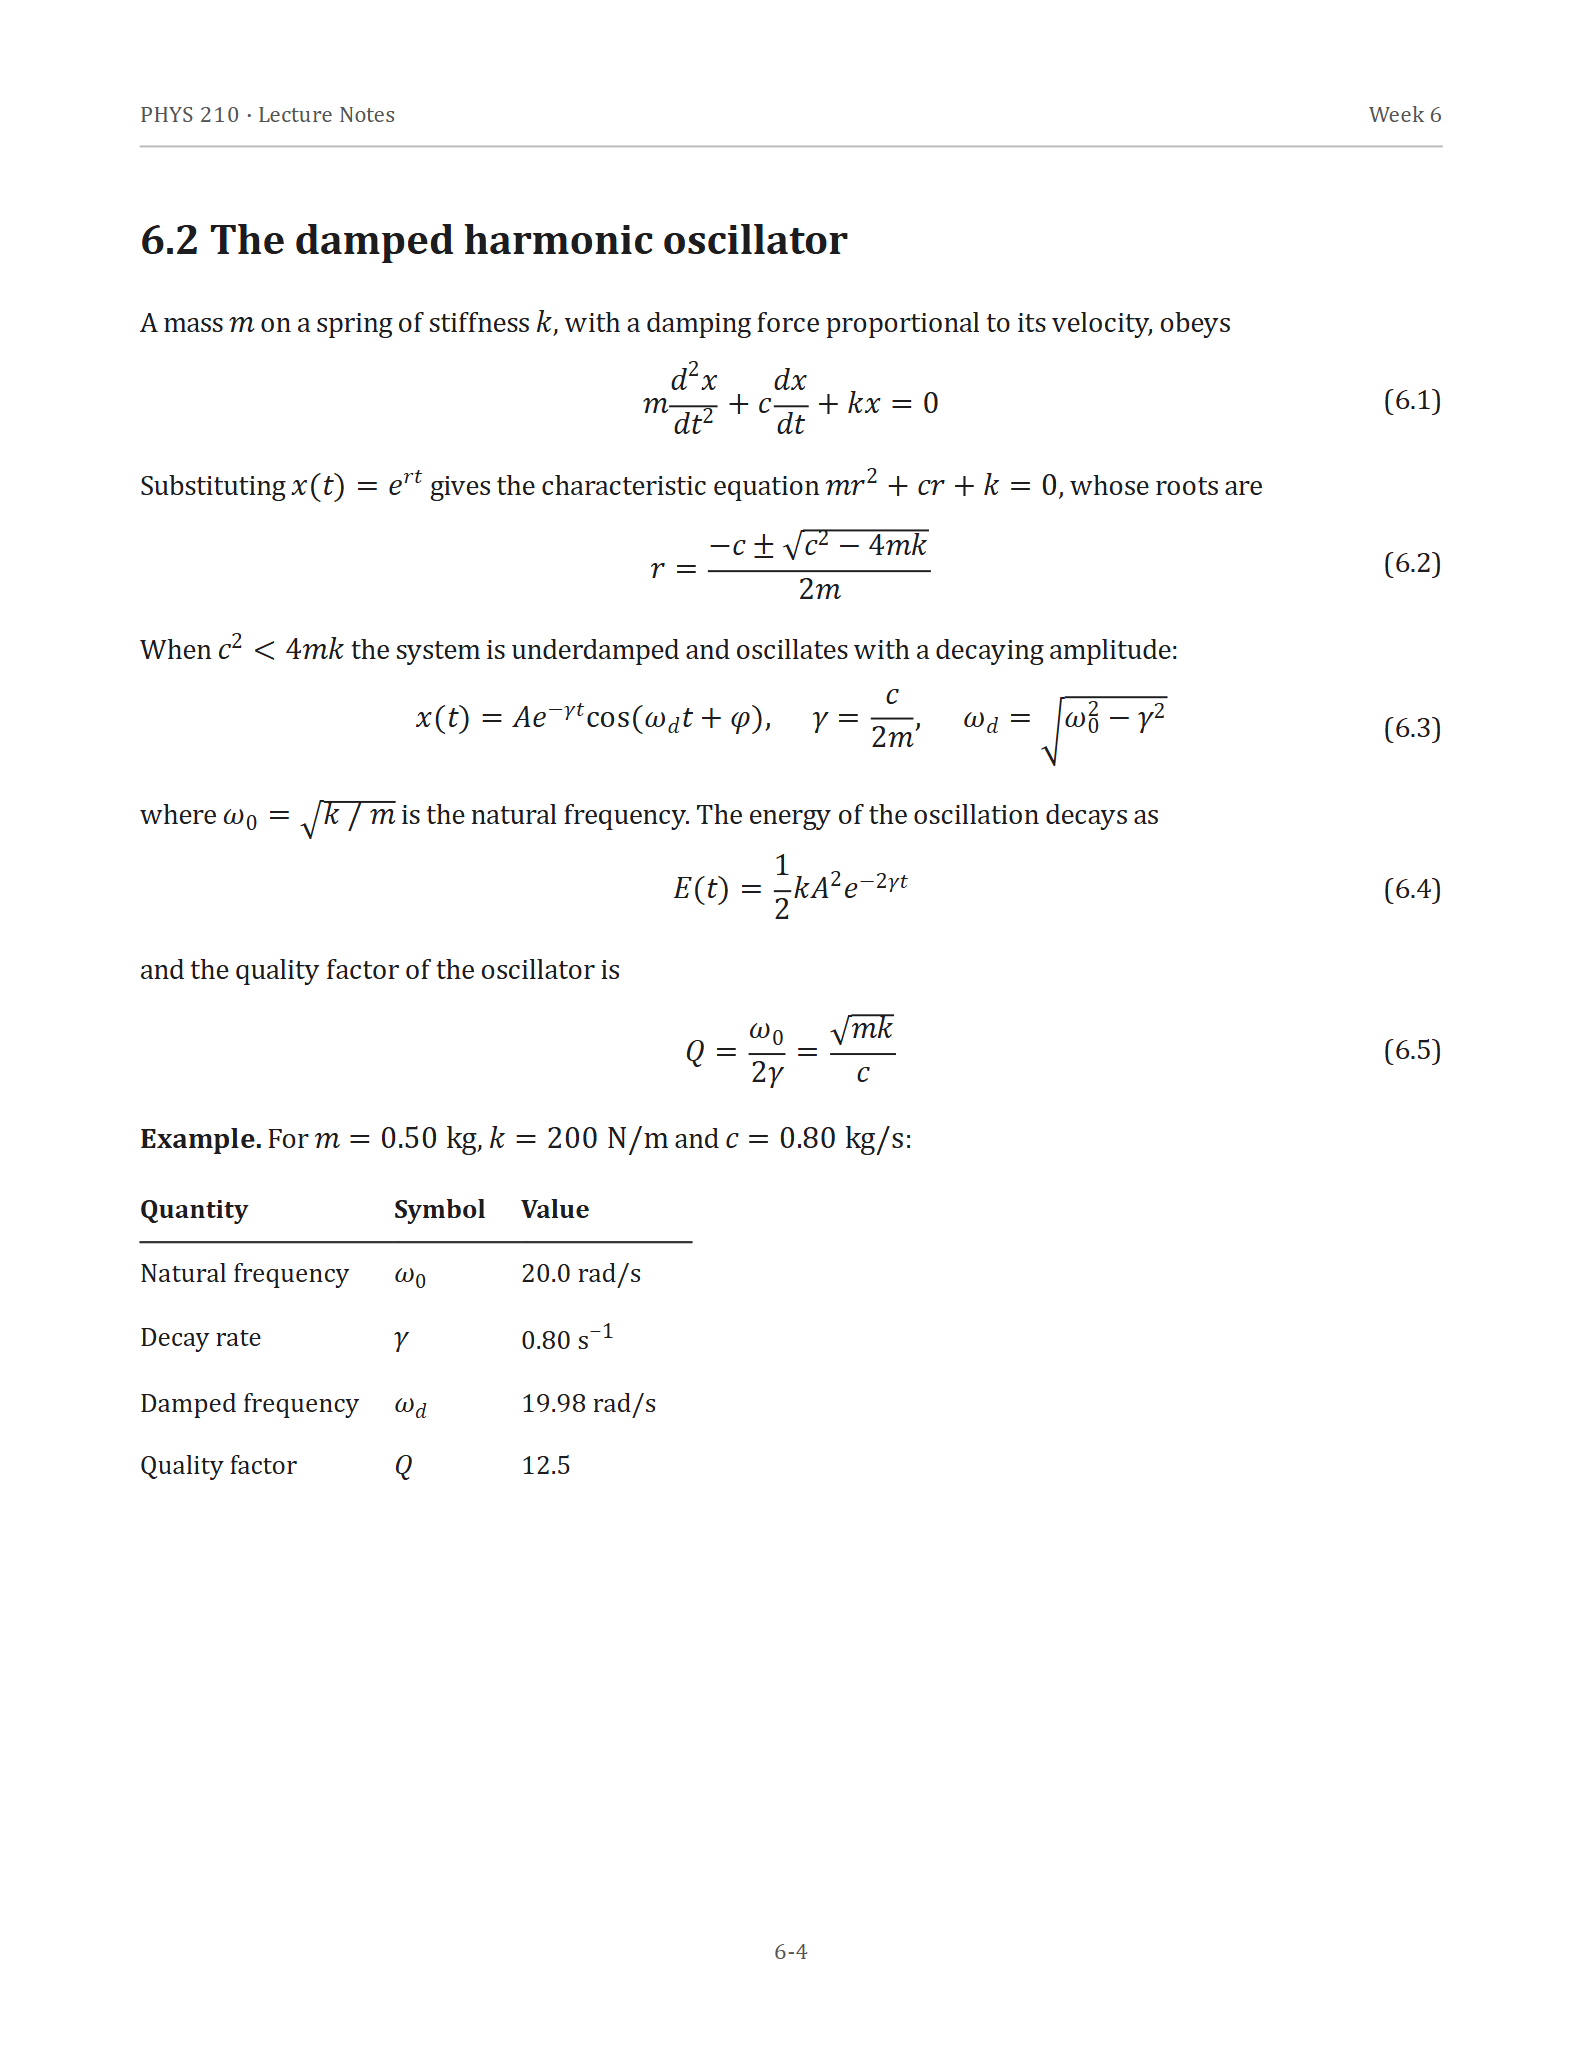
一页讲义测试页,一请求中读完。这页和另外两页对阵三位视觉聊天模型都已发布 LightOnOCR-3 4B vs Qwen3.5 4B vs Gemma 4 26B-A4B vs Mistral Small 3.1。 。 。.
该页面返回的Markdown开头;另外三个方程、表格和页码在同一个回答中:
物理210 ·讲义 第6周 ## 6.2 阻尼谐振子 A 质量 $m$ 位于刚度弹簧 $k$ 上,阻尼力与其速度成正比,服从 $$ m \frac{d^2 x}{dt^2} + c \frac{dx}{dt} + kx = 0 \quad \text{(6.1)} $$ 代入 $x(t) = e^{rt}$ 得到特征方程 $mr^2 + cr + k = 0$,其根为 $$ r = \frac{-c \pm \sqrt{c^2 - 4mk}}{2m} \quad \text{(6.2)} $$你的第一个请求
通过URL或base64数据URI发送文档。此请求读取示例PDF的前两页:
curl https://api.empiriolabs.ai/v1/ocr \ -h “授权:承载者 $EMPIRIOLABS_API_key” \ -h “内容类型: application/json” \ -d '{ “model”: “lightonocr-3-4b”, “document”: { “type”: “document_url”, “document_url”: “https://media.empiriolabs.ai/assets/blog-images/lightonocr-3-4b-test-2026-10-25/sample-document.pdf" }, ”pages“: [0, 1] }'你电脑上的文件作为数据URI进入,无需托管:
import base64 import OS 导入请求,使用 open(“report.pdf”, “rb”) 作为 handle: encoded = base64.b64encode(handle.read().decode() response = requests.post( “https://api.empiriolabs.ai/v1/ocr", headers={”Authorization“: f”Bearer {os.environ['EMPIRIOLABS_API_KEY']}}, json={ “model”: “lightonocr-3-4b”, “document”: {“type”: “document_url”, “document_url”: f“data:application/pdf;base64,{encoded}”}, }, timeout=300, ) response.raise_for_status() 页面 response.json()[“pages”]: print(f“--- page {page['index'} ---”) print(page[“markdown”])图像的工作原理相同,其中 “类型”:“image_url” 以及URL或数据URI中的 image_url.一份文档可以是PDF或PNG、JPEG、WebP、TIFF、BMP、GIF或AVIF图片,最多可达50MB,一次请求可阅读最多1000页。
回应内容
响应每页包含一个对象 页数.每个页面的页面为 打折; 方块,页面的每个区域按其类型(标题, (中文), 文本, (中文), 列表, (中文), 表格, (中文), 方程, (中文), 说明, (中文), 头部, (中文), 页脚以及像素中的方框; 图片,图像区域;以及 尺寸,方框所指的页面图像大小。 usage_info.pages_processed 统计已读页数。讲义页返回的16个块之一:
{ “类型”:“方程”,“top_left_x”:641,“top_left_y”:526,“bottom_right_x”:1447,“bottom_right_y”:610,“内容”:“$$\nr = \\frac{-c \\pm \\sqrt{c^2 - 4mk}}{2m} \\quad \\text{(6.2)}\n$$” }请求的回答是在页面被阅读后才会回复。大约四分半钟后,一个请求仍在运行 202 其中 任务(d):民意调查 快/v1/jobs/{job_id} 直到 现状 是 已完成,页面已经放进去了 结果.要一次性获取作业ID,发送头部 偏好:异步响应。 。 。.
选项
- 页数。
页数以零为基础的页码作为列表([0, 2, 3])或字符串("0,2-4").把它放出来,读每一页。 - 桌子。
table_format设置为打折或HTML将每个表格移动到表格以该格式并保留如下链接[tbl-0.html](tbl-0.html)在页面Markdown中。没有它,表格会以HTML的形式留在Markdown中。 - 图片。
include_image_base64返回每个图像区域为JPEG数据URI。image_limit限制整个文档返回的图片数量,以及image_min_size排除了比这个像素数更窄或更短的区域。 - 页眉和页脚。
extract_header以及extract_footer把他们从Markdown转移到自己的场地。 - 布局。
include_blocks设置为错误叶片方块出去。
作战笔记
- 页码从0开始。
“页数”:[1]读到第二页。 - 美元符号可能会被逃脱。 在页面文本中,可能有一个美元符号写道
\$,以及HTML表格内部& 美元;.在搜索金额之前,先解除Markdown。 - 注释字段被拒绝。
bbox_annotation_format, (中文),document_annotation_format, 和document_annotation_prompt回答400在任何页面被阅读之前。
定价
按页数收费。 每个请求至少计费5页,因此将长文档作为一份PDF发送,而不是每页发送一个请求。未返回的请求不会计费。当前费率详见 模型页面 页:1 定价页面。 。 。.
开始建造
试试LightOnOCR-3 4B,在 Playground 带上你自己的文档,并阅读 文档OCR指南 页:1 API 文档 对每个参数。
披露:这篇文章是在AI的协助下撰写的,并由EmpirioLabs AI审查.