Aplomb 1 是我们的第一个模型。它在一次请求中接收文本、JSON、图片、音频和视频,读取最多 100 万个令牌,并在大约 3 秒内对一个 100 万个令牌的文档做出决策。一个简短的问题大约需要 15 毫秒的模型时间。
它运行在我们为决策模型构建的推理运行时上。在我们的API和Playground中,长文档会经过快速长上下文模式:一个100万令牌的文档大约需要3秒,而111秒,快速模式在长上下文测试中正确回答了全部525个决策。
对于代理,Aplomb 1 在一次请求中返回每个工具以及每个枚举和布尔参数的概率,因此当模型确定时行动,不确定时升级。每个答案都经过校准,并且可以判断输入中没有答案,而不是猜测。它为软件每天做的数千次决策而构建,从路由工单到选择代理的下一个工具。
在发布的Decision Index 0.2.1板(2026年9月28日数据)中,它在4B模型中排名第1,官方套件中排名第44.86,在38个基准中8个参数参数最高为53亿的模型中排名第#1。在2026年10月12日的Decision Index 0.3.2板上,它在R-Bench-M、GPQA Diamond和cfcolor的尺寸类别中排名第1。目前它在EmpirioLabs API和Playground中可用,权重显示在Hugging Face的EmpirioLabs型号许可下。
| Aplomb 1 一览 | |
|---|---|
| 输入 | 文本、JSON、图片、视频和音频,任何混合形式都可以 |
| 窗户 | 1,000,000个状态代币加问题 |
| 问题 | 是或否,选择(2到255个选项),评分(2到10级),工具选择 |
| 在州内没有 | 输入不包含答案的概率 |
| 工具选择 | 下一个调用工具,并包含其枚举和布尔参数的概率 |
| 速度 | 短问题约为15毫秒的模型时间;快速长上下文模式下,100万令牌文档约为3秒 |
| API 格式 | Decisions API,以及OpenAI、Anthropic和Gemini格式 |
| 账单 | 仅输入标记;输出标记始终为零 |
| 数据保留 | 默认为零数据保留 |
| 规模 | 53亿参数,基于Qwen3.5-4B构建;拥抱脸上的开放权重 |
| 决策索引 0.2.1 | 官方套件的运行量为44.86,在发布的0.2.1板板上4B型号中排名第91(数据截至2026年9月28日) |
| 决策指数 0.3.2 | R-Bench-M(最高25B)、GPQA Diamond和cfcolor(8B以下)尺寸类别的#1,2026年10月12日的板块 |
| 打字决策 | 2026年10月8日,拥抱面排行榜默认视图中,吉隆坡分量(0.123)和布赖尔分数(0.065)#1 |
答案是什么
四种题型。 努尔 回答是或否,概率是。 选择 从2到255个选项中选择一个,并返回全部分配。 配乐 将国家设定在2到10级的有序等级上。 工具 选择调用你的函数工具,并返回其枚举和布尔参数的分布。
不在这个州。 添加 “弃权”:正确 对一个问题和答案也带有状态不包含问题所需内容的概率。没有载子字段的记录会获得较高的弃权概率,而非信心猜测。
独立回答。 最多128个问题共享一个状态,每个问题单独回答,因此添加一个问题不会改变另一个答案。
代理人的工具选择
给 Aplomb 1 你的代理函数工具和当前状态(工单、对话、记录),它会在一次请求中返回下一个调用工具,每个工具的概率和每个枚举和布尔参数的分布。通用的大型语言模型会逐个标记调用工具,不会说明对工具或任何参数的确定性。代理在概率高时行动,低于时将步骤交给更大的模型,因此常规步骤跳过生成的答案。我们未发现其他决策模型能返回参数概率。
一张写着“订单B-44120送达时屏幕破裂的工单。我要退钱。”带着三把工具, issue_refund (a 原因 枚举和 full_refund 布尔值), track_package 以及 escalate_to_human返回为(简略,圆润):
{“tool”: “issue_refund”, “probabilities”: {“issue_refund”: 0.969, “none”: 0.025, “escalate_to_human”: 0.005, “track_package”: 0.002}, “arguments”: {“issue_refund”: { “reason”: {“value”: “damaged”, “probabilities”: {“damaged”: 0.993, “not_as_described”: 0.007, “late”: 0.001}}, “full_refund”: {“value”: true, “probability_true”: 0.761}}, “open_arguments”: {“track_package”: [“order_id”]}}
自由文本参数,如顺序ID,列于下方 open_arguments 由经纪人来填补。
混合输入,最多100万个代币
文本、JSON 对象和数组、图片、视频和音频会处于同一状态,组合任意:客户记录旁有支持通话录音,理赔表旁有行车记录仪片段,商品照片放在商品列表旁边。状态加上最长的问题可能达到100万token,足够一次性申请一份长合同捆绑包、一年的工单或数小时的文字记录。
评分
我们对同一项目运行了Aplomb 1和三个开放的4B决策模型,并将Intern-Decision发布的Jev、JevK5和SemIf的数据放在旁边。在七套套件的Intern-Decision报告中,Aplomb 1的平均得分率为88.7%。与Jev已发布的Decision相比,它在JevBench Hard和打字决策中领先,在JevBench Easy中持平,落后于JevBench Original、ToolACE、AG News和WildJailbreak。其最大领先优势是JevBench Hard,+5.4分。
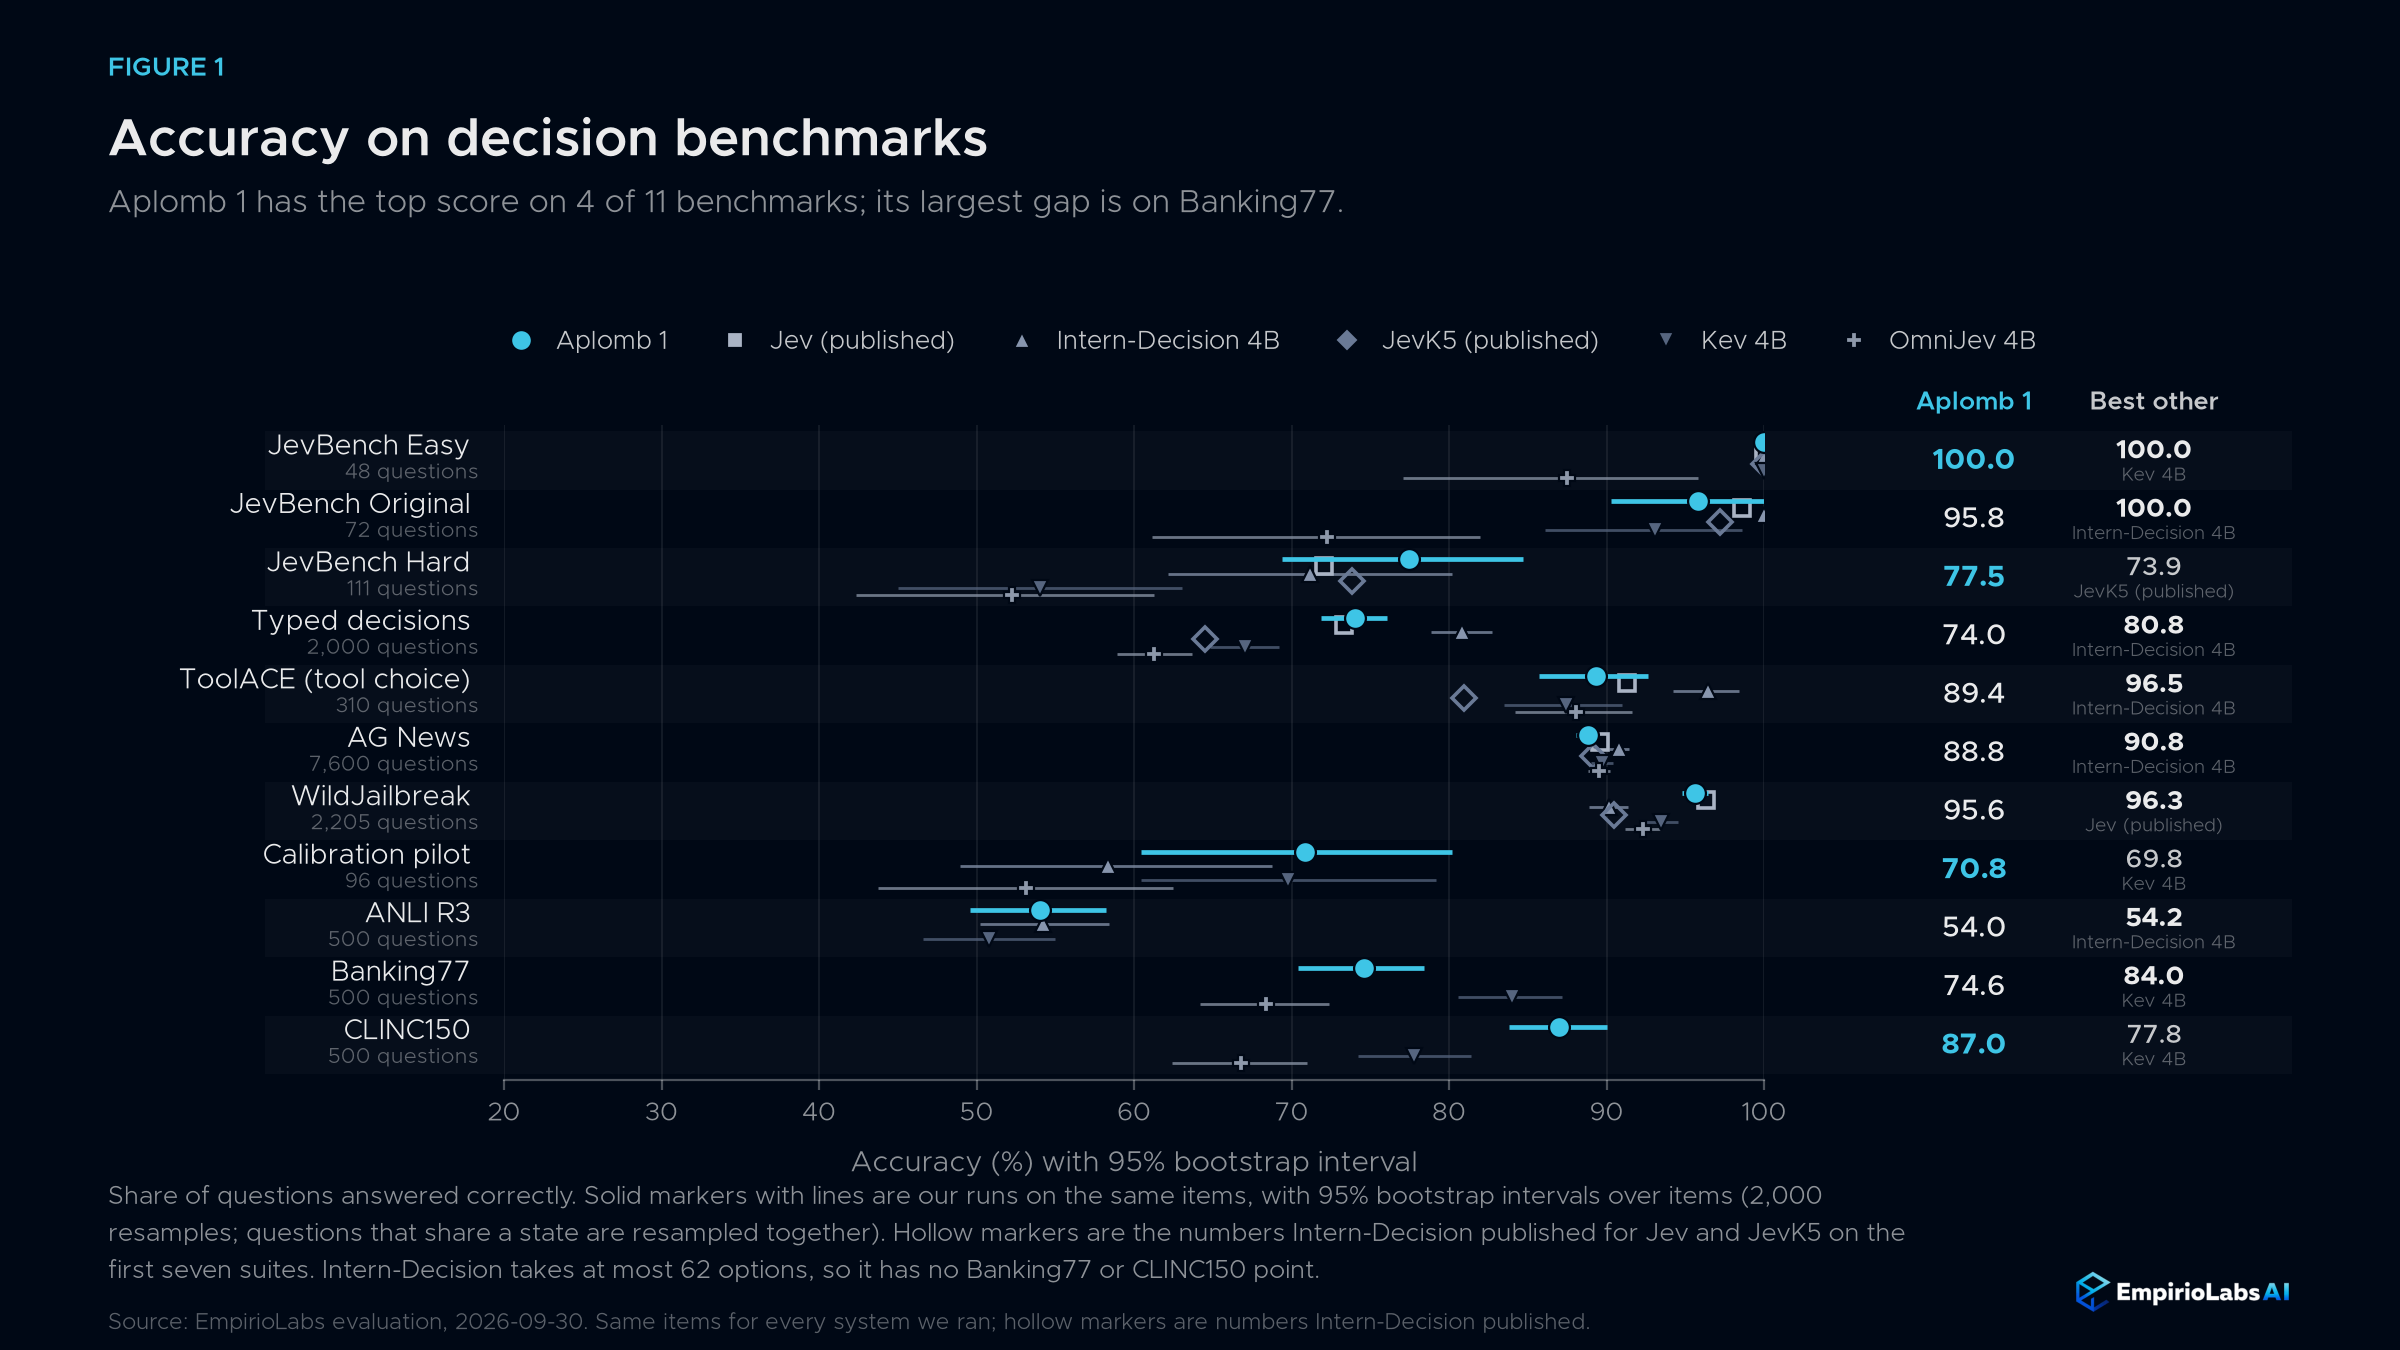
| 基准测试 | 装甲1 | Jev(p) | JevK5 (p) | Semif (p) | 实习生决策4B | Kev 4B | OmniJev 4B |
|---|---|---|---|---|---|---|---|
| JevBench Easy | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 87.5 |
| JevBench 原版 | 95.8 | 98.6 | 97.2 | 98.6 | 100.0 | 93.1 | 72.2 |
| JevBench Hard | 77.5 | 72.1 | 73.9 | 61.3 | 71.2 | 54.1 | 52.3 |
| 类型决策 | 74.0 | 73.3 | 64.5 | 62.8 | 80.8 | 67.0 | 61.3 |
| ToolACE | 89.4 | 91.3 | 81.0 | 85.2 | 96.5 | 87.4 | 88.1 |
| AG新闻 | 88.8 | 89.6 | 89.1 | 89.2 | 90.8 | 89.7 | 89.6 |
| 野狱突破 | 95.6 | 96.3 | 90.5 | 92.5 | 90.2 | 93.5 | 92.3 |
| 平均值 | 88.7 | 88.7 | 85.2 | 84.2 | 89.9 | 83.5 | 77.6 |
(p) 由Intern-Decision发布的同项数据。Intern-Decision报告其4B模型对该捆绑的90.02;列中显示我们的运行。
| 基准测试 | 装甲1 | 实习生决策4B | Kev 4B | OmniJev 4B |
|---|---|---|---|---|
| 校准试点 | 70.8 | 58.3 | 69.8 | 53.1 |
| ANLI R3 | 54.0 | 54.2 | 50.8 | n/a |
| Banking77(77个选项) | 74.6 | n/a | 84.0 | 68.4 |
| CLINC150(150个选项) | 87.0 | n/a | 77.8 | 66.8 |
长输入
我们测量了订单账本中的查询次数,从16K到1M代币,关于一个订单在随机深度下放的问题。
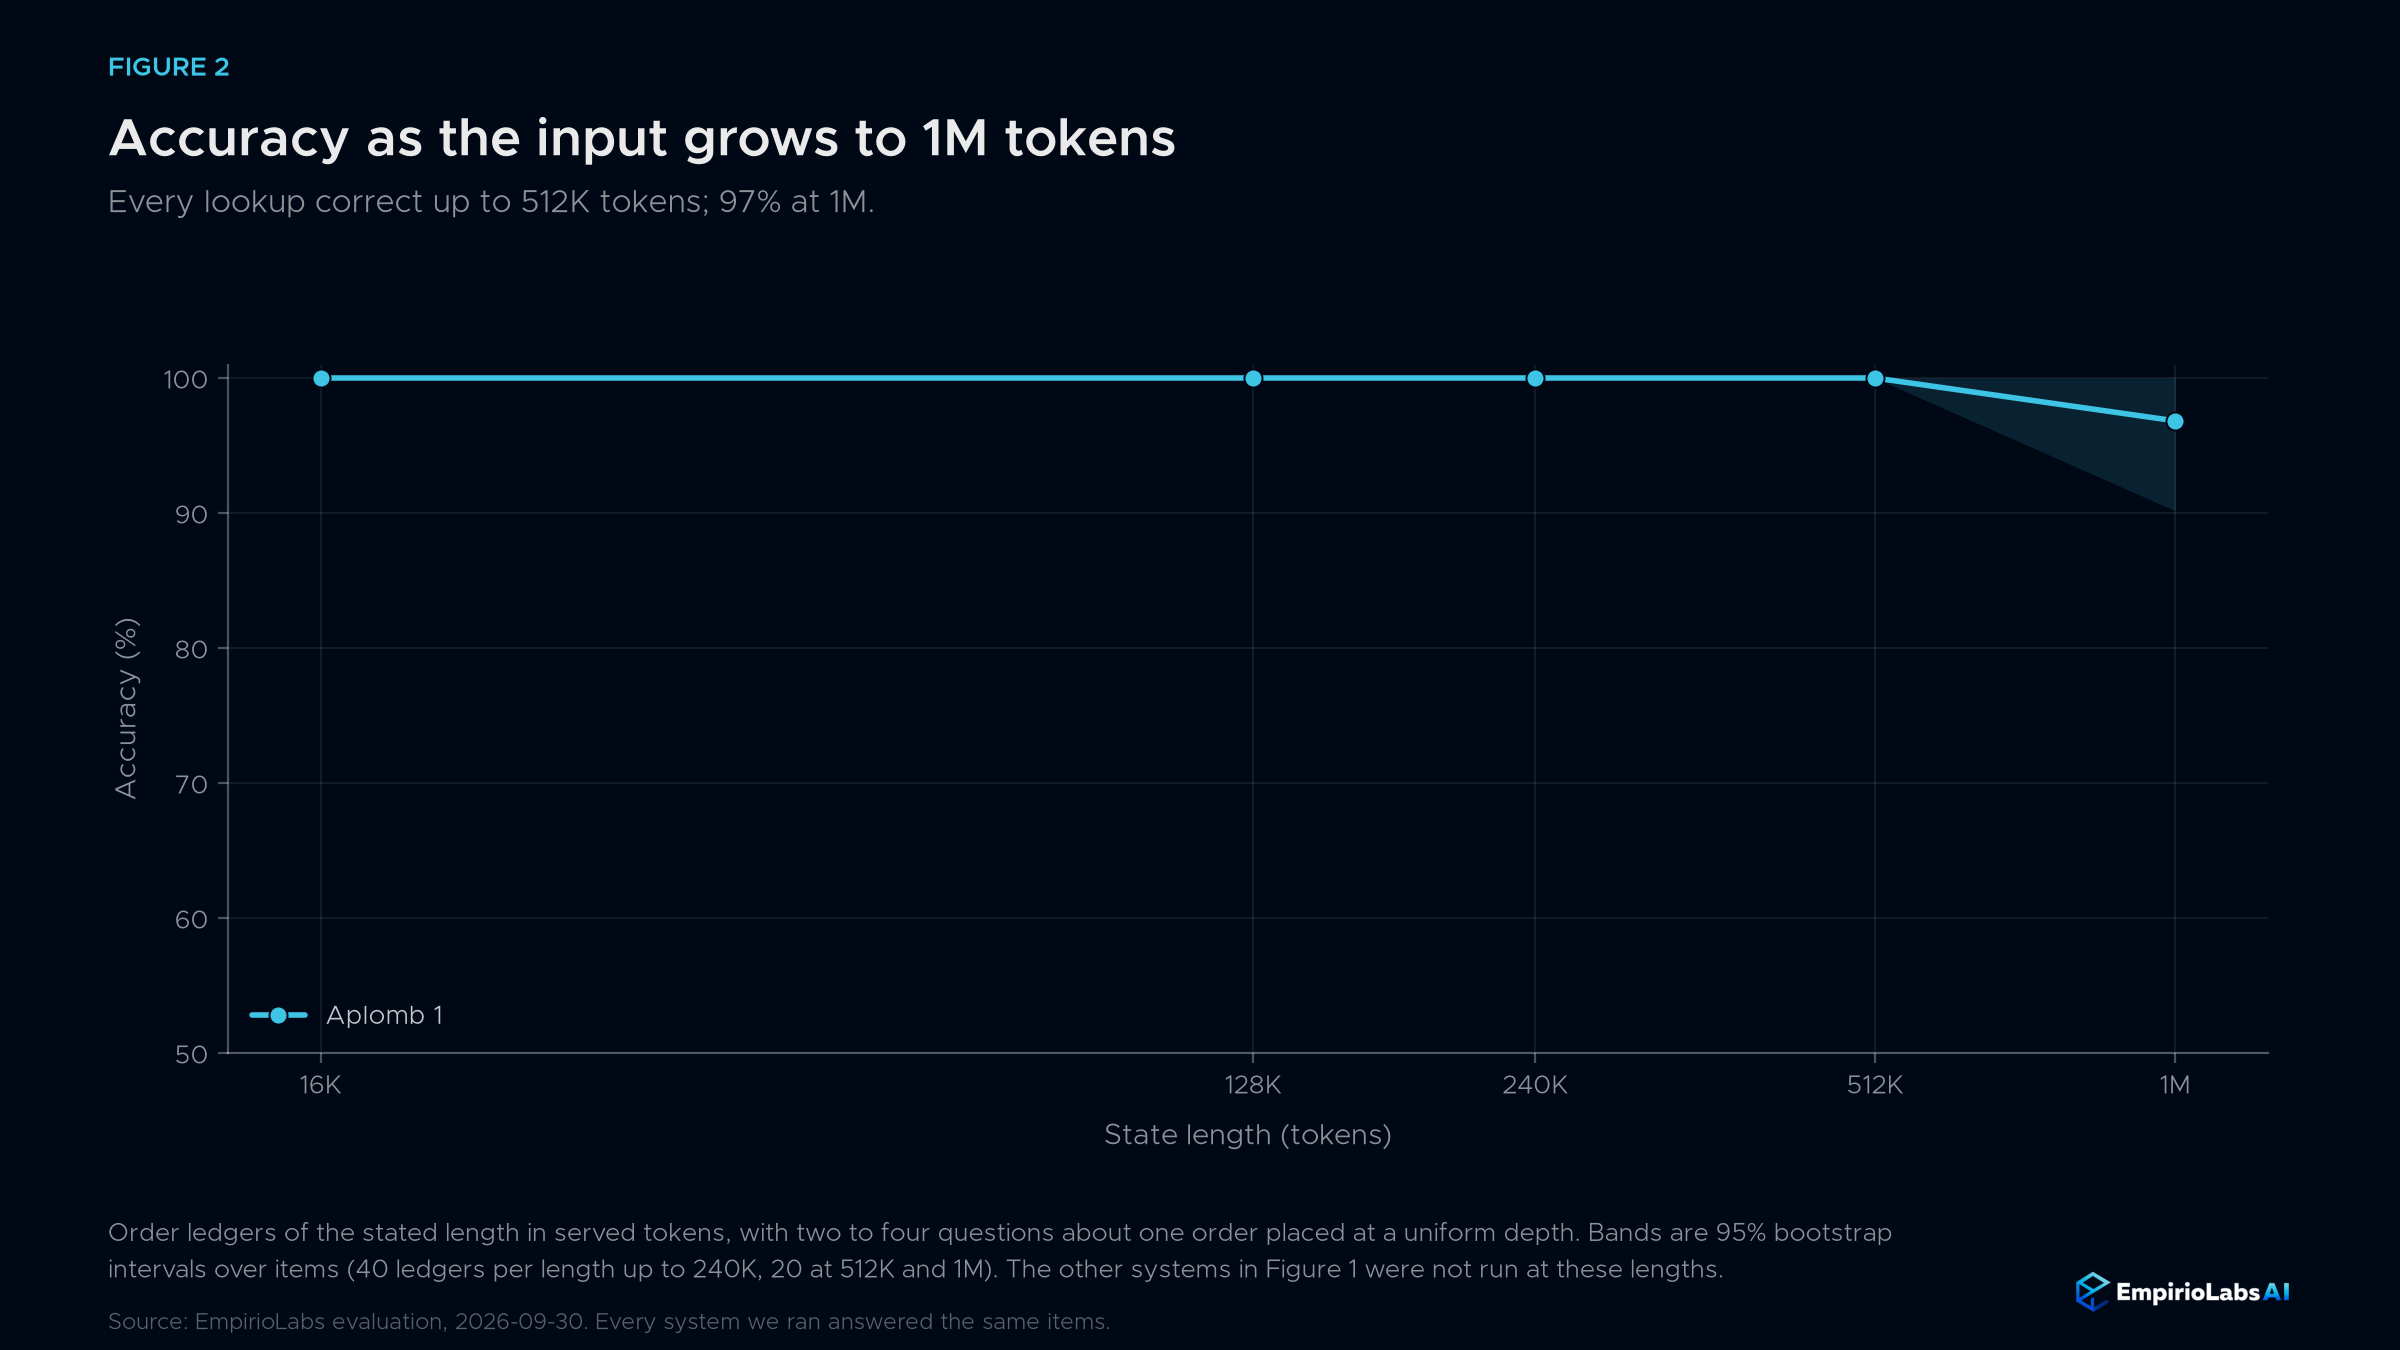
| 输入长度(代币) | 16K | 128K | 240K | 512K | 1M |
|---|---|---|---|---|---|
| 装甲1 | 100.0 | 100.0 | 100.0 | 100.0 | 96.8 |
几秒钟内完成长文档
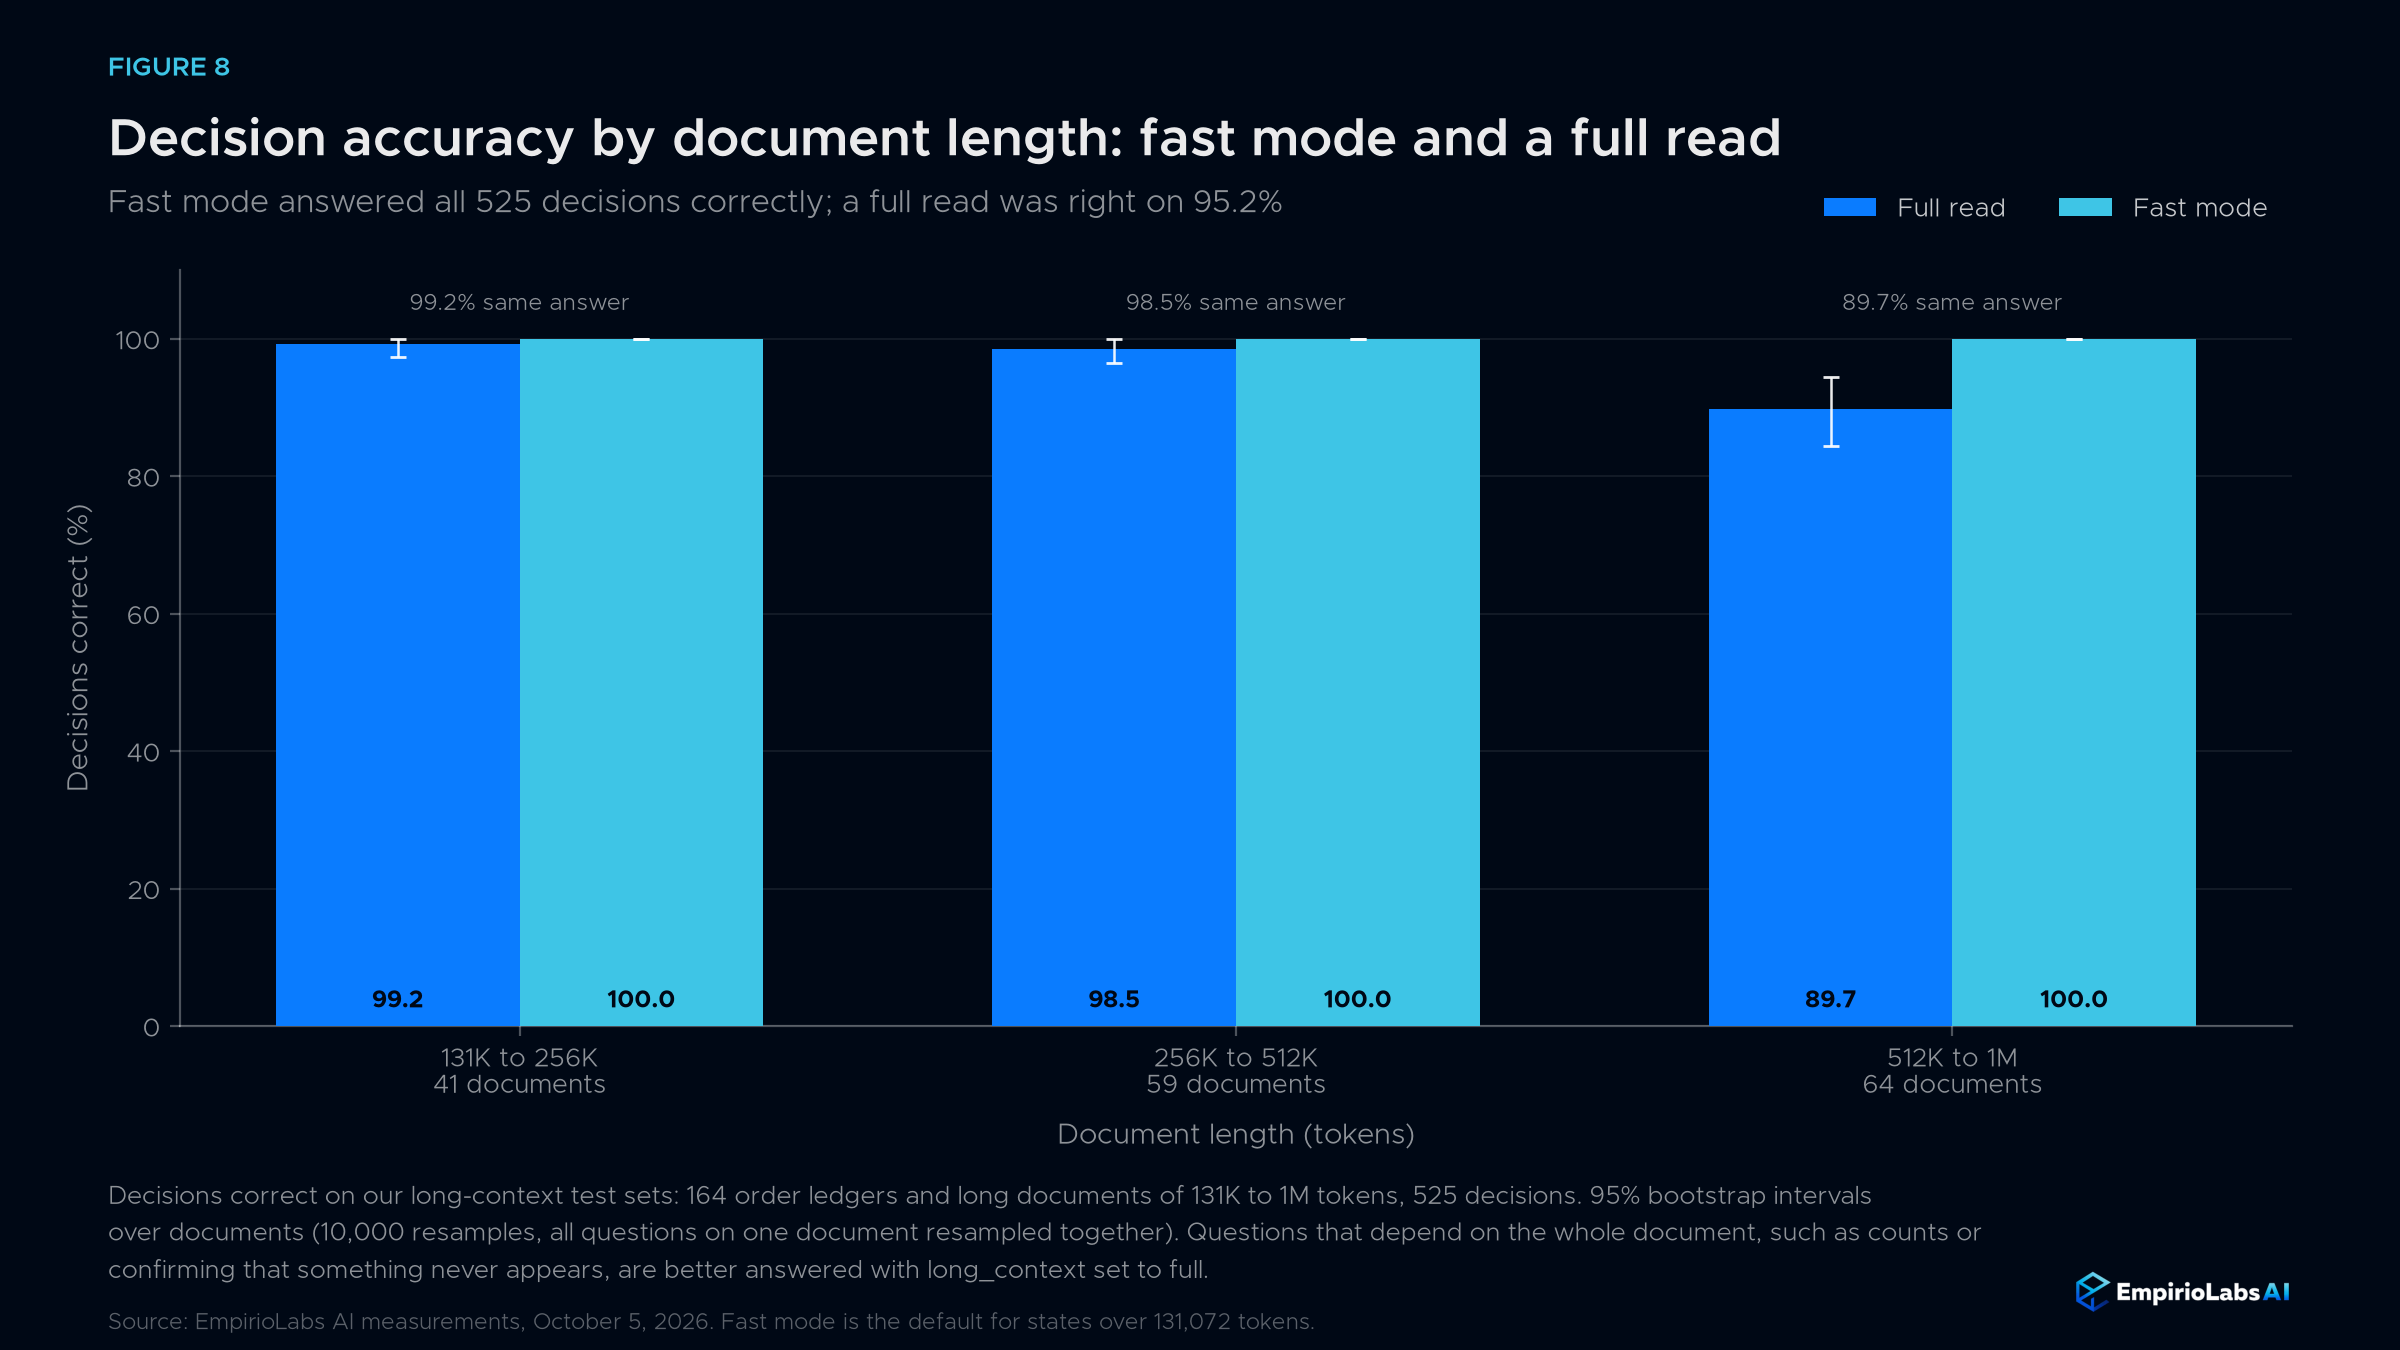
在EmpirioLabs API和Playground中,默认读取超过131,072个令牌的状态会在快速长上下文模式下读取。一个1M令牌文档大约需要3秒,而完整读取大约需要111秒,在我们的长上下文测试集中,快速模式正确回答了全部525个判定,而完整读取的准确率为95.2%。
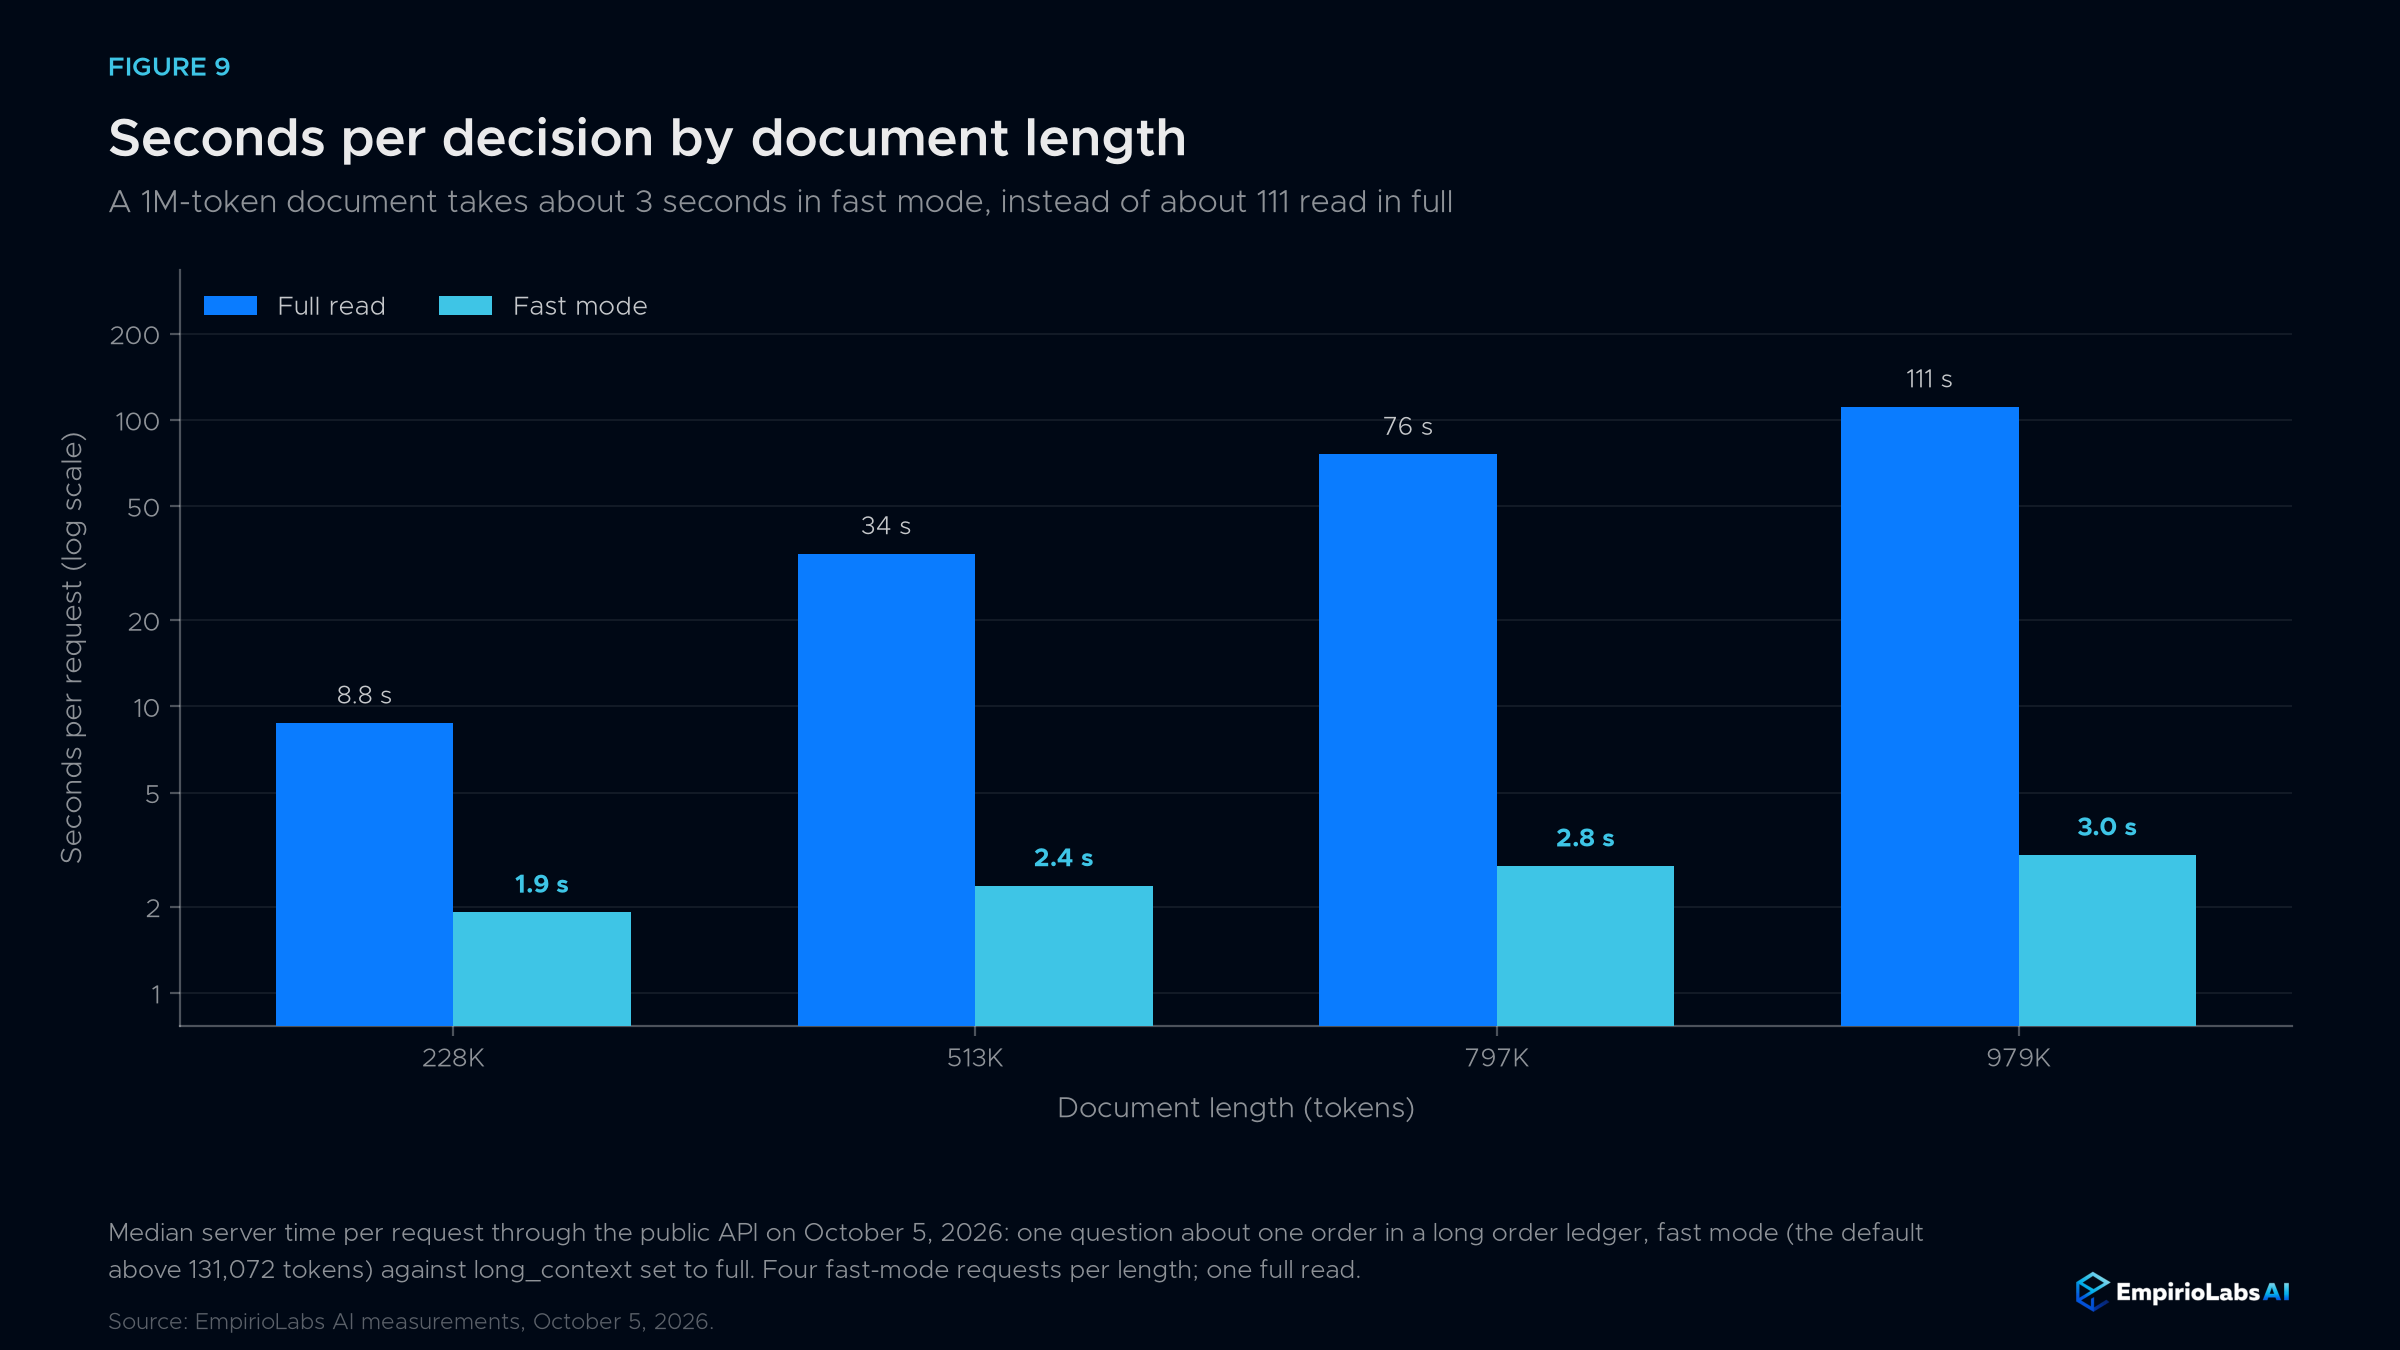
| 文档长度(令牌) | 228K | 513K | 797K | 979K |
|---|---|---|---|---|
| 快速模式 | 1.9秒 | 2.4秒 | 2.8秒 | 3.0秒 |
| 全文阅读 | 8.8秒 | 34秒 | 76秒 | 111 s |
发送 “long_context”:“满” 读取每一个标记。当答案依赖于整个文档时,比如计数、整体语气,或确认某事从未出现时,完整阅读是更好的选择:在为测试这些问题而构建的24份文档中,快速模式正确了50%的决策,完整读取正确率为61%。回答是 long_context 字段表示所使用的模式,使用量在两种模式下计入整个状态。快速长上下文模式仅在EmpirioLabs API和Playground中提供;开放权重读取所有令牌。
校准
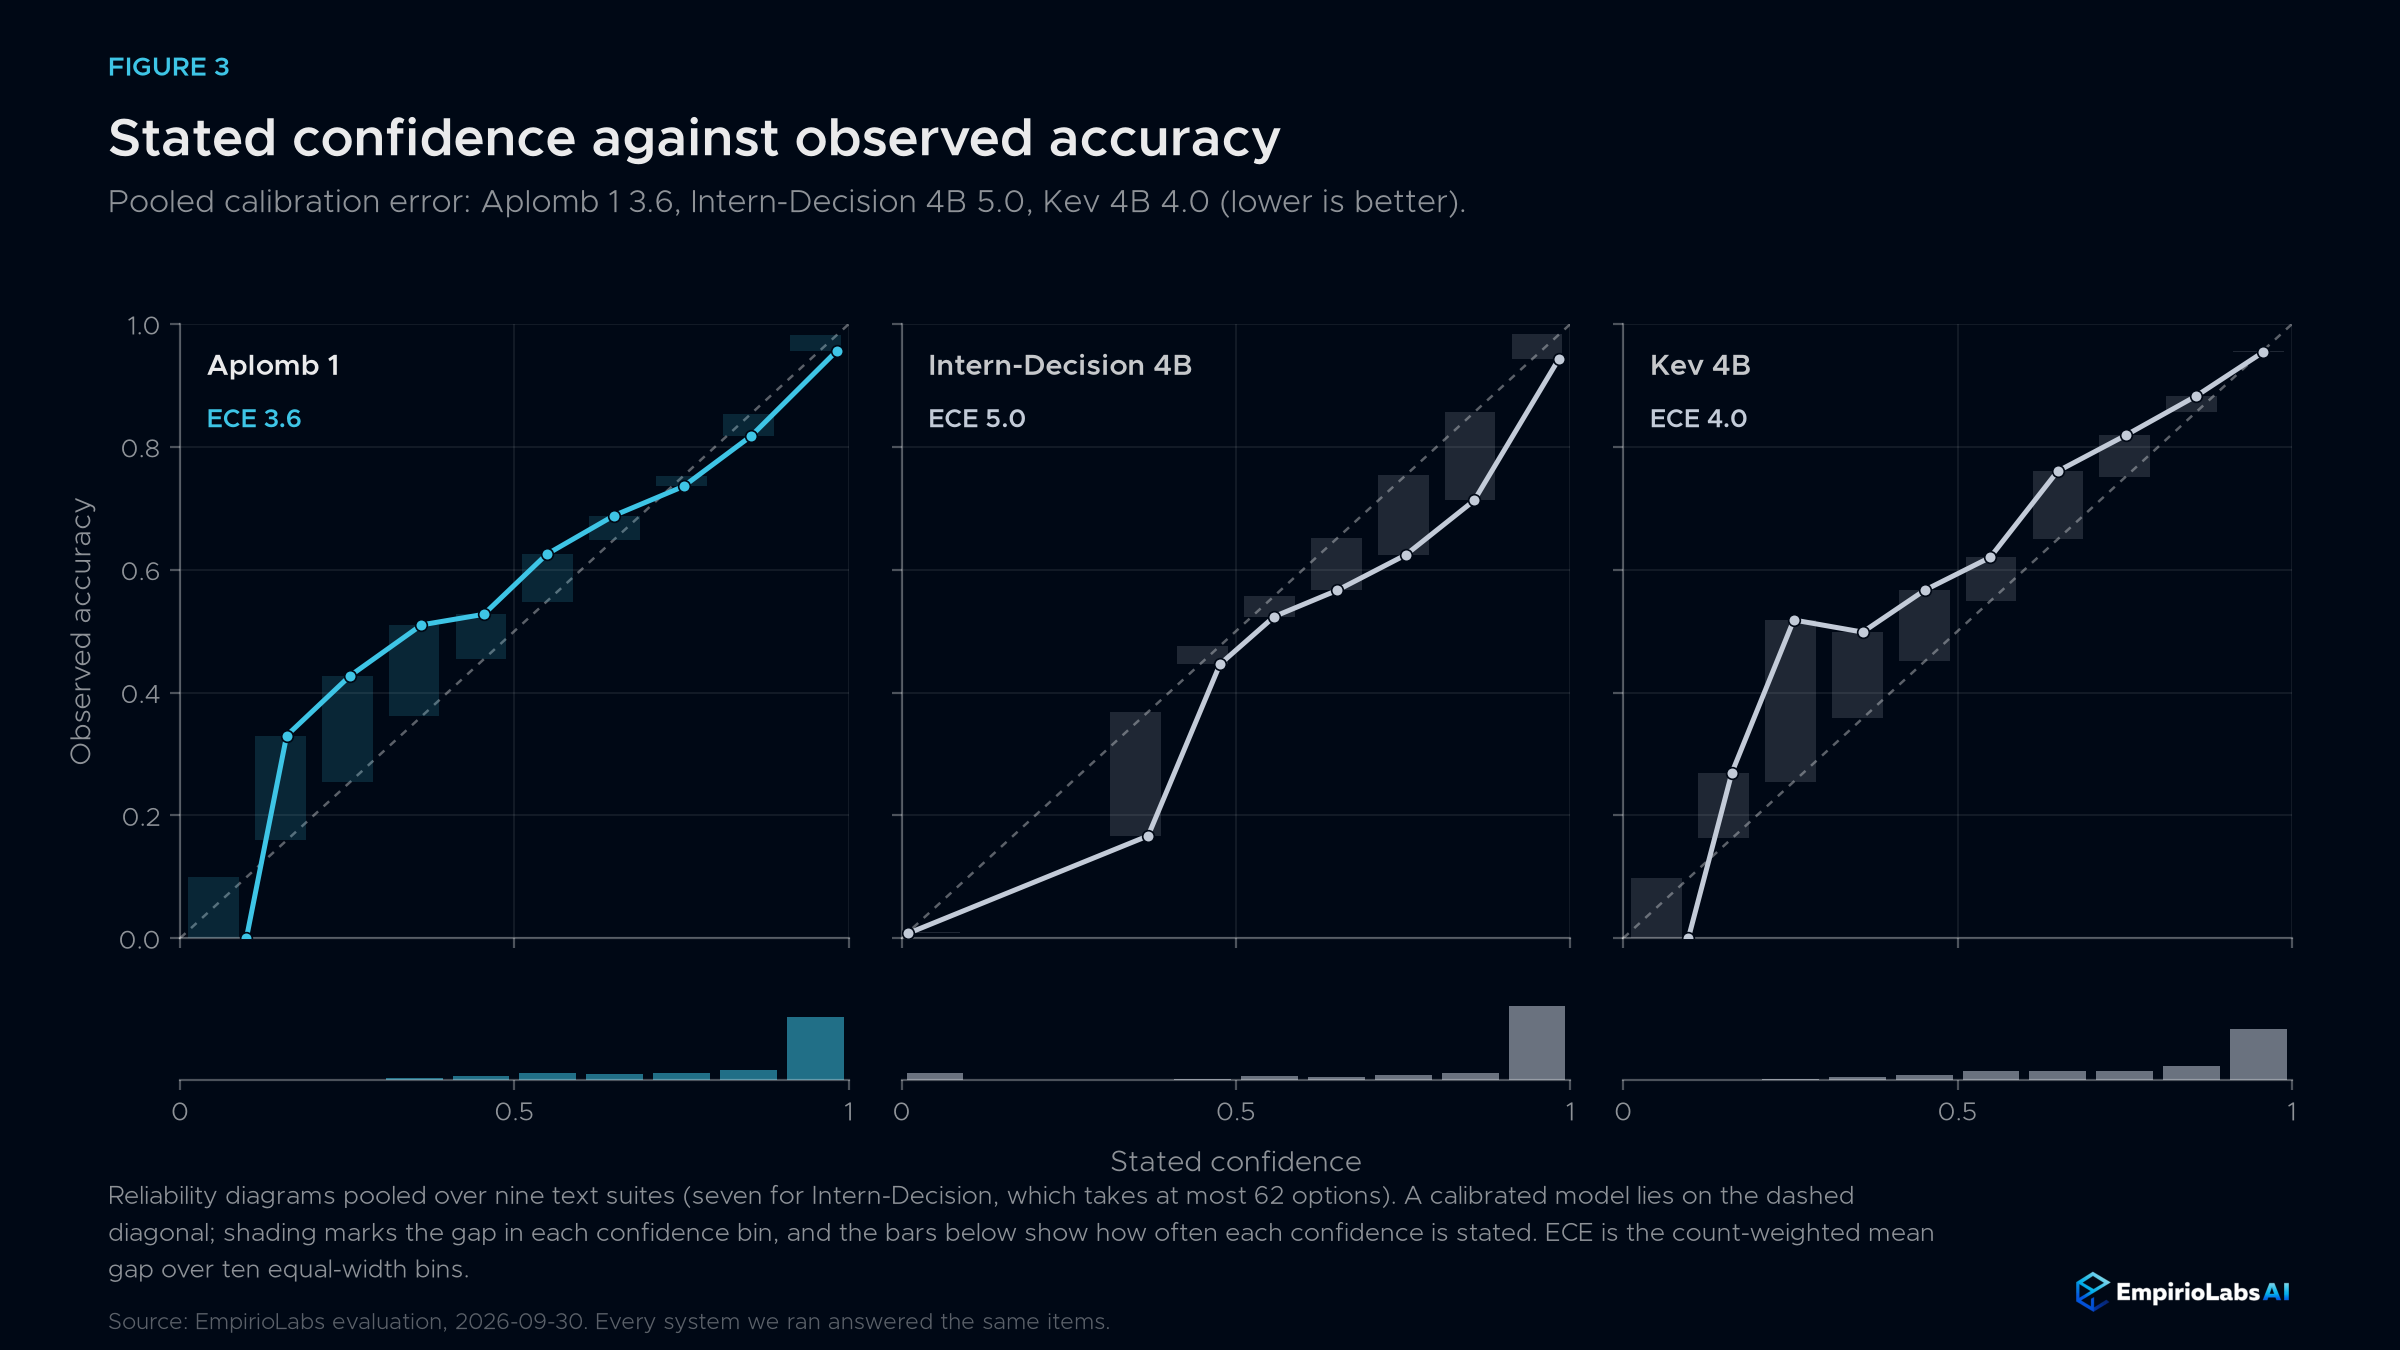
概率只有在字面意思都准确时才有用。在九个文本套件中,Aplomb 1的标注置信度追踪其正确频率:其合并校准误差为3.6,Intern-Decision 4B为5.0,Kev 4B为4.0(越低越好)。
图片、视频与音频
| 基准测试(前500件) | 装甲1 | 实习生决策4B | OmniJev 4B |
|---|---|---|---|
| 教皇 | 89.0 | 89.2 | 88.4 |
| MMStar | 68.6 | 65.2 | 64.4 |
| AI2D | 87.0 | 81.0 | 83.4 |
| 嗯嗯 | 57.2 | 57.0 | 56.0 |
| 幻觉长椅 | 79.8 | 79.4 | 71.2 |
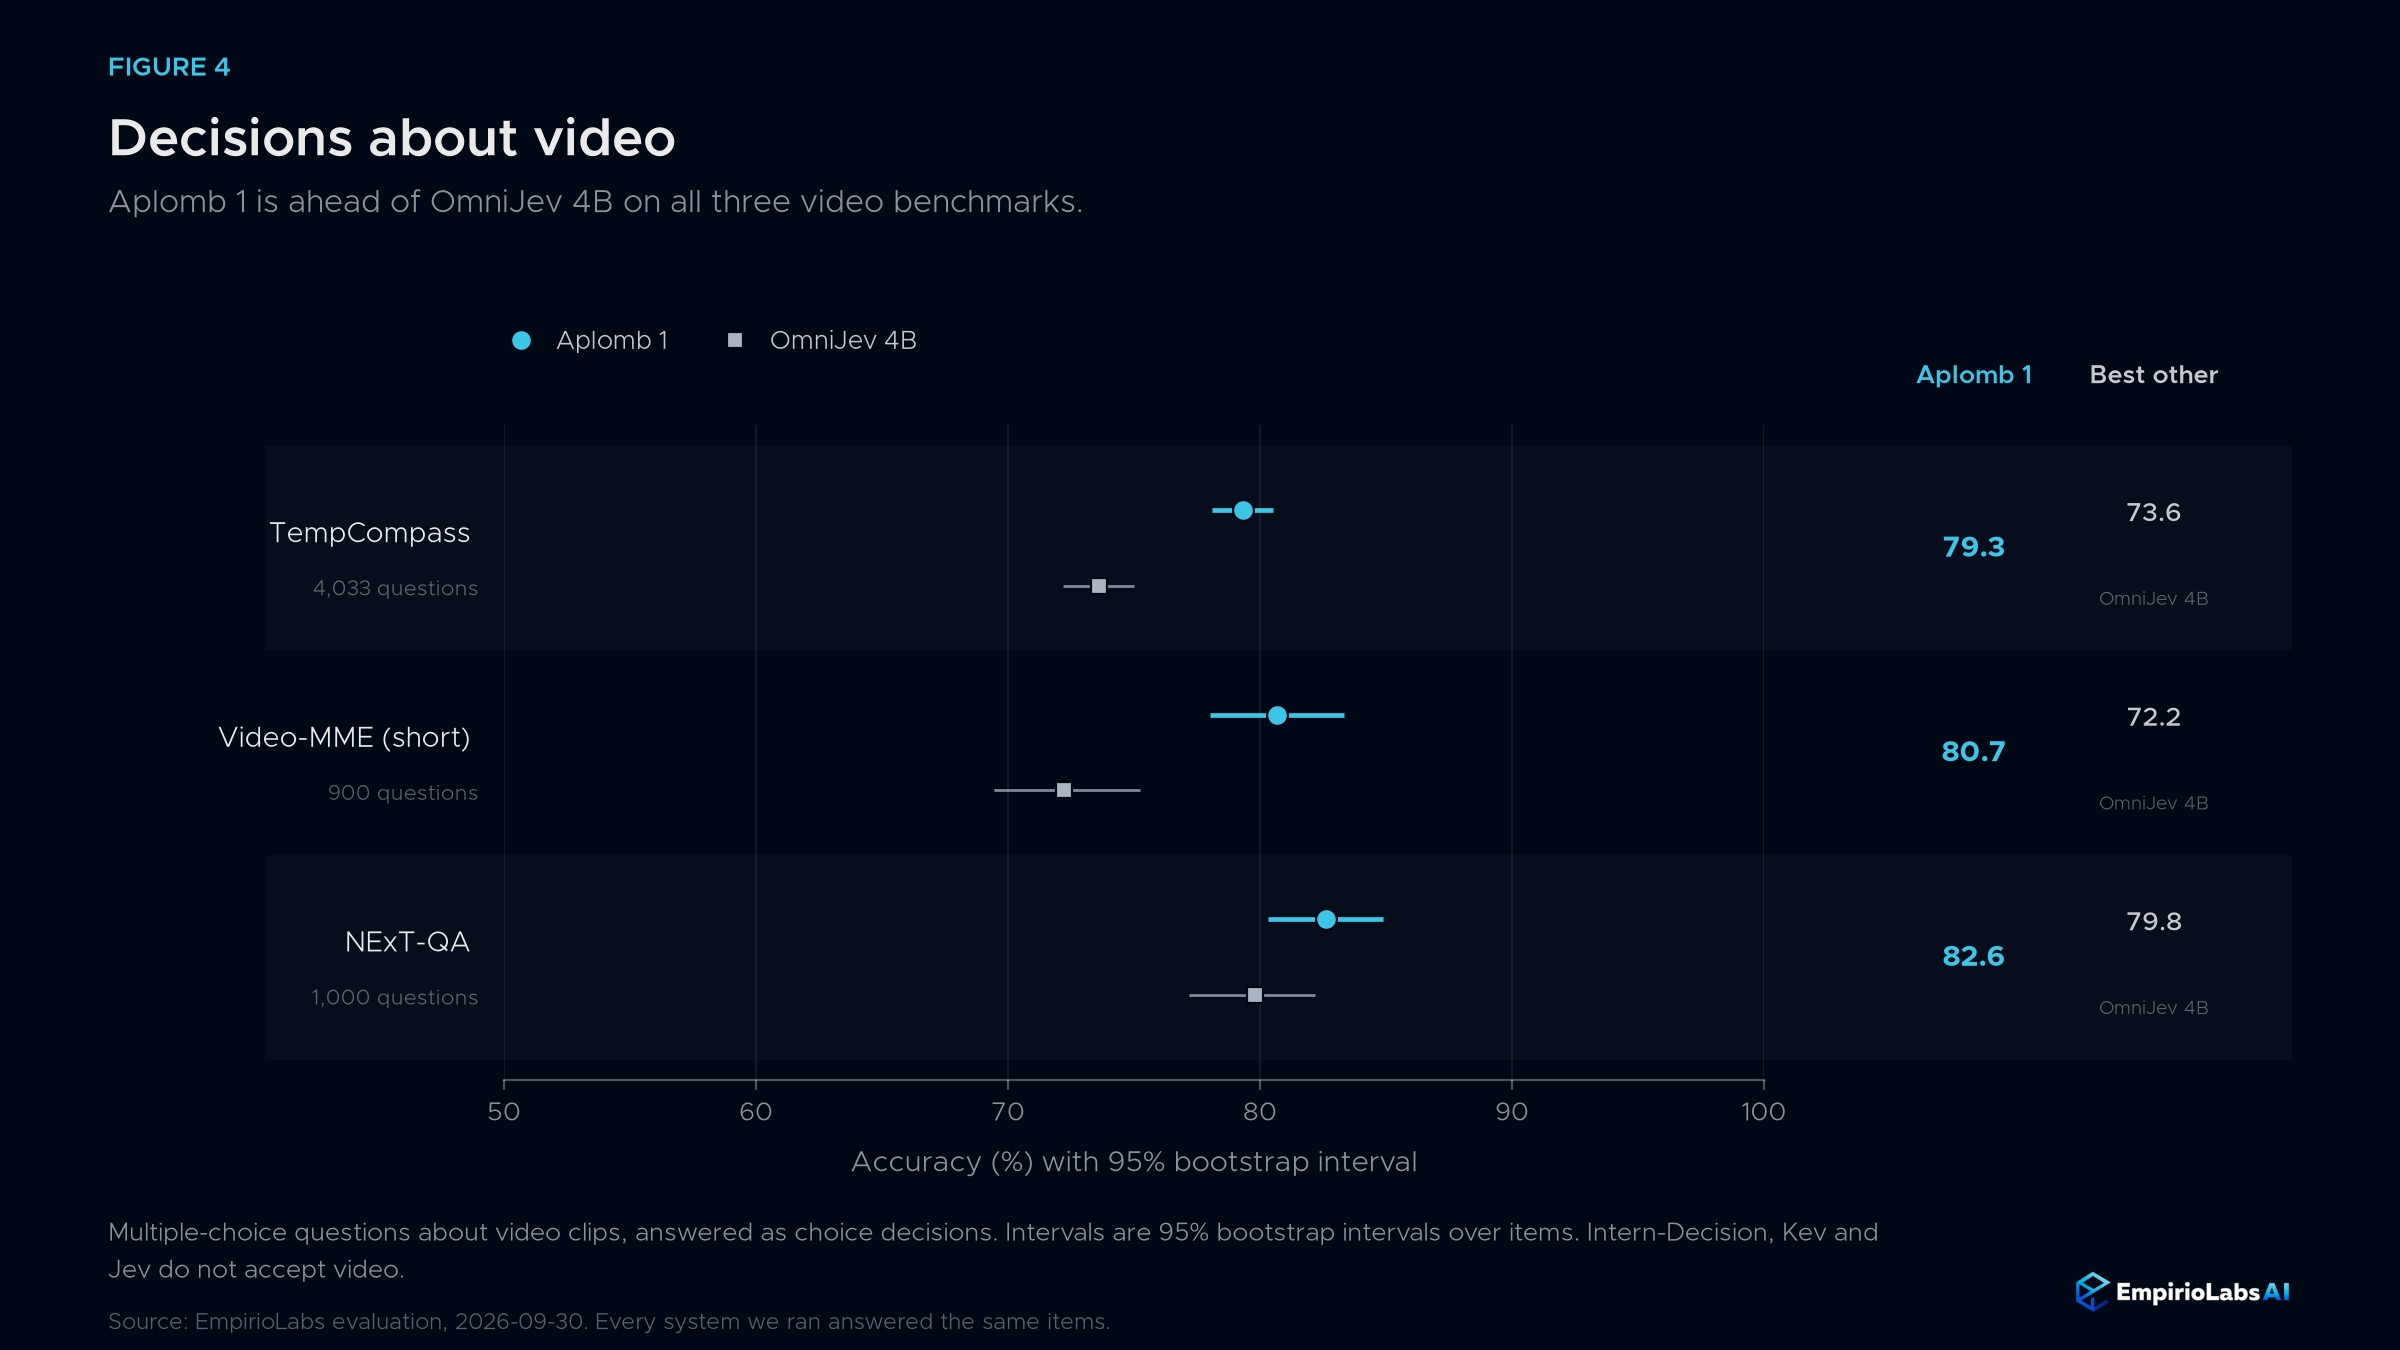
| 基准测试 | 装甲1 | OmniJev 4B |
|---|---|---|
| 温度指南针 | 79.3 | 73.6 |
| 视频-MME(简称) | 80.7 | 72.2 |
| NExT-QA | 82.6 | 79.8 |
我们自己也为 Aplomb 1 添加了音频;上述其他决策模型都不接受音频。它识别语音、语音中的情感和日常声音,并回答关于所说内容的问题:
| 基准测试 | 装甲1 |
|---|---|
| 声响(声响) | 91.9 |
| CREMA-D(言语中的情绪) | 78.7 |
| ESC-50(环境音效) | 77.0 |
| MMAU(音频问题) | 68.3 |
| MMSU(口语) | 63.2 |
音频结果于2026年10月6日更新,新增了Aplomb 1的音频权重;文本、图片和视频结果保持不变。
51种语言
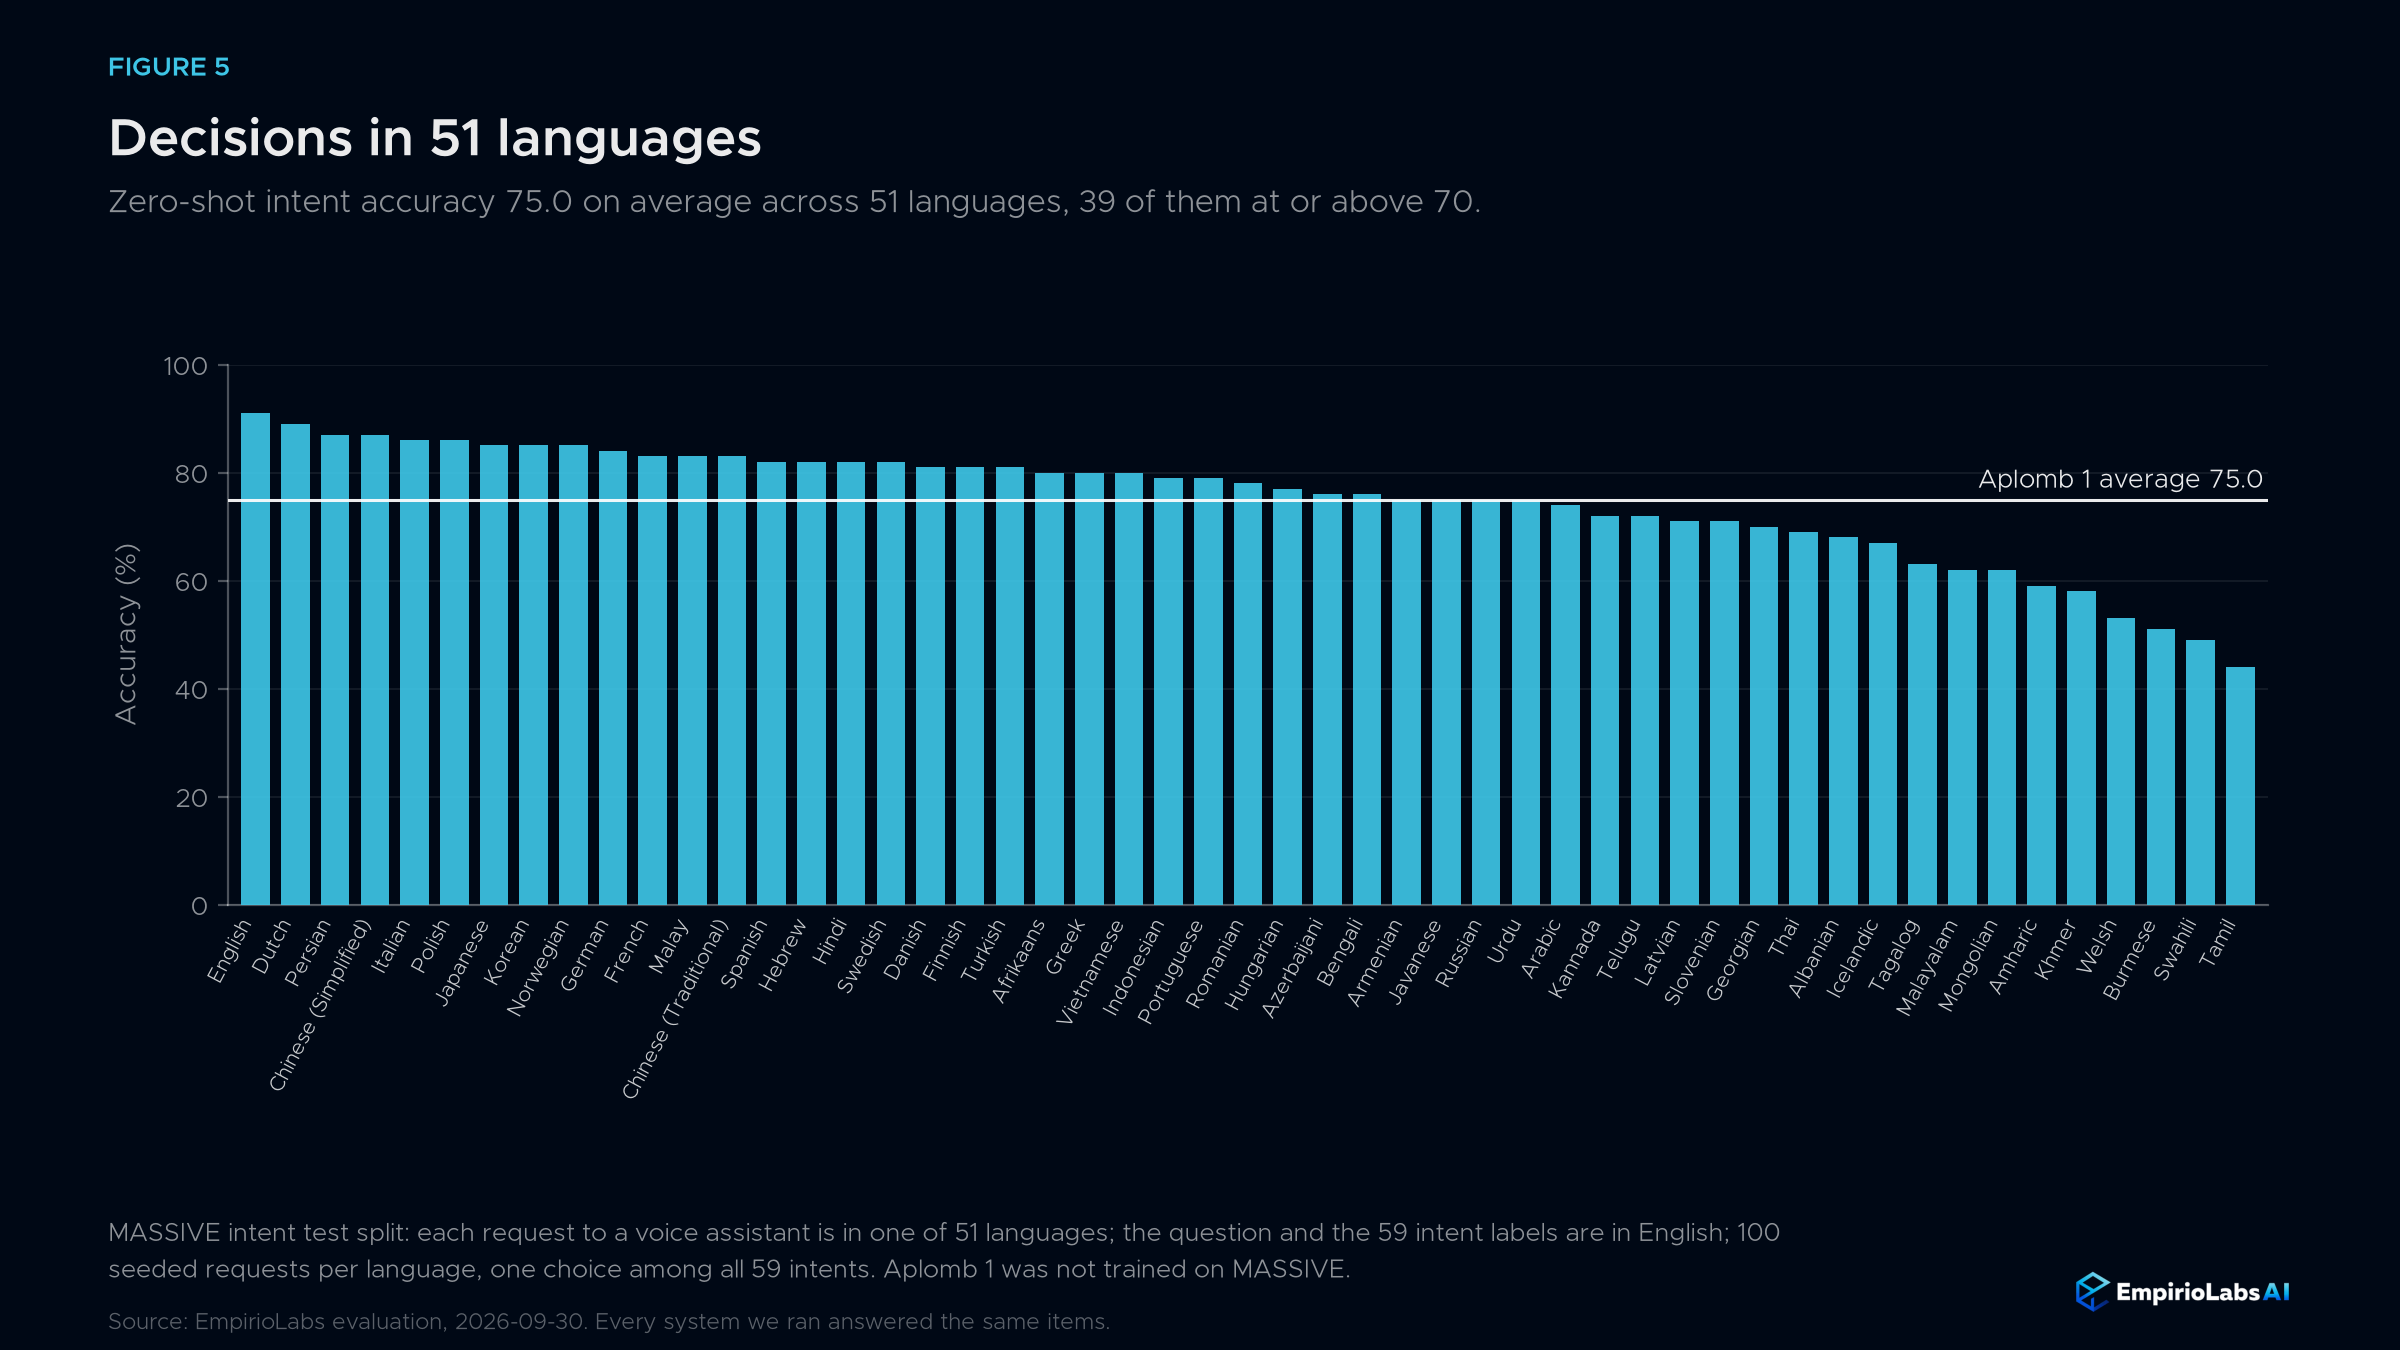
Aplomb 1 决定多种语言的文本,而不仅仅是英语。在 MASSIVE 中,每个语音助手请求都用 51 种语言中的一种书写,而问题和 59 个意图标签则保持英文。在没有任何 MASSIVE 培训的情况下,Aplomb 1 在 59 种意图中选择时平均 75.0%,英语为 91.0%,其中 39 种意图中达到 70% 或以上。
参考,Laya 项目报告其多语言模型在相同 51 种语言中选择 20 种意图时为 40.1%,JevK5 项目报告英语中 60 种意图中为 73.8%。
决策指数
决策指数 0.2.1(2026年10月5日)
决策指数0.2.1平均涵盖五个领域38个公开基准:知识与推理、语言理解、检索与分类、工具与自动化,以及艺术与人类品味。每个基准均经过概率修正,0表示随机猜测,100表示完美。
我们于2026年10月5日在Aplomb 1上运行了官方套件,回答了全部150,317个可评分请求。Aplomb 1的评分为44.86。这是我们自己的套件运行版本,不是发布板上的条目。
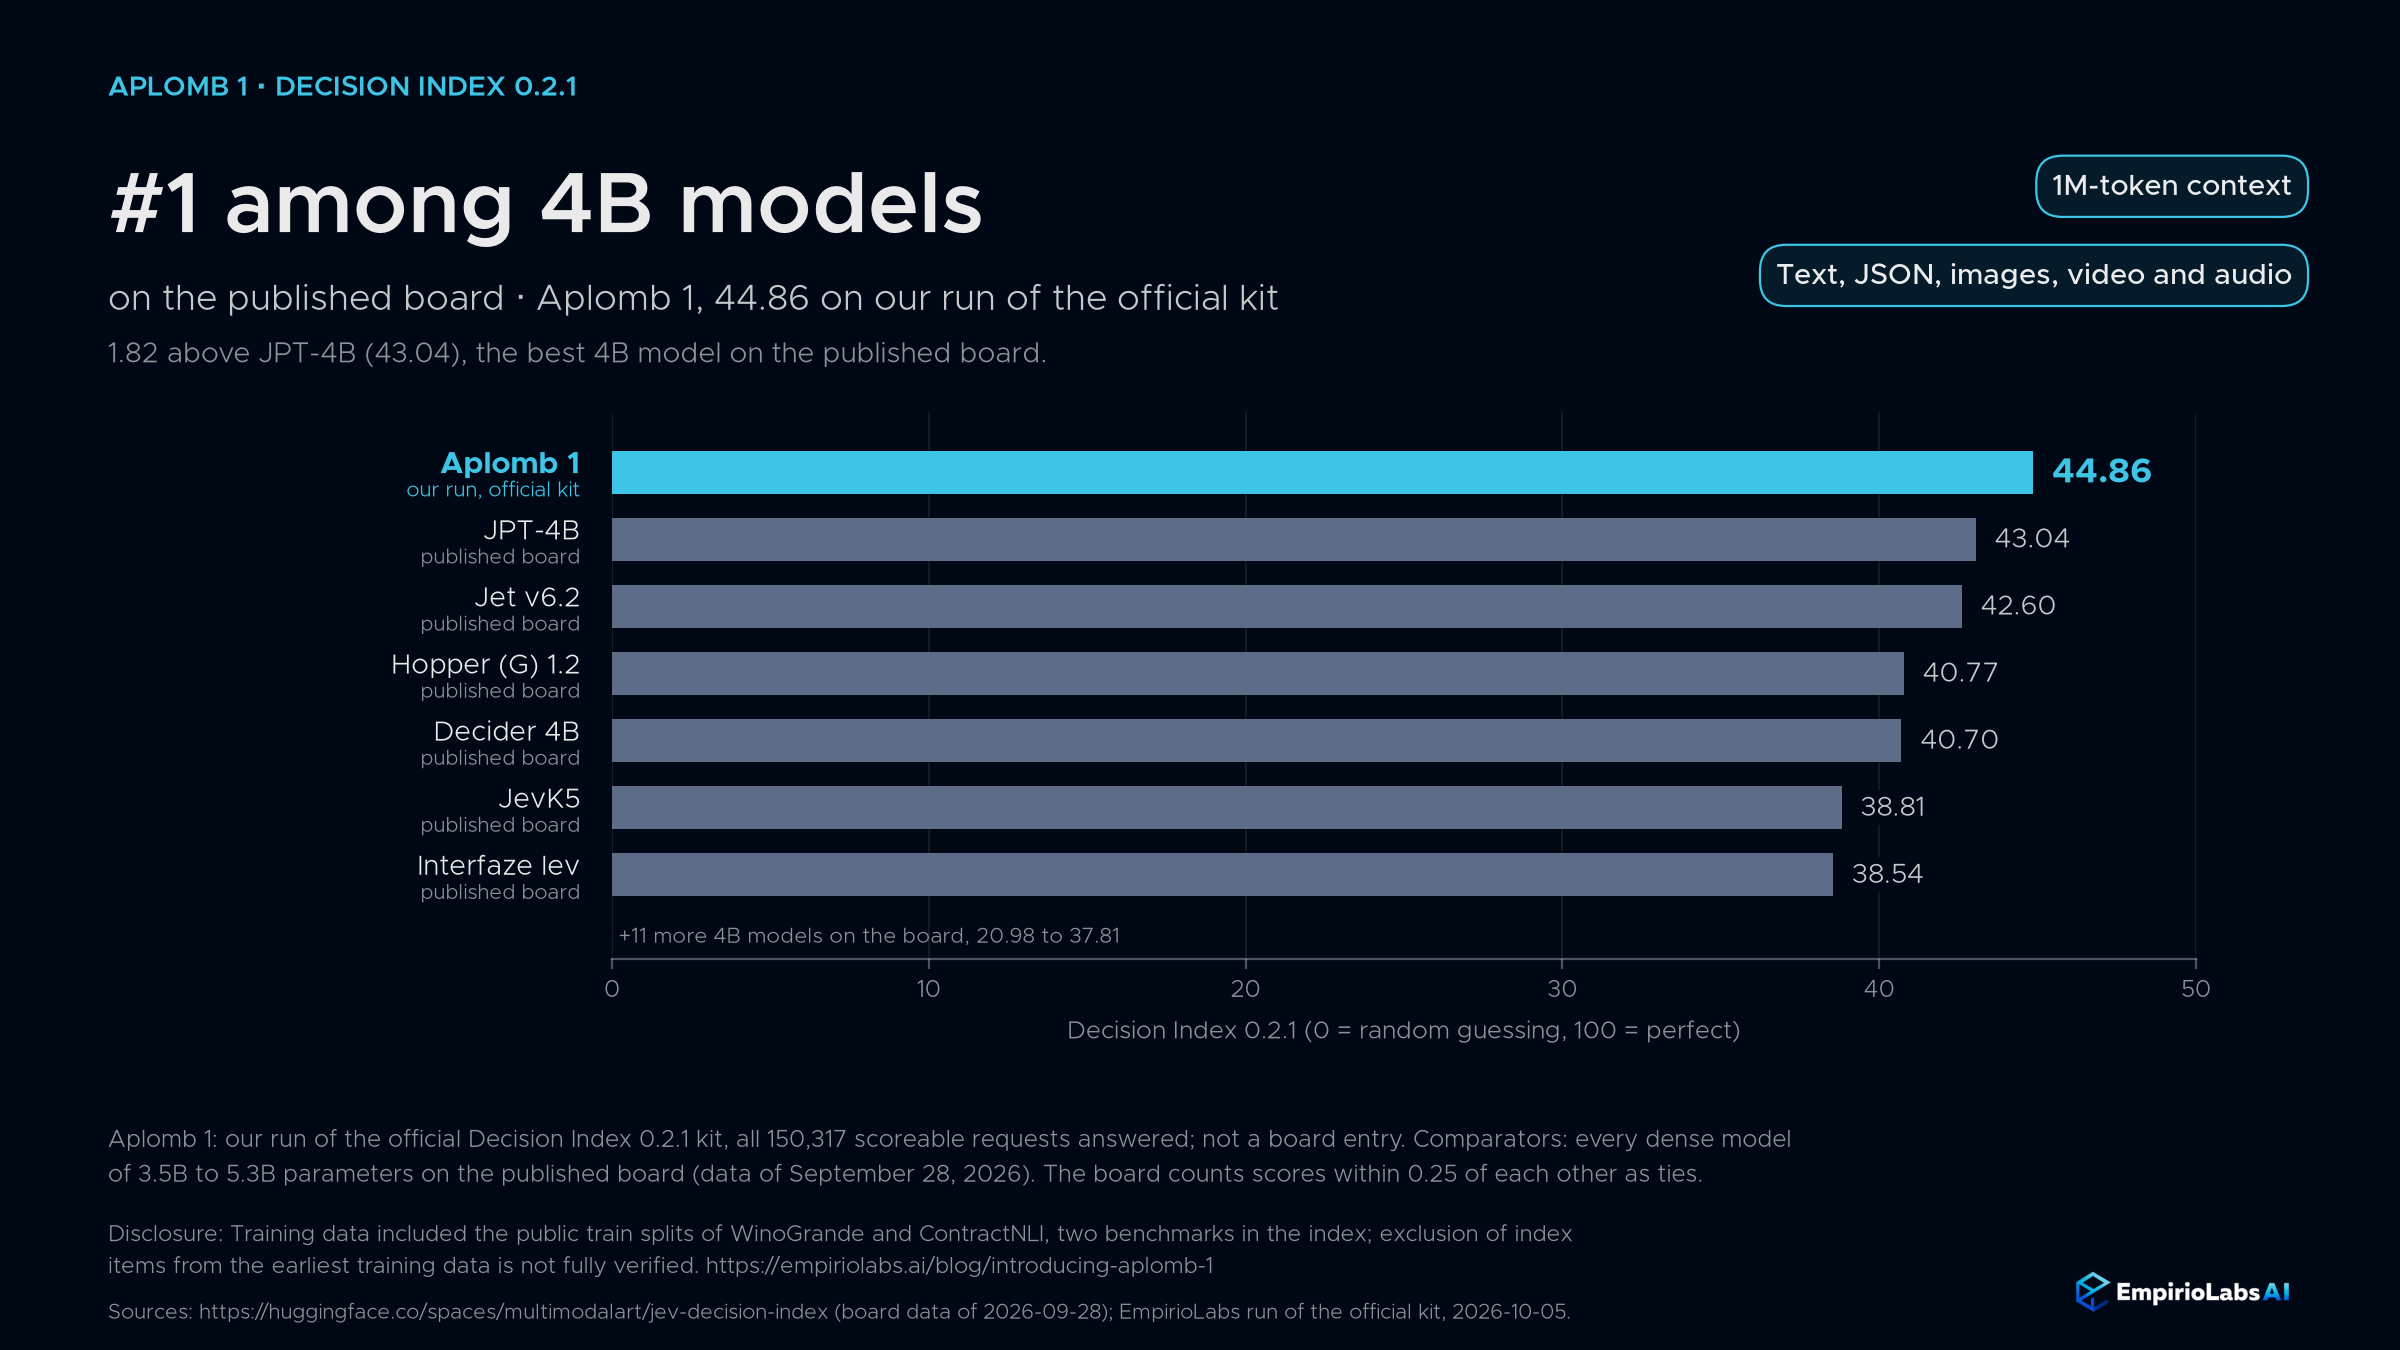
在发布的Decision Index 0.2.1板(数据截至2026年9月28日)中,Aplomb 1在4B模型中排名第91,在38个基准测试中有8项参数达到53亿的模型中排名第#1,包括MMLU-Pro、GPQA Diamond和BBH。在该板上,4B模型的最高分是JPT-4B的43.04,比Aplomb 1低1.82分。
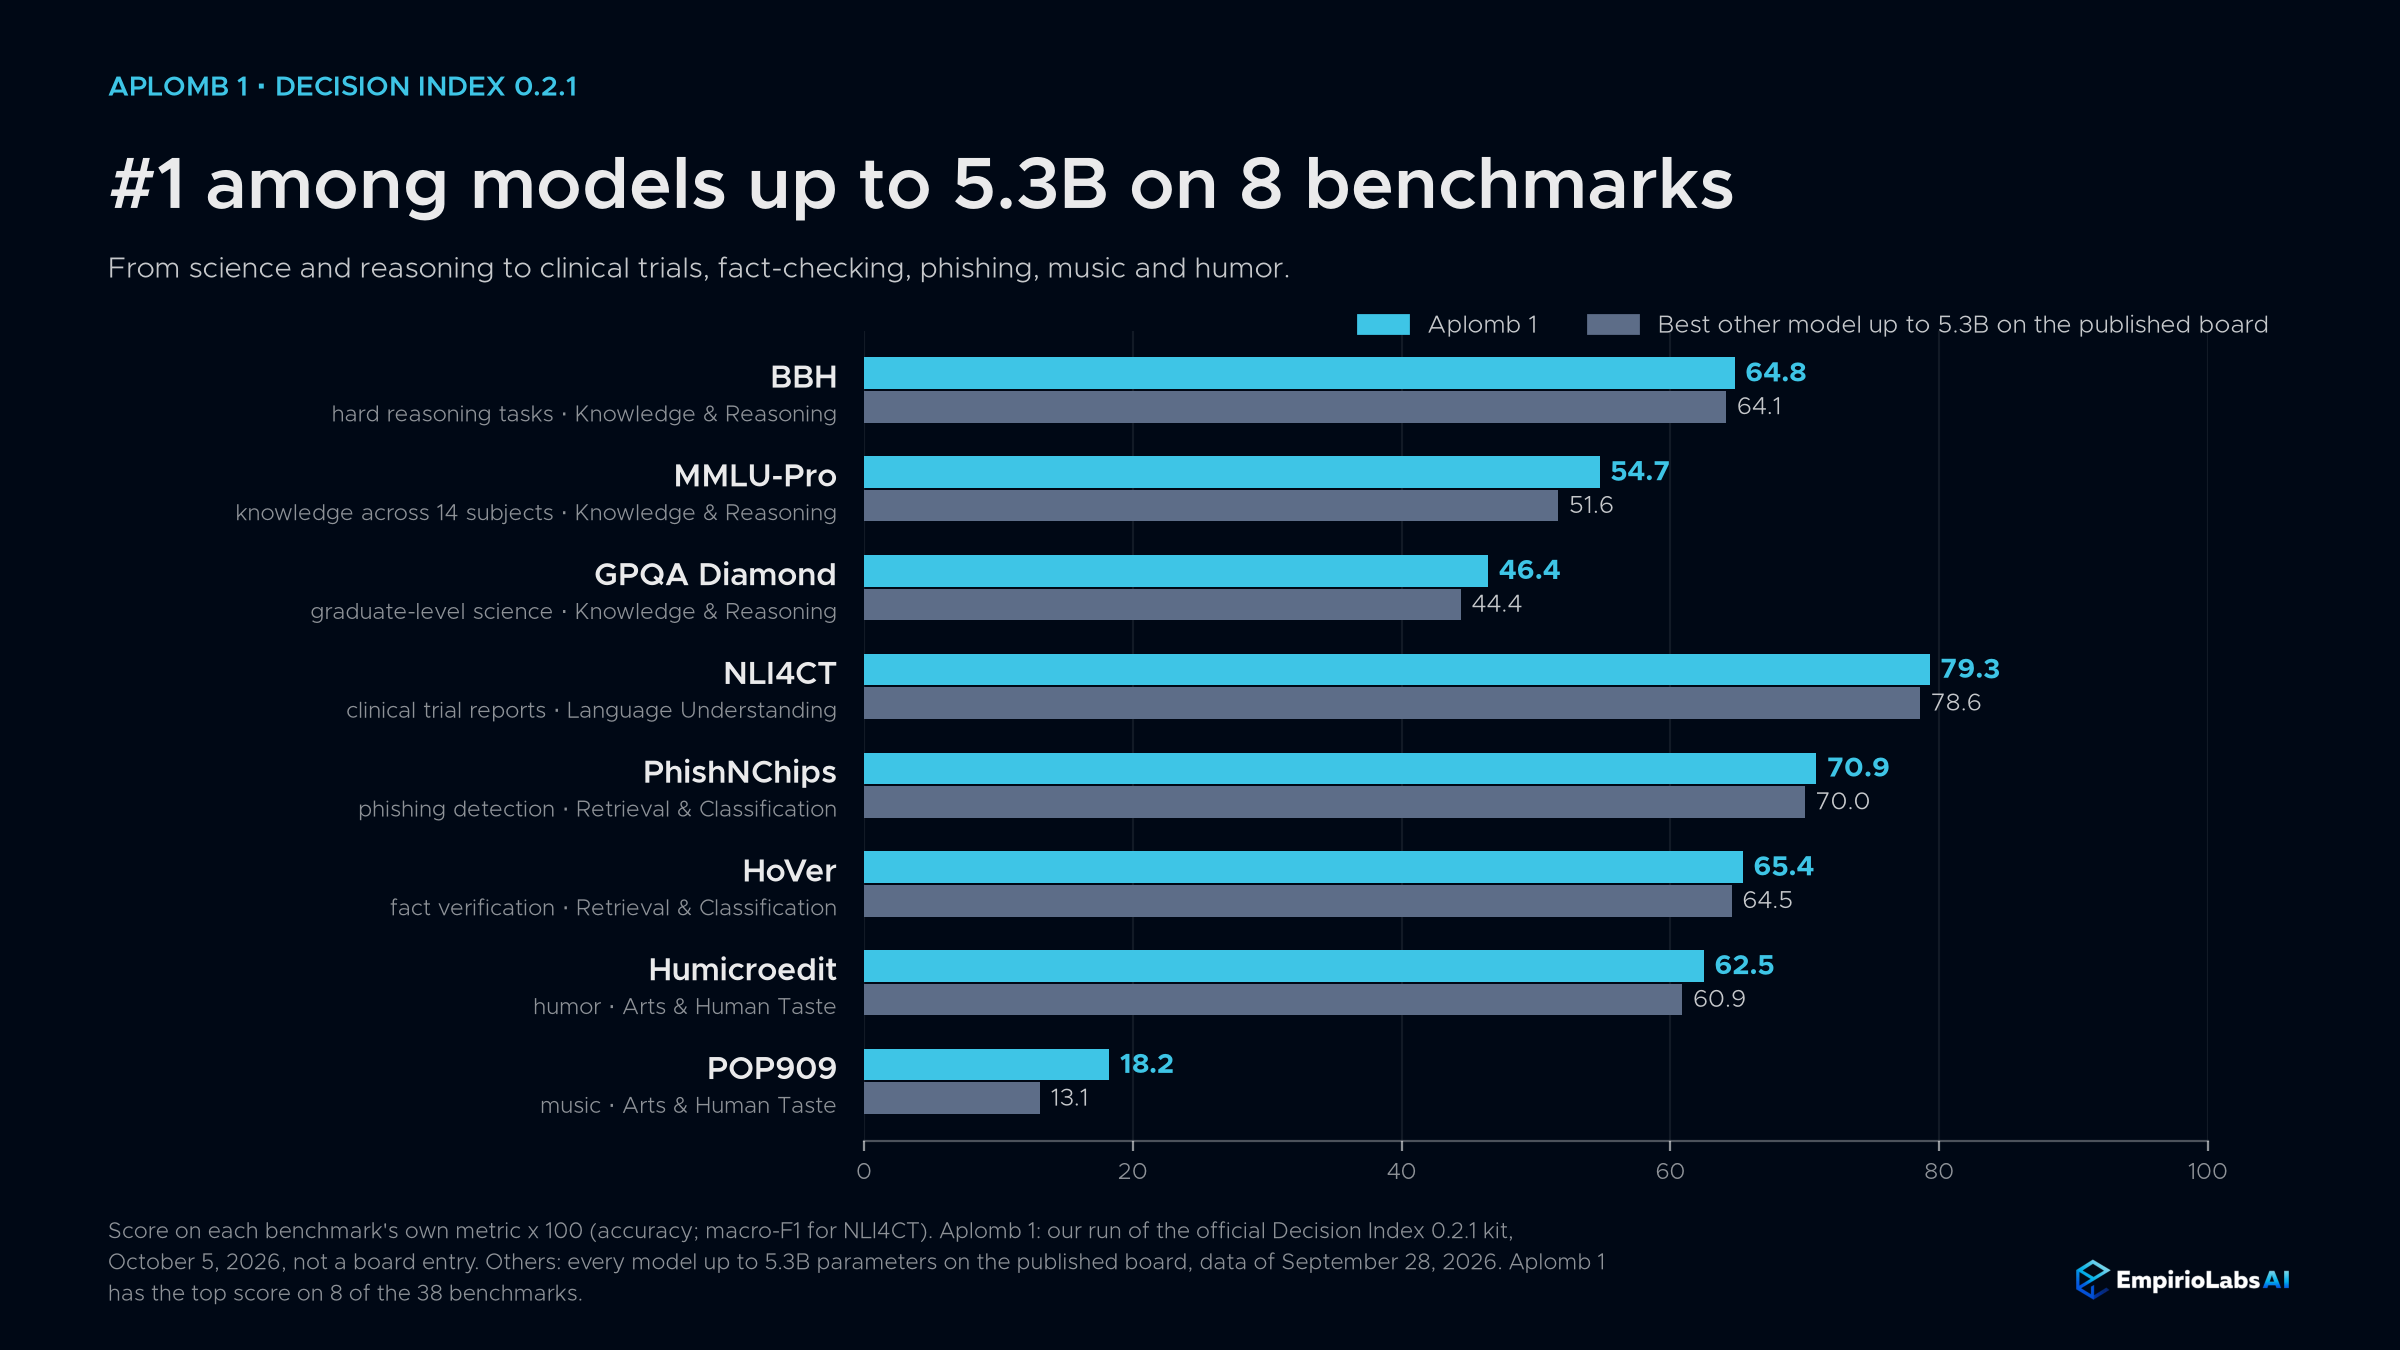
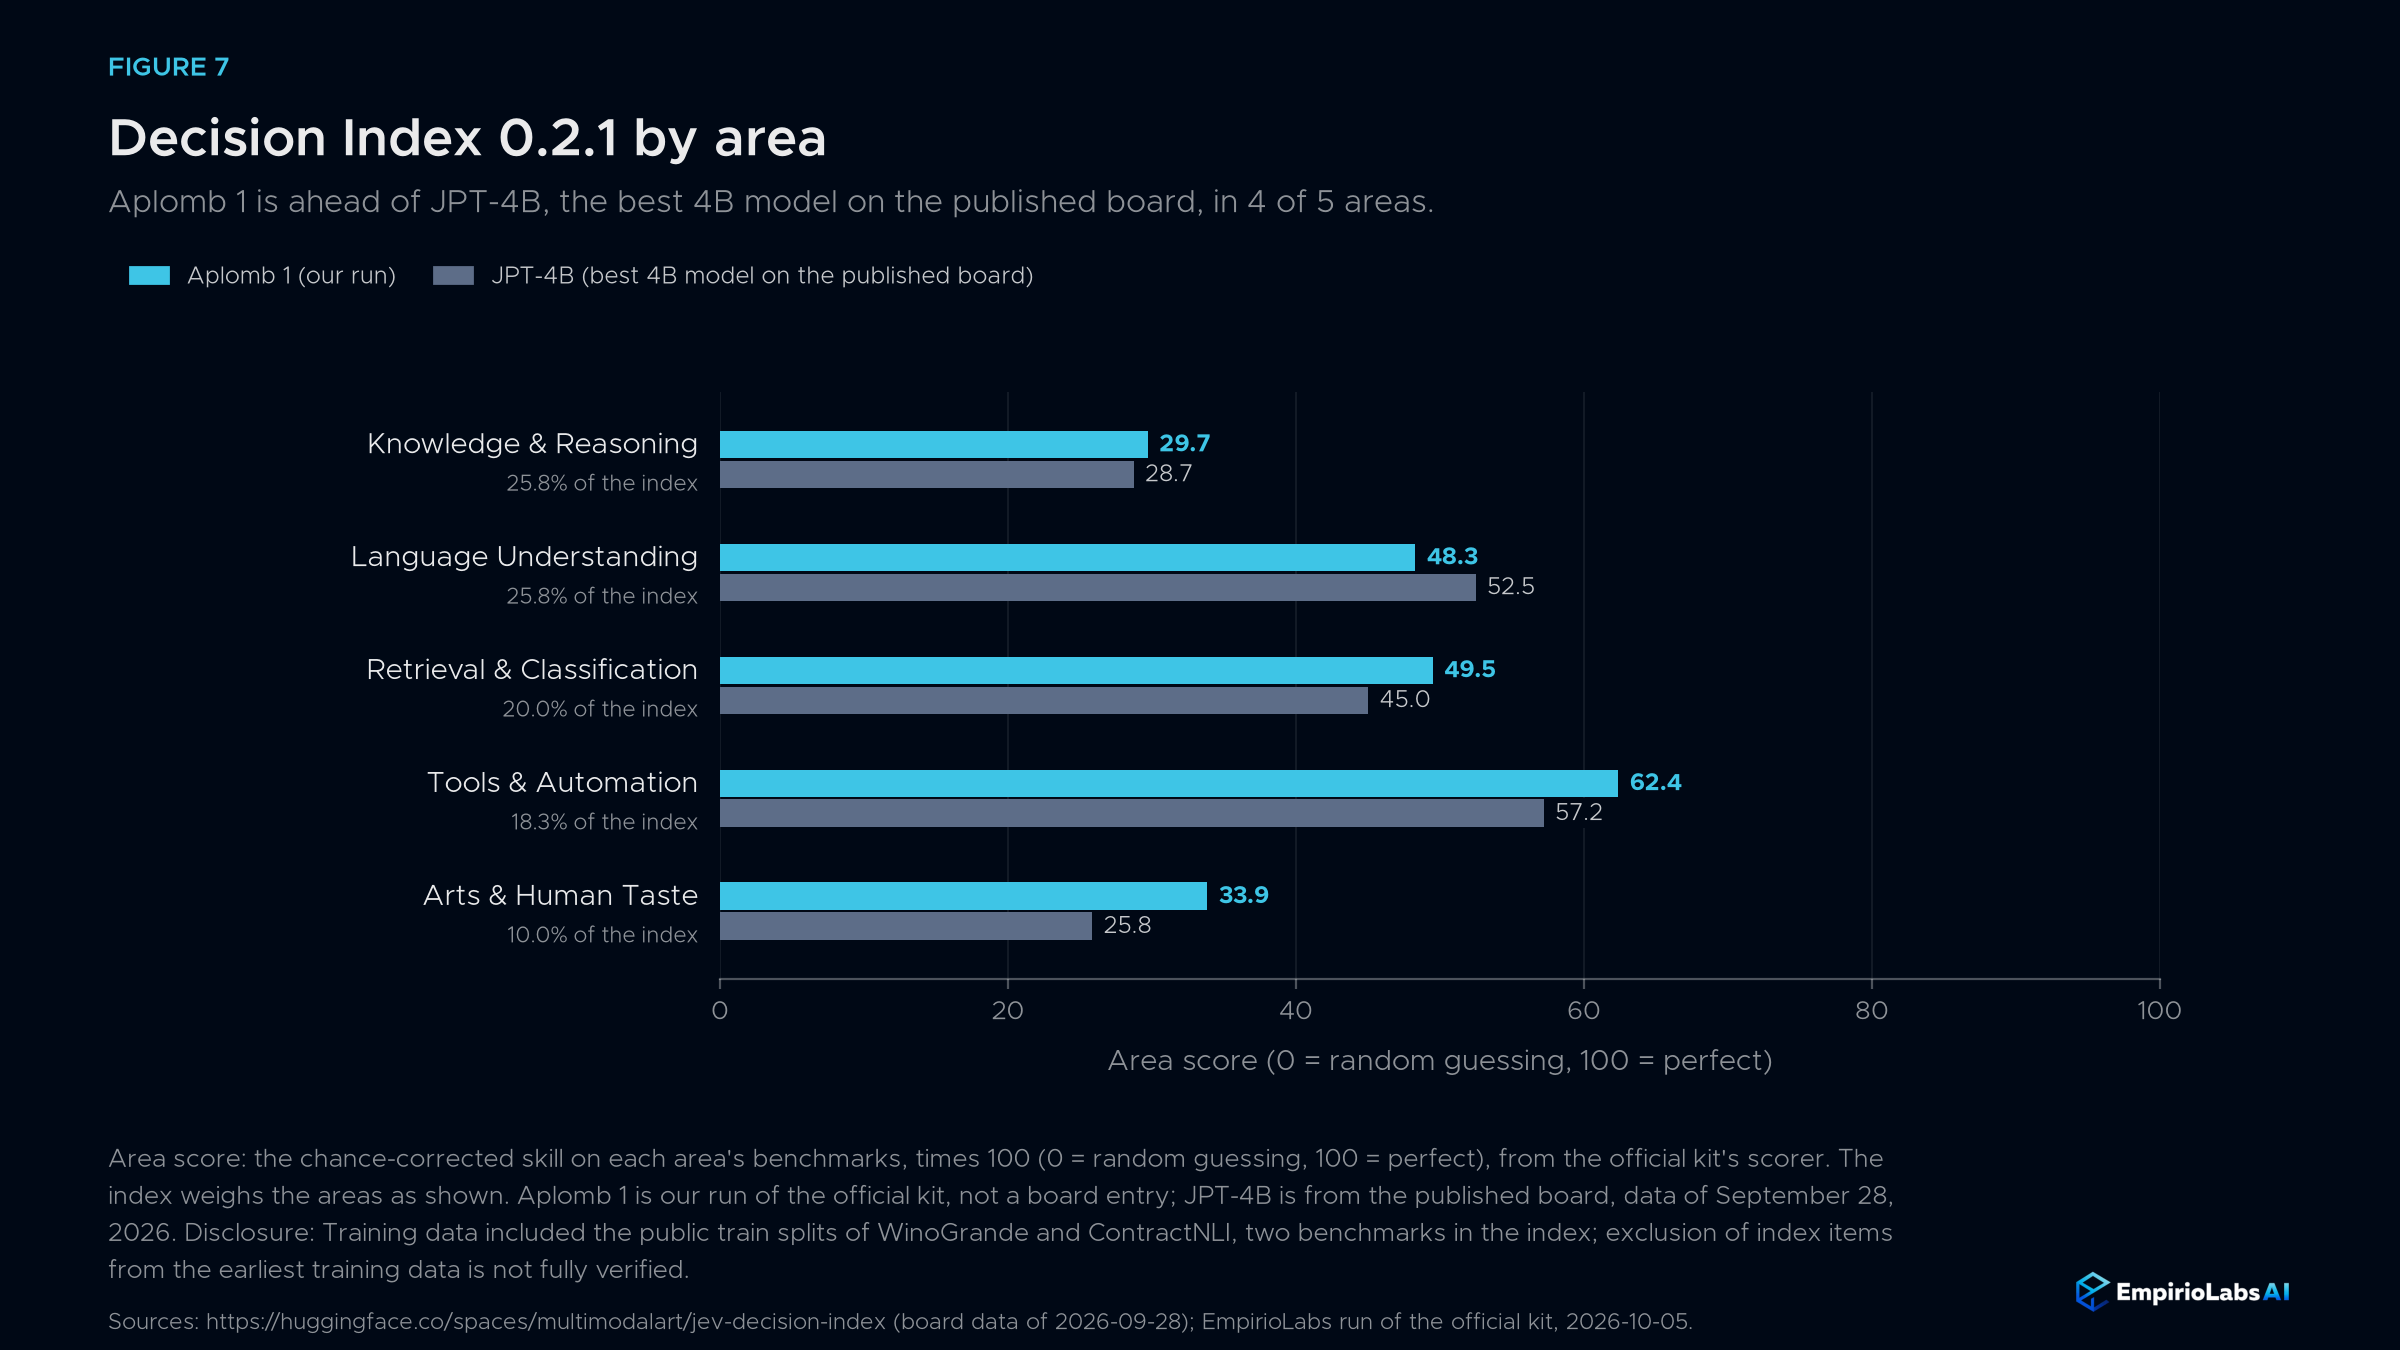
按领域划分,Aplomb 1在工具与自动化(62.4)以及检索与分类(49.5)方面得分最高。与JPT-4B相比,它在五个领域中的四个领先,在语言理解方面落后(48.3对52.5)。
决策指数 0.3.2(2026年10月12日)
Aplomb 1 在 Hugging Face 上发布的决策指数 0.3.2 板上,在 37 个公共文本基准上排名 149 个决策模型,在另外 11 个基准中排名 33 个愿景模型。在 2026 年 10 月 12 日的板块上,它在三项测试中位列其规模类别的 #1:
- R-Bench-M关于科学、工程和医学图片的专家问题:29.6,在Vision板上25B以下的模特中排名第1。下一个25B的模特,12B,得分24.9,最佳4B模特19.5。只有26B到36B的模特得分更高。
- GPQA钻石,196道博士级科学题:48.0%,在8B以下模特中排名第1(次为44.9%)。
- cfcolor,5,000条色彩调色板偏好预测:65.6%,在8B以下模特中文本板排名第#1(次为64.7%)。
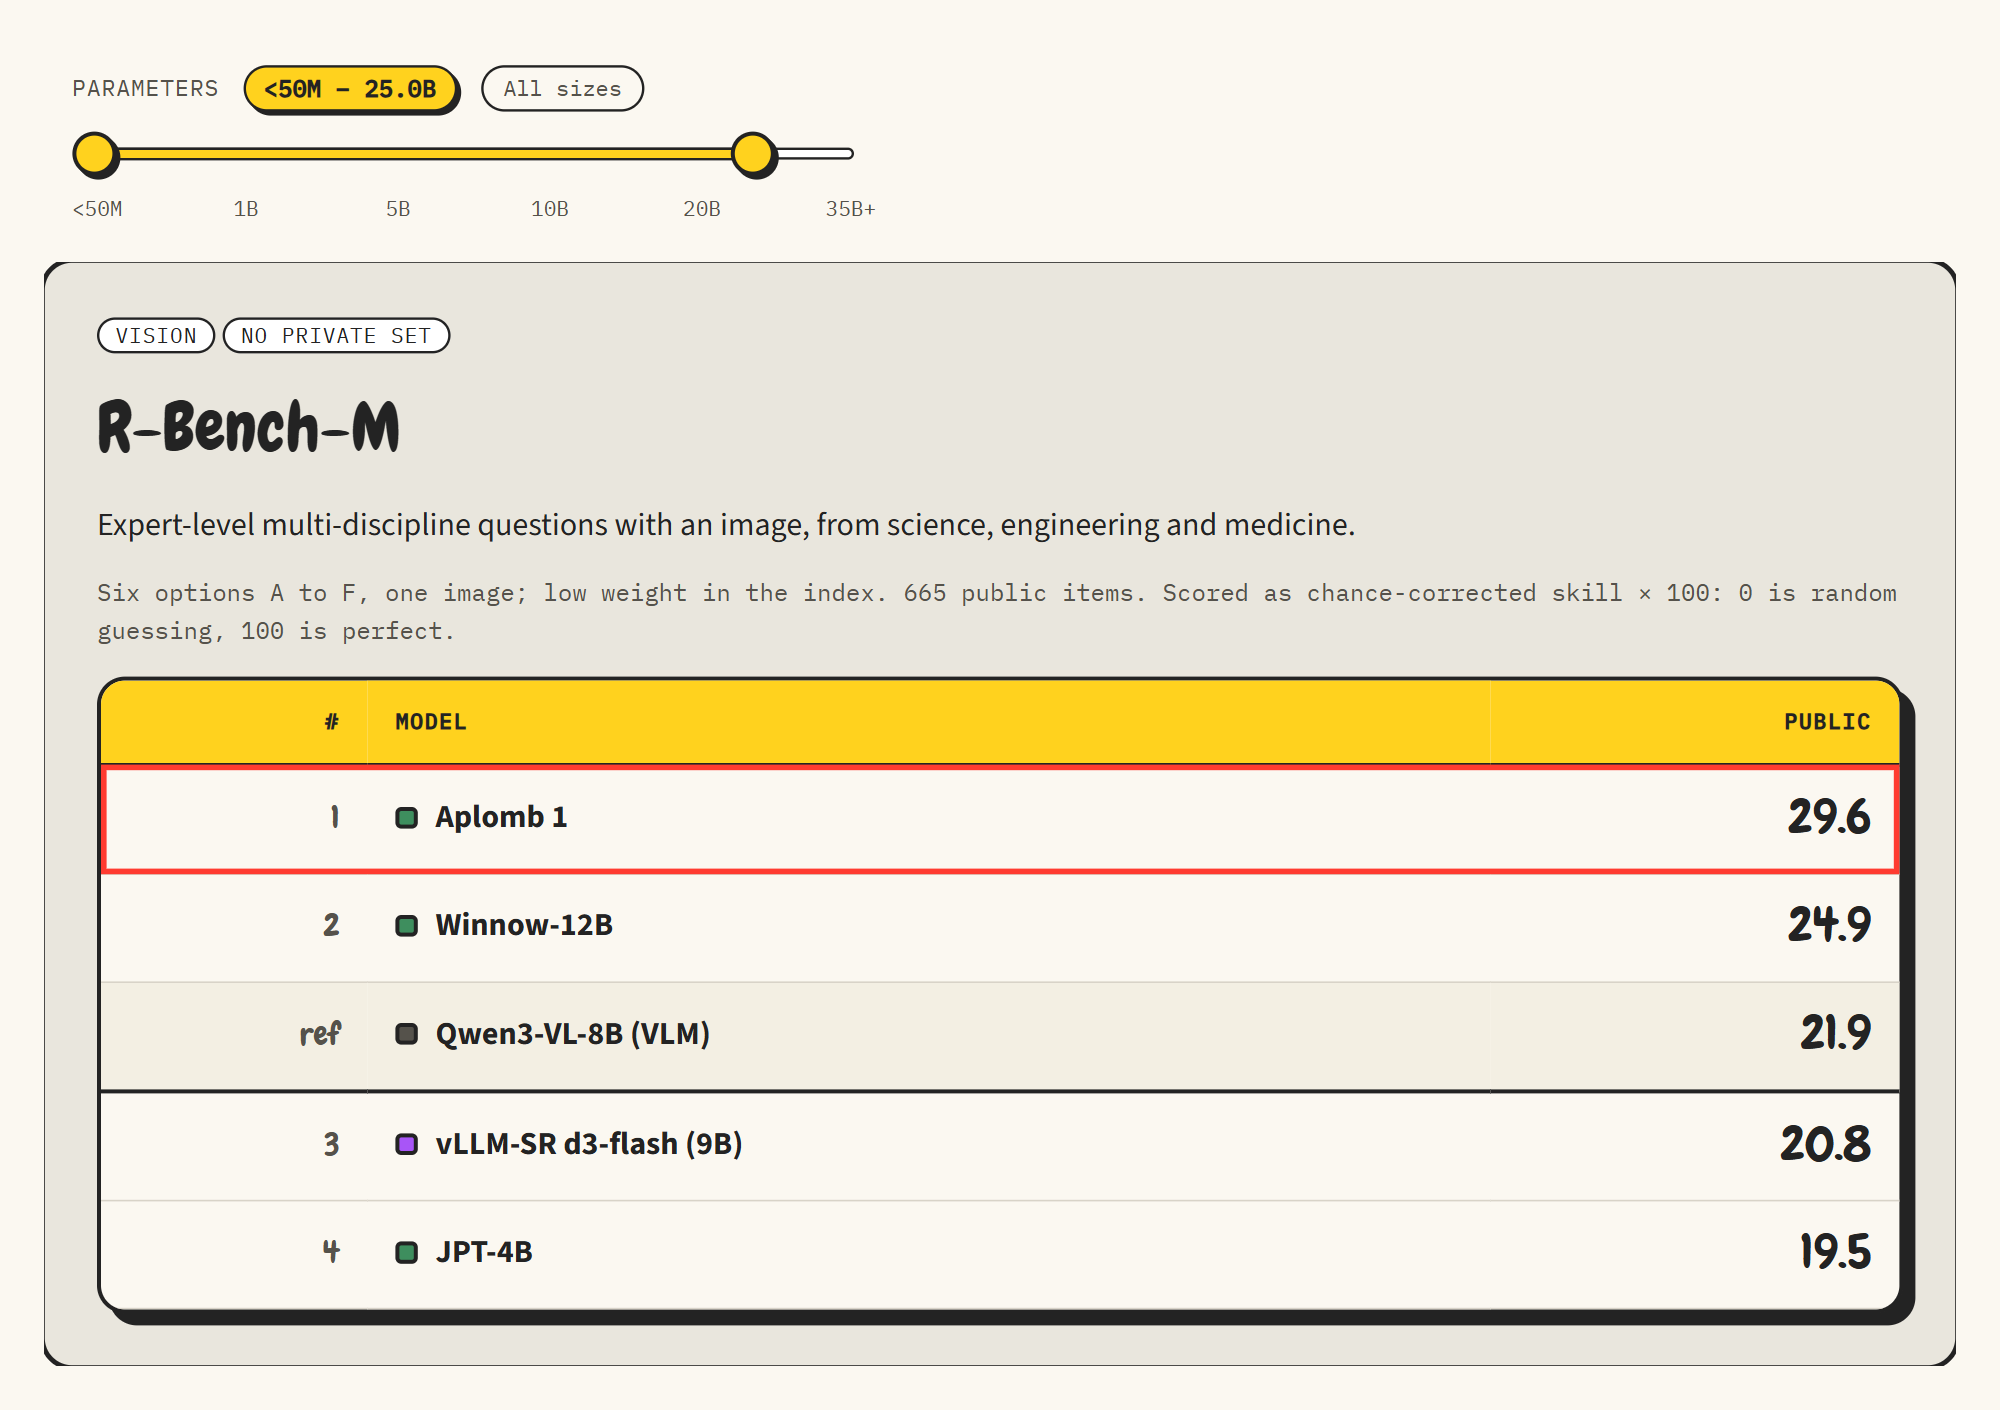
要查看此视图,请打开 愿景板,将参数设为25B,并打开R-Bench-M的完整排名。
披露。 Aplomb 1的训练数据包括WinoGrande和ContractNLI的公共列车拆分,这两项基准器均为决策指数0.2.1和0.3.2中的基准。我们无法完全验证索引项目是否被排除在最早的训练数据中。
打字决策
Typed Decisions 是官方的 Hugging Face 基准测试(LocalLLaMA/typed-decisions).其测试分配包含400个案例和2000个决定,每个答案均为与金色分布的概率分布。2026年10月8日,其排行榜在默认视图中将Aplomb 1在KL与金分布的分歧度(0.123)和Brier分数(0.065)方面排名为#1;两者均较低更佳。以53亿的成绩领先于约其五倍的27B模型,后者得分分别为0.204和0.097。
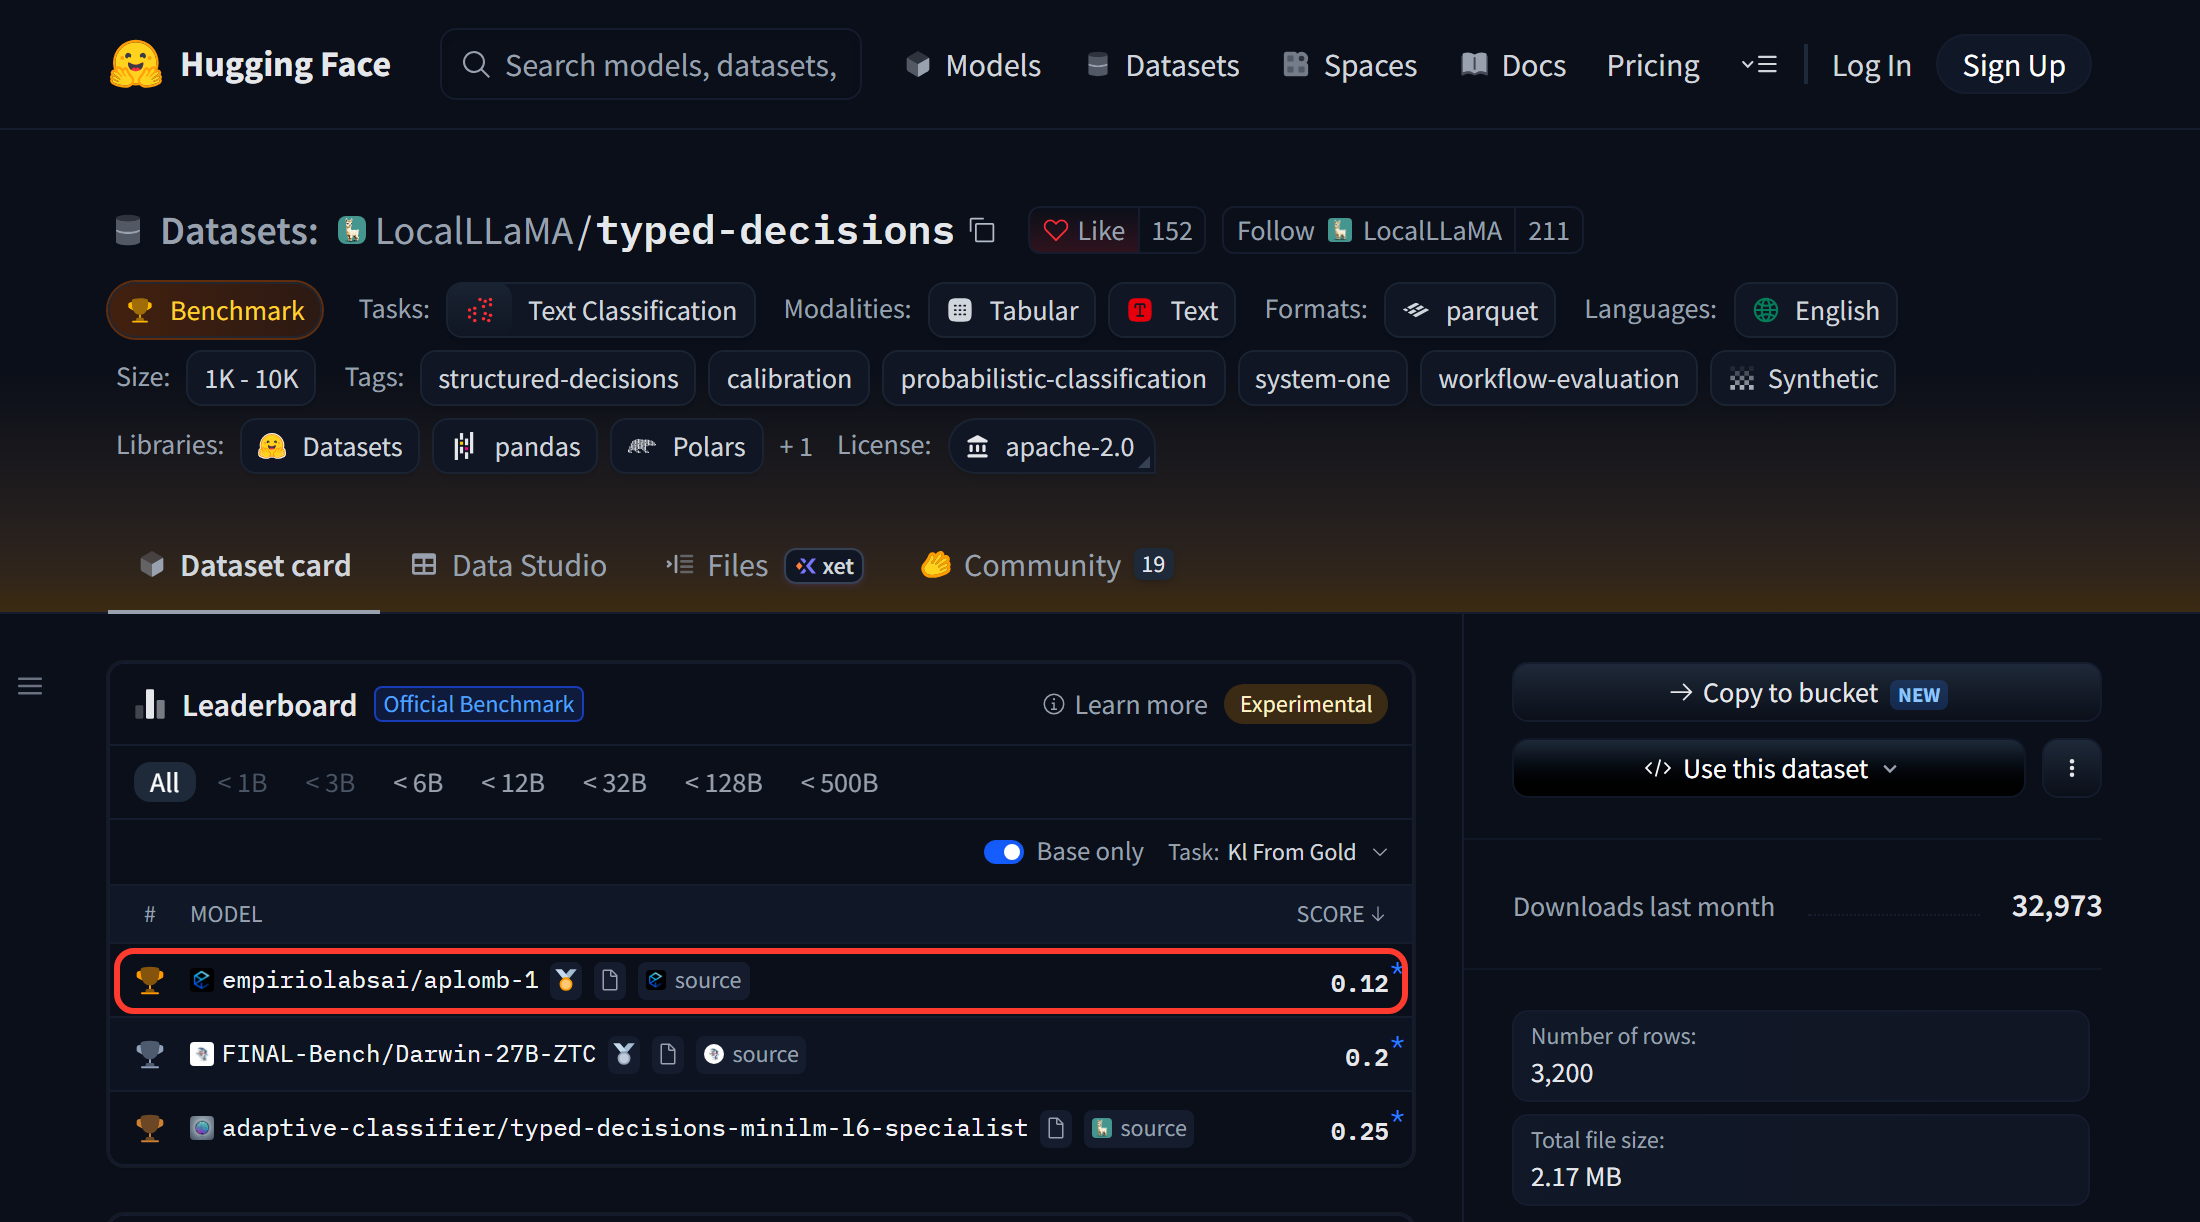
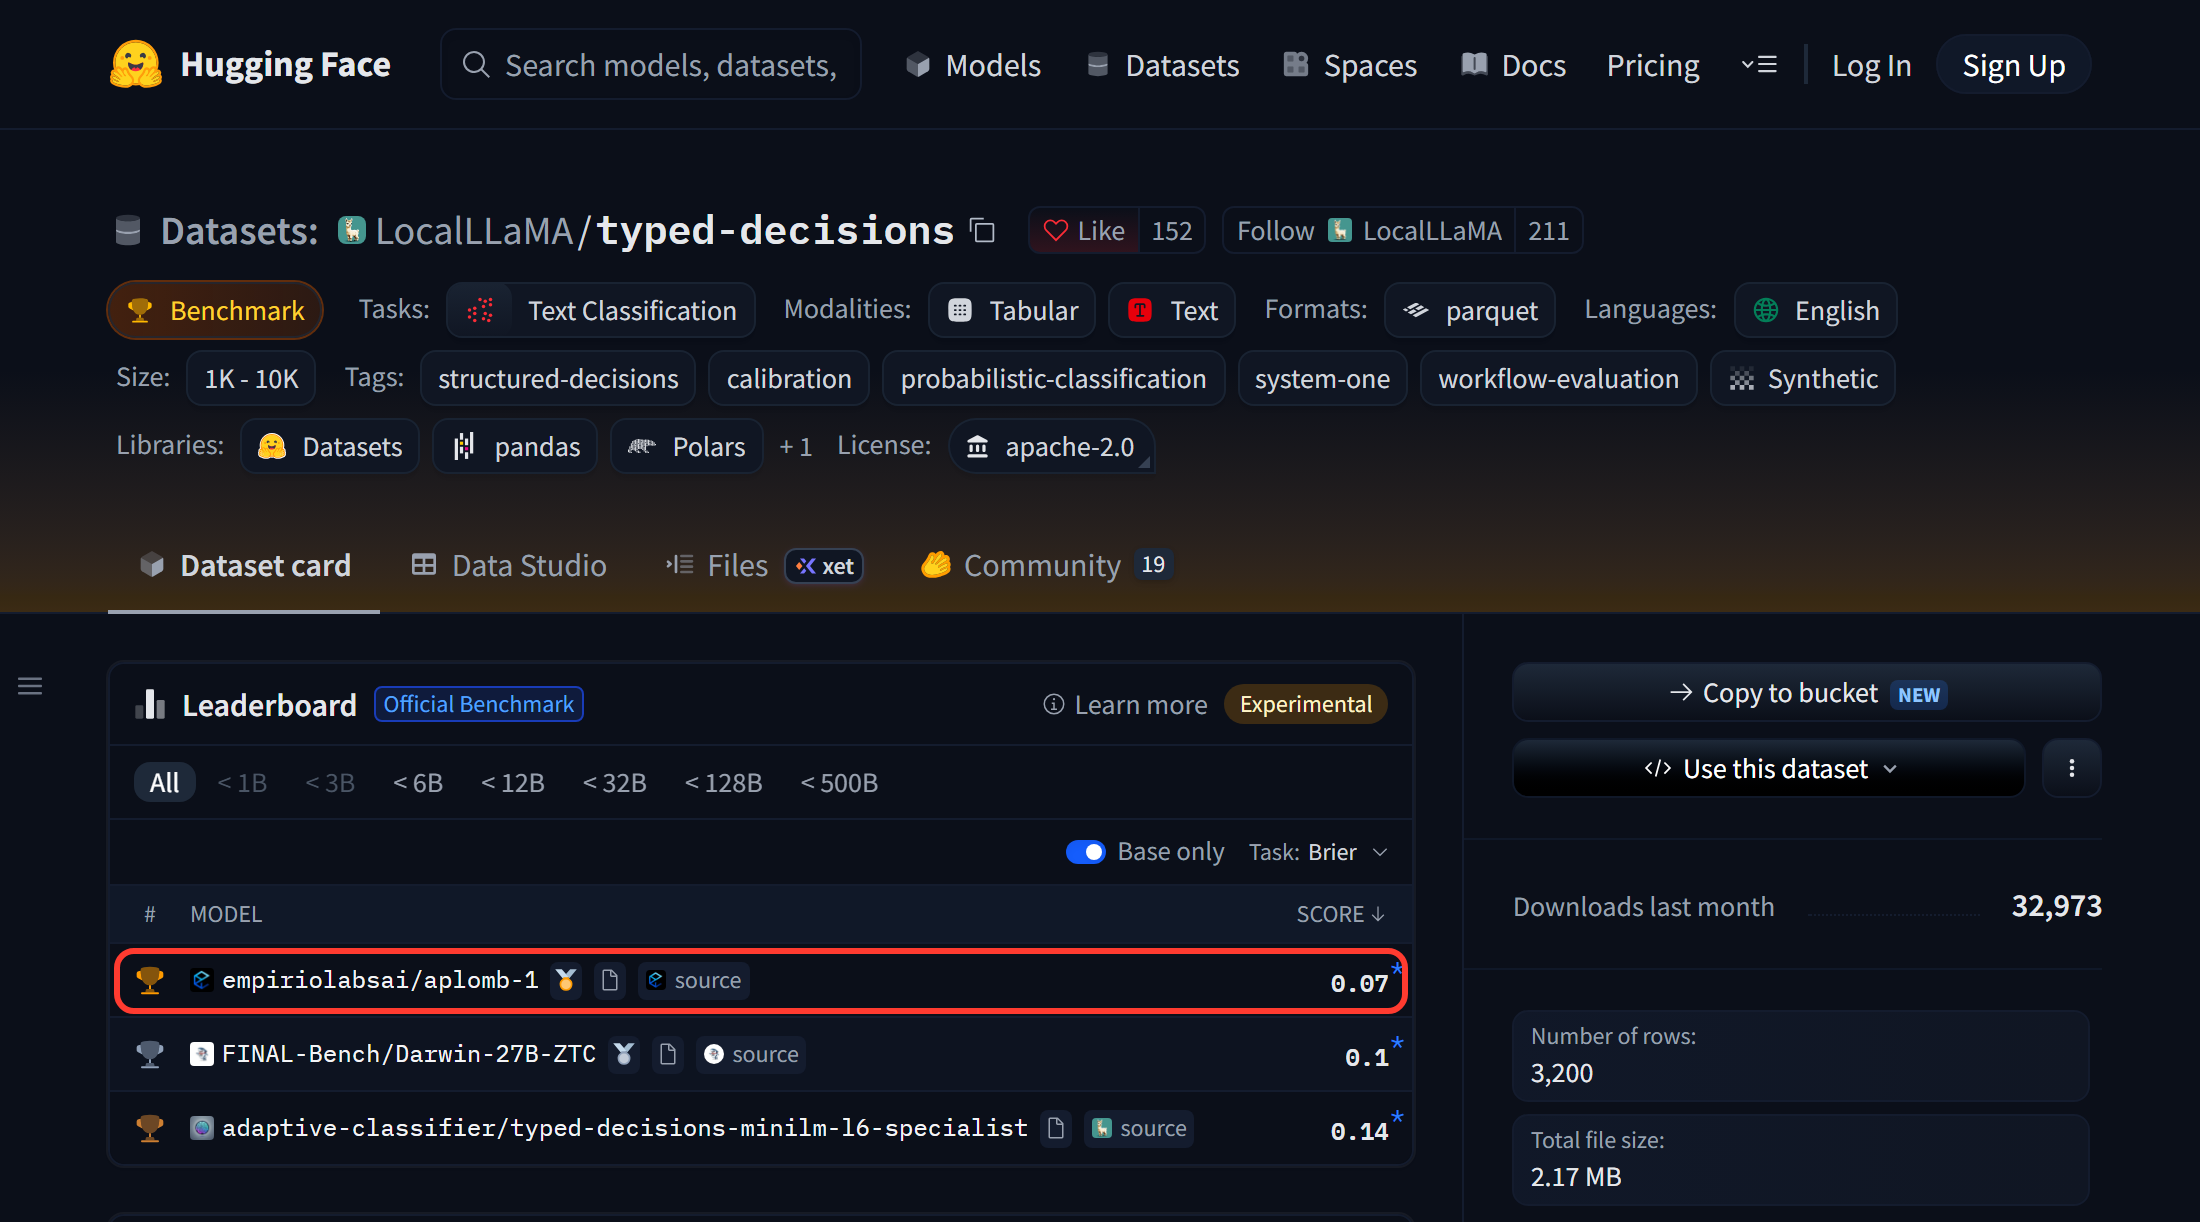
排行榜上的结果由每个模型作者自行报告。Aplomb 1的训练数据包括基准的训练分段;测试分段未用于训练。
相比如何
根据截至2026年9月29日的官方文档,以及截至2026年10月6日的价格,每个决策模型或API接受和回答的内容:
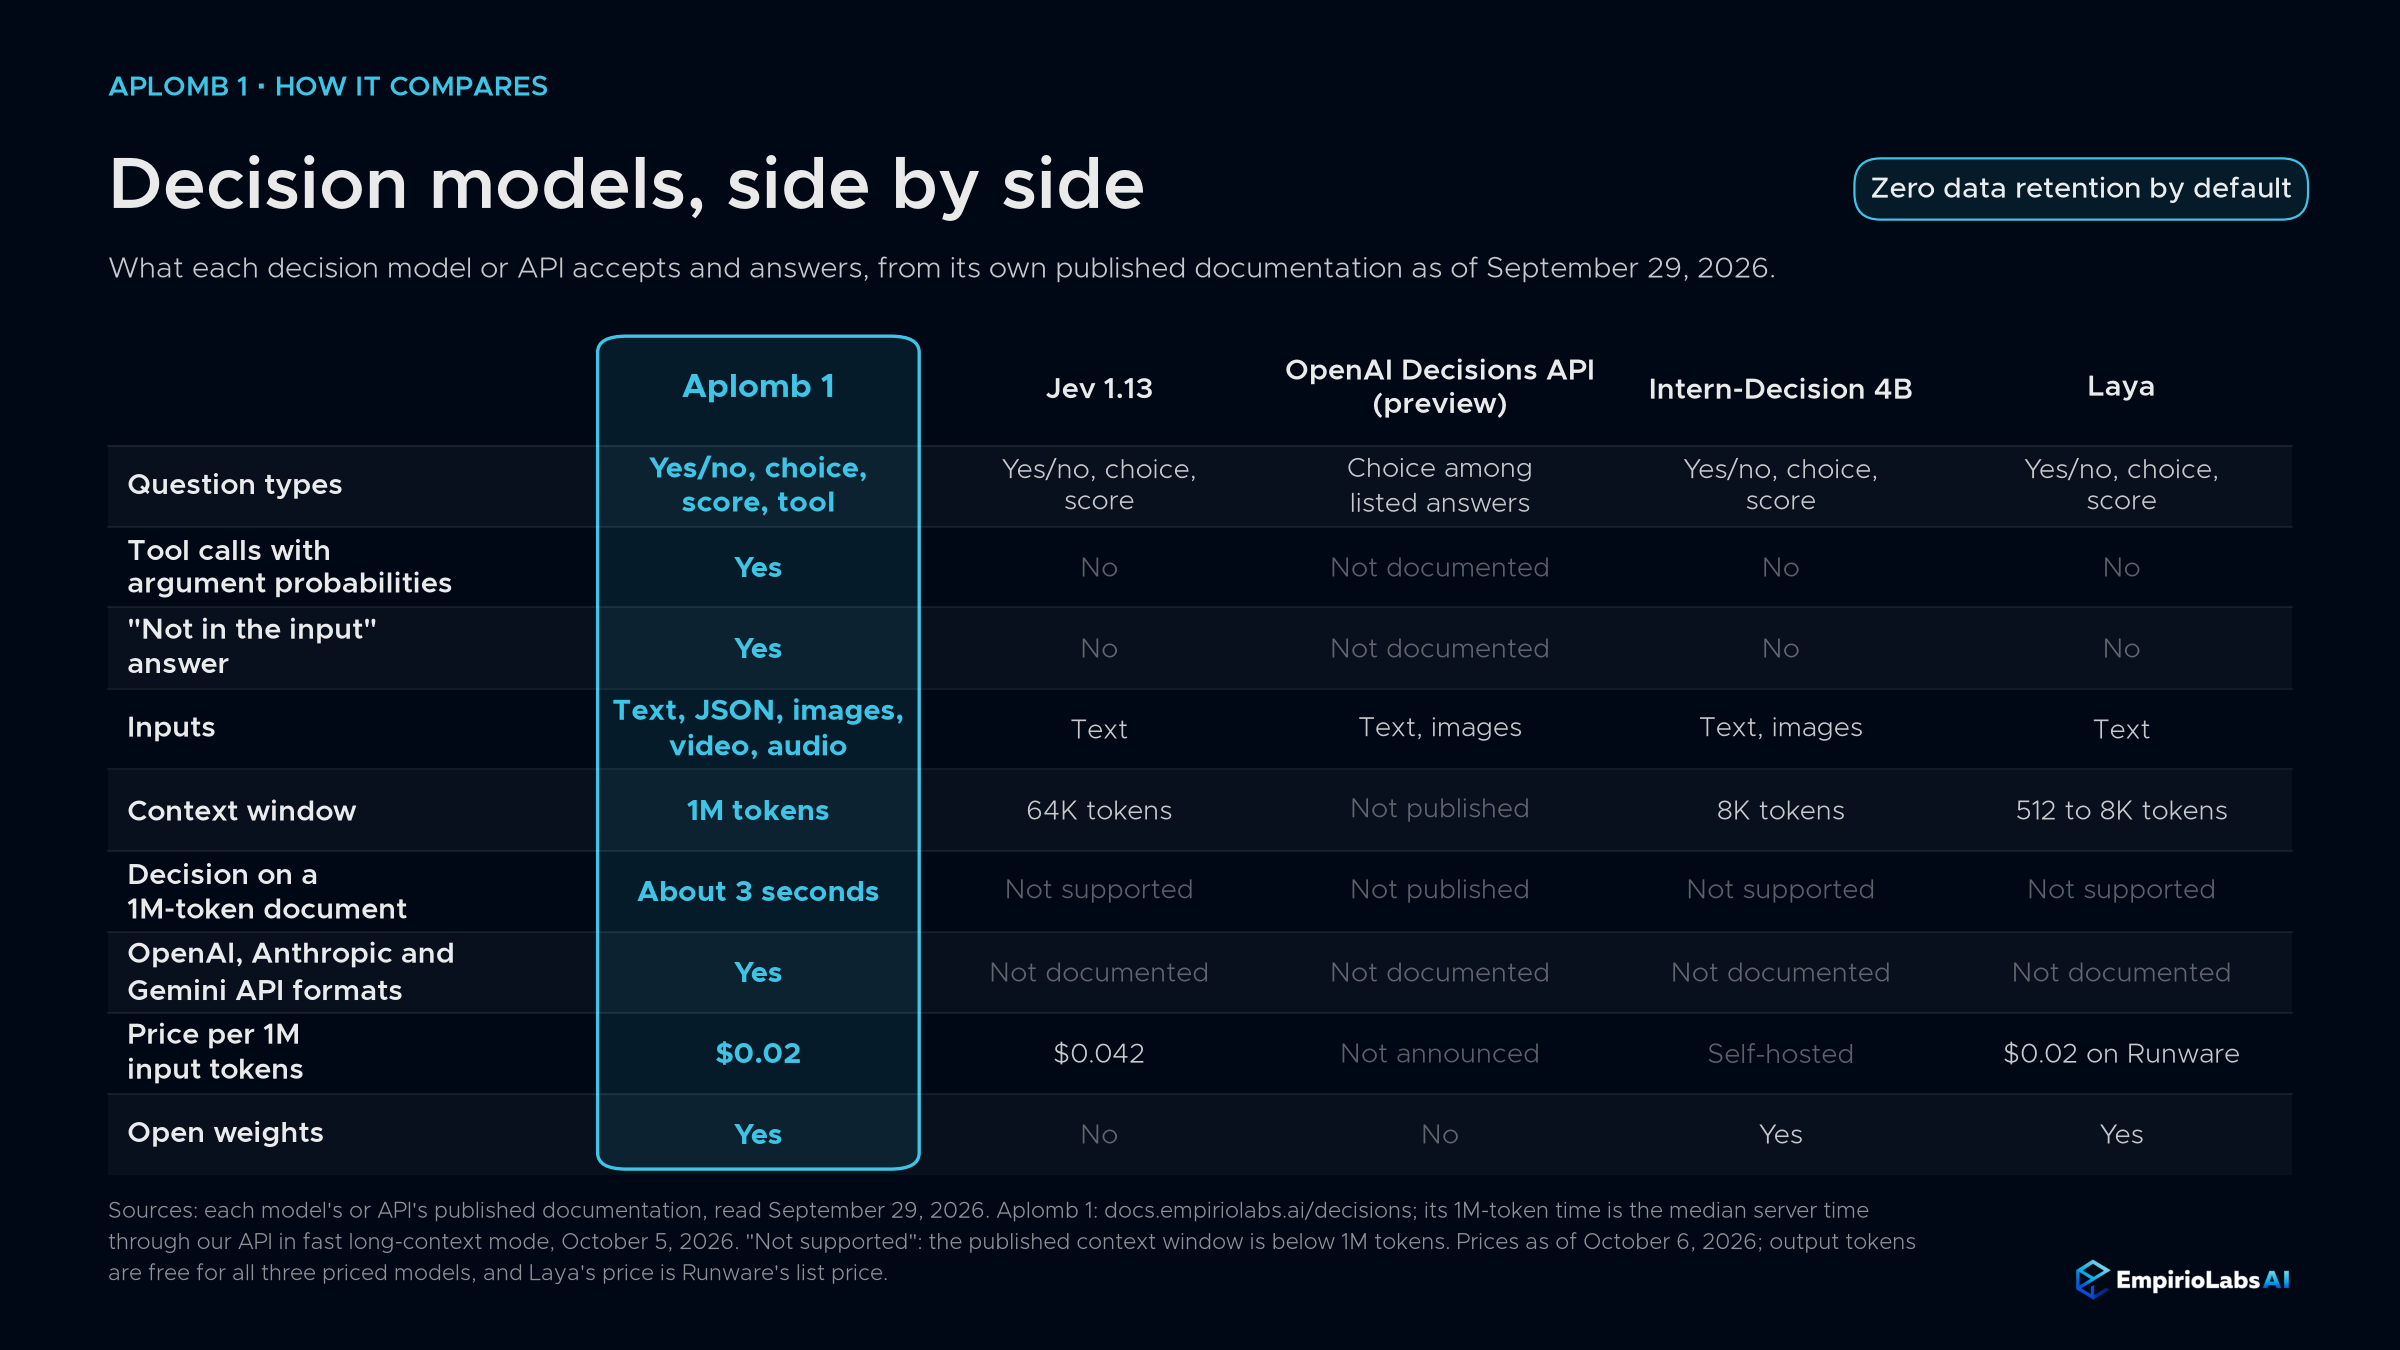
| 装甲1 | Jev 1.13 | OpenAI 决策 API(预览版) | 实习生决策4B | 拉亚 | |
|---|---|---|---|---|---|
| 题型 | 是或否,选择,评分,工具 | 是或否,选择,评分 | 在列出的答案中选择 | 是或否,选择,评分 | 是或否,选择,评分 |
| 带参数概率的工具选择 | 是的 | 不 | 未记录 | 不 | 不 |
| 州里的答案不是这样 | 是的 | 不 | 未记录 | 不 | 不 |
| 输入 | 文本、JSON、图片、视频、音频 | 正文 | 文本,图片 | 文本,图片 | 正文 |
| 窗户 | 1,000,000 代币 | 64K代币 | 未发表 | 8,192枚代币 | 512到8,192代币 |
| 每100万输入代币的价格 | $0.02 | $0.042 | 未公布 | 自托管 | $0.02 Runware |
| 开放式重量 | 是的 | 不 | 不 | 是的 | 是的 |
速度与计费
Aplomb 1 运行在EmpirioLabs自身的决策模型推理运行时上。一个短问题大约需要15毫秒的模型时间,一个带有图像的问题大约需要35毫秒,一个包含15,000令牌的文档大约需要0.3秒,一个100万令牌的状态在快速长上下文模式下大约需要3秒,默认值超过131,072个令牌,或全程读取约111秒。
你只为输入代币付费:每个请求一次状态和每个问题的文本,绝不为提示模板付费。输出代币始终为零。当前速率是 模型页面 页:1 定价页面。 。 。.
默认为零数据保留:我们不会保留您的请求或回复内容。
开放式重量
Aplomb 1 基于 Qwen3.5-4B 构建。我们将窗口从262K扩展到100万个令牌,增加了Qwen3-Omni音频编码器的音频输入,添加了自己的决策头,将每个答案以校准概率返回,而非生成文本,并训练了决策模型,包括工具选择和not-in-the-input答案。对于API和Playground,我们构建并优化了自己的推理运行时。
权重和自己运行的参考脚本是 huggingface.co/empiriolabsai/aplomb-1.脚本的回答可能与API略有不同。
年收入低于US$1百万的组织的研究、评估、个人使用和内部使用均可根据EmpirioLabs模型许可免费;将Aplomb 1作为服务托管或将其用于销售给他人的产品则需商业许可。
开始吧
curl https://api.empiriolabs.ai/v1/decisions \ -H “授权:持有人 $EMPIRIOLABS_API_KEY” \ -H “内容类型:application/json” \ -d '{ “型号”:“aplomb-1”, “state”: {“order”: {“id”: “B-44120”, “status”: “已发货”, “付款”: “未付款”}}, “questions”: { “已付款”: {“type”: “noul”, “instructions”: “订单B-44120已付款吗?”, “abstain”: true}, “carrier”: {“type”: “choice”, “instructions”: “哪个承运人正在交付订单B-44120?”, “criteria”: {“UPS”: null, “FedEx”: null, “DHL”: null}, “abstain”: true} } }'有偿 结果是自信地否定。 载体 带着兴奋回来 禁制 概率,因为记录中没有标注载波。完整的模式、媒体输入和限制都在 决策API指南.Aplomb 1 也接受 OpenAI、Anthropic 和 Gemini 格式的请求,所以你可以从他们的 SDK 中调用;指南的 聊天格式 部分展示了聊天请求如何映射到决策。试试在 Playground。 。 。.
致谢
我们在数据、训练、评估和部署等多个方面借助AI代理工具构建了Aplomb 1。感谢Qwen团队为Qwen 3.5和Qwen3-Omni(Aplomb 1基于此构建)、Lambda为我们训练和提供GPU的贡献,以及NVIDIA Inception项目、Z.ai 创业项目和StepFun创业项目的支持。