LightOnOCR-3 4B está disponível no EmpirioLabs. É o modelo OCR de documentos do LightOn: envie um PDF ou uma imagem, e ele retorna cada página como Markdown, com o texto em ordem de leitura, títulos, listas, tabelas, matemática em LaTeX e gráficos como tabelas dos seus pontos de dados. Cada página também retorna com seu layout: o tipo e a posição de cada bloco na página. Ela funciona PÓS-/v1/ocr, na API e na Playground.
Referência. O LightOn reporta uma pontuação geral de 86,3 no olmOCR-Bench para o LightOnOCR-3 4B em seus Anúncio de lançamento de 8 de outubro de 2026.
O que diz
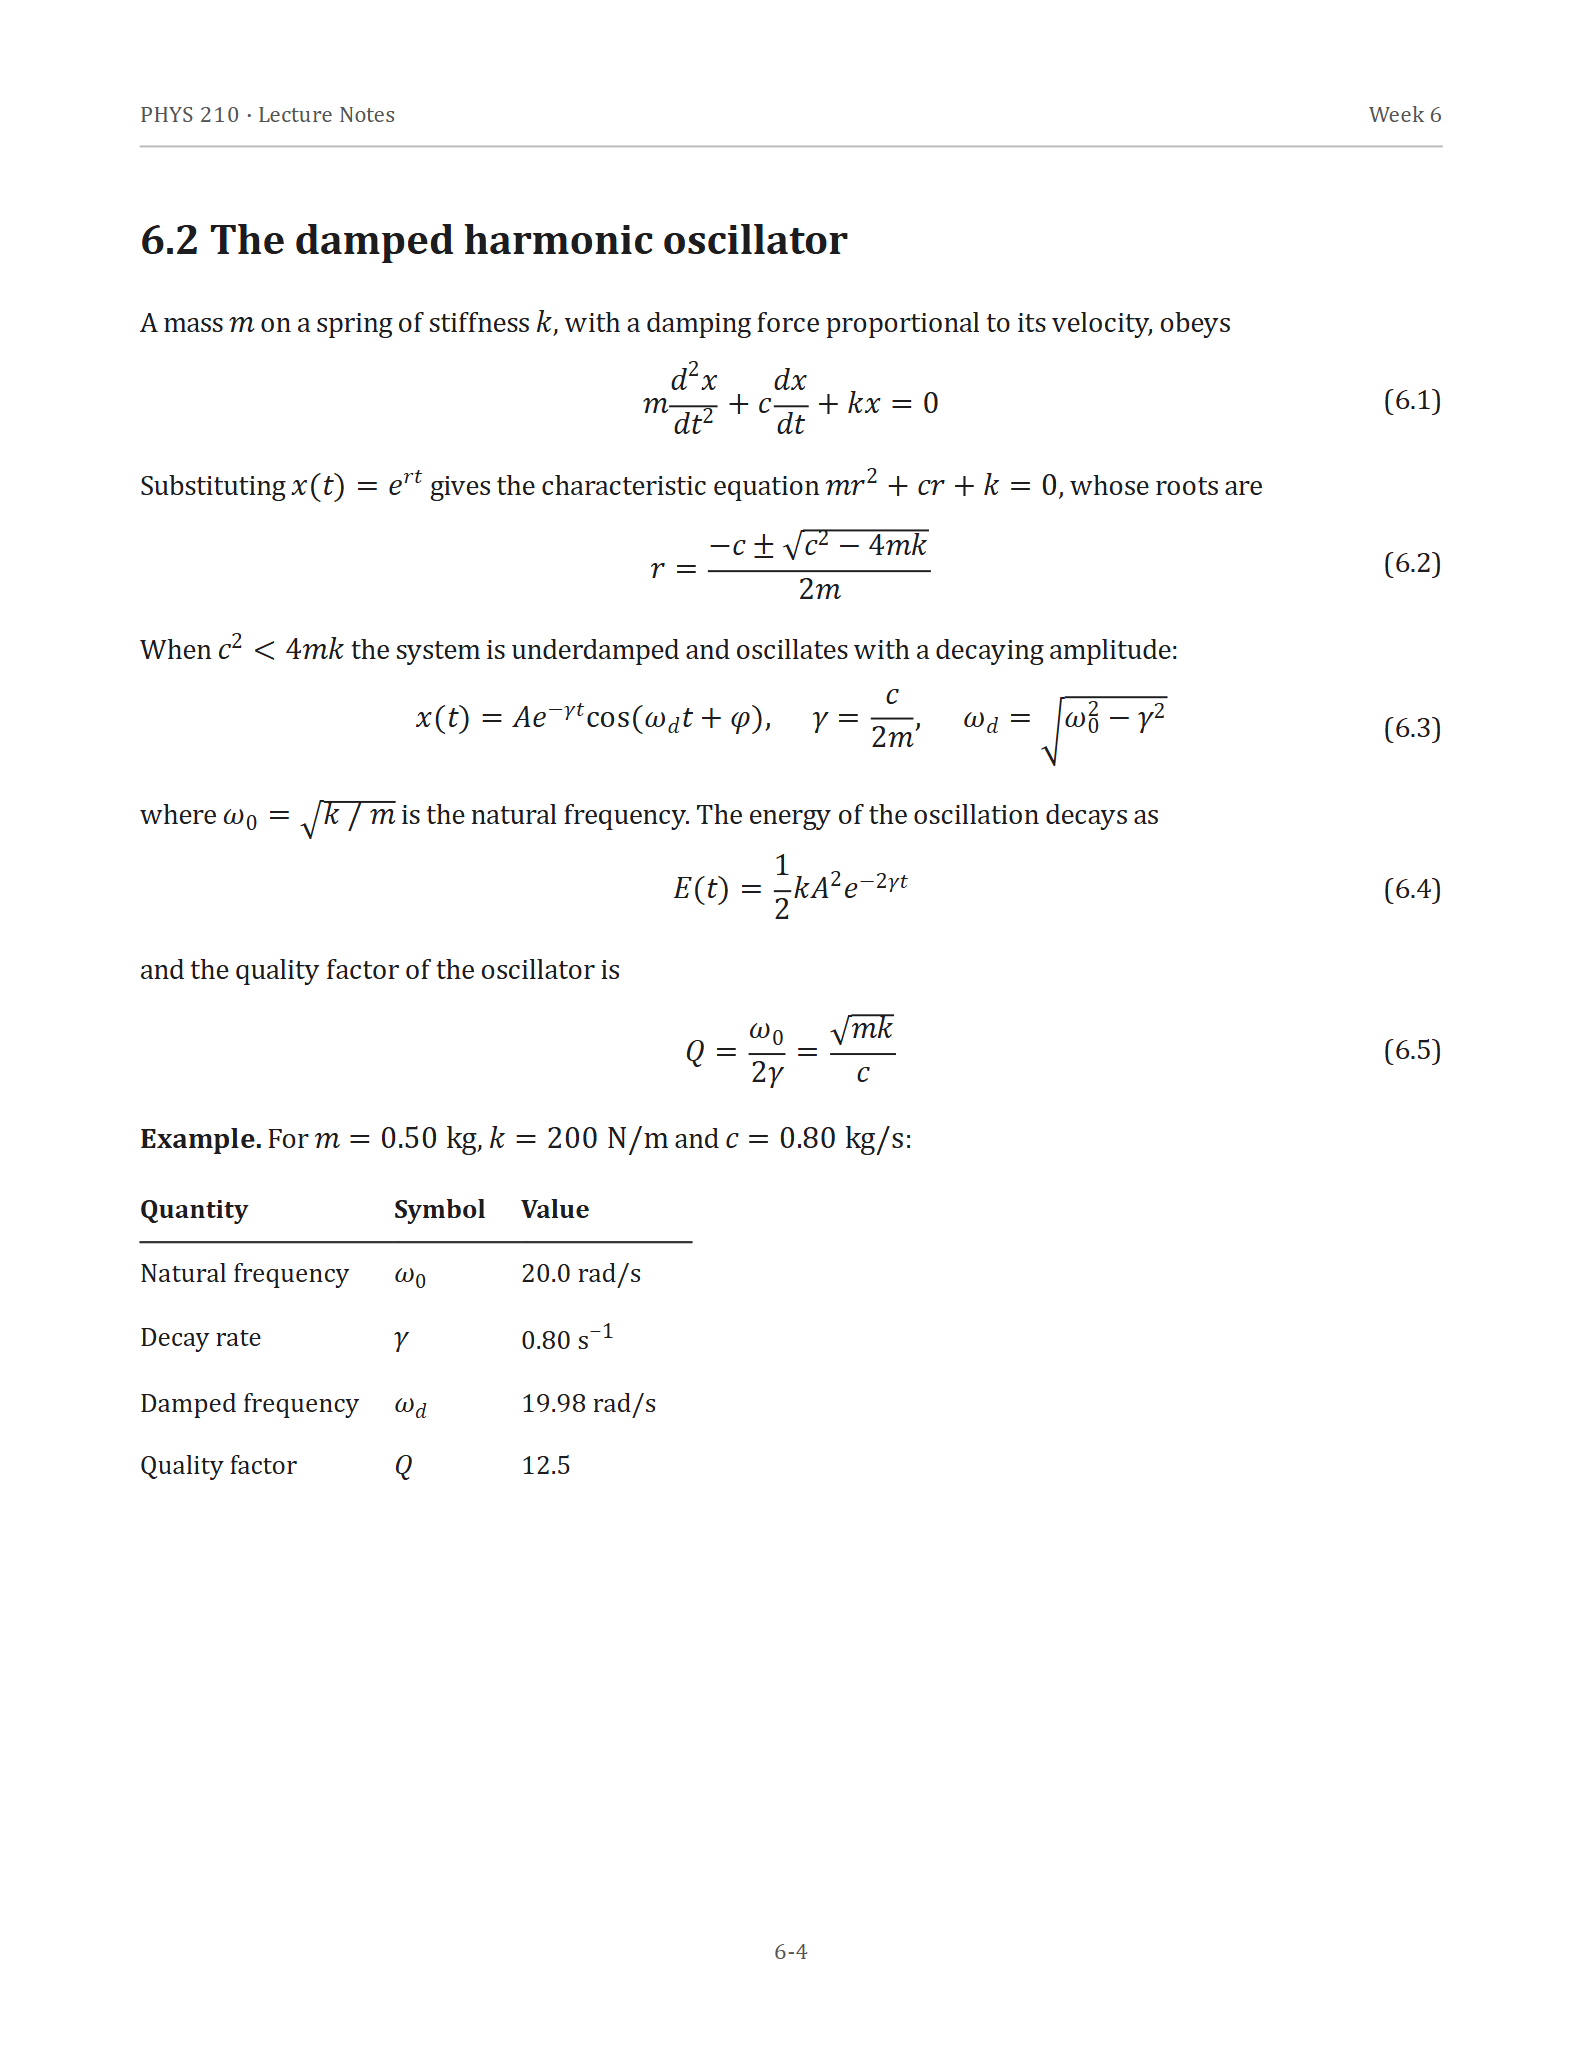
Uma página de teste com anotações de aula, lida em um pedido. Esta página e mais duas contra três modelos de chat de visão estão em LightOnOCR-3 4B vs Qwen3.5 4B vs Gemma 4 26B-A4B vs Mistral Small 3.1.
O início do Markdown retornou para aquela página; as outras três equações, a tabela e o número da página seguem na mesma resposta:
PHYS 210 · Notas da Aula Semana 6 ## 6.2 O oscilador harmônico amortecido Uma massa $m$ em uma mola de rigidez $k$, com força de amortecimento proporcional à sua velocidade, obedece $$ m \frac{d^2 x}{dt^2} + c \frac{dx}{dt} + kx = 0 \quad \text{(6.1)} $$ Substituindo $x(t) = e^{rt}$ dá a equação característica $mr^2 + cr + k = 0$, cujas raízes são $$ r = \frac{-c \pm \sqrt{c^2 - 4mk}}{2m} \quad \text{(6.2)} $$Seu primeiro pedido
Envie um documento por URL ou como um URI de dados base64. Essa solicitação lê as duas primeiras páginas de um PDF de exemplo:
curl https://api.empiriolabs.ai/v1/ocr \ -H "Autorização: Portador $EMPIRIOLABS_API_KEY" \ -H "Tipo-de-Conteúdo: application/json" \ -d '{ "modelo": "lightonocr-3-4b", "documento": { "tipo": "document_url", "document_url": "https://media.empiriolabs.ai/assets/blog-images/lightonocr-3-4b-test-2026-10-25/sample-document.pdf" }, "páginas": [0, 1] }'Um arquivo na sua máquina entra como um URI de dados, sem necessidade de hospedagem:
importar base64 importar solicitações de importação de sistemas operativos com open("report.pdf", "rb") como handle: encoded = base64.b64encode(handle.read()).decode() resposta = requests.post("https://api.empiriolabs.ai/v1/ocr", cabeçalhos={"Authorization": f"Bearer {os.environ['EMPIRIOLABS_API_KEY']}"}, json={ "model": "lightonocr-3-4b", "document": {"type": "document_url", "document_url": f"data:application/pdf; base64,{encoded}"}, }, timeout=300,) response.raise_for_status() para página em response.json()["páginas"]: print(f"--- página {page['index']} ---") print(page["markdown"])Uma imagem funciona da mesma forma, com "tipo": "image_url" e a URL ou URI de dados em image_url. Um documento pode ser um PDF ou uma imagem PNG, JPEG, WebP, TIFF, BMP, GIF ou AVIF de até 50 MB, e uma requisição pode ler até 1.000 páginas.
O que volta
A resposta comporta um objeto por página em páginas. Cada uma tem a página como Desconto; Blocos, cada região da página em ordem de leitura com seu tipo (Título, Texto, Lista, Tabela, Equação, legenda, cabeçalho, rodapé, e outros) e sua caixa em pixels; Imagens, as regiões da imagem; e Dimensões, o tamanho da imagem da página à qual as caixas se referem. usage_info.pages_processed conta as páginas lidas. Um dos 16 blocos retornados para a página de anotações de aula:
{ "tipo": "equação", "top_left_x": 641, "top_left_y": 526, "bottom_right_x": 1447, "bottom_right_y": 610, "conteúdo": "$$\nr = \\frac{-c \\pm \\sqrt{c^2 - 4mk}}{2m} \\quad \\text{(6.2)}\n$$" }Um pedido de respostas quando suas páginas são lidas. Um ainda está correndo após cerca de quatro minutos e meio de respostas 202 com um job id: enquete VÁ /v1/jobs/{job_id} até Status é completo, e as páginas estão em Resultado. Para obter o ID do trabalho imediatamente, envie o cabeçalho Preferir: respond-async.
Opções
- Páginas.
páginasConsidera números de página baseados em zero como uma lista ([0, 2, 3]) ou uma corda ("0,2-4"). Deixe para ler cada página. - Mesas.
table_formatdefinir paraDescontoouHTMLmove cada mesa paraTabelasnesse formato e deixa um link como[tbl-0.html] (tbl-0.html)na página Markdown. Sem ele, as tabelas permanecem no Markdown como HTML. - Imagens.
include_image_base64retorna cada região da imagem como um URI de dados JPEG.image_limitlimita quantas imagens retornam para todo o documento, eimage_min_sizeDeixa de fora regiões mais estreitas ou mais curtas que esse número de pixels. - Cabeçalhos e rodapés.
extract_headereextract_footermovê-los para fora do Markdown para seus próprios campos. - Layout.
include_blocksdefinir parafalsofolhasBlocosfora.
Notas operacionais
- Os números das páginas começam em 0.
"páginas": [1]Lê a segunda página. - Cifrões podem voltar escapando. No texto da página, um cifrão pode dizer
\$, e dentro de tabelas HTML$. Saiba da Redução antes de procurar por quantias. - Campos de anotação são recusados.
bbox_annotation_format,document_annotation_format, edocument_annotation_promptresposta400antes de qualquer página ser lida.
Preços
Cobrado por página lida. Cada solicitação é cobrada com pelo menos 5 páginas, então envie um documento longo como um PDF em vez de uma solicitação por página. Uma solicitação que falha não é cobrada por páginas que não devolveu. As tarifas atuais estão no página do modelo e o página de preços.
Comece a construir
Tente LightOnOCR-3 4B no Playground com seu próprio documento, e leia o Guia OCR de documentos e o Documentação da API para cada parâmetro.
Divulgação: Este artigo foi escrito com assistência de IA e revisado por EmpirioLabs IA.