Aplomb 1 é nosso primeiro modelo. Ele pega texto, JSON, imagens, áudio e vídeo em uma única solicitação, lê até 1M de tokens e toma uma decisão sobre um documento de 1M de token em cerca de 3 segundos. Uma pergunta curta leva cerca de 15 ms de tempo de modelo.
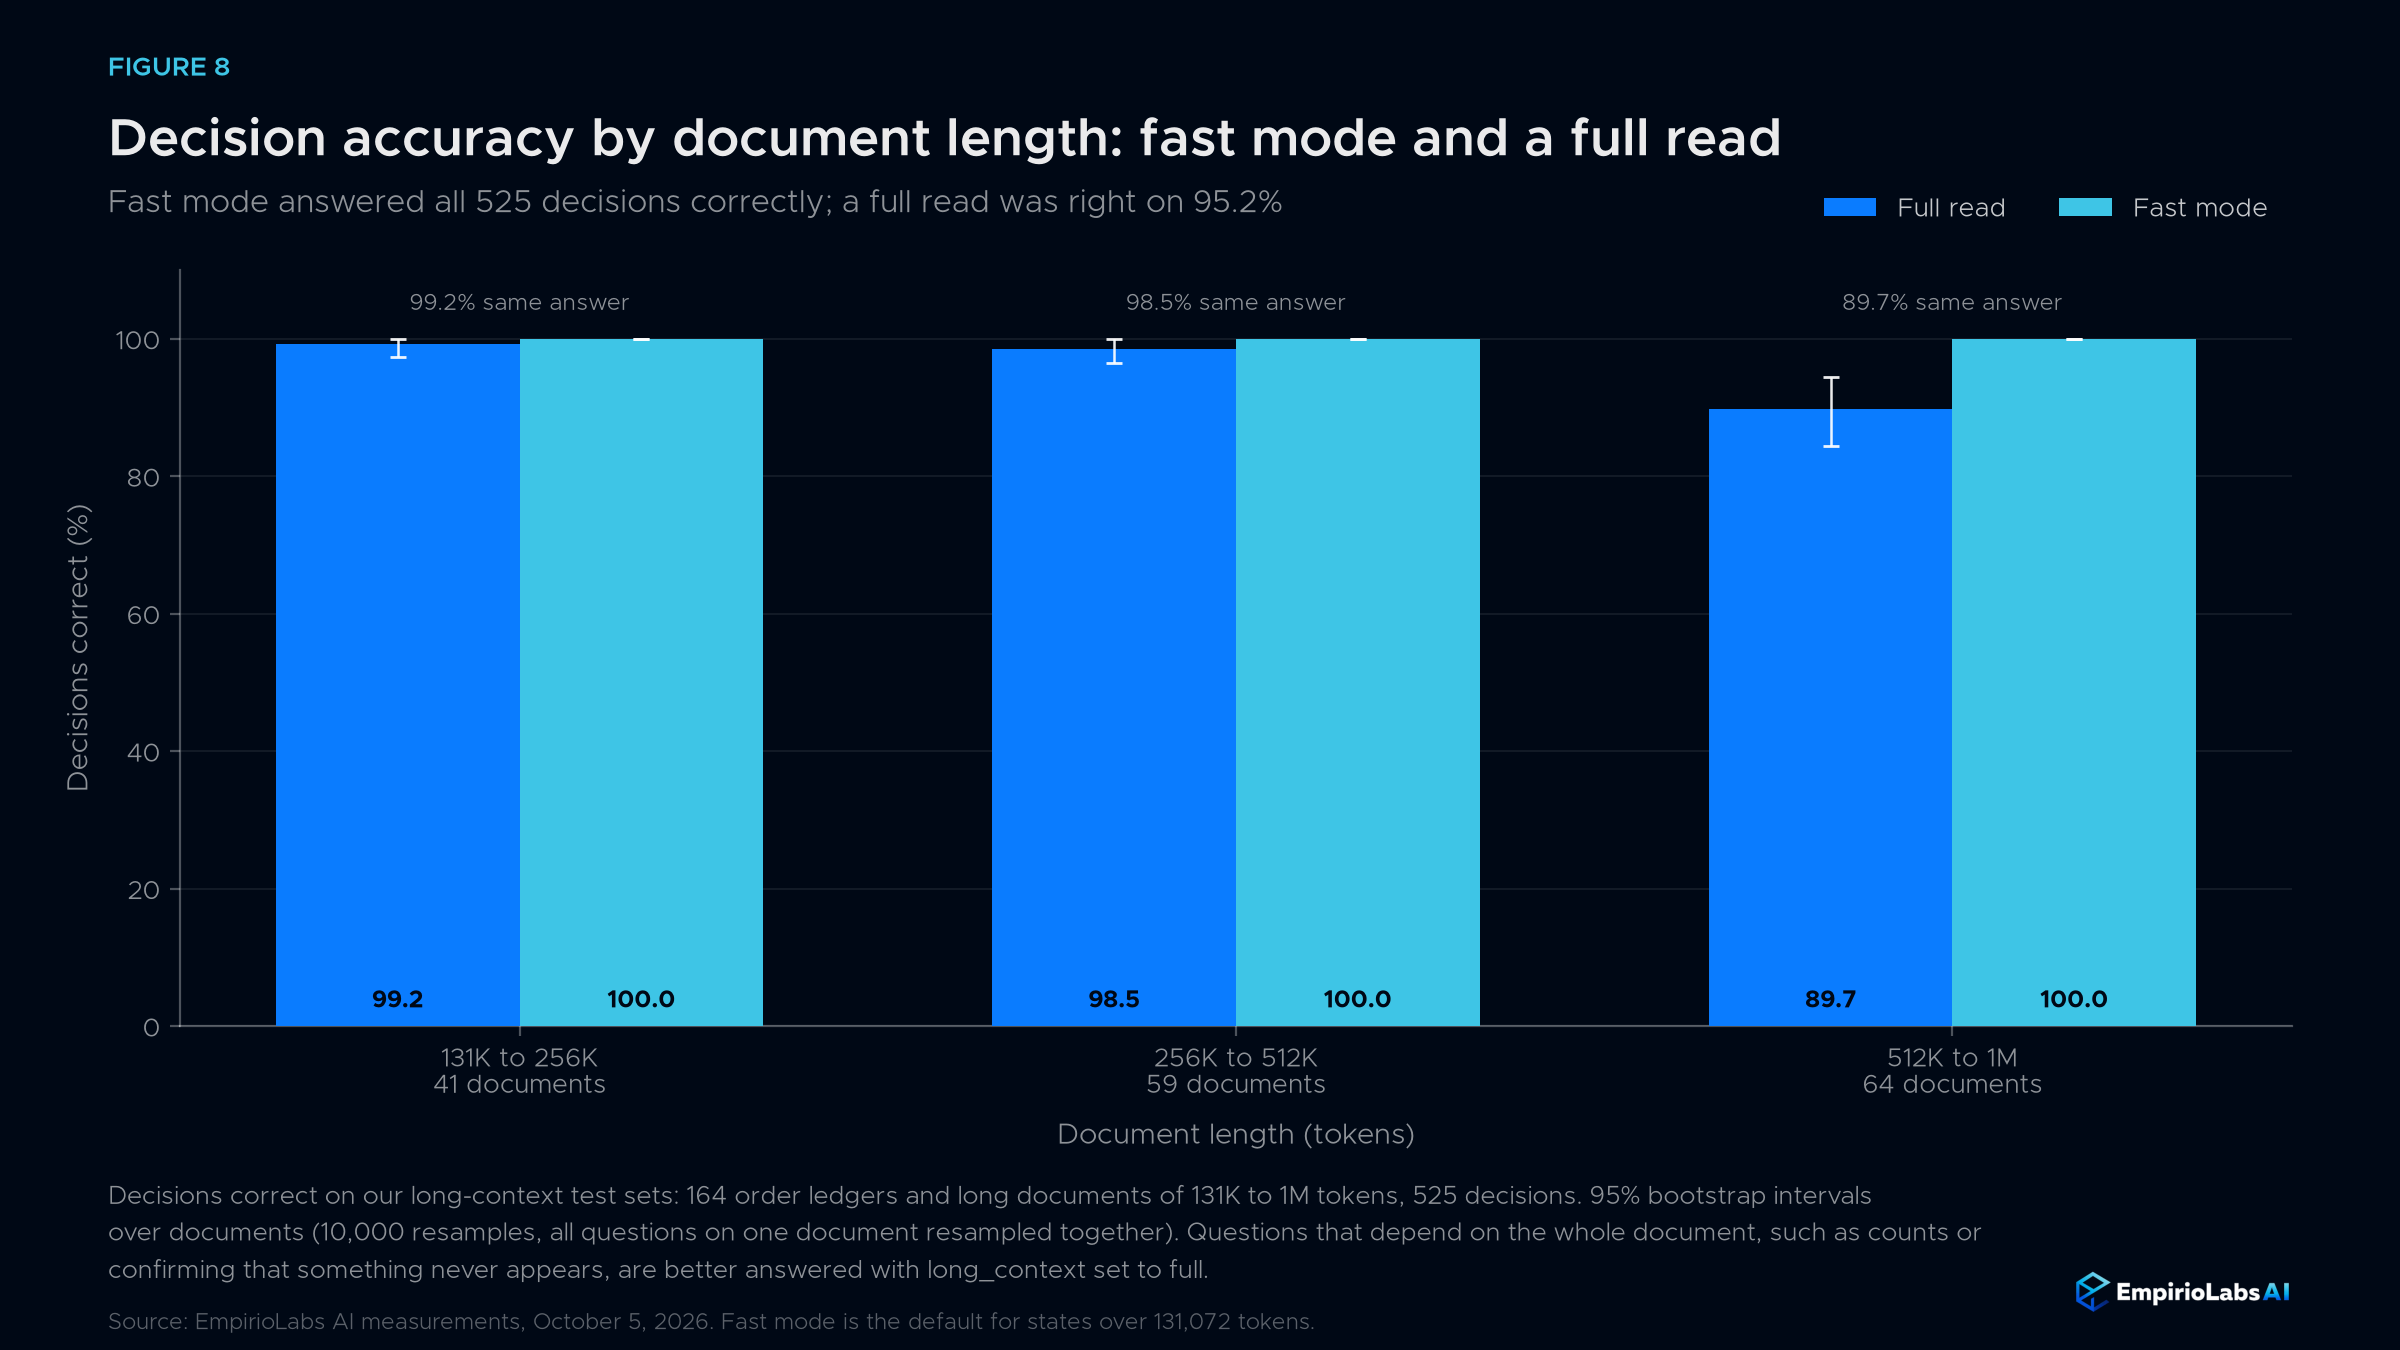
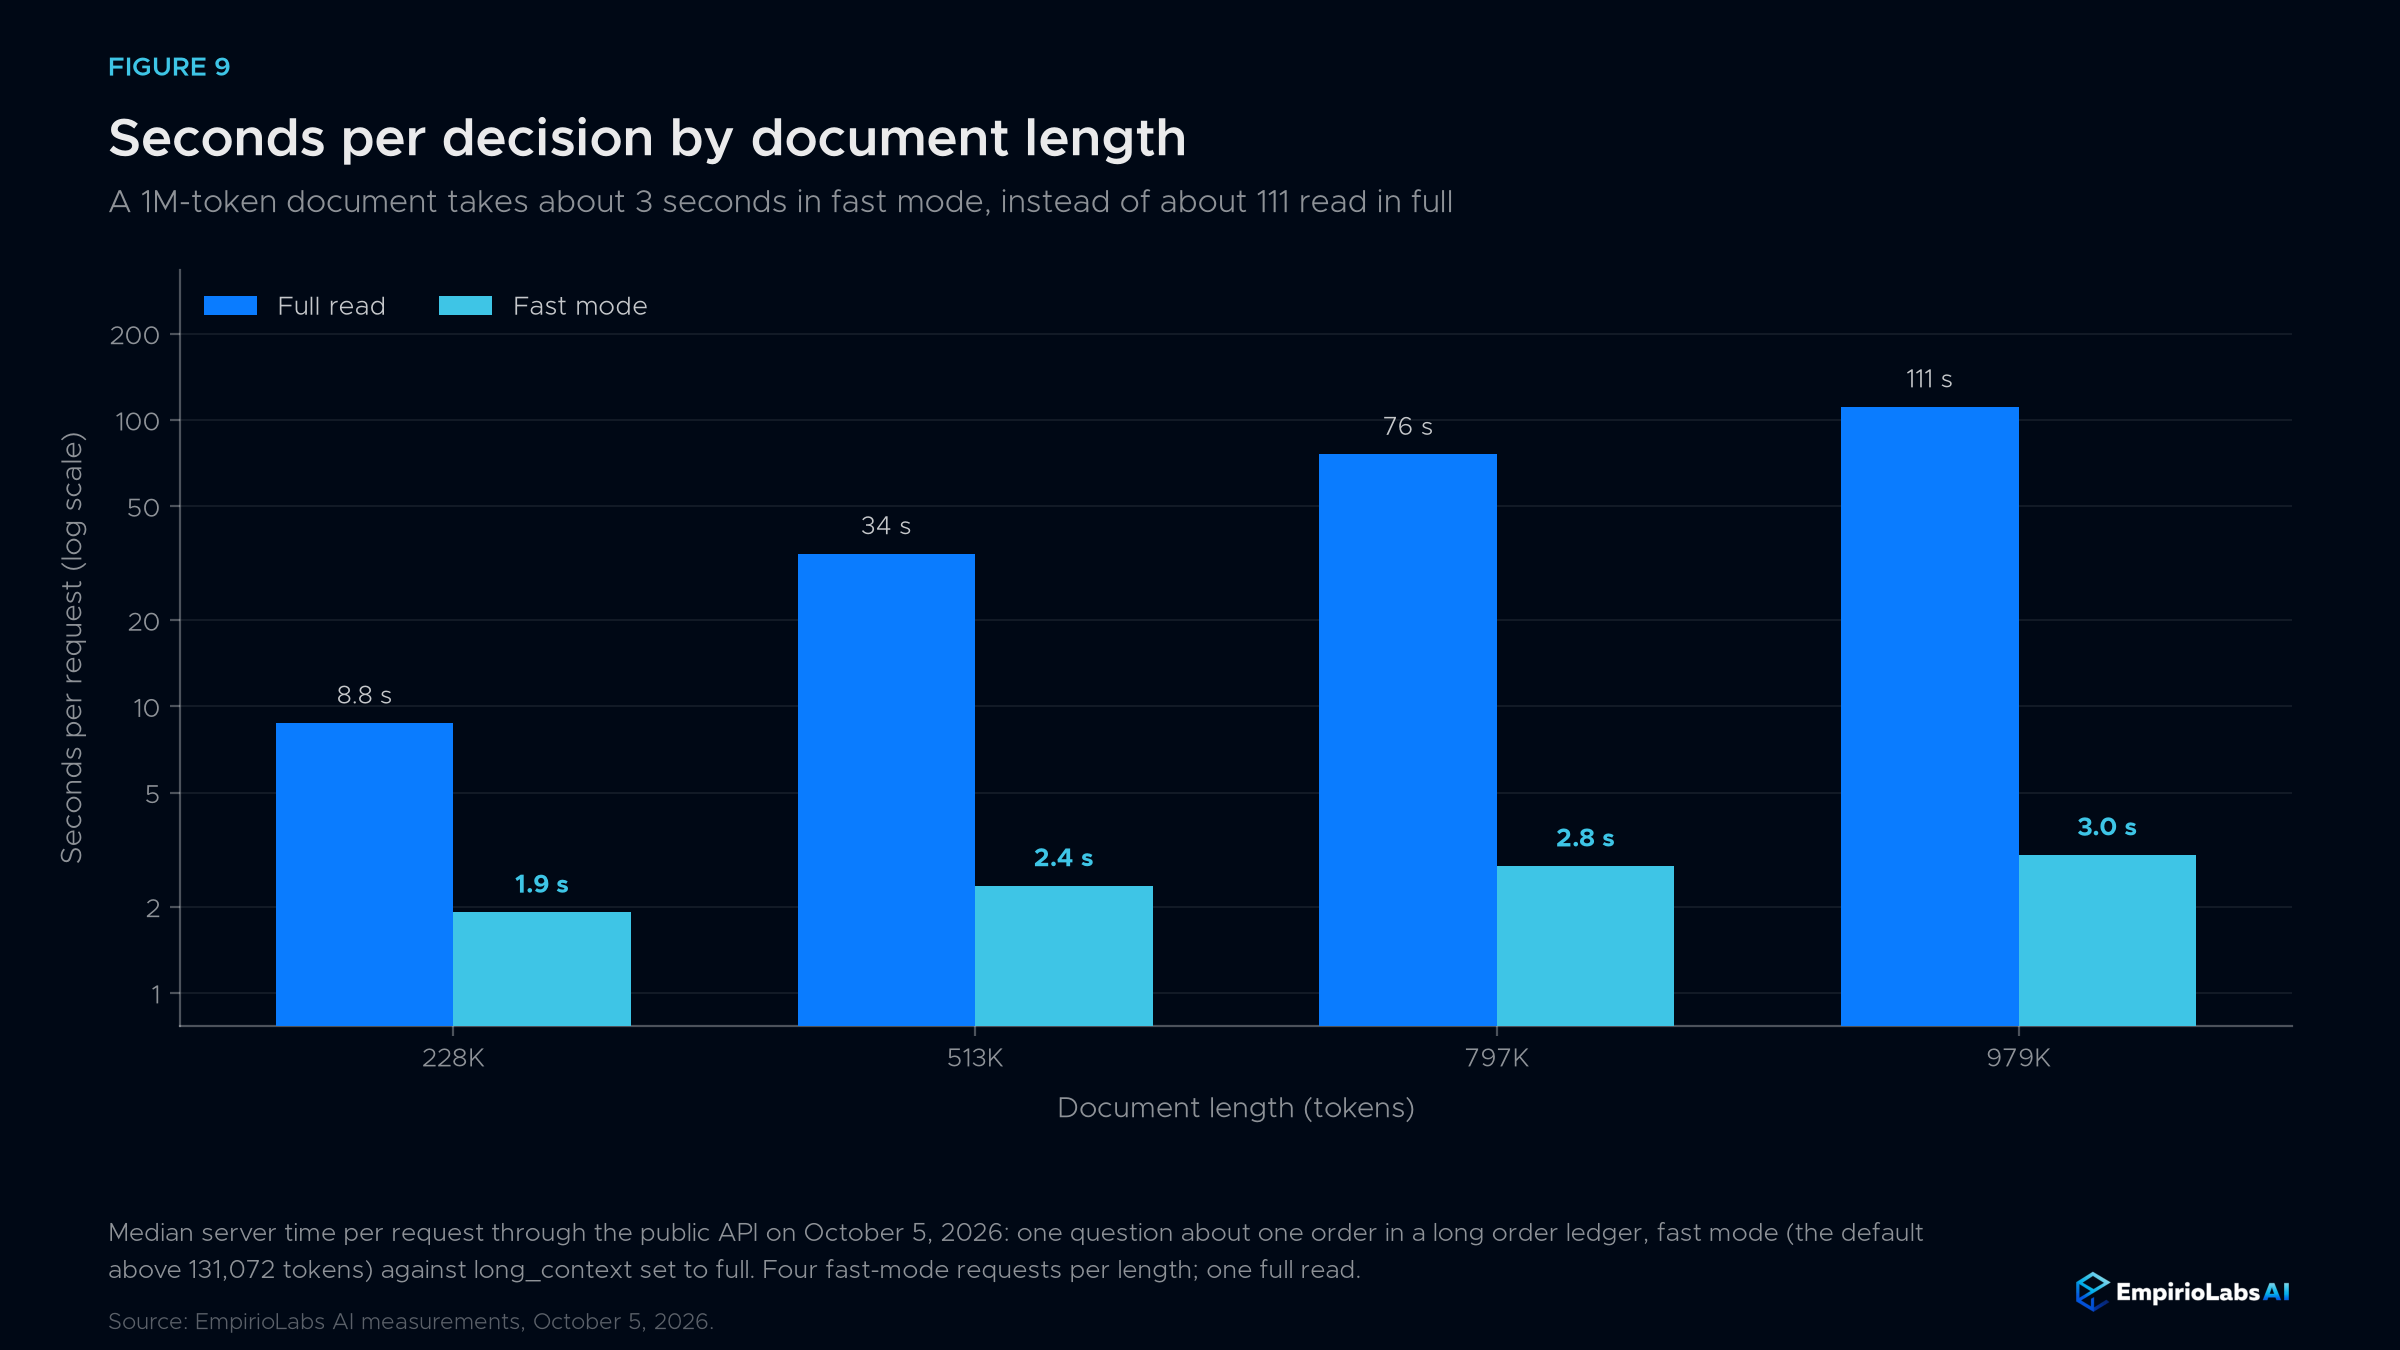
Ele roda em um runtime de inferência que construímos para modelos de decisão. Na nossa API e no Playground, documentos longos passam pelo modo rápido de longo contexto: um documento com 1M de token leva cerca de 3 segundos em vez de 111, e o modo rápido respondeu corretamente todas as 525 decisões em nossos testes de longo contexto.
Para agentes, o Aplomb 1 retorna uma probabilidade para cada ferramenta e para cada argumento enum e booleano em uma única solicitação, então um agente age quando o modelo está certo e escala quando não está. Toda resposta é calibrada, e pode indicar quando a entrada não contém a resposta em vez de adivinhar. Ela foi feita para as decisões que o software toma milhares de vezes por dia, desde o roteamento de um ticket até a escolha da próxima ferramenta do agente.
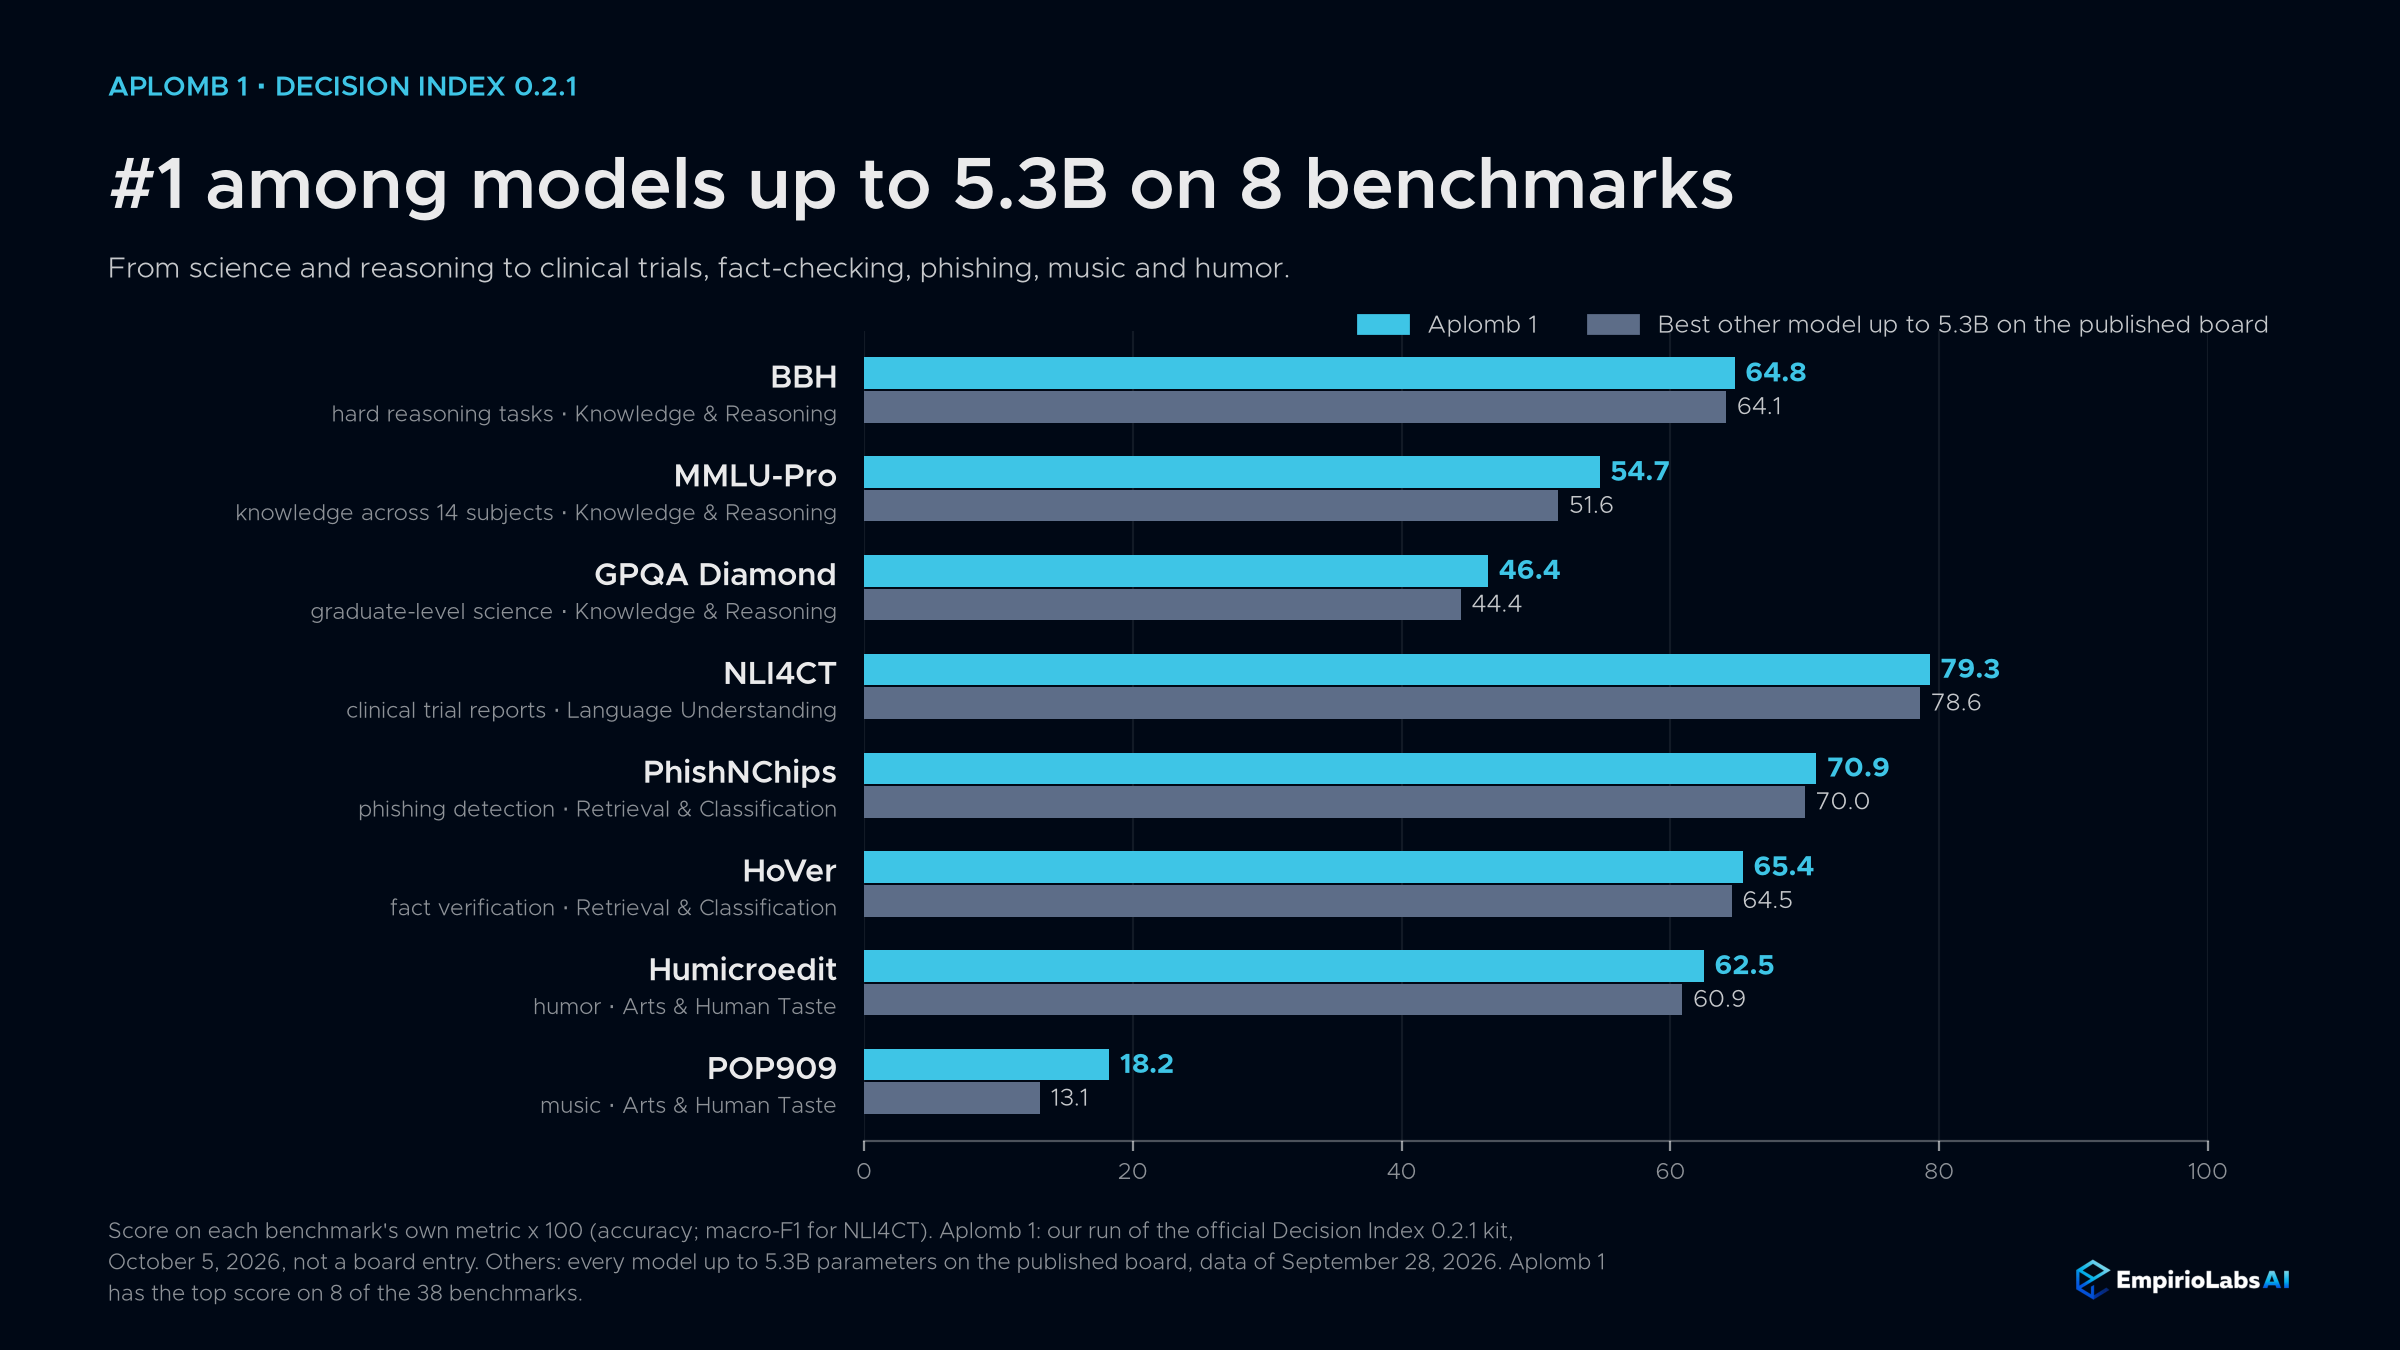
Em 6 de outubro de 2026, está em #1 entre os modelos 4B no quadro publicado do Decision Index, com 44,86 em nossa edição oficial do kit, e #1 entre modelos até 5,3B parâmetros em 8 dos 38 benchmarks. Está disponível hoje na API EmpirioLabs e na Playground, e seus pesos estão no Hugging Face sob a Licença de Modelo EmpirioLabs.
| Desenvoltura 1 em um olhar | |
|---|---|
| Entradas | Texto, JSON, imagens, vídeo e áudio, em qualquer mistura |
| Janela | 1.000.000 de tokens de estado mais pergunta |
| Perguntas | Sim ou não, escolha (2 a 255 opções), pontuação (2 a 10 níveis), seleção de ferramentas |
| Não no estado | Uma probabilidade de que a entrada não contenha a resposta |
| Seleção de ferramentas | A próxima ferramenta a chamar, com probabilidades para seus argumentos enum e booleanos |
| Velocidade | Cerca de 15 ms de tempo de modelo para uma pergunta curta; cerca de 3 segundos para um documento de 1M de token em modo rápido de longo contexto |
| Formatos de API | A API Decisions, além dos formatos OpenAI, Anthropic e Gemini |
| Faturamento | Apenas tokens de entrada; tokens de saída são sempre zero |
| Retenção de dados | Retenção zero de dados por padrão |
| Tamanho | 5,3 bilhões de parâmetros, construídos em Qwen3.5-4B; pesos abertos no Hugging Face |
| Índice de Decisão 0.2.1 | 44,86 na nossa edição do kit oficial, #1 entre os modelos 4B no quadro publicado em 6 de outubro de 2026 |
O que ela responde
Quatro tipos de perguntas. Noul Responde sim ou não, com a probabilidade de sim. Escolha Escolhe uma entre 2 a 255 opções e retorna a distribuição completa. Pontuação coloca o estado em uma escala ordenada de 2 a 10 níveis. ferramenta escolhe qual das suas ferramentas de função chamar e retorna distribuições sobre seus argumentos enum e booleano.
Não no estado. Adicionar "abstenção": verdade para uma pergunta e a resposta também carrega a probabilidade de que o estado não contenha o que a pergunta precisa. Um registro sem campo portador recebe alta probabilidade de abstenção em vez de um palpite confiante.
Respostas independentes. Até 128 perguntas compartilham um estado, e cada uma é respondida separadamente, então adicionar uma pergunta nunca muda outra resposta.
Seleção de ferramentas para agentes
Dê ao Aplomb 1 as ferramentas de função do seu agente e o estado atual (um ticket, uma conversa, um registro), e ele retorna a ferramenta para chamar em seguida com uma probabilidade para cada ferramenta e uma distribuição para cada argumento enum e booleano, em uma única solicitação. Um LLM geral escreve uma ferramenta que chama token por token e não diz o quão certo está sobre a ferramenta ou qualquer argumento. O agente age quando a probabilidade é alta e passa o passo para um modelo maior quando não está, então passos rotineiros pulam uma resposta gerada. Não encontramos outro modelo de decisão que retorne probabilidades de argumentos.
Um ticket que diz "Pedido B-44120 chegou com a tela rachada. Quero meu dinheiro de volta." com três ferramentas, issue_refund (a Motivo enum e a full_refund booleano), track_package e escalate_to_human, retorna como (abreviado, arredondado):
{"ferramenta": "issue_refund", "probabilidades": {"issue_refund": 0,969, "nenhuma": 0,025, "escalate_to_human": 0,005, "track_package": 0,002}, "argumentos": {"issue_refund": { "razão": {"valor": "danificado", "probabilidades": {"danificado": 0,993, "not_as_described": 0,007, "tardio": 0,001}}, "full_refund": {"valor": verdadeiro, "probability_true": 0,761}}}, "open_arguments": {"track_package": ["order_id"]}}
Argumentos em texto livre, como um id de ordem, são listados sob open_arguments para o agente preencher.
Entradas mistas, até 1M de tokens
Texto, objetos JSON e arrays, imagens, vídeo e áudio entram no mesmo estado, em qualquer combinação: uma gravação de chamada de suporte ao lado do registro da conta, um clipe de dashcam ao lado do formulário de reclamação, uma foto do produto ao lado do anúncio. O estado mais a pergunta mais longa pode chegar a 1.000.000 de tokens, o suficiente para um pacote contratual longo, um ano de tickets ou horas de transcrições em uma única solicitação.
Como ela pontua
Rodamos modelos de decisão abertos 4B Aplomb 1 e três nos mesmos itens, e definimos os números publicados pelo Intern-Decision para Jev, JevK5 e Semif ao lado deles. Nos relatórios de sete suítes Intern-Decision, Aplomb 1 tem média de 88,7%. Contra a linha publicada por Jev, está à frente no JevBench Hard e decisões digitadas, empatado no JevBench Easy, e atrás no JevBench Original, ToolACE, AG News e WildJailbreak. Sua maior vantagem é no JevBench Hard, +5,4 pontos.
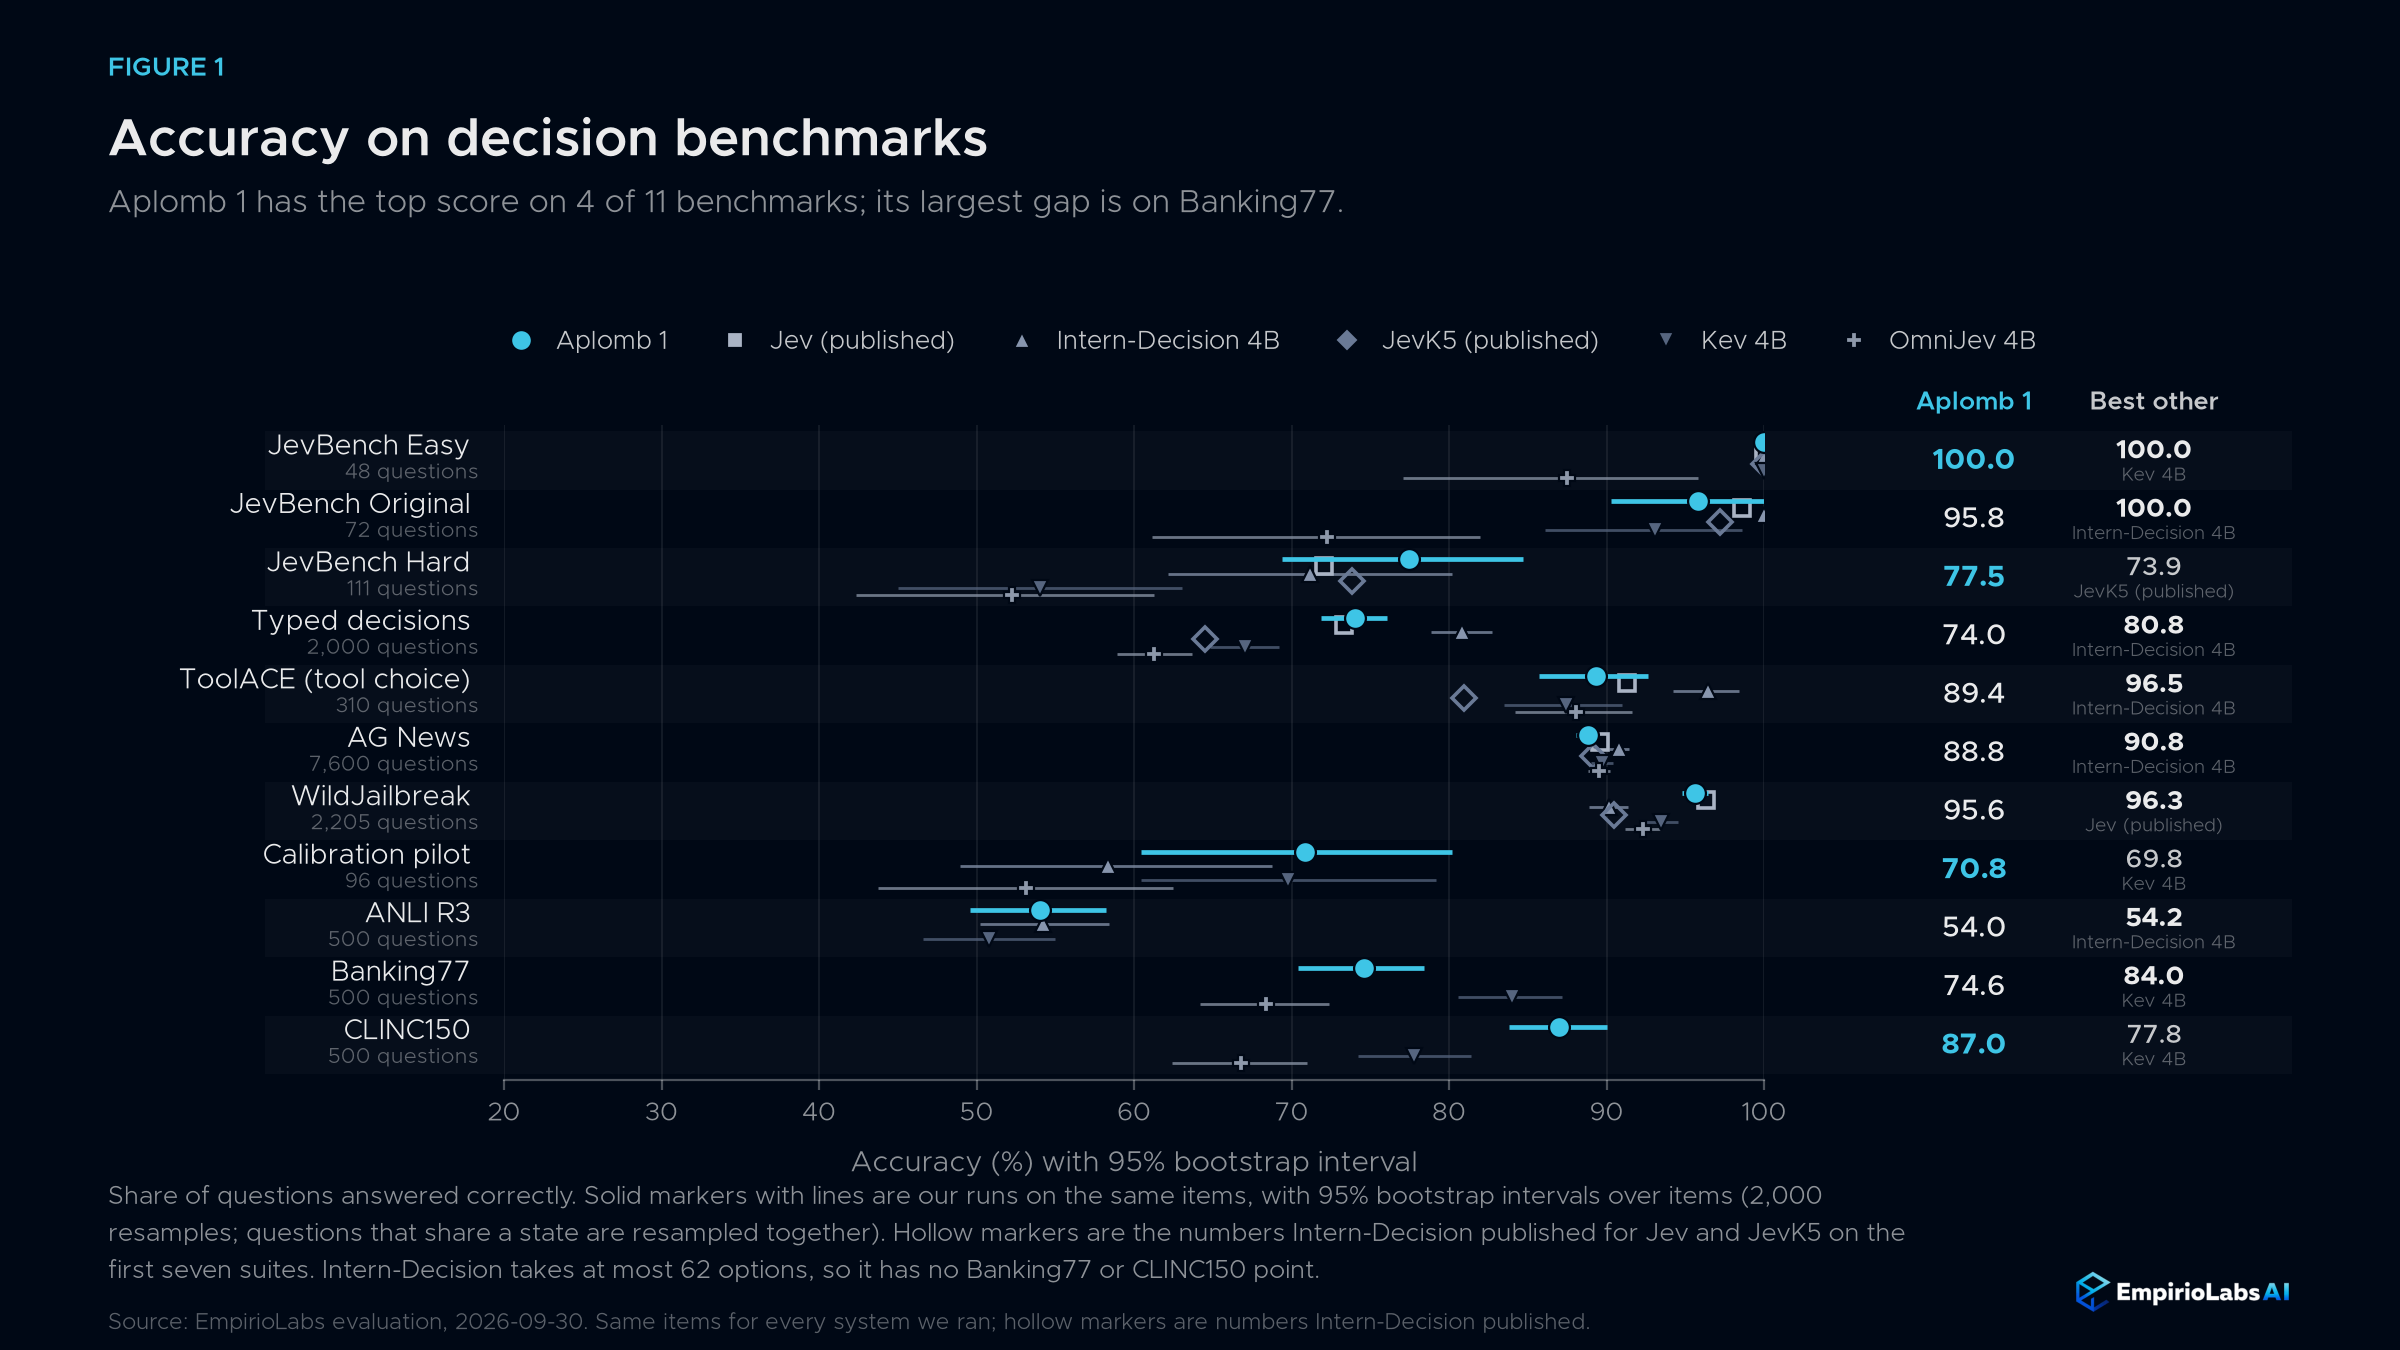
| Referência | Desenvoltura 1 | Jev (p) | JevK5 (p) | Semif (p) | Decisão de Estagiário 4B | Kev 4B | OmniJev 4B |
|---|---|---|---|---|---|---|---|
| JevBench Easy | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 87.5 |
| JevBench Original | 95.8 | 98.6 | 97.2 | 98.6 | 100.0 | 93.1 | 72.2 |
| JevBench Difícil | 77.5 | 72.1 | 73.9 | 61.3 | 71.2 | 54.1 | 52.3 |
| Decisões tipadas | 74.0 | 73.3 | 64.5 | 62.8 | 80.8 | 67.0 | 61.3 |
| ToolACE | 89.4 | 91.3 | 81.0 | 85.2 | 96.5 | 87.4 | 88.1 |
| AG News | 88.8 | 89.6 | 89.1 | 89.2 | 90.8 | 89.7 | 89.6 |
| Fuga Selvagem | 95.6 | 96.3 | 90.5 | 92.5 | 90.2 | 93.5 | 92.3 |
| Média | 88.7 | 88.7 | 85.2 | 84.2 | 89.9 | 83.5 | 77.6 |
(p) Conforme publicado pela Intern-Decision para os mesmos itens. A Intern-Decision reporta 90,02 para seu modelo 4B neste pacote; a coluna mostra nossa sequência.
| Referência | Desenvoltura 1 | Decisão de Estagiário 4B | Kev 4B | OmniJev 4B |
|---|---|---|---|---|
| Piloto de calibração | 70.8 | 58.3 | 69.8 | 53.1 |
| ANLI R3 | 54.0 | 54.2 | 50.8 | n/a |
| Banking77 (77 opções) | 74.6 | n/a | 84.0 | 68.4 |
| CLINC150 (150 opções) | 87.0 | n/a | 77.8 | 66.8 |
Entradas longas
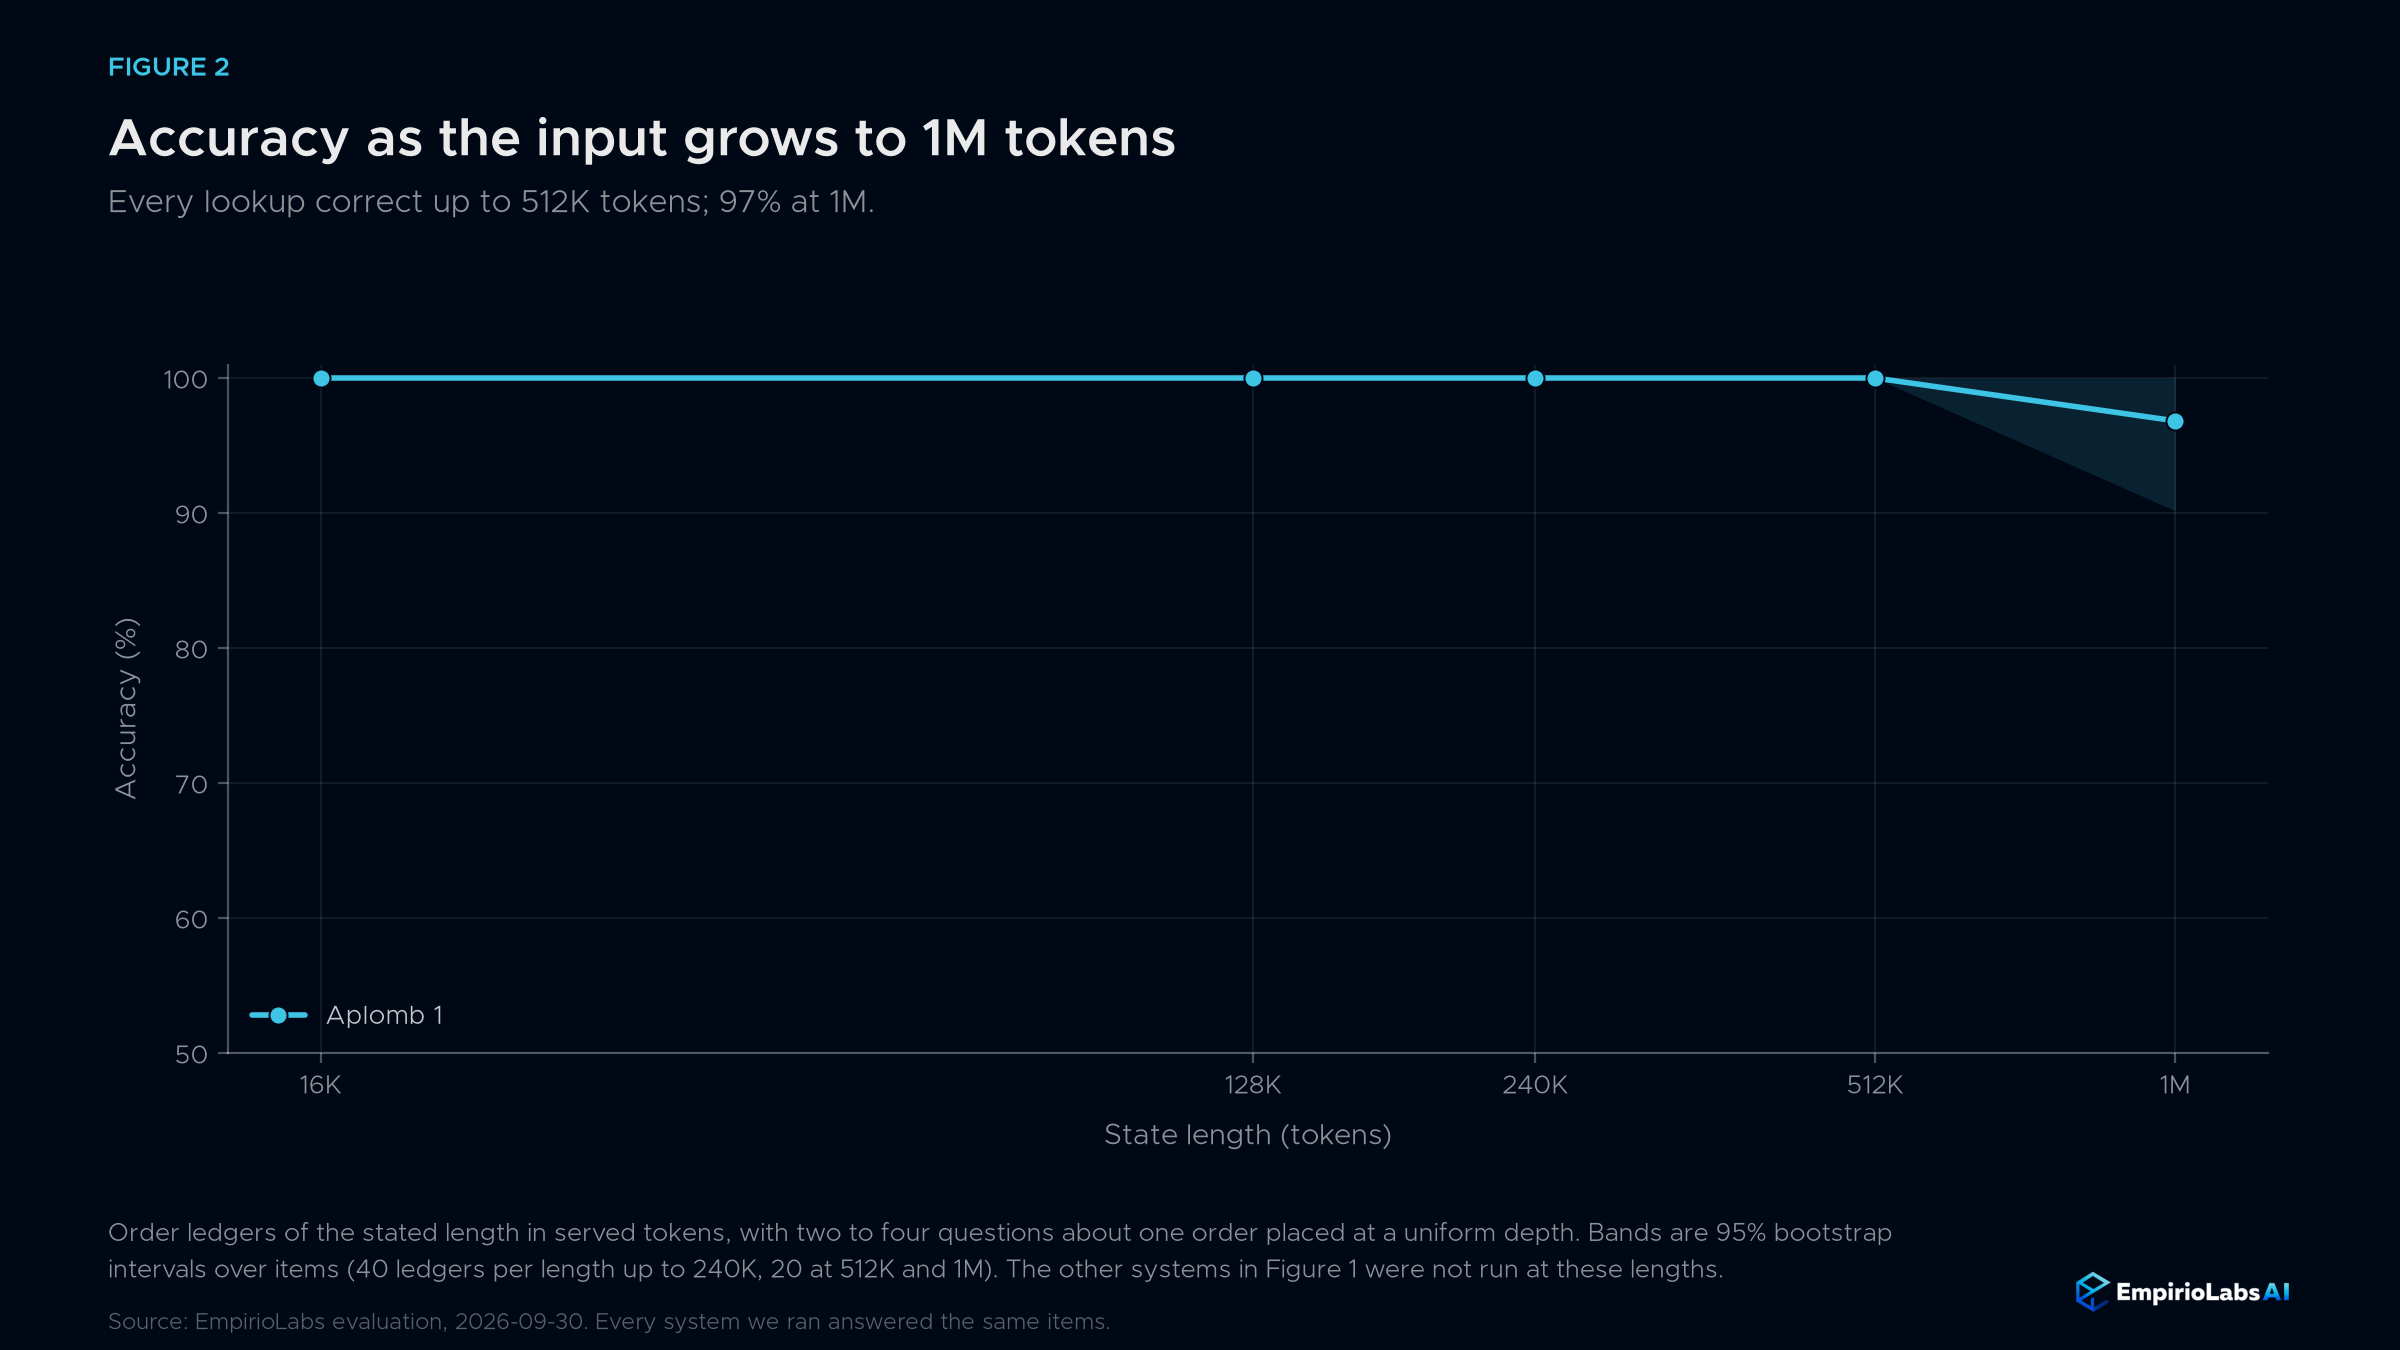
Medimos as buscas em livros-razão de ordem de 16K a 1M tokens, com as perguntas sobre uma ordem colocadas em profundidade aleatória.
| Comprimento de entrada (tokens) | 16K | 128K | 240K | 512K | 1M |
|---|---|---|---|---|---|
| Desenvoltura 1 | 100.0 | 100.0 | 100.0 | 100.0 | 96.8 |
Documentos longos em segundos
Na API EmpirioLabs e no Playground, um estado com mais de 131.072 tokens é lido no modo rápido de longo contexto por padrão. Um documento de 1M de token leva cerca de 3 segundos em vez de cerca de 111 segundos de leitura na íntegra, e em nossos conjuntos de teste de longo contexto o modo rápido respondeu corretamente todas as 525 decisões, contra 95,2% para uma leitura completa.
| Comprimento do documento (tokens) | 228K | 513K | 797K | 979K |
|---|---|---|---|---|
| Modo rápido | 1,9 s | 2.4 s | 2,8 s | 3.0 s |
| Leitura completa | 8,8 s | 34 s | 76 s | 111 s |
Enviar "long_context": "cheio" para ler cada token. Uma leitura completa é a melhor escolha quando uma resposta depende de todo o documento, como uma contagem, o tom geral ou confirmar que algo nunca aparece: em 24 documentos criados para testar essas perguntas, o modo rápido acertou em 50% das decisões e a leitura completa em 61%. As respostas long_context o campo indica qual modo foi usado, e o uso conta todo o estado em ambos os modos. O modo rápido de contexto longo está disponível apenas na API EmpirioLabs e no Playground; os pesos abertos leem todos os tokens.
Calibração
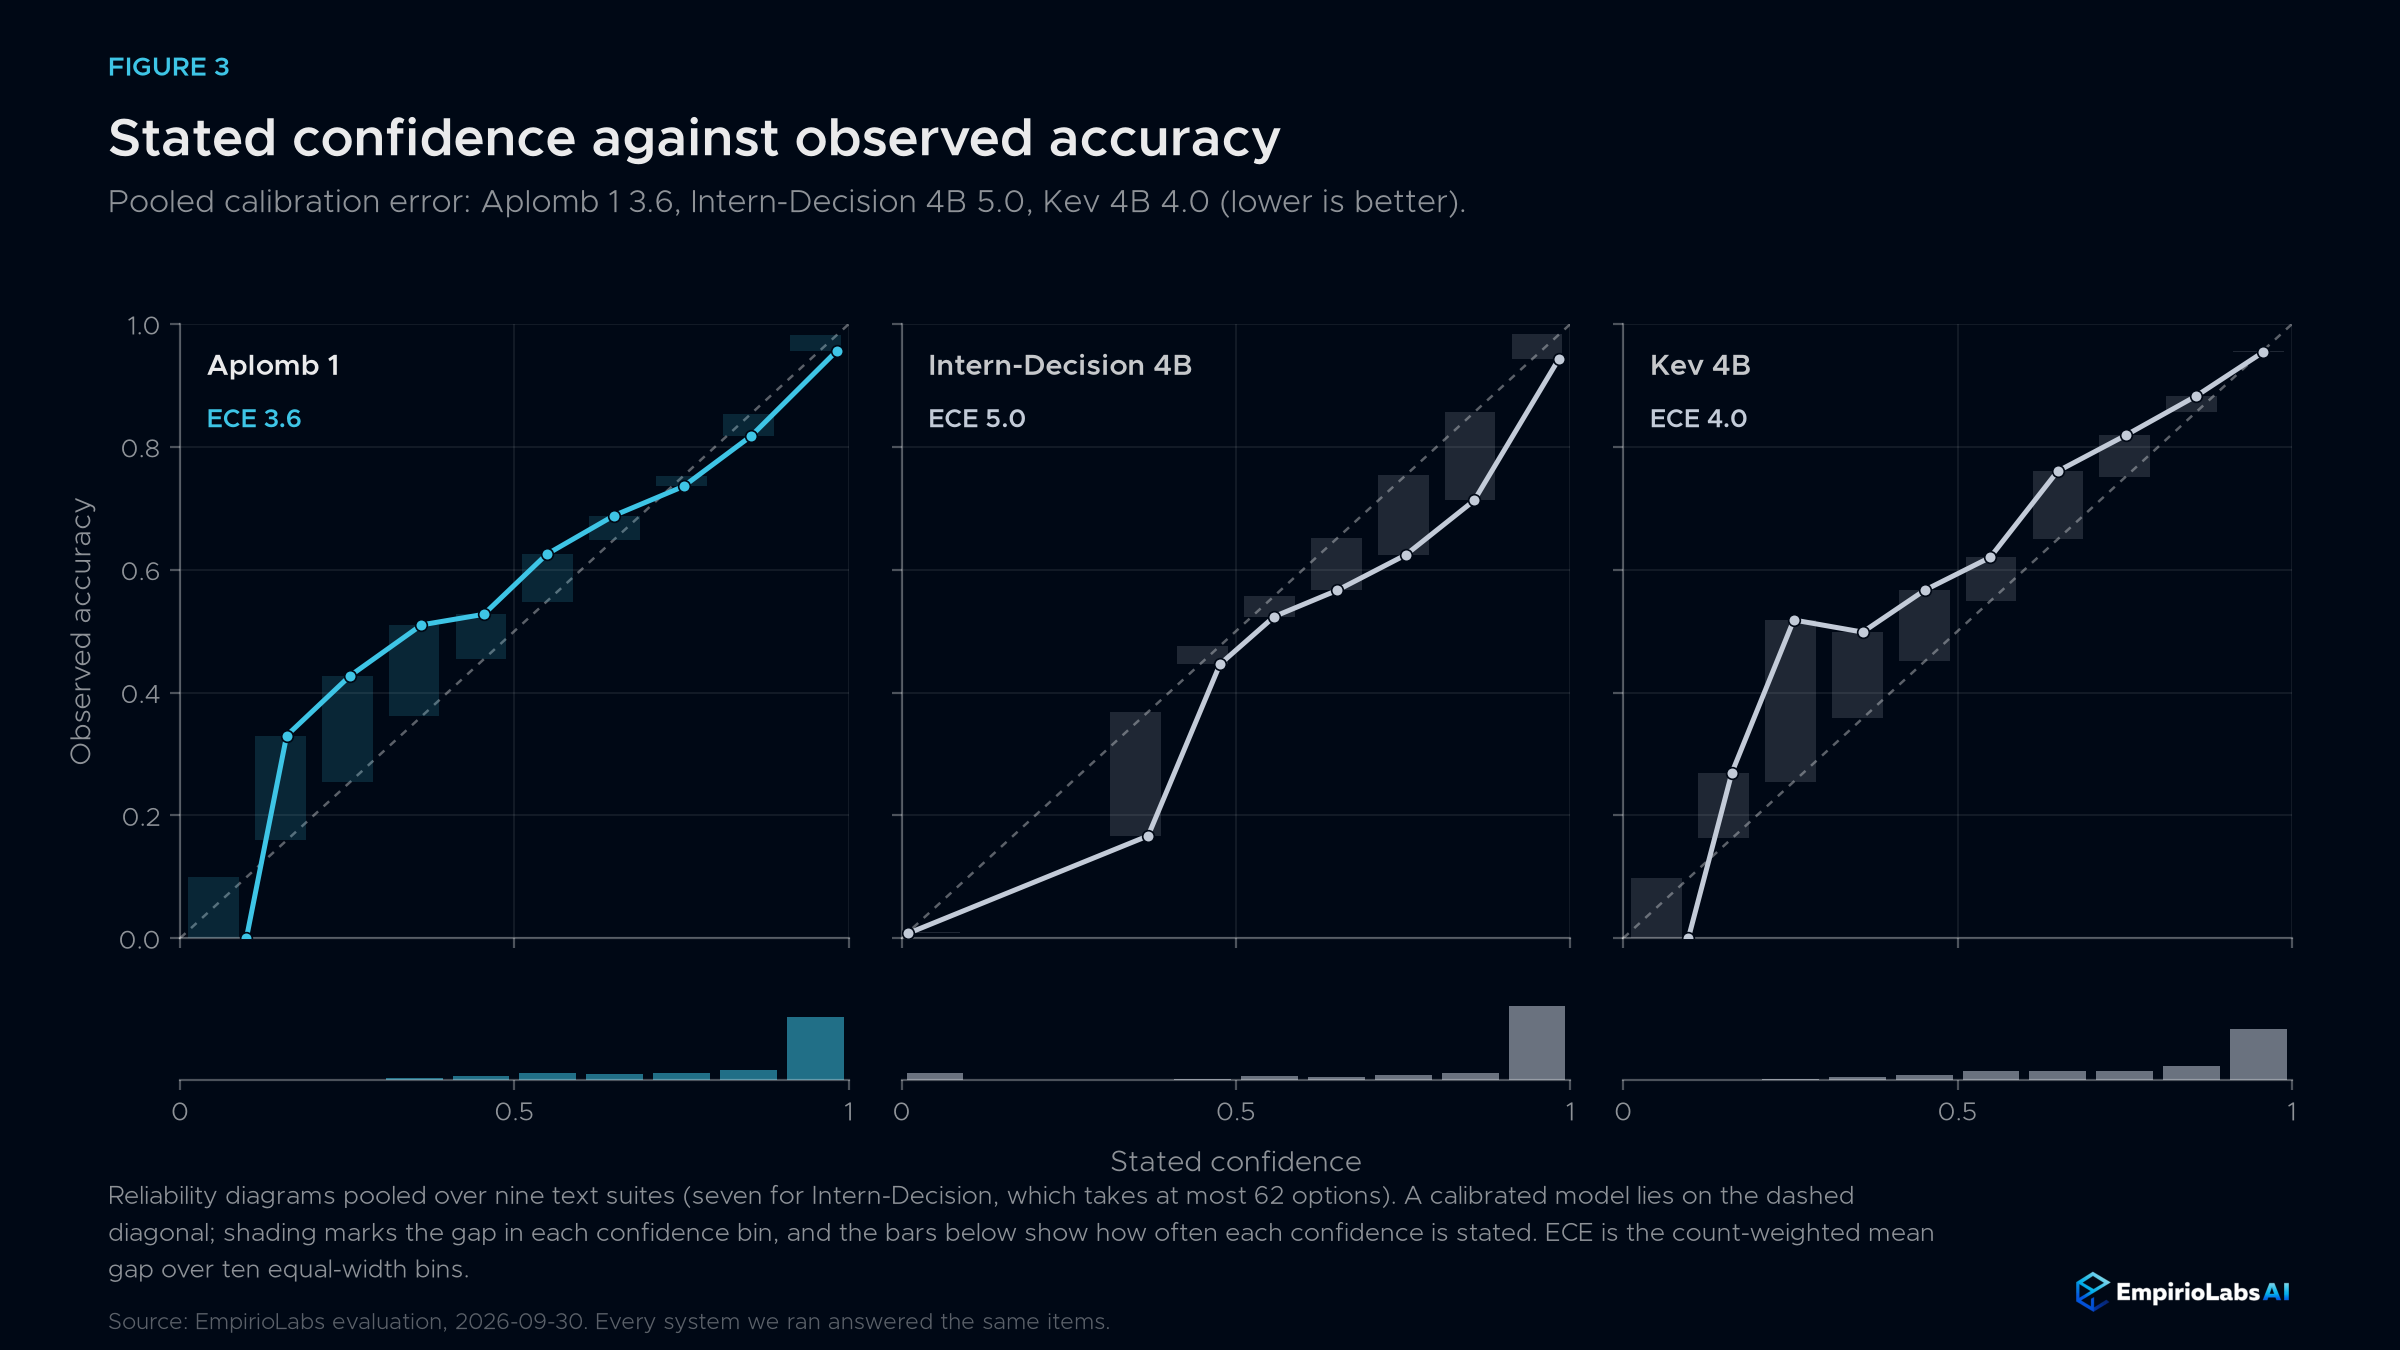
Uma probabilidade só é útil se ela quiser dizer o que diz. Em nove suítes de texto, a confiança declarada do Aplomb 1 acompanha com que frequência está correta: seu erro de calibração agrupado é 3,6, contra 5,0 para o Intern-Decision 4B e 4,0 para Kev 4B (menor melhor).
Imagens, vídeo e áudio
| Benchmark (primeiros 500 itens) | Desenvoltura 1 | Decisão de Estagiário 4B | OmniJev 4B |
|---|---|---|---|
| PAPA | 89.0 | 89.2 | 88.4 |
| MMStar | 68.6 | 65.2 | 64.4 |
| AI2D | 87.0 | 81.0 | 83.4 |
| MMMU | 57.2 | 57.0 | 56.0 |
| HallusionBench | 79.8 | 79.4 | 71.2 |
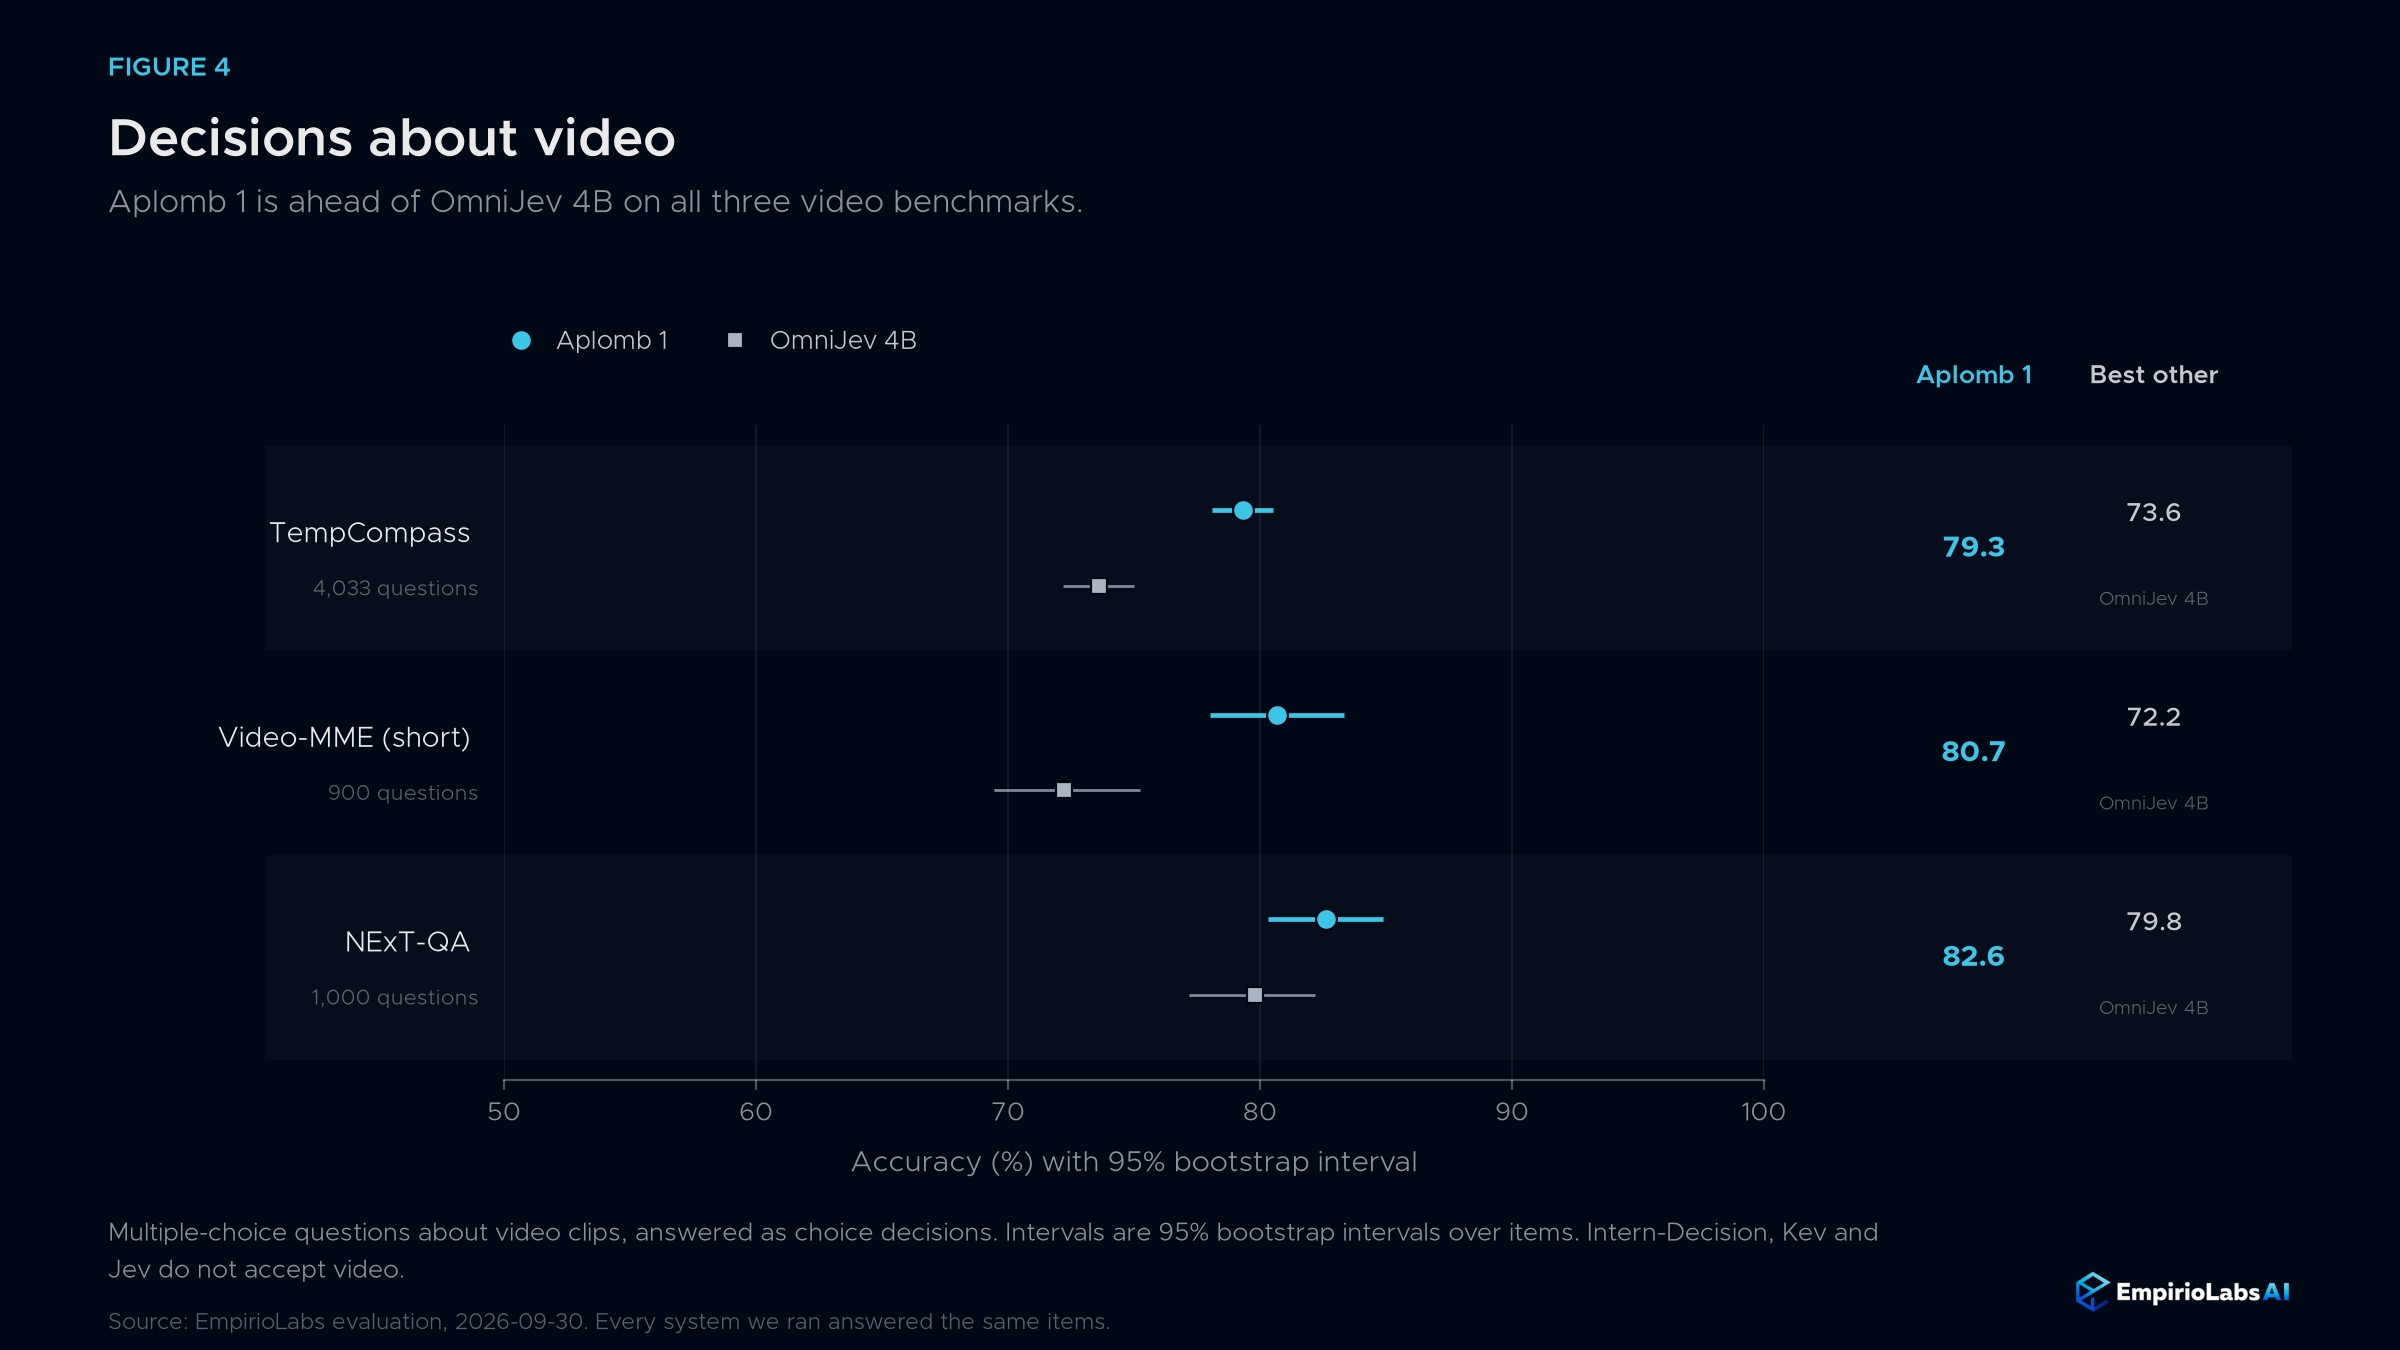
| Referência | Desenvoltura 1 | OmniJev 4B |
|---|---|---|
| TempCompass | 79.3 | 73.6 |
| Video-MME (curta) | 80.7 | 72.2 |
| NExT-QA | 82.6 | 79.8 |
Nós mesmos adicionamos o áudio ao Aplomb 1; nenhum dos outros modelos de decisão acima o aceita. Ele reconhece sons vocais, emoção na fala e sons do dia a dia, e responde perguntas sobre o que é dito:
| Referência | Desenvoltura 1 |
|---|---|
| VocalSound (sons vocais) | 91.9 |
| CREMA-D (emoção na fala) | 78.7 |
| ESC-50 (sons ambientais) | 77.0 |
| MMAU (perguntas de áudio) | 68.3 |
| MMSU (língua falada) | 63.2 |
Os resultados de áudio foram atualizados em 6 de outubro de 2026, com novos pesos de áudio para o Aplomb 1; os resultados de texto, imagem e vídeo permaneceram inalterados.
51 idiomas
Aplomb 1 decide sobre texto em muitos idiomas, não apenas em inglês. No MASSIVE, cada pedido para um assistente de voz é escrito em um dos 51 idiomas, enquanto a pergunta e os 59 rótulos de intenção permanecem em inglês. Sem qualquer treinamento em MASSIVE, o Aplomb 1 tem uma média de 75,0% nos 51 idiomas ao escolher entre todos os 59 intents, 91,0% em inglês e 70% ou mais em 39 deles.
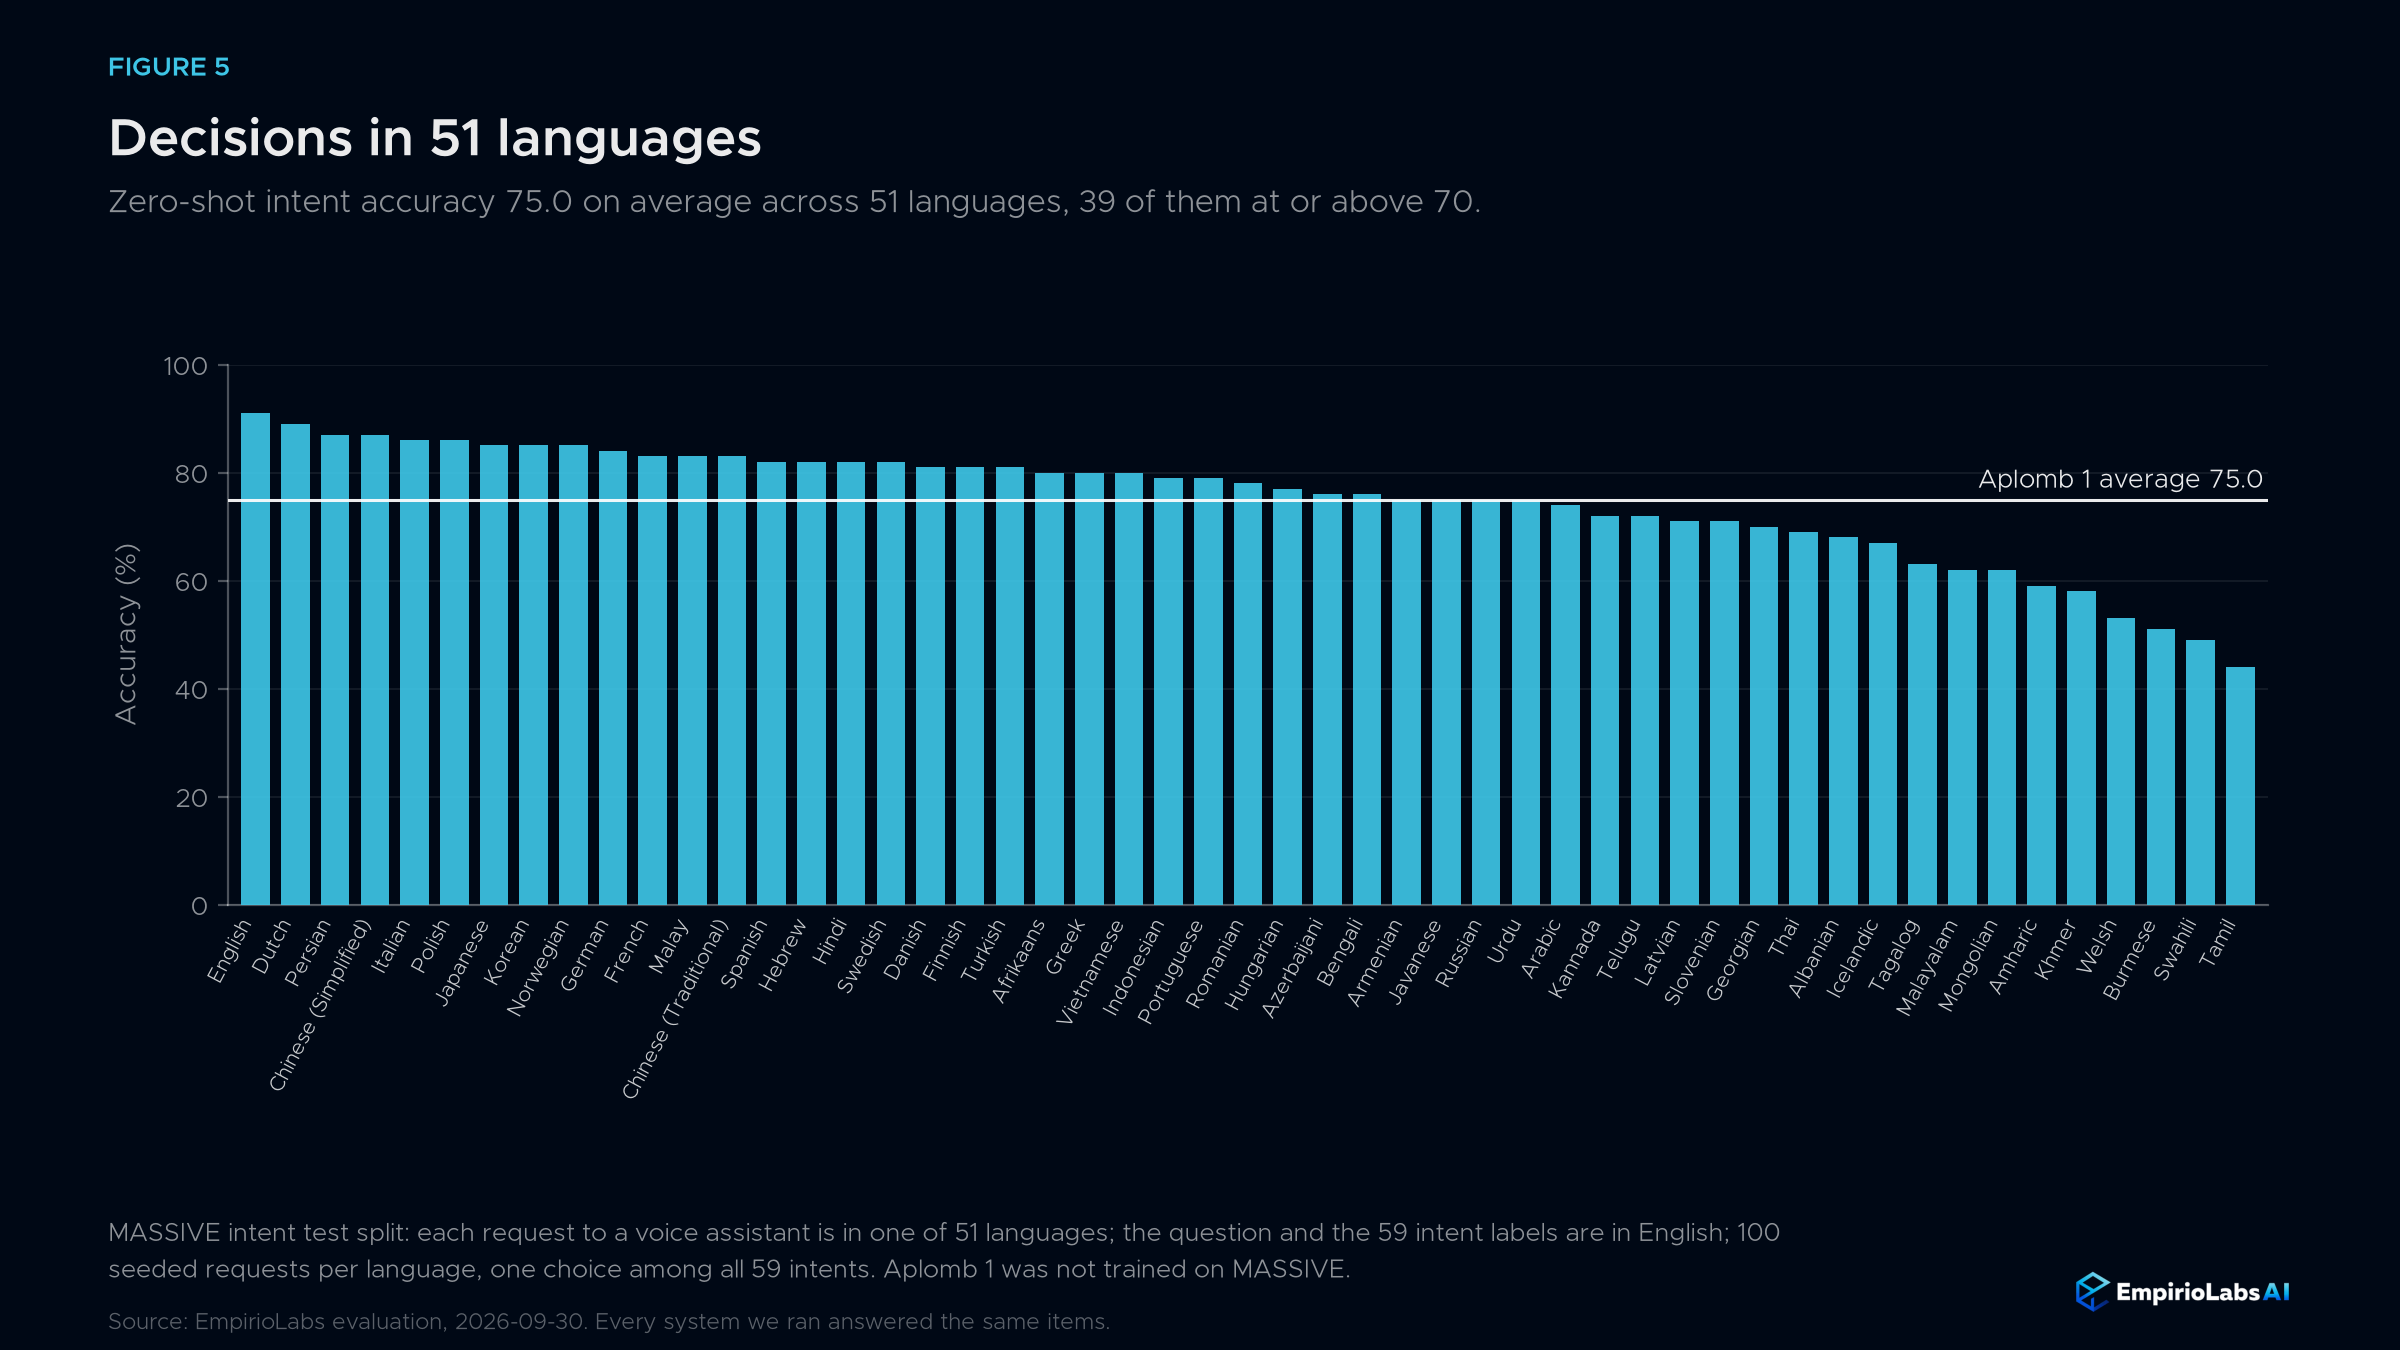
Para referência, o projeto Laya relata 40,1% de seu modelo multilíngue nos mesmos 51 idiomas ao escolher entre 20 intenções, e o projeto JevK5 relata 73,8% em inglês com todas as 60 intenções.
Índice de Decisão
O Índice de Decisão 0.2.1 tem uma média de 38 referências públicas em cinco áreas: conhecimento e raciocínio, entendimento de linguagem, recuperação e classificação, ferramentas e automação, e artes e gosto humano. Cada referência é corrigida por acaso, então 0 significa chute aleatório e 100 significa perfeito.
Rodamos o kit oficial no Aplomb 1 em 5 de outubro de 2026, e ele atendeu a todos os 150.317 pedidos de pontuação. Aplomb 1 pontua 44,86. Esta é nossa própria edição do kit, não uma entrada no quadro publicado.
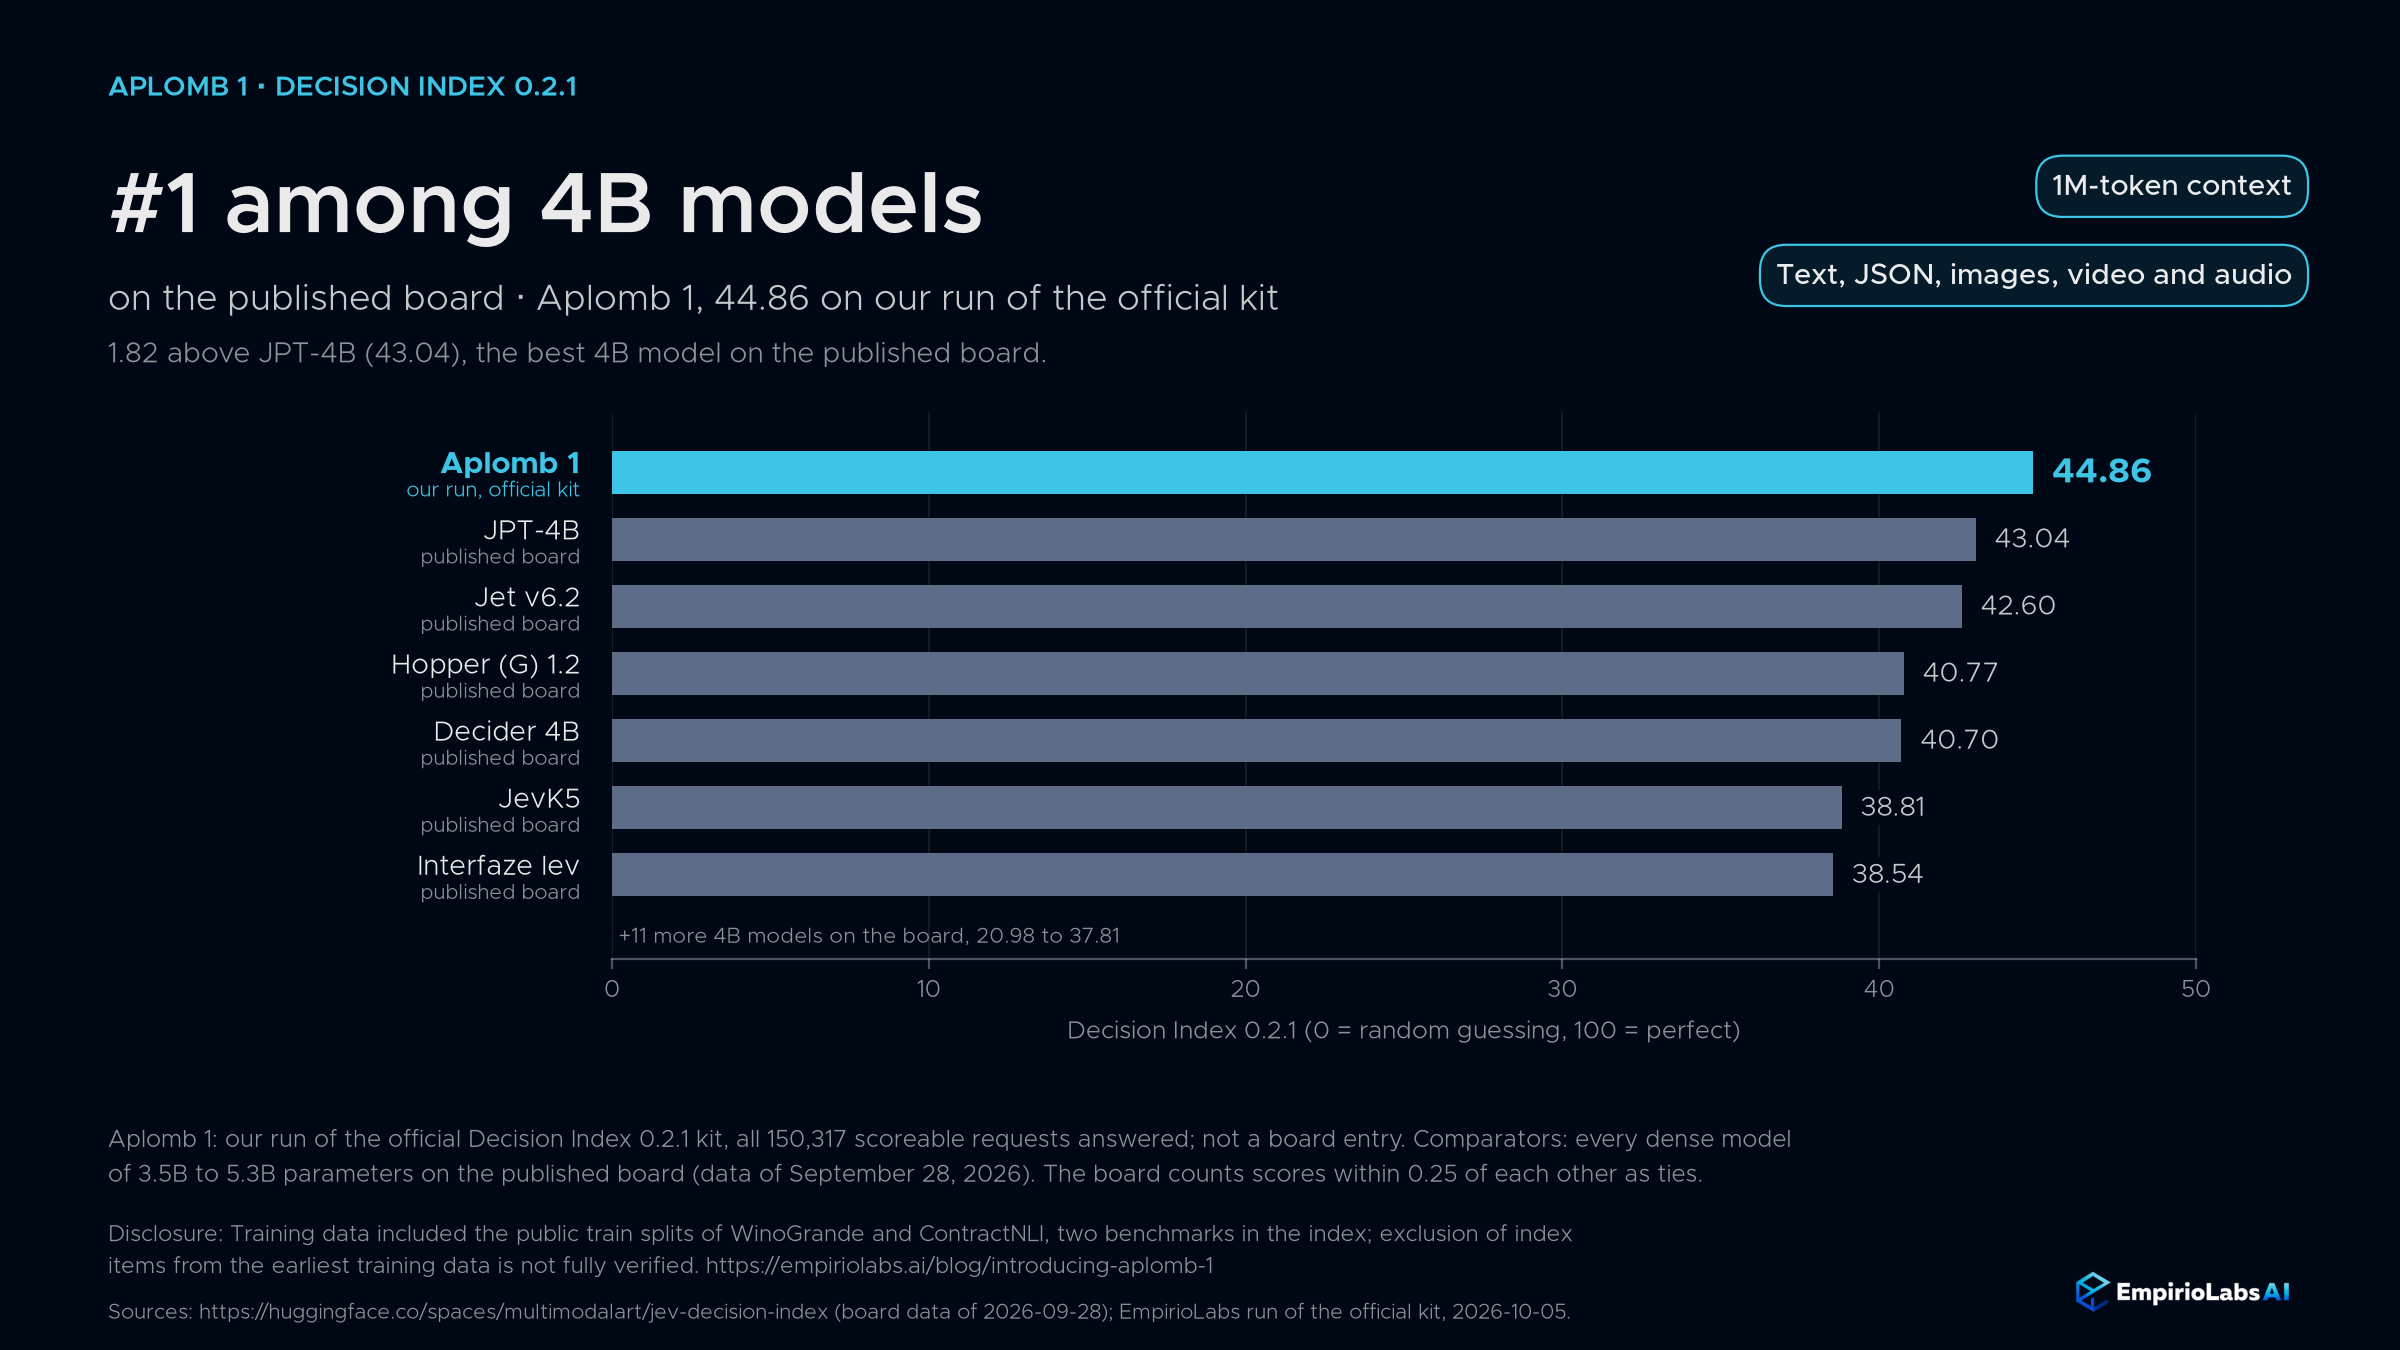
Em 6 de outubro de 2026, o Aplomb 1 está em #1 entre os modelos 4B no quadro publicado, e #1 entre os modelos até 5,3 bilhões de parâmetros em 8 dos 38 benchmarks, incluindo MMLU-Pro, GPQA Diamond e BBH. No painel publicado (dados de 28 de setembro de 2026), a maior pontuação para um modelo 4B é 43,04 do JPT-4B, 1,82 abaixo do Aplomb 1.
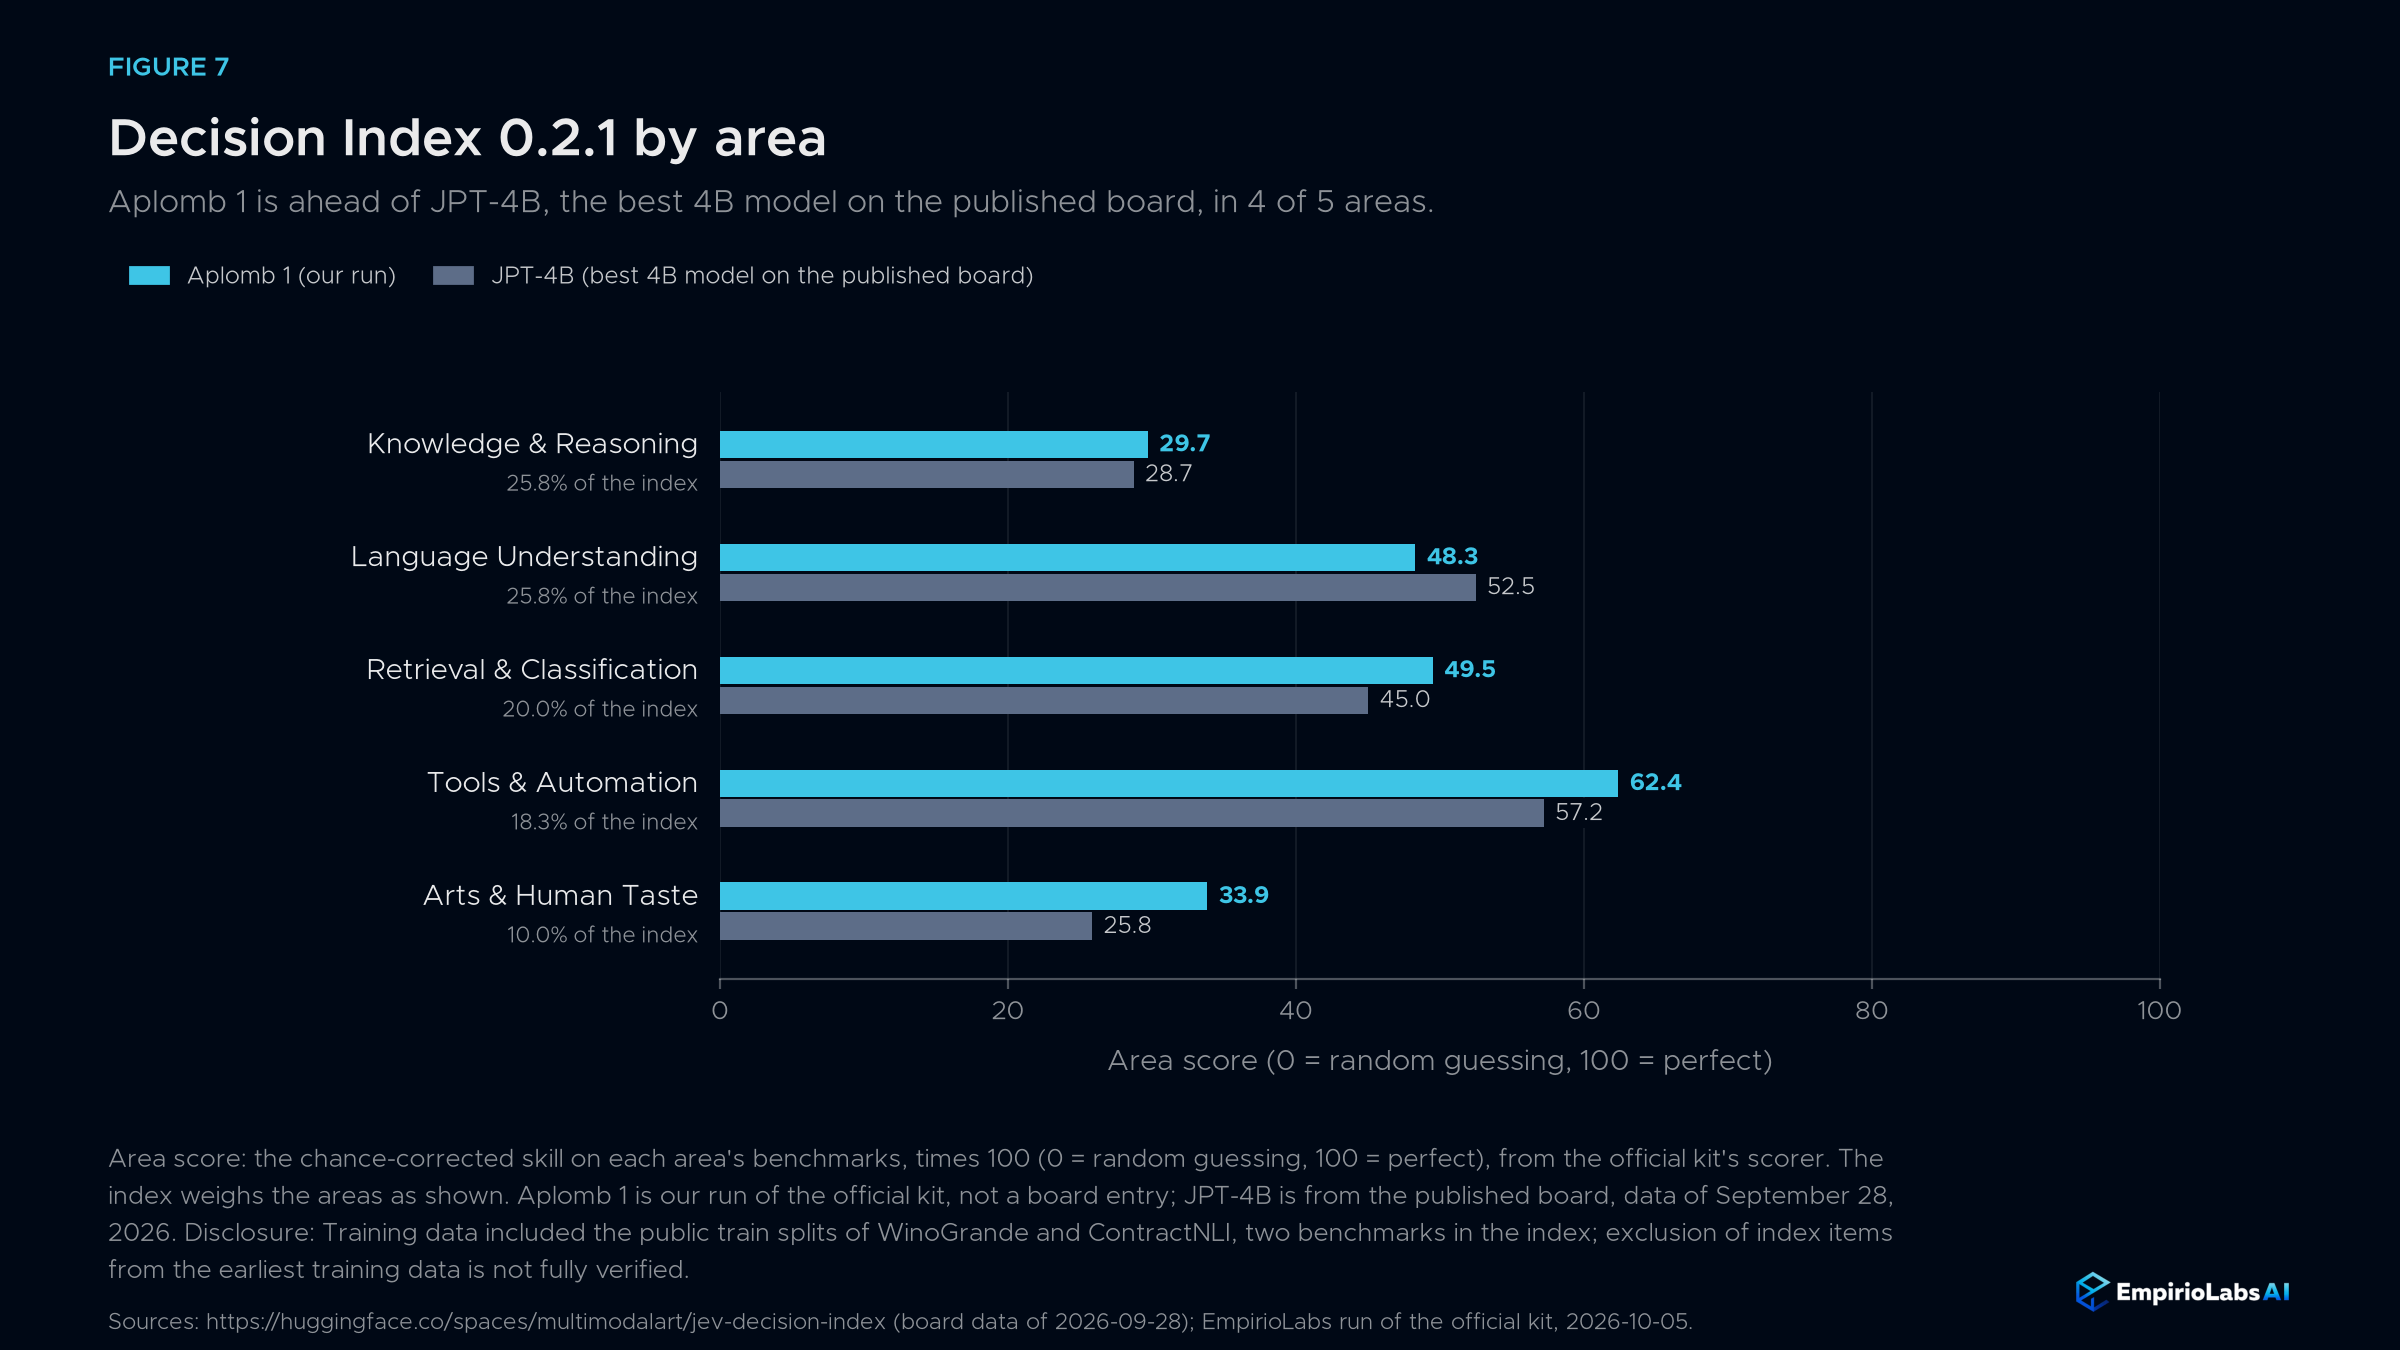
Por área, o Aplomb 1 obtém a maior pontuação em ferramentas e automação (62,4) e recuperação e classificação (49,5). Comparado ao JPT-4B, está à frente em quatro das cinco áreas e atrás na compreensão de idiomas (48,3 contra 52,5).
Divulgação. Os dados de treinamento do Aplomb 1 incluíam as divisões públicas de trem de WinoGrande e ContractNLI, dois dos 38 benchmarks do índice. Não pudemos verificar totalmente que os itens do índice foram excluídos dos dados de treinamento mais antigos.
Como se compara
O que cada modelo de decisão ou API aceita e responde, a partir de sua própria documentação publicada em 29 de setembro de 2026, com preços em 6 de outubro de 2026:
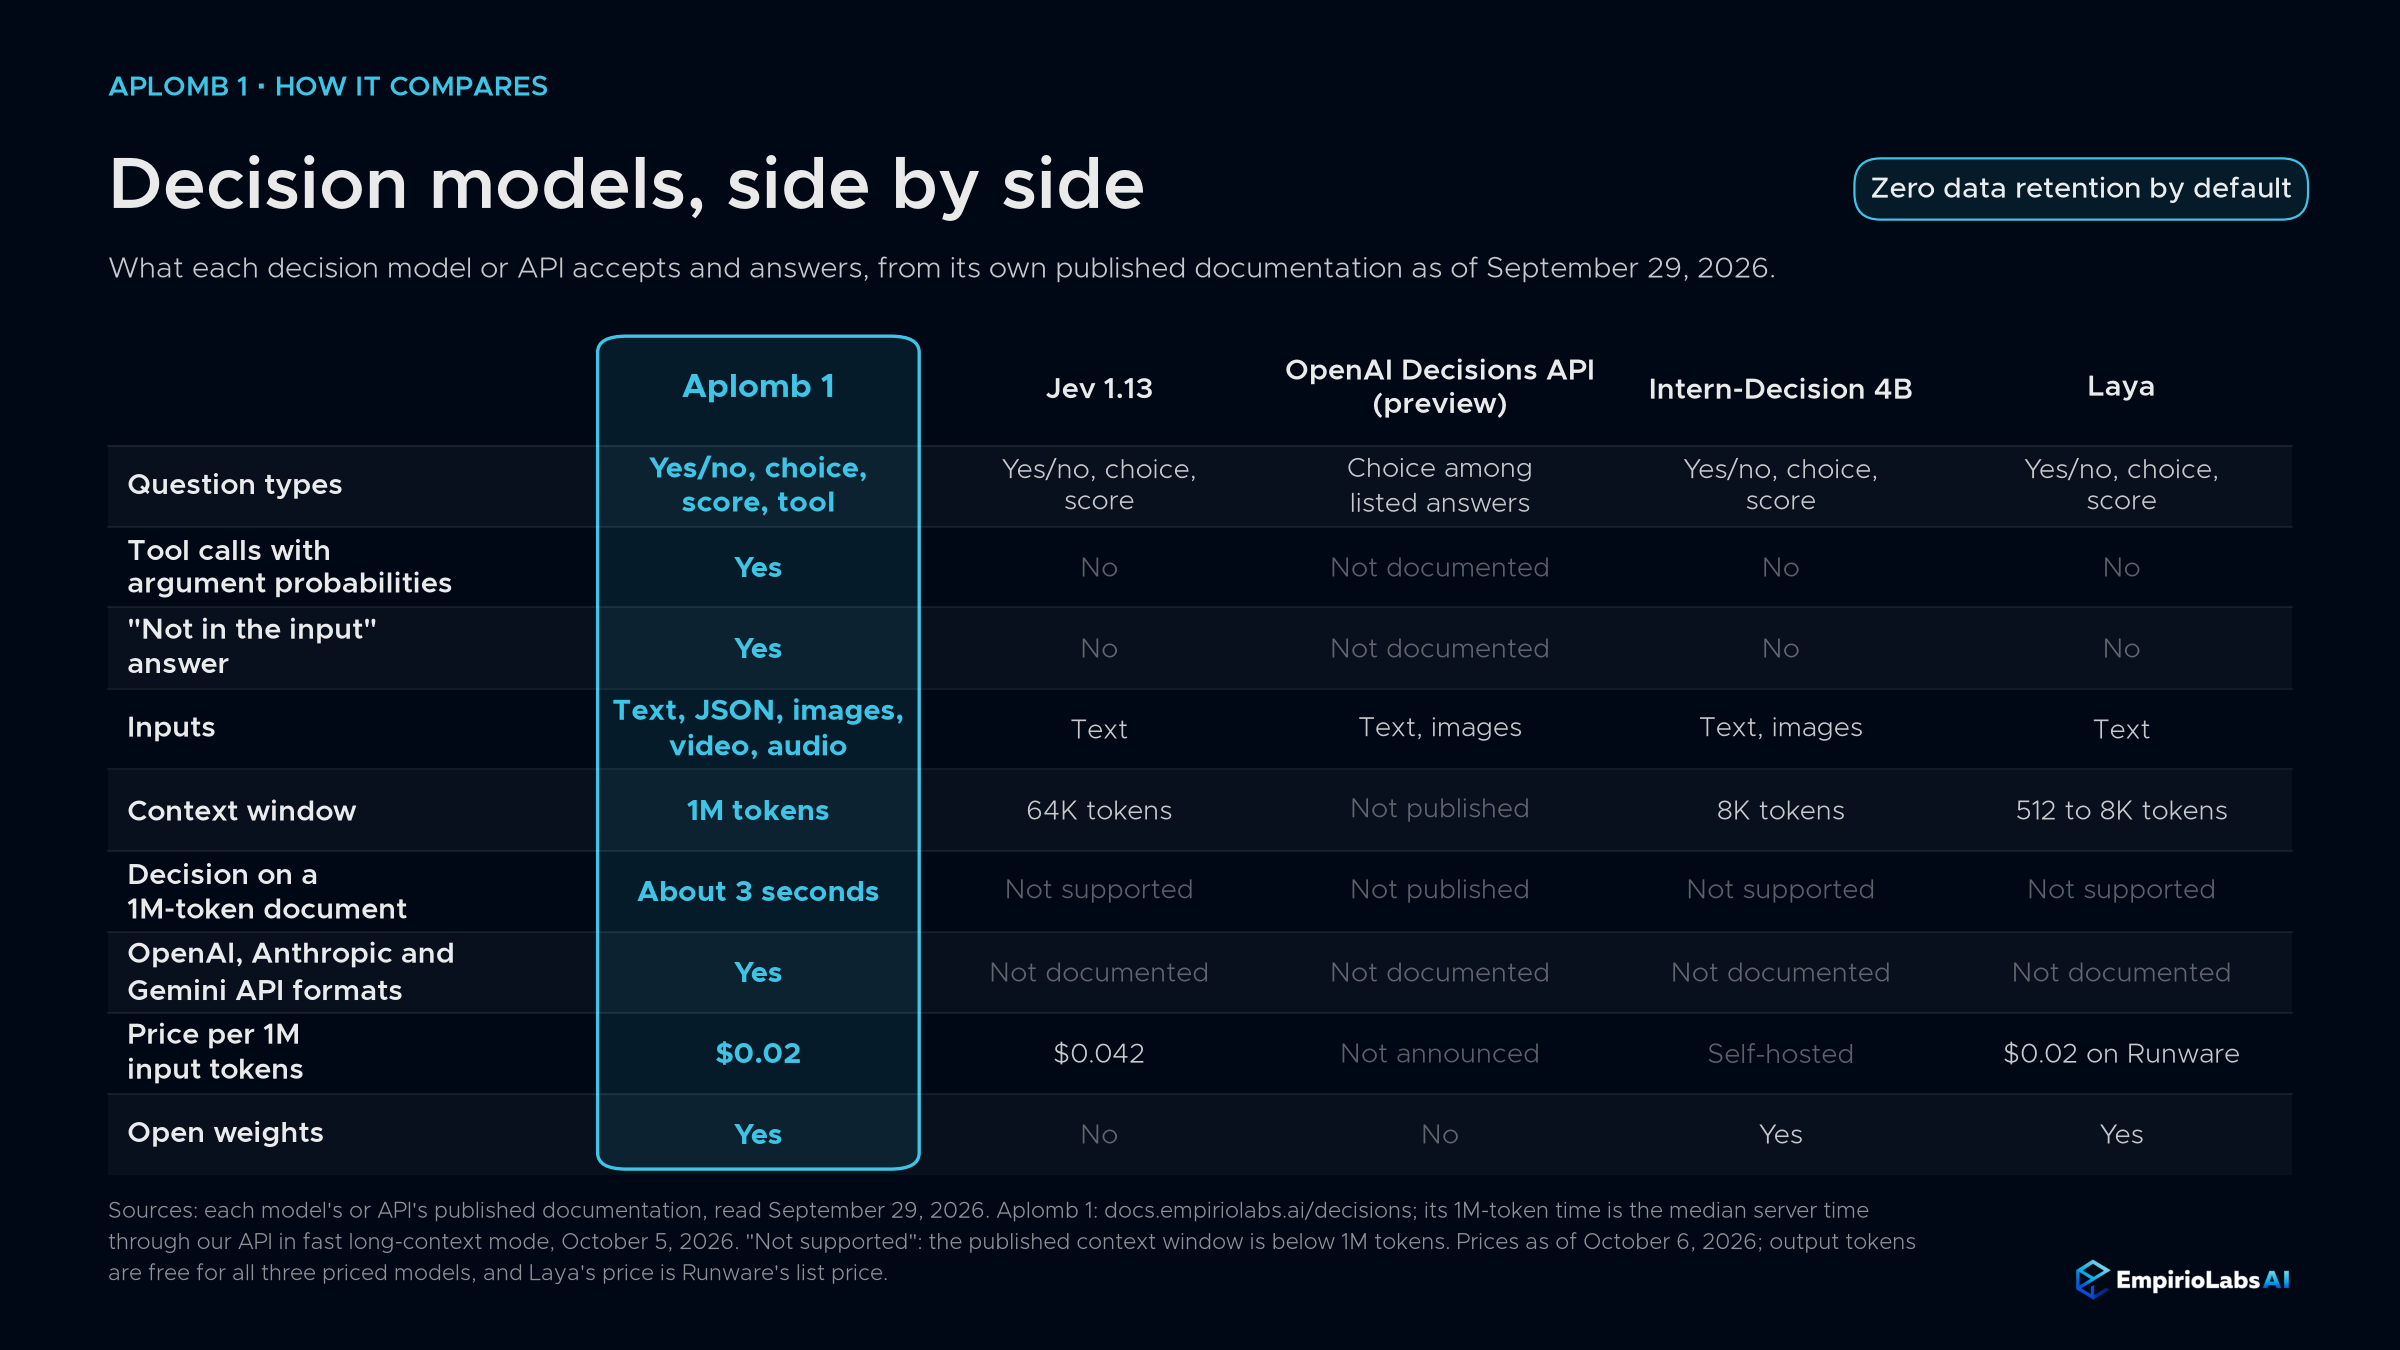
| Desenvoltura 1 | Jev 1.13 | API OpenAI Decisions (prévia) | Decisão de Estagiário 4B | Laya | |
|---|---|---|---|---|---|
| Tipos de perguntas | Sim ou não, escolha, pontuação, ferramenta | Sim ou não, escolha, pontuação | Escolha entre as respostas listadas | Sim ou não, escolha, pontuação | Sim ou não, escolha, pontuação |
| Seleção de ferramentas com probabilidades de argumento | Sim | Não | Não documentado | Não | Não |
| Não na resposta do estado | Sim | Não | Não documentado | Não | Não |
| Entradas | Texto, JSON, imagens, vídeo, áudio | Texto | Texto, imagens | Texto, imagens | Texto |
| Janela | 1.000.000 de fichas | 64K tokens | Não publicado | 8.192 fichas | 512 a 8.192 fichas |
| Preço por 1M de tokens de entrada | $0.02 | $0.042 | Não anunciado | Autohospedado | $0.02 no Runware |
| Pesos abertos | Sim | Não | Não | Sim | Sim |
Velocidade e faturamento
O Aplomb 1 roda com o próprio tempo de execução de inferência da EmpirioLabs para modelos de decisão. Uma pergunta curta leva cerca de 15 ms de tempo de modelo, uma pergunta com uma imagem de cerca de 35 ms, um documento de 15.000 tokens cerca de 0,3 segundos, e um estado de 1M-token cerca de 3 segundos em modo rápido de longo contexto, com o padrão acima de 131.072 tokens, ou cerca de 111 segundos lidos na íntegra.
Você paga apenas pelos tokens de entrada: o estado uma vez por requisição e o texto de cada pergunta, nunca um modelo de prompt. Tokens de saída são sempre zero. A taxa atual está no página do modelo e o página de preços.
Zero retenção de dados está ativada por padrão: não retemos o conteúdo das suas solicitações ou respostas.
Pesos abertos
O Aplomb 1 é construído sobre o Qwen3.5-4B. Estendemos sua janela de 262K para 1M de tokens, adicionamos entrada de áudio com o codificador de áudio do Qwen3-Omni, adicionamos nossa própria cabeça de decisão, que retorna todas as respostas como probabilidades calibradas em vez de texto gerado, e treinamos o modelo para decisões, incluindo seleção de ferramentas e a resposta not-in-the-input. Para a API e o Playground, construímos e otimizamos nosso próprio runtime de inferência.
Os pesos e um script de referência para executá-los você mesmo estão em huggingface.co/empiriolabsai/desenvoltura-1. As respostas do script podem diferir um pouco das da API.
Pesquisa, avaliação, uso pessoal e uso interno por organizações com receita anual inferior a US$1 milhões são gratuitas sob a Licença Modelo EmpirioLabs; hospedar o Aplomb 1 como serviço ou enviá-lo em um produto vendido para terceiros exige uma licença comercial.
Começar
curl https://api.empiriolabs.ai/v1/decisions \ -H "Autorização: Portador $EMPIRIOLABS_API_KEY" \ -h "Tipo-Conteúdo: application/json" \ -d '{ "modelo": "aplomb-1", "estado": {"pedido": {"id": "B-44120", "status": "enviado", "pagamento": "não pago"}}, "perguntas": { "pago": {"tipo": "noul", "instruções": "A ordem B-44120 foi paga?", "abstenha": verdadeiro}, "transportadora": {"tipo": "escolha", "instruções": "Qual transportadora está entregando a ordem B-44120?", "critérios": {"UPS": nulo, "FedEx": nulo, "FedEx": nulo, "DHL": nulo}, "abstenhamo": verdadeiro} } }'Pago Retorna como um não confiante. Operadora volta com um efeito alto abstenha-se probabilidade, porque o registro não nomeia uma portadora. O esquema completo, entrada de mídia e limites estão no Guia da API de decisões. O Aplomb 1 também aceita solicitações nos formatos OpenAI, Anthropic e Gemini, então você pode chamá-las a partir dos SDKs deles; os do guia Formatos de chat A seção mostra como um pedido de chat se mapeia para uma decisão. Tente sem código no Área de reprodução.
Agradecimentos
Construímos o Aplomb 1 com a ajuda do nosso harness de agentes de IA em dados, treinamento, avaliação e implantação. Graças à equipe Qwen pelo Qwen3.5 e Qwen3-Omni, sobre os quais o Aplomb 1 se baseia, ao Lambda pelas GPUs que treinamos e nos quais o atendemos, e ao programa NVIDIA Inception, ao programa de startup Z.ai e ao programa de startups StepFun pelo suporte.