LightOnOCR-3 4B는 EmpirioLabs에서 이용 가능합니다. LightOn의 문서 OCR 모델로, PDF나 이미지를 보내면 각 페이지를 Markdown으로 반환하며, 텍스트는 읽기 순서, 제목, 목록, 표, LaTeX의 수학, 그리고 데이터 포인트의 차트가 표시됩니다. 각 페이지는 레이아웃도 함께 반환합니다: 페이지 내 각 블록의 유형과 위치. 이 기능은 /v1/ocr 이후, API와 Playground에서 모두 포함됩니다.
벤치마크. LightOn은 LightOnOCR-3 4B의 전체 olmOCR-Bench 점수를 86.3으로 보고했습니다. 출시 공지 2026년 10월 8일.
내용
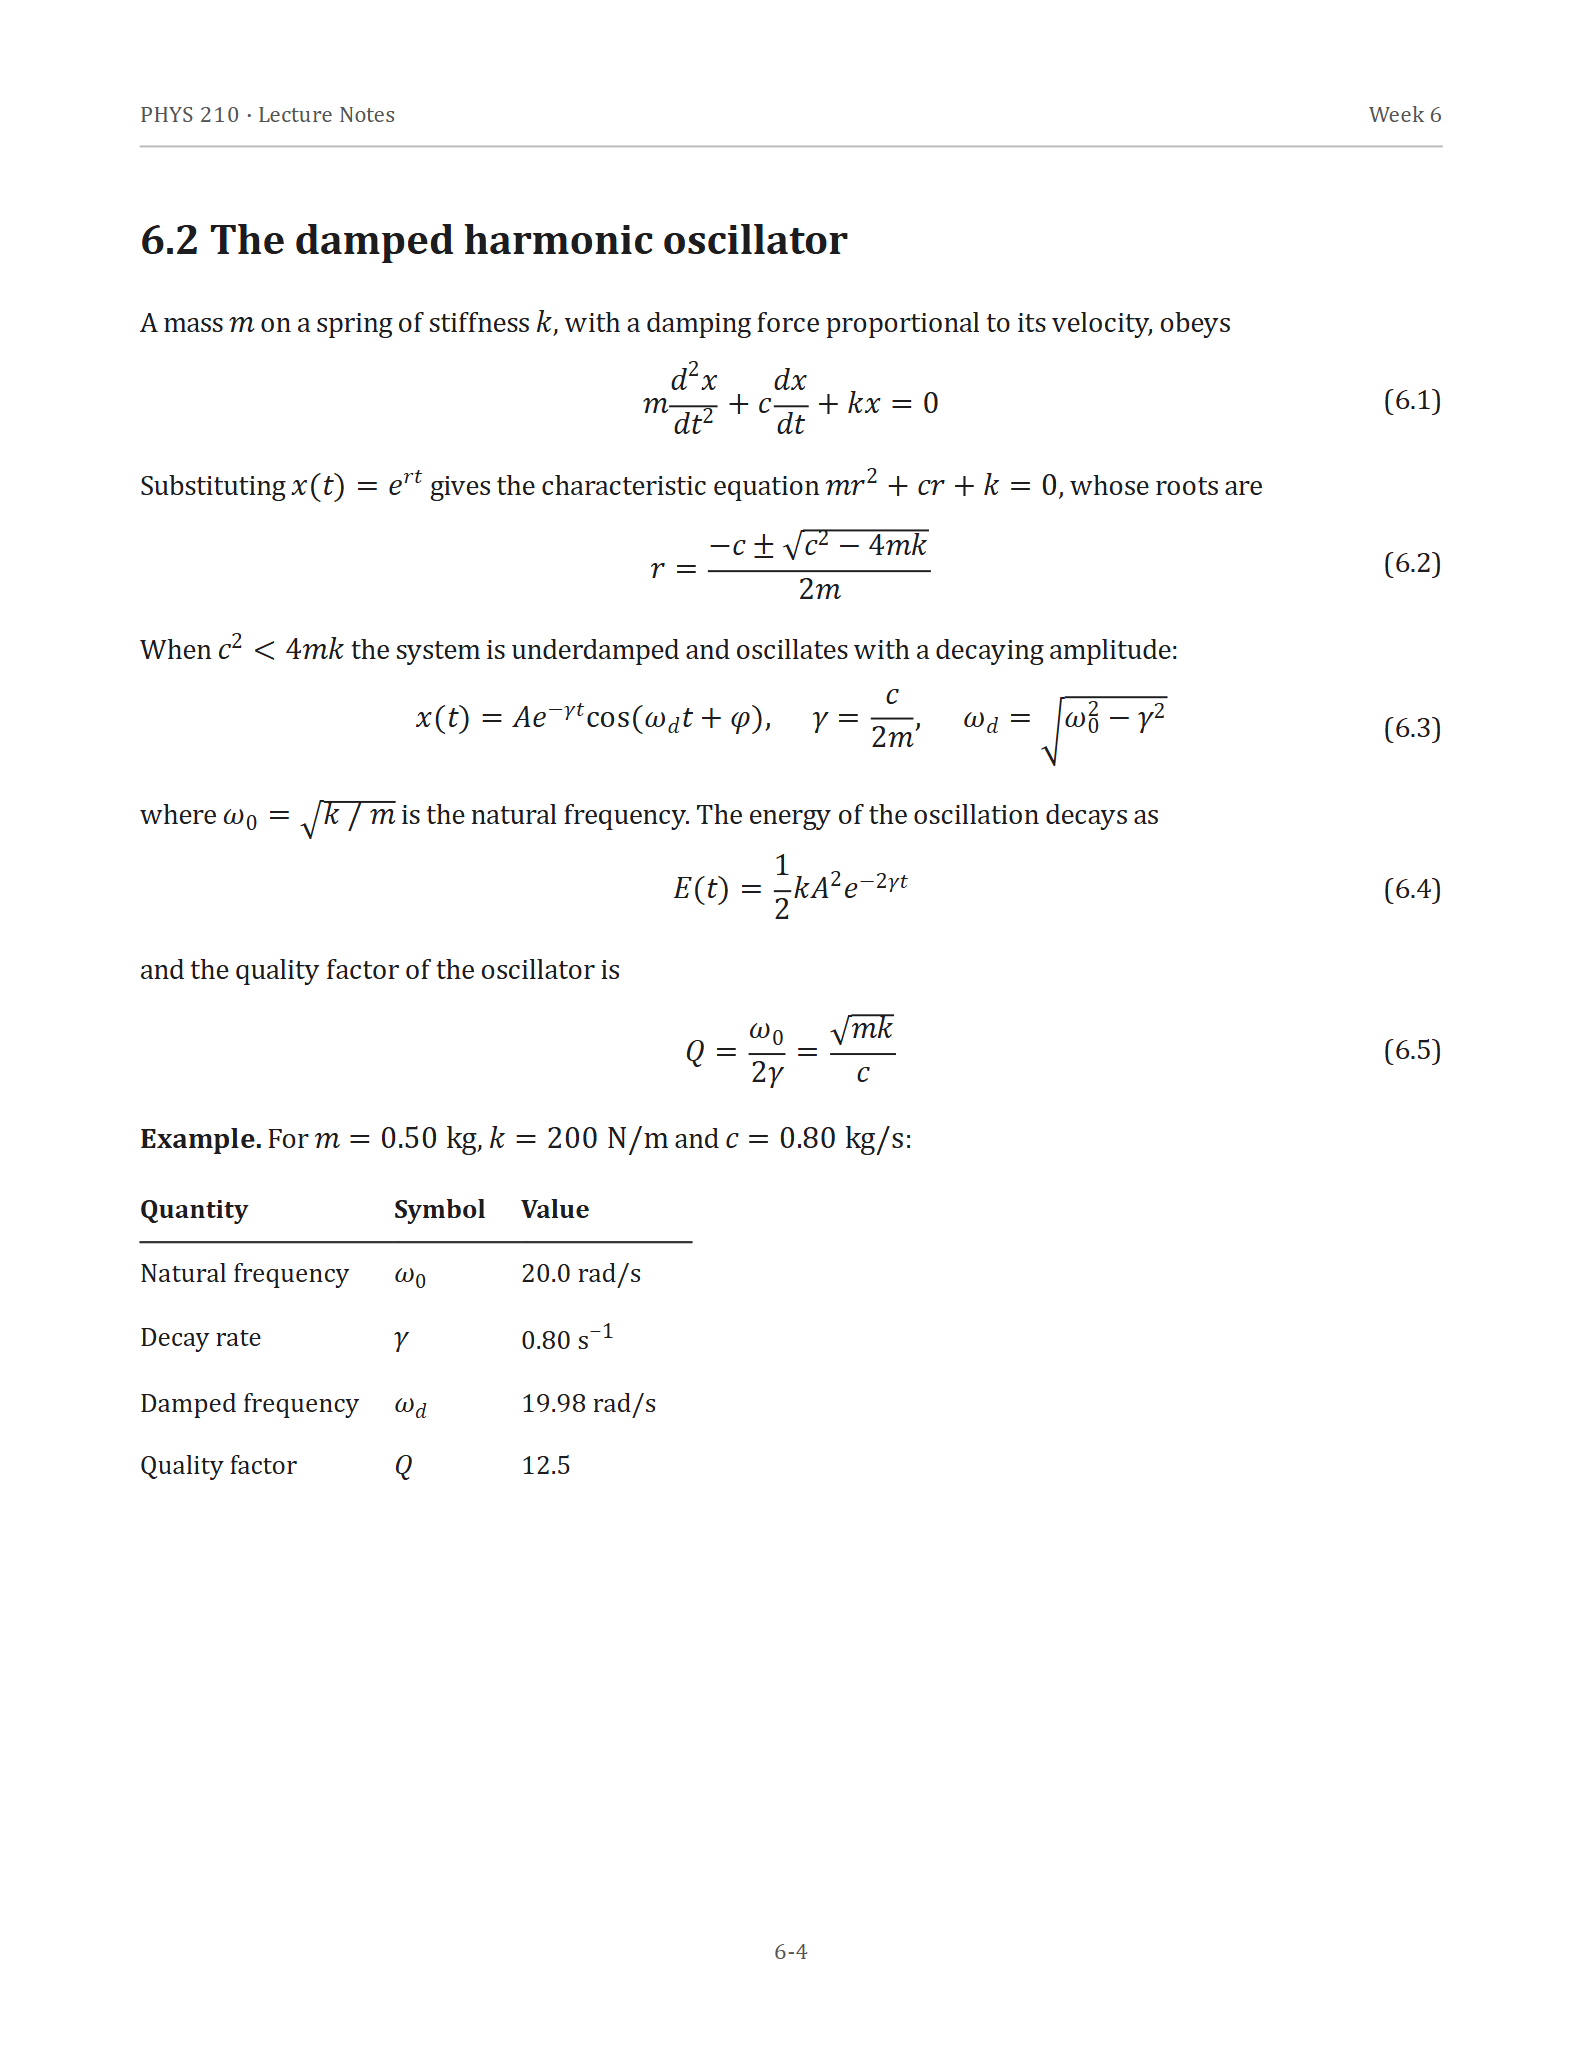
한 번의 요청으로 읽힌 강의 노트 테스트 페이지. 이 페이지와 세 명의 비전 채팅 모델에 대한 두 페이지가 더 포함되어 있습니다 LightOnOCR-3 4B 대 Qwen3.5 4B 대 Gemma 4 26B-A4B 대 Mistral Small 3.1·.
해당 페이지에 대해 반환된 마크다운의 시작 부분; 나머지 세 가지 방정식, 표, 그리고 페이지 번호도 같은 답변에서 따라옵니다:
물리학 210 · 강의 노트 6주차 ## 6.2 감쇠된 조화 진동기 $m 질량 $k$ 강성 스프링 위에 작용하며, 속도에 비례하는 감쇠력을 가진다는 뜻은 $$ m \frac{d^2 x}{dt^2} + c \frac{dx}{dt} + kx = 0 \quad \text{(6.1)} $$ $x(t) = e^{rt}$ 대입하면 특성 방정식 $mr^2 + cr + k = 0$, 근은 $$ r = \frac{-c \pm \sqrt{c^2 - 4mk}}{2m} \quad \text{(6.2)} $$당신의 첫 번째 요청
문서를 URL로 전송하거나 base64 데이터 URI로 전송할 수 있습니다. 이 요청은 샘플 PDF의 첫 두 페이지를 읽습니다:
curl https://api.empiriolabs.ai/v1/ocr \ -h "인증: 베어러 $EMPIRIOLABS_API_KEY" \ -h "Content-Type: application/json" \ -d '{ "model": "lightonocr-3-4b", "document": { "type": "document_url", "document_url": "https://media.empiriolabs.ai/assets/blog-images/lightonocr-3-4b-test-2026-10-25/sample-document.pdf" }, "pages": [0, 1] }'컴퓨터의 파일은 호스팅이 필요 없는 데이터 URI로 들어갑니다:
open("report.pdf", "rb")을 handle로 사용하여 import base64 OS 가져오기 요청: encoded = base64.b64encode(handle.read().decode() 응답 = requests.post("https://api.empiriolabs.ai/v1/ocr", 헤더={"Authorization": f"Bearer {os.environ['EMPIRIOLABS_API_KEY']}"}, json={ "model": "lightonocr-3-4b", "document": {"type": "document_url", "document_url": f"data:application/pdf; base64,{encoded}"}, }, timeout=300,) response.raise_for_status() response.json 내 페이지 사용["pages"]: print(f"--- page {page['index'} ---") print(page["markdown"])이미지도 같은 방식으로 작동합니다. "유형": "image_url" 그리고 URL 또는 데이터 URI는 image_url. 문서는 PDF 또는 PNG, JPEG, WebP, TIFF, BMP, GIF, AVIF 이미지 최대 50MB일 수 있으며, 한 번의 요청은 최대 1,000페이지까지 읽을 수 있습니다.
돌아오는 것들
응답은 각 페이지당 하나의 객체를 저장합니다. 페이지. 각 페이지는 다음과 같습니다. 할인; 블록, 페이지의 각 영역이 해당 유형과 함께 읽기 순서대로 (제목·, 본문·, 목록·, 표·, 방정식·, 캡션·, 헤더·, 기초그리고 픽셀로 된 상자; 이미지, 이미지 영역들; 그리고 치수, 박스들이 참조하는 페이지 이미지 크기입니다. usage_info.pages_processed 읽은 페이지를 세는 것입니다. 강의 노트 페이지에 반환된 16개의 블록 중 하나:
{ "type": "equation", "top_left_x": 641, "top_left_y": 526, "bottom_right_x": 1447, "bottom_right_y": 610, "content": "$$\nr = \\frac{-c \\pm \\sqrt{c^2 - 4mk}}{2m} \\quad \\text{(6.2)}\n$$" }요청은 페이지를 읽으면 답변을 받는다. 약 4분 반 정도 답변이 지나도 계속 진행 중이다 202 with a 작업 id: 여론조사 빨리 /v1/jobs/{job_id} 그러다 현황 이야. 지원하다, 그리고 페이지들이 들어갔다 결과. 작업 ID를 한 번에 받으려면 헤더를 보내세요 선호: 리스폰스-비동기·.
옵션
- 페이지.
페이지0 기반 페이지 번호를 목록으로 사용합니다 ([0, 2, 3]) 또는 문자열 ("0,2-4"). 모든 페이지를 읽을 때 꺼내세요. - 테이블.
table_format다음할인또는HTML각 테이블을 다음으로 이동시킵니다표그 형식에서 다음과 같은 링크를 남깁니다.[tbl-0.html] (tbl-0.html)페이지 Markdown 안에 있습니다. 이 기능이 없으면 테이블은 HTML로 Markdown 내에 남아 있습니다. - 이미지들.
include_image_base64각 이미지 영역은 JPEG 데이터 URI로 반환합니다.image_limit문서 전체에서 반환되는 이미지 수를 제한하고,image_min_size그 픽셀 수보다 좁거나 짧은 영역은 제외합니다. - 헤더와 하단 말.
extract_header그리고extract_footer마크다운에서 각자 들판으로 옮기세요. - 레이아웃.
include_blocks다음거짓잎블록나가.
운용 노트
- 페이지 번호는 0부터 시작합니다.
"페이지": [1]두 번째 페이지를 읽는다. - 달러 기호는 도망칠 수 있습니다. 페이지 텍스트에는 달러 기호가 적혀 있을 수 있습니다
\$, 그리고 HTML 테이블 안에서&달러;. 금액을 찾기 전에 Markdown을 해제하세요. - 주석 필드는 거부됩니다.
bbox_annotation_format·,document_annotation_format, 그리고document_annotation_prompt답변400어떤 페이지도 읽기 전에.
제품정보
페이지당 청구됩니다. 각 요청은 최소 5페이지 분량으로 청구되므로, 긴 문서를 페이지당 한 번의 요청이 아닌 하나의 PDF로 보내세요. 실패한 요청은 반환하지 않은 페이지에 대해 청구되지 않습니다. 현재 요금은 모델 페이지 그리고 가격표·.
건설 시작
LightOnOCR-3 4B를 시도해 보세요. Playground 자신의 문서와 함께 읽어보세요. 문서 OCR 가이드 그리고 API 문서 모든 매개변수에 대해
공개: 이 문서는 AI 지원으로 작성되었으며 EmpirioLabs AI에 의해 검토되었습니다.