Aplomb 1은 저희의 첫 번째 모델입니다. 텍스트, JSON, 이미지, 오디오, 비디오를 한 번에 받아 최대 1M 토큰을 읽고, 1M 토큰 문서에 대해 약 3초 만에 결정을 내립니다. 짧은 질문 한 개는 모델 시간 약 15ms가 소요됩니다.
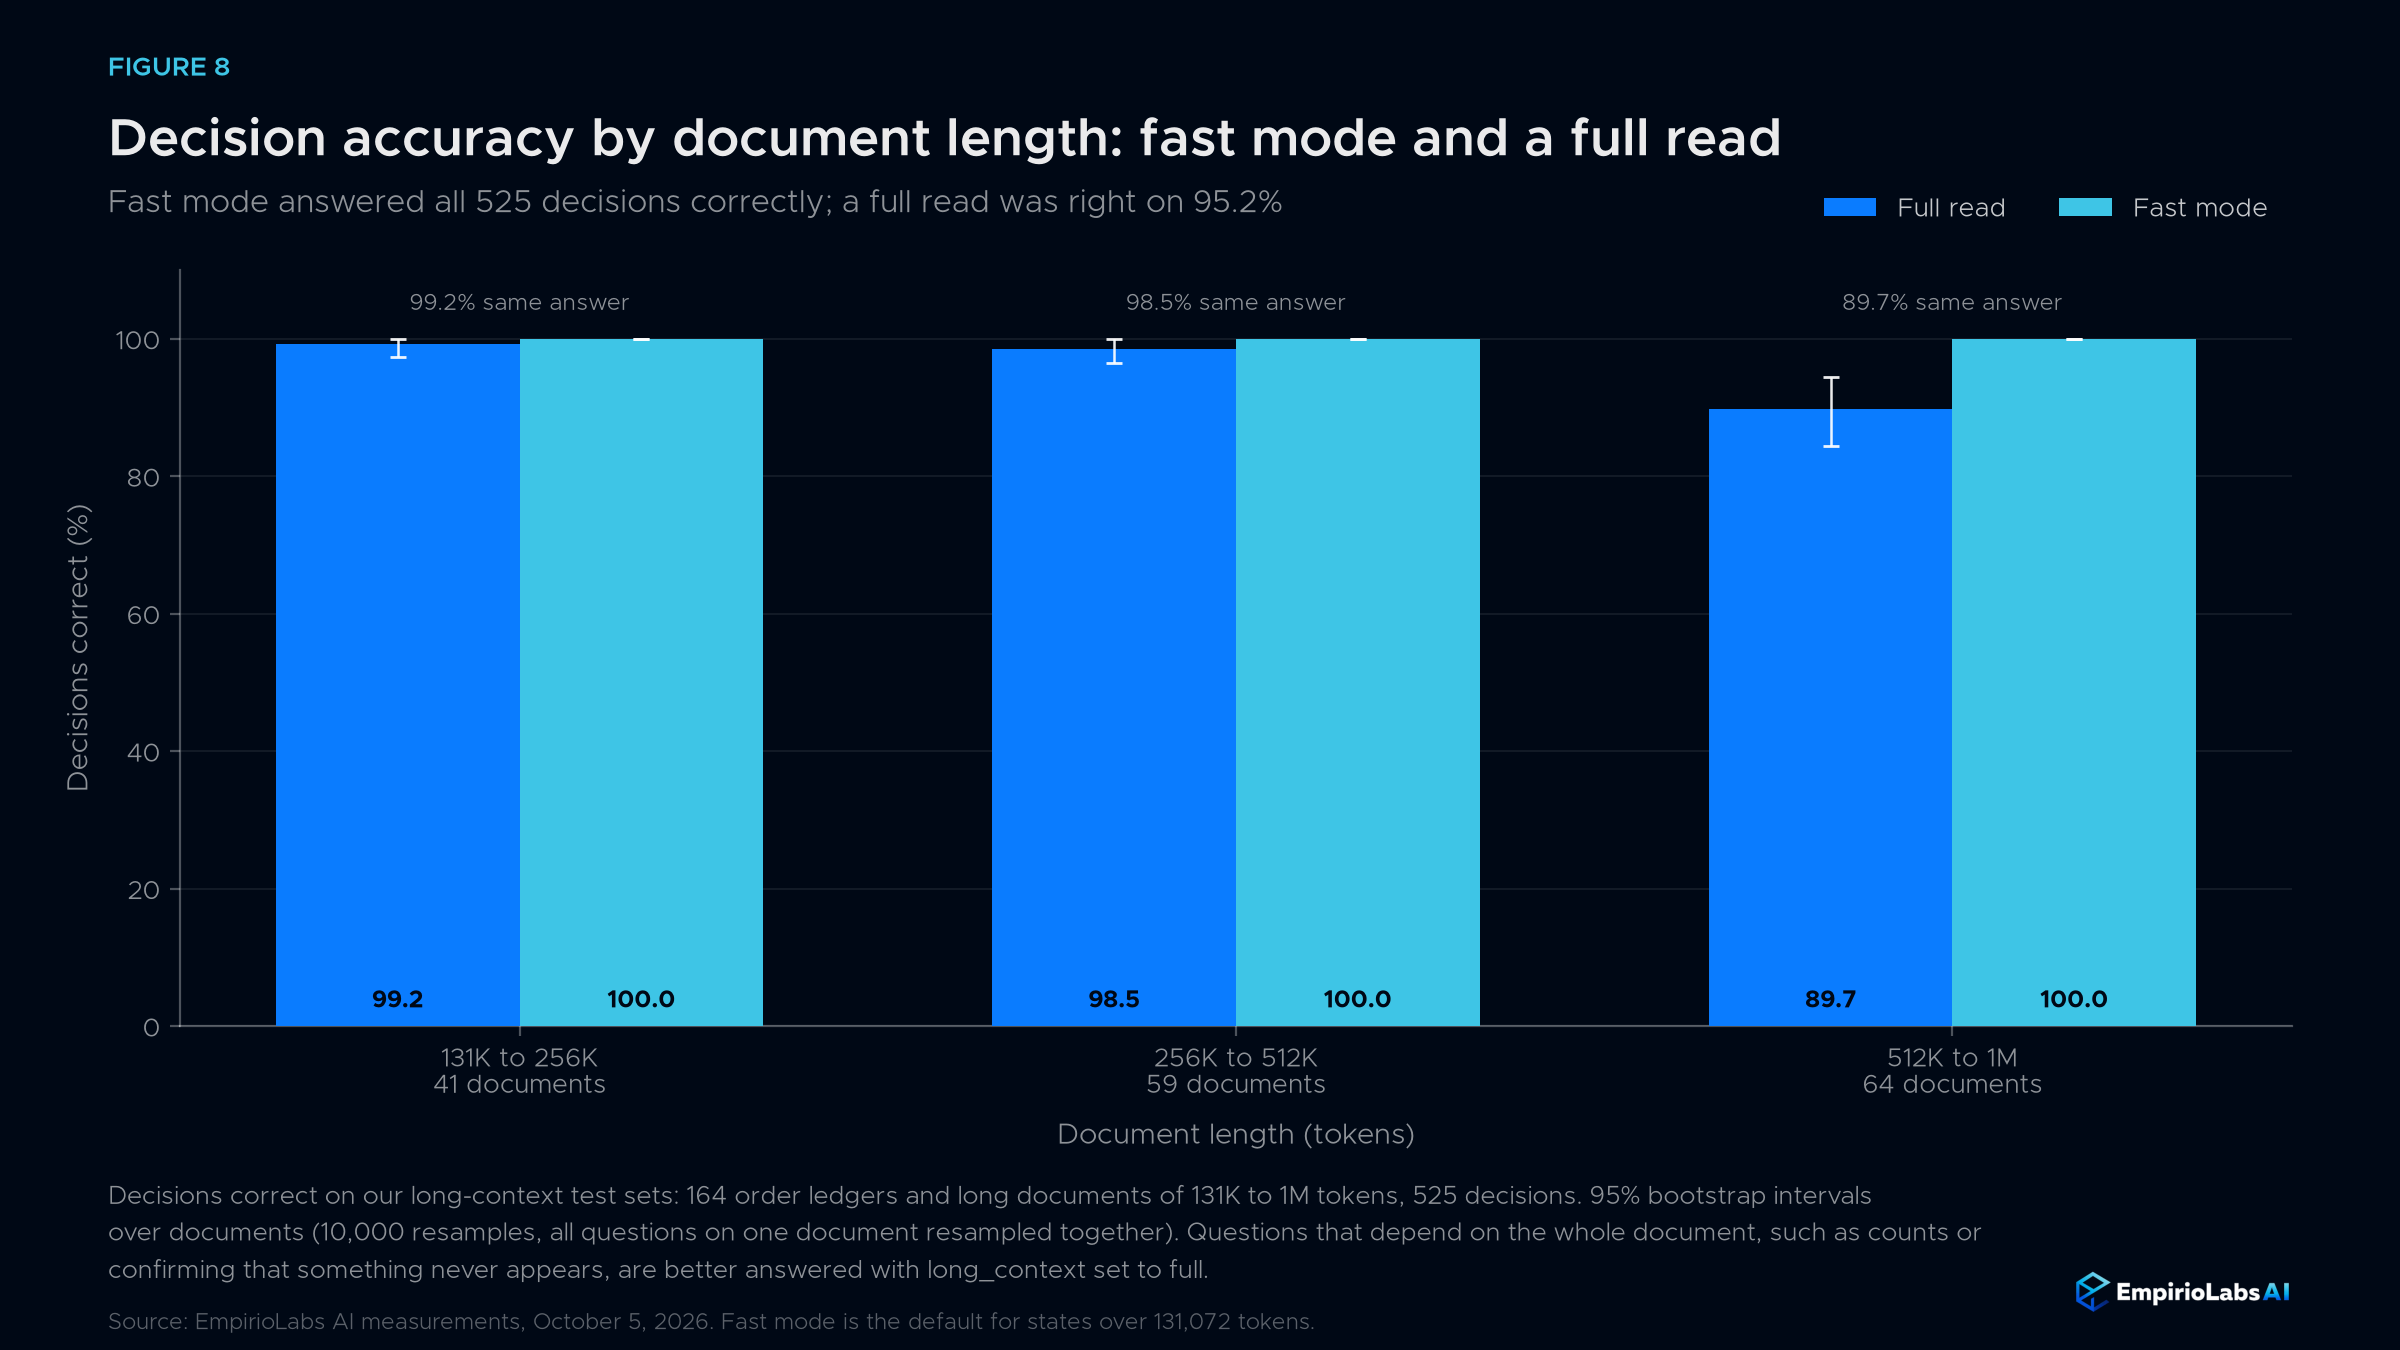
이 모델은 우리가 결정 모델용으로 구축한 추론 런타임에서 실행됩니다. 우리 API와 Playground에서는 긴 문서가 빠른 장기 문맥 모드를 거칩니다: 1M 토큰 문서는 111초가 아닌 약 3초가 걸리며, 빠른 모드는 장기 문맥 테스트에서 525개의 결정 모두에 정확히 답했습니다.
에이전트의 경우, Aplomb 1은 한 번의 요청에서 모든 도구와 각 열거 및 불리언 인수에 대해 확률을 반환하므로, 모델이 확실할 때는 행동하고, 그렇지 않을 때는 에스컬레이션됩니다. 모든 답변은 보정되며, 입력이 답을 유지하지 않을 때 예측할 수 있습니다. 이 시스템은 티켓 라우팅부터 에이전트의 다음 도구 선택까지 하루에 수천 번 내리는 결정을 위해 설계되었습니다.
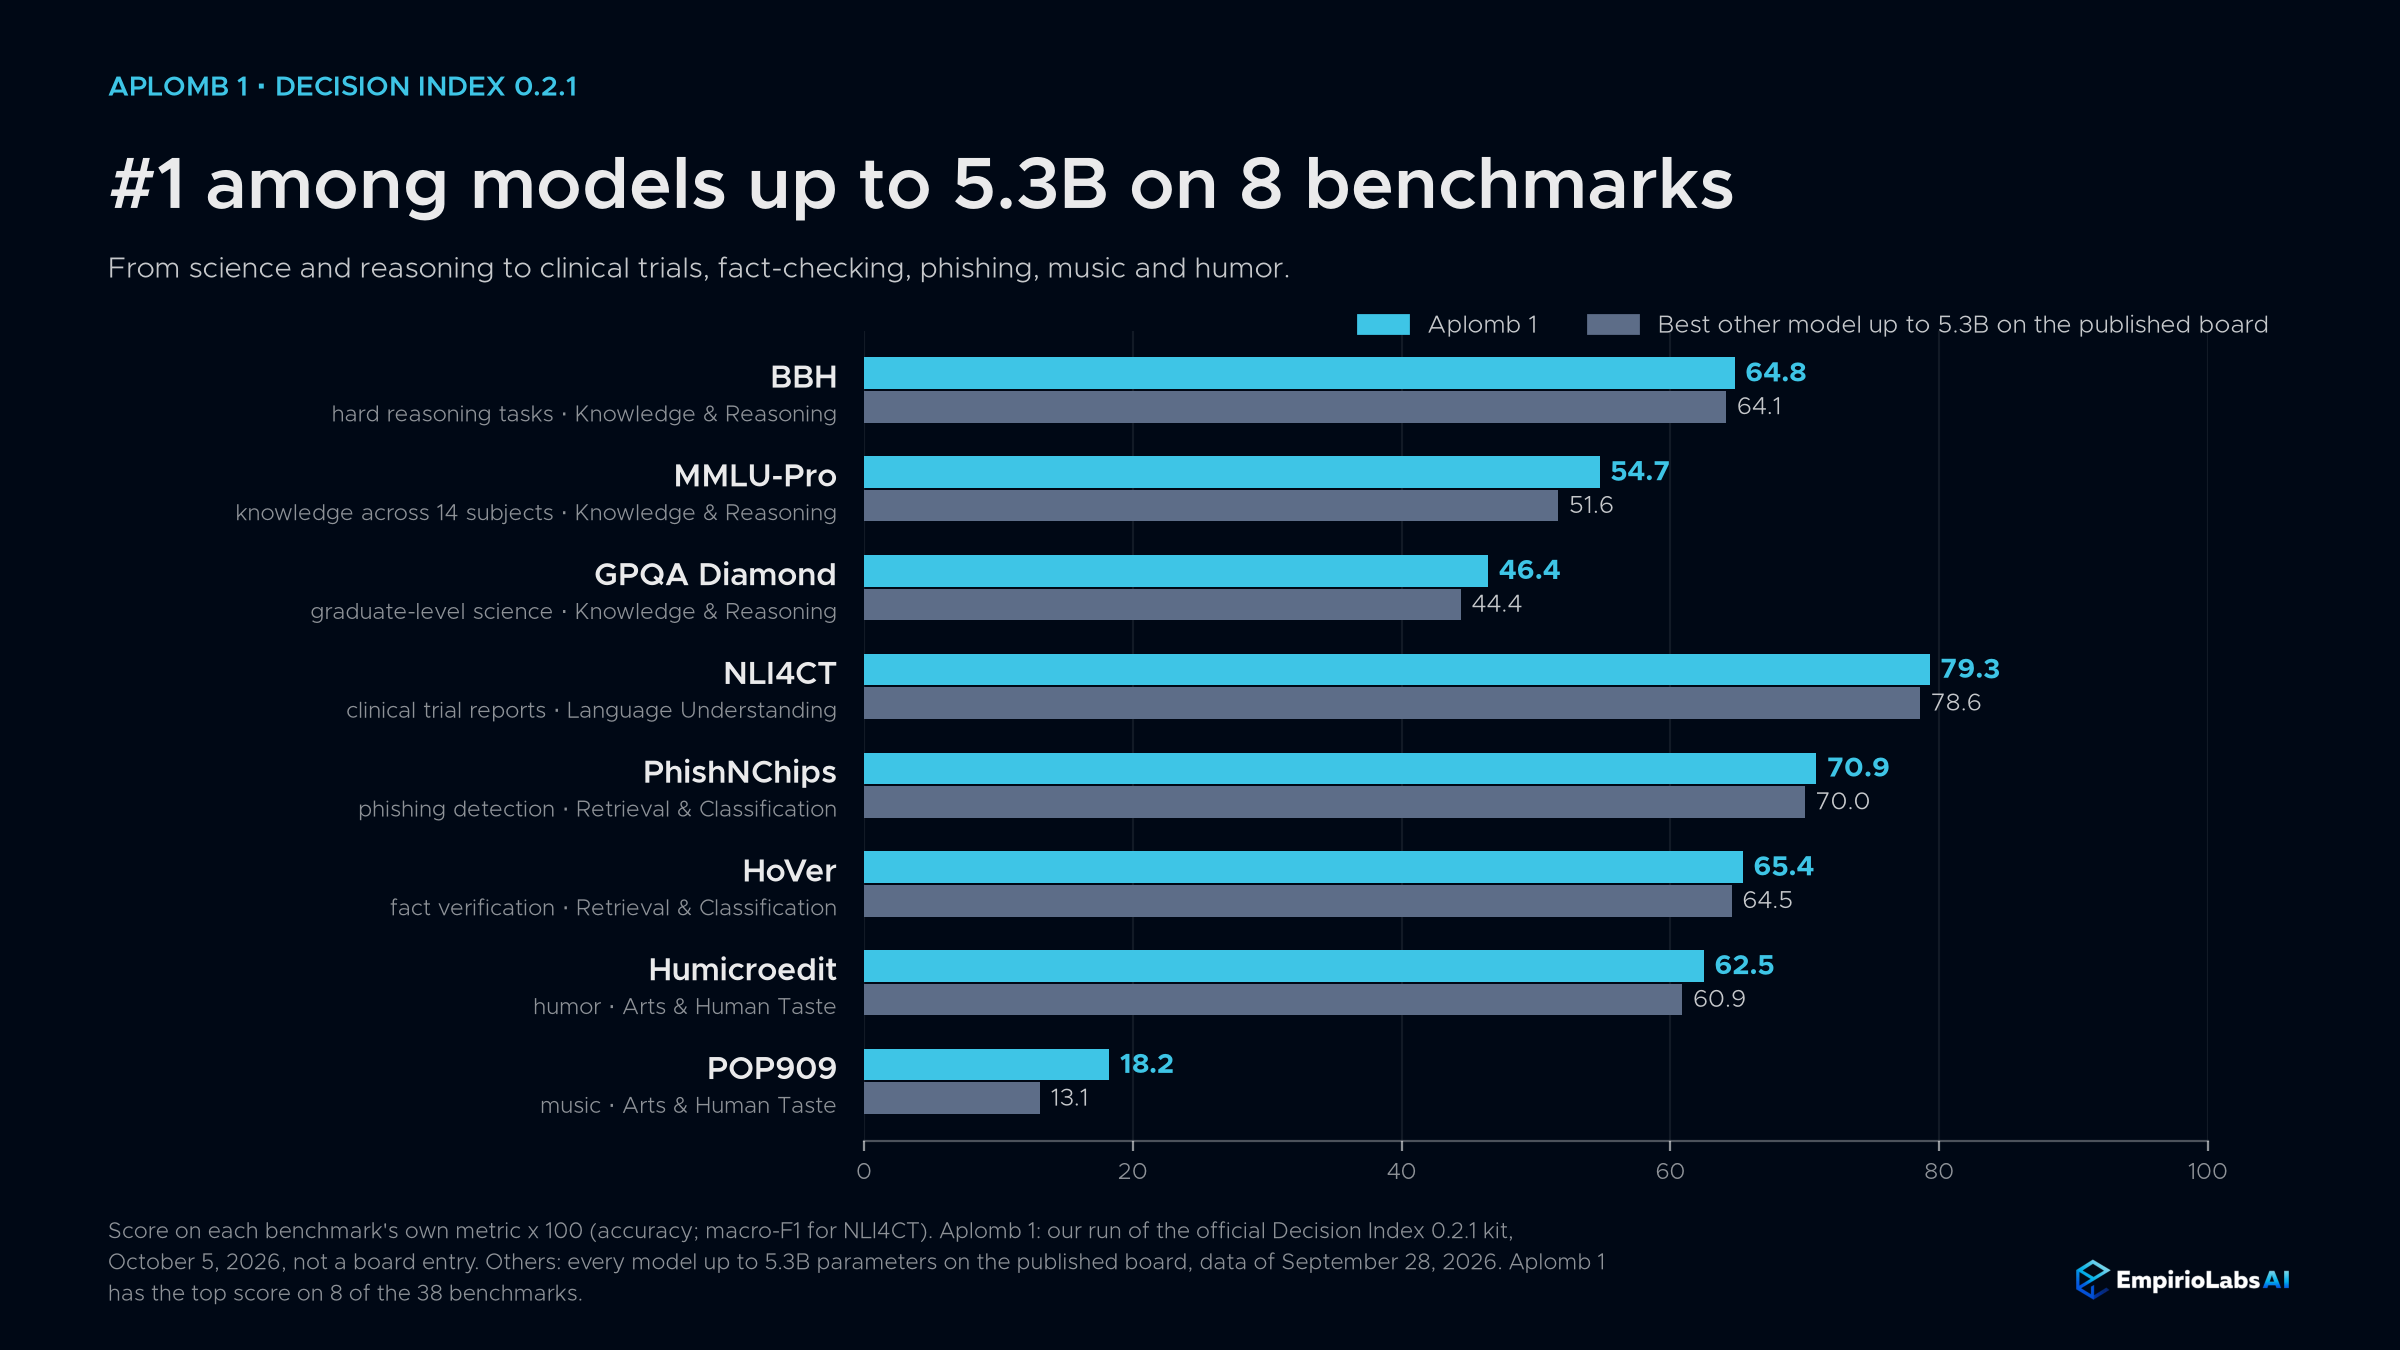
2026년 10월 6일 기준으로, 발표된 Decision Index 보드에서 4B 모델 중 #1위이며, 공식 키트 기준 44.86, 38개 벤치마크 중 8개 기준에서 53B 파라미터 이하 모델 중 #1위입니다. 현재 EmpirioLabs API와 Playground에서 이용 가능하며, 가중치는 Hugging Face의 EmpirioLabs 모델 라이선스 하에 있습니다.
| Aplomb 1 한눈에 보기 | |
|---|---|
| 입력 | 텍스트, JSON, 이미지, 비디오, 오디오, 어떤 믹스에서든 |
| 창문 | 1,000,000 토큰 상태 및 질문 |
| 질문 | 예 또는 아니오, 선택지(2개에서 255개), 점수(2단계에서 10단계), 도구 선택 |
| 주에서는 그렇지 않습니다 | 입력이 답을 갖지 않을 확률입니다 |
| 공구 선택 | 다음으로 호출할 도구, 그 열거 및 불리언 인수에 대한 확률을 포함해 |
| 속도 | 짧은 질문에 대해 약 15ms의 모델 시간; 빠른 장기 컨텍스트 모드에서 1M 토큰 문서의 경우 약 3초가 소요됩니다 |
| API 형식 | Decisions API와 함께 OpenAI, Anthropic, Gemini 포맷을 지원합니다 |
| 청구 | 입력 토큰만; 출력 토큰은 항상 0입니다 |
| 데이터 보존 | 기본적으로 데이터 보존 제로입니다 |
| 크기 | 53억 개의 파라미터, Qwen3.5-4B 위에 구축됨; Hugging Face의 오픈 가중치 |
| 결정 지수 0.2.1 | 공식 키트 기준 44.86, 2026년 10월 6일 기준 4B 모델 중 #1 |
답변
네 가지 문제 유형이 있습니다. 눌 예 또는 아니오로 답할 확률이 있습니다. 선택 2개에서 255개 옵션 중 하나를 선택해 전체 분배금을 반환합니다. 음악 국가를 2에서 10까지의 질서 있는 척도로 배치합니다. 도구 어떤 함수 도구를 호출할지 선택하고, 열거 및 불리언 인수에 대한 분포를 반환합니다.
주에서는 그렇지 않습니다. 추가 "기권": 참 질문과 답변에 대한 답변은 상태가 질문에 필요한 내용을 포함하지 않을 확률도 포함합니다. 반송자 필드가 없는 기록은 확신 있는 추측 대신 높은 무조건 확률을 받습니다.
독립적인 답변들. 최대 128개의 질문이 하나의 상태를 공유하며, 각 질문이 독립적으로 답변되므로 질문을 추가해도 다른 답변이 바뀌지 않습니다.
에이전트를 위한 도구 선택
Aplomb 1에 에이전트의 함수 도구와 현재 상태(티켓, 대화, 레코드)를 주면, 다음 호출 도구를 모든 도구에 대한 확률과 각 열거 및 불 인자별 분포로 한 번의 요청으로 반환합니다. 일반 LLM은 토큰 호출 도구를 토큰별로 작성하며, 도구나 인자에 대해 얼마나 확신하는지 명시하지 않습니다. 에이전트는 확률이 높을 때 행동하고, 그렇지 않을 때는 단계를 더 큰 모델에 넘기므로, 일상적인 단계는 생성된 답변을 건너뛸 수 있습니다. 우리는 인수 확률을 반환하는 다른 결정 모델을 찾지 못했습니다.
"B-44120 주문이 화면에 금이 간 상태로 도착했습니다. 환불을 원합니다."라는 티켓, 세 가지 도구로, issue_refund (a 이유 enum과 a full_refund 불리언), track_package 그리고 escalate_to_human, 는 (축약, 둥근형) 다음과 같이 돌아옵니다:
{"tool": "issue_refund", "probabilities": {"issue_refund": 0.969, "none": 0.025, "escalate_to_human": 0.005, "track_package": 0.002}, "arguments": {"issue_refund": { "reason": {"value": "damaged", "probabilities": {"damaged": 0.993, "not_as_described": 0.007, "late": 0.001}}, "full_refund": {"value": true, "probability_true": 0.761}}, "open_arguments": {"track_package": ["order_id"]}}
명령 식별자와 같은 자유 텍스트 인자는 아래에 나열되어 있습니다 open_arguments 에이전트가 채워야 할 일이었다.
혼합 입력, 최대 100만 토큰
텍스트, JSON 객체와 배열, 이미지, 비디오, 오디오는 동일한 상태로 어떤 조합으로든 들어갑니다: 계정 기록 옆에 지원 통화 녹음, 청구서 옆에 대시캠 클립, 상품 사진 옆에 매물 등이 있습니다. 상태와 가장 긴 질문은 1,000,000 토큰에 달할 수 있는데, 이는 한 번의 요청으로 긴 계약 묶음, 1년치 티켓 또는 몇 시간 분의 대본을 만들 수 있습니다.
점수
우리는 동일한 항목에 대해 Aplomb 1과 세 개의 오픈 4B 결정 모델을 실행하고, Jev, JevK5, SemIf 등 Intern-Decision이 발표한 숫자를 그 옆에 배치했습니다. 7개의 스위트 묶음 Intern-Decision 보고서에서 Aplomb 1은 평균 88.7%를 기록했습니다. Jev의 공개된 순위에서는 JevBench Hard와 타입 결정에서 앞서고, JevBench Easy에서는 평균이며, JevBench Original, ToolACE, AG News, WildJailbreak에서는 뒤처져 있습니다. 가장 큰 격차는 JevBench Hard에 +5.4점입니다.
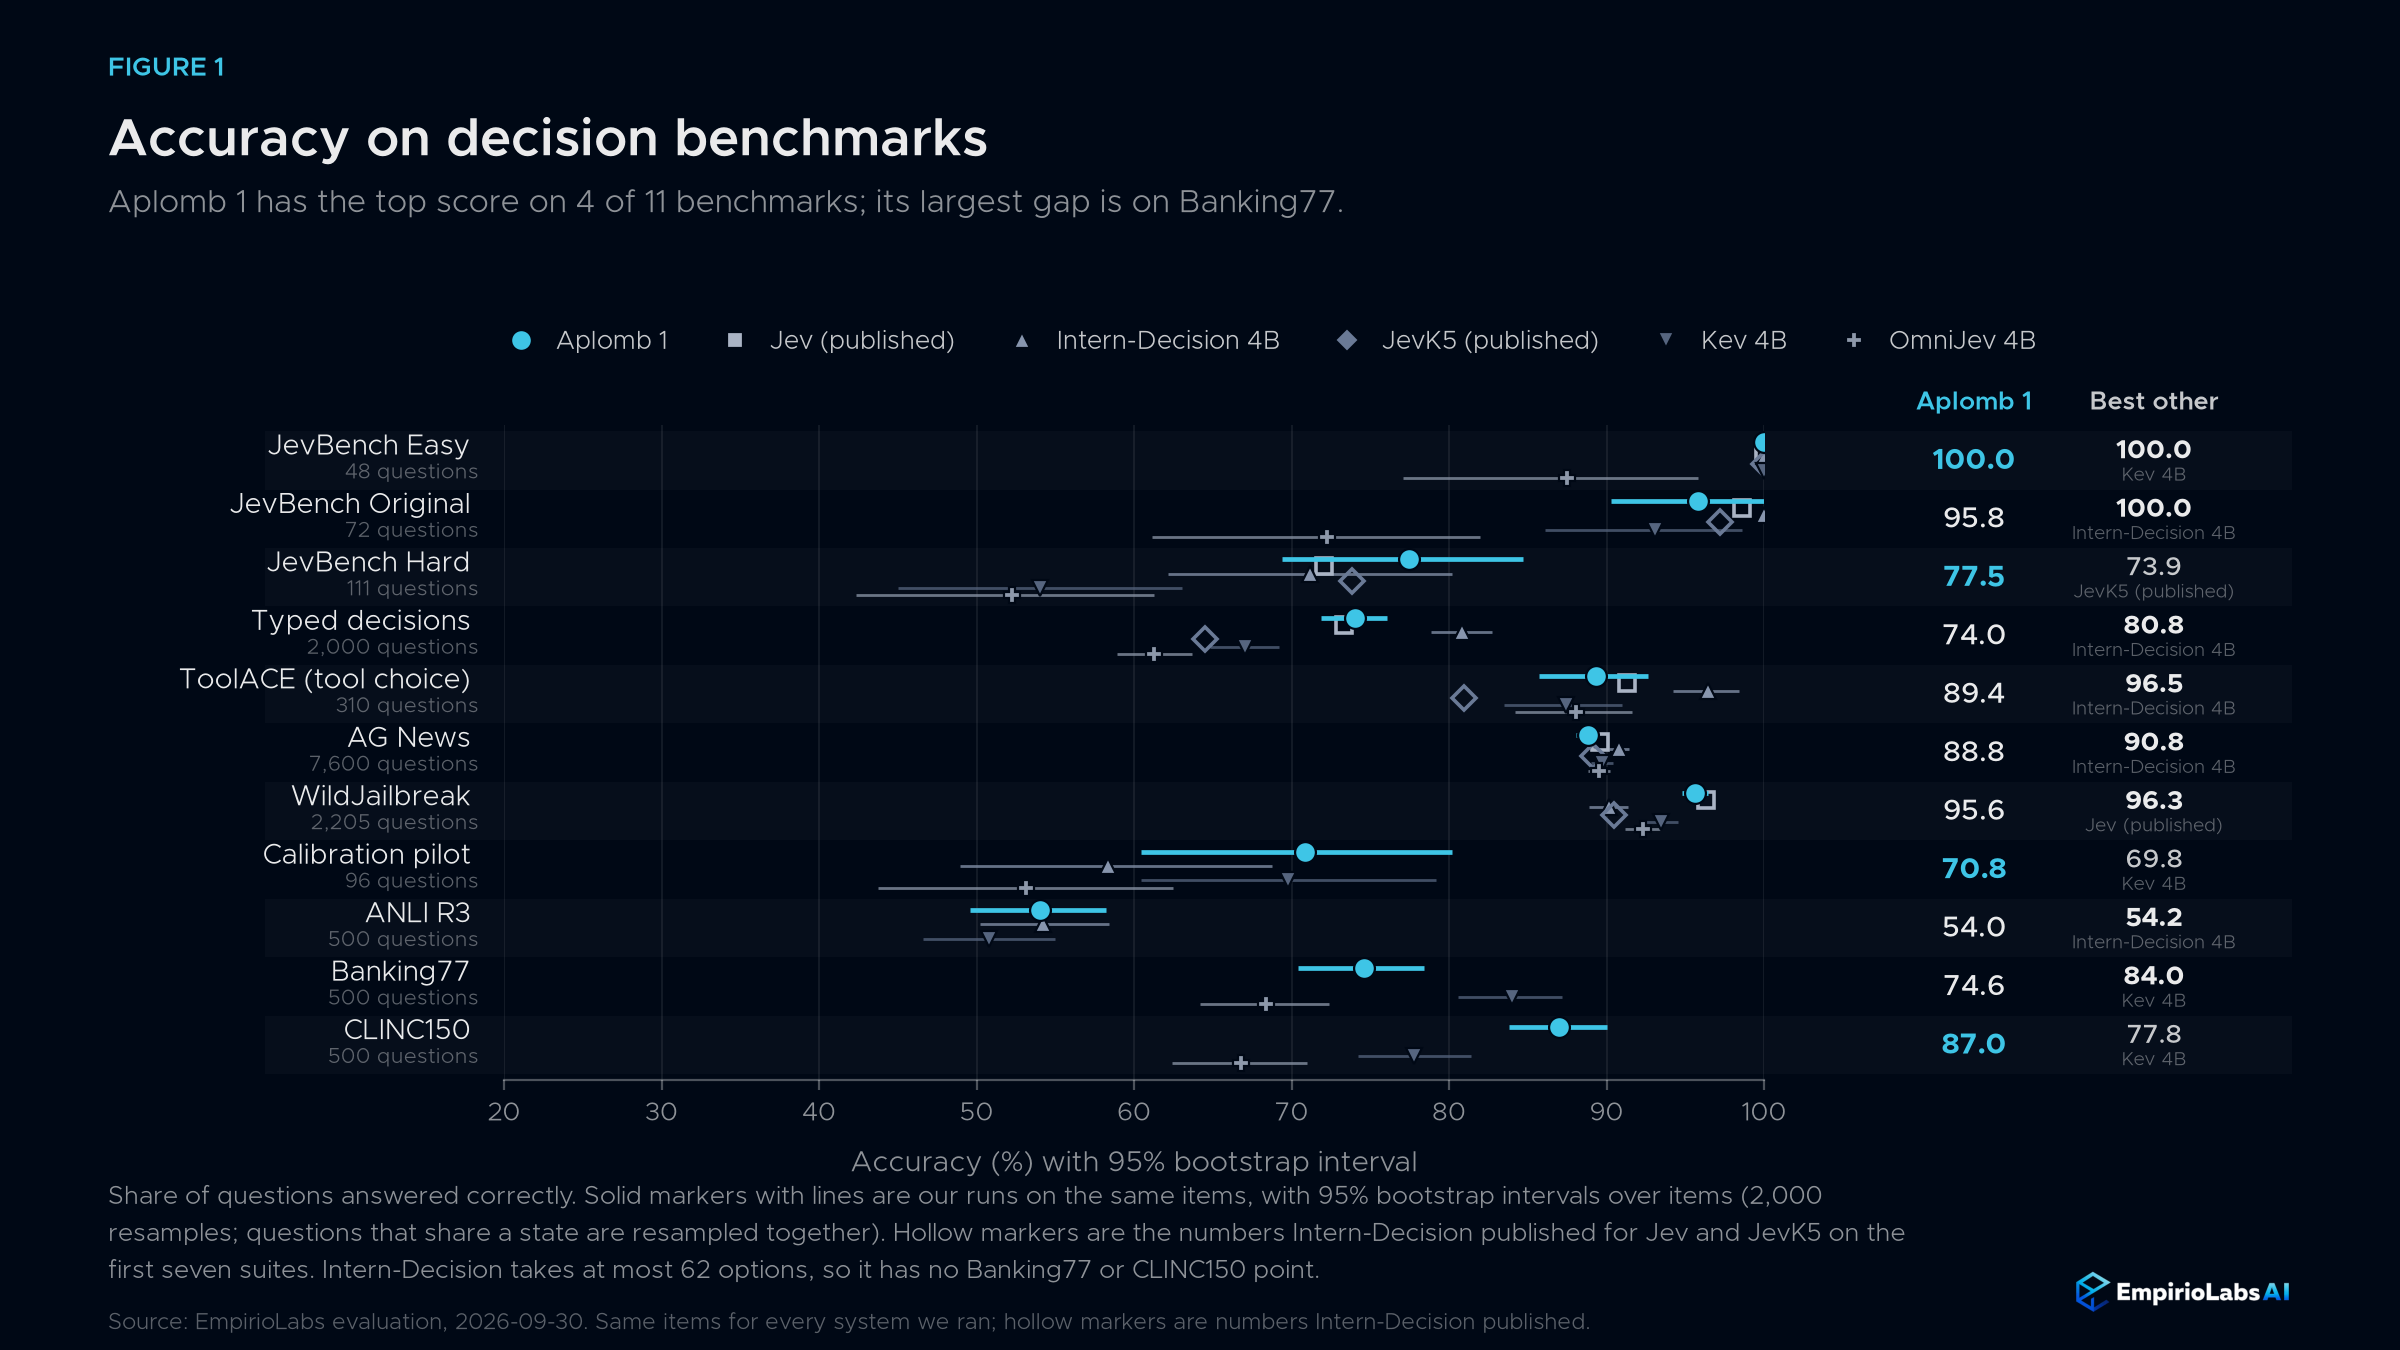
| 벤치마크 | 아플롬 1 | Jev (p) | JevK5 (p) | 세미프 (p) | 인턴-디시전 4B | 케브 4B | 옴니제브 4B |
|---|---|---|---|---|---|---|---|
| 제브벤치 이지 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 87.5 |
| 제브벤치 오리지널 | 95.8 | 98.6 | 97.2 | 98.6 | 100.0 | 93.1 | 72.2 |
| 제브벤치 하드 | 77.5 | 72.1 | 73.9 | 61.3 | 71.2 | 54.1 | 52.3 |
| 타이핑된 결정 | 74.0 | 73.3 | 64.5 | 62.8 | 80.8 | 67.0 | 61.3 |
| 툴ACE | 89.4 | 91.3 | 81.0 | 85.2 | 96.5 | 87.4 | 88.1 |
| AG 뉴스 | 88.8 | 89.6 | 89.1 | 89.2 | 90.8 | 89.7 | 89.6 |
| 와일드제일브레이크 | 95.6 | 96.3 | 90.5 | 92.5 | 90.2 | 93.5 | 92.3 |
| 평균입니다 | 88.7 | 88.7 | 85.2 | 84.2 | 89.9 | 83.5 | 77.6 |
(p) 동일한 항목에 대해 Intern-Decision에서 발표한 결과입니다. Intern-Decision은 이 번들에 대해 4B 모델로 90.02를 보고합니다; 열은 우리의 실행 결과를 보여줍니다.
| 벤치마크 | 아플롬 1 | 인턴-디시전 4B | 케브 4B | 옴니제브 4B |
|---|---|---|---|---|
| 보정 파일럿 | 70.8 | 58.3 | 69.8 | 53.1 |
| ANLI R3 | 54.0 | 54.2 | 50.8 | n/a |
| Banking77 (77가지 옵션) | 74.6 | n/a | 84.0 | 68.4 |
| CLINC150 (150가지 옵션) | 87.0 | n/a | 77.8 | 66.8 |
긴 입력
우리는 16K에서 1M 토큰까지의 주문 원장에서 조회를 측정했으며, 한 주문에 대한 질문은 무작위 깊이에 배치되었습니다.
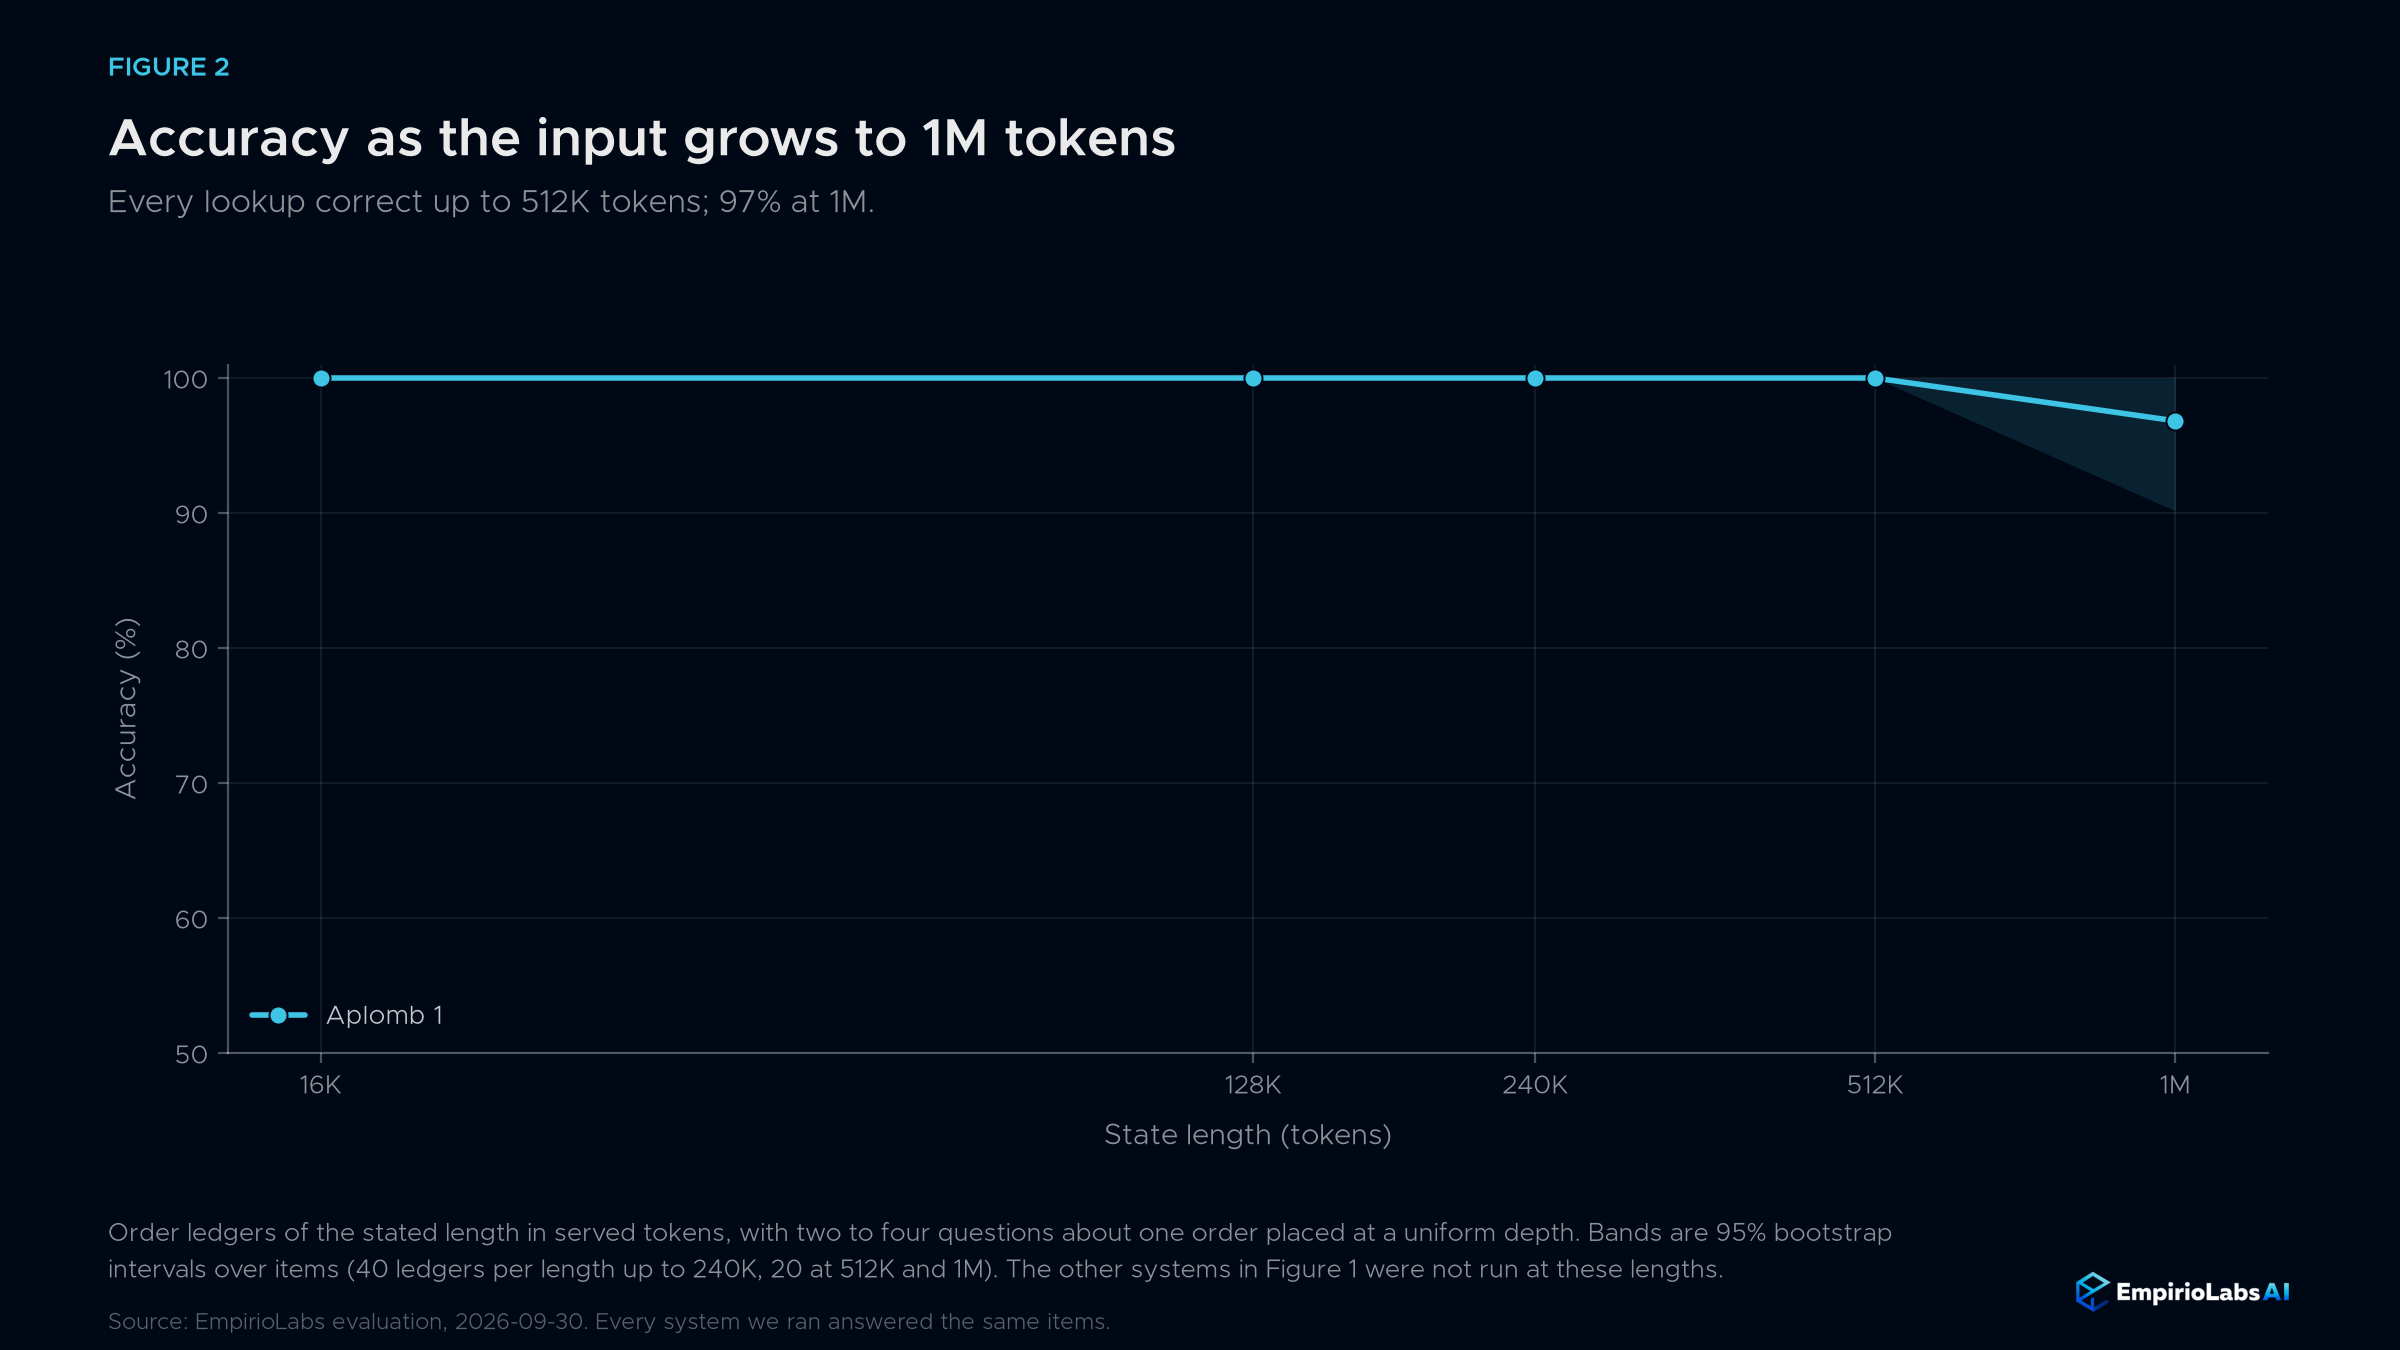
| 입력 길이(토큰) | 16K | 128K | 240K | 512K | 1M |
|---|---|---|---|---|---|
| 아플롬 1 | 100.0 | 100.0 | 100.0 | 100.0 | 96.8 |
몇 초 만에 긴 문서 작성
EmpirioLabs API와 Playground에서는 기본적으로 131,072개 이상의 토큰 상태가 빠른 장기 문맥 모드에서 읽힙니다. 1M 토큰 문서는 전체 읽기 시 약 111초가 아닌 약 3초가 걸리며, 장기 문맥 테스트 세트에서는 빠른 모드가 525개 결정 모두에 정답했으며, 전체 읽기 시 95.2%에 비해 낮았습니다.
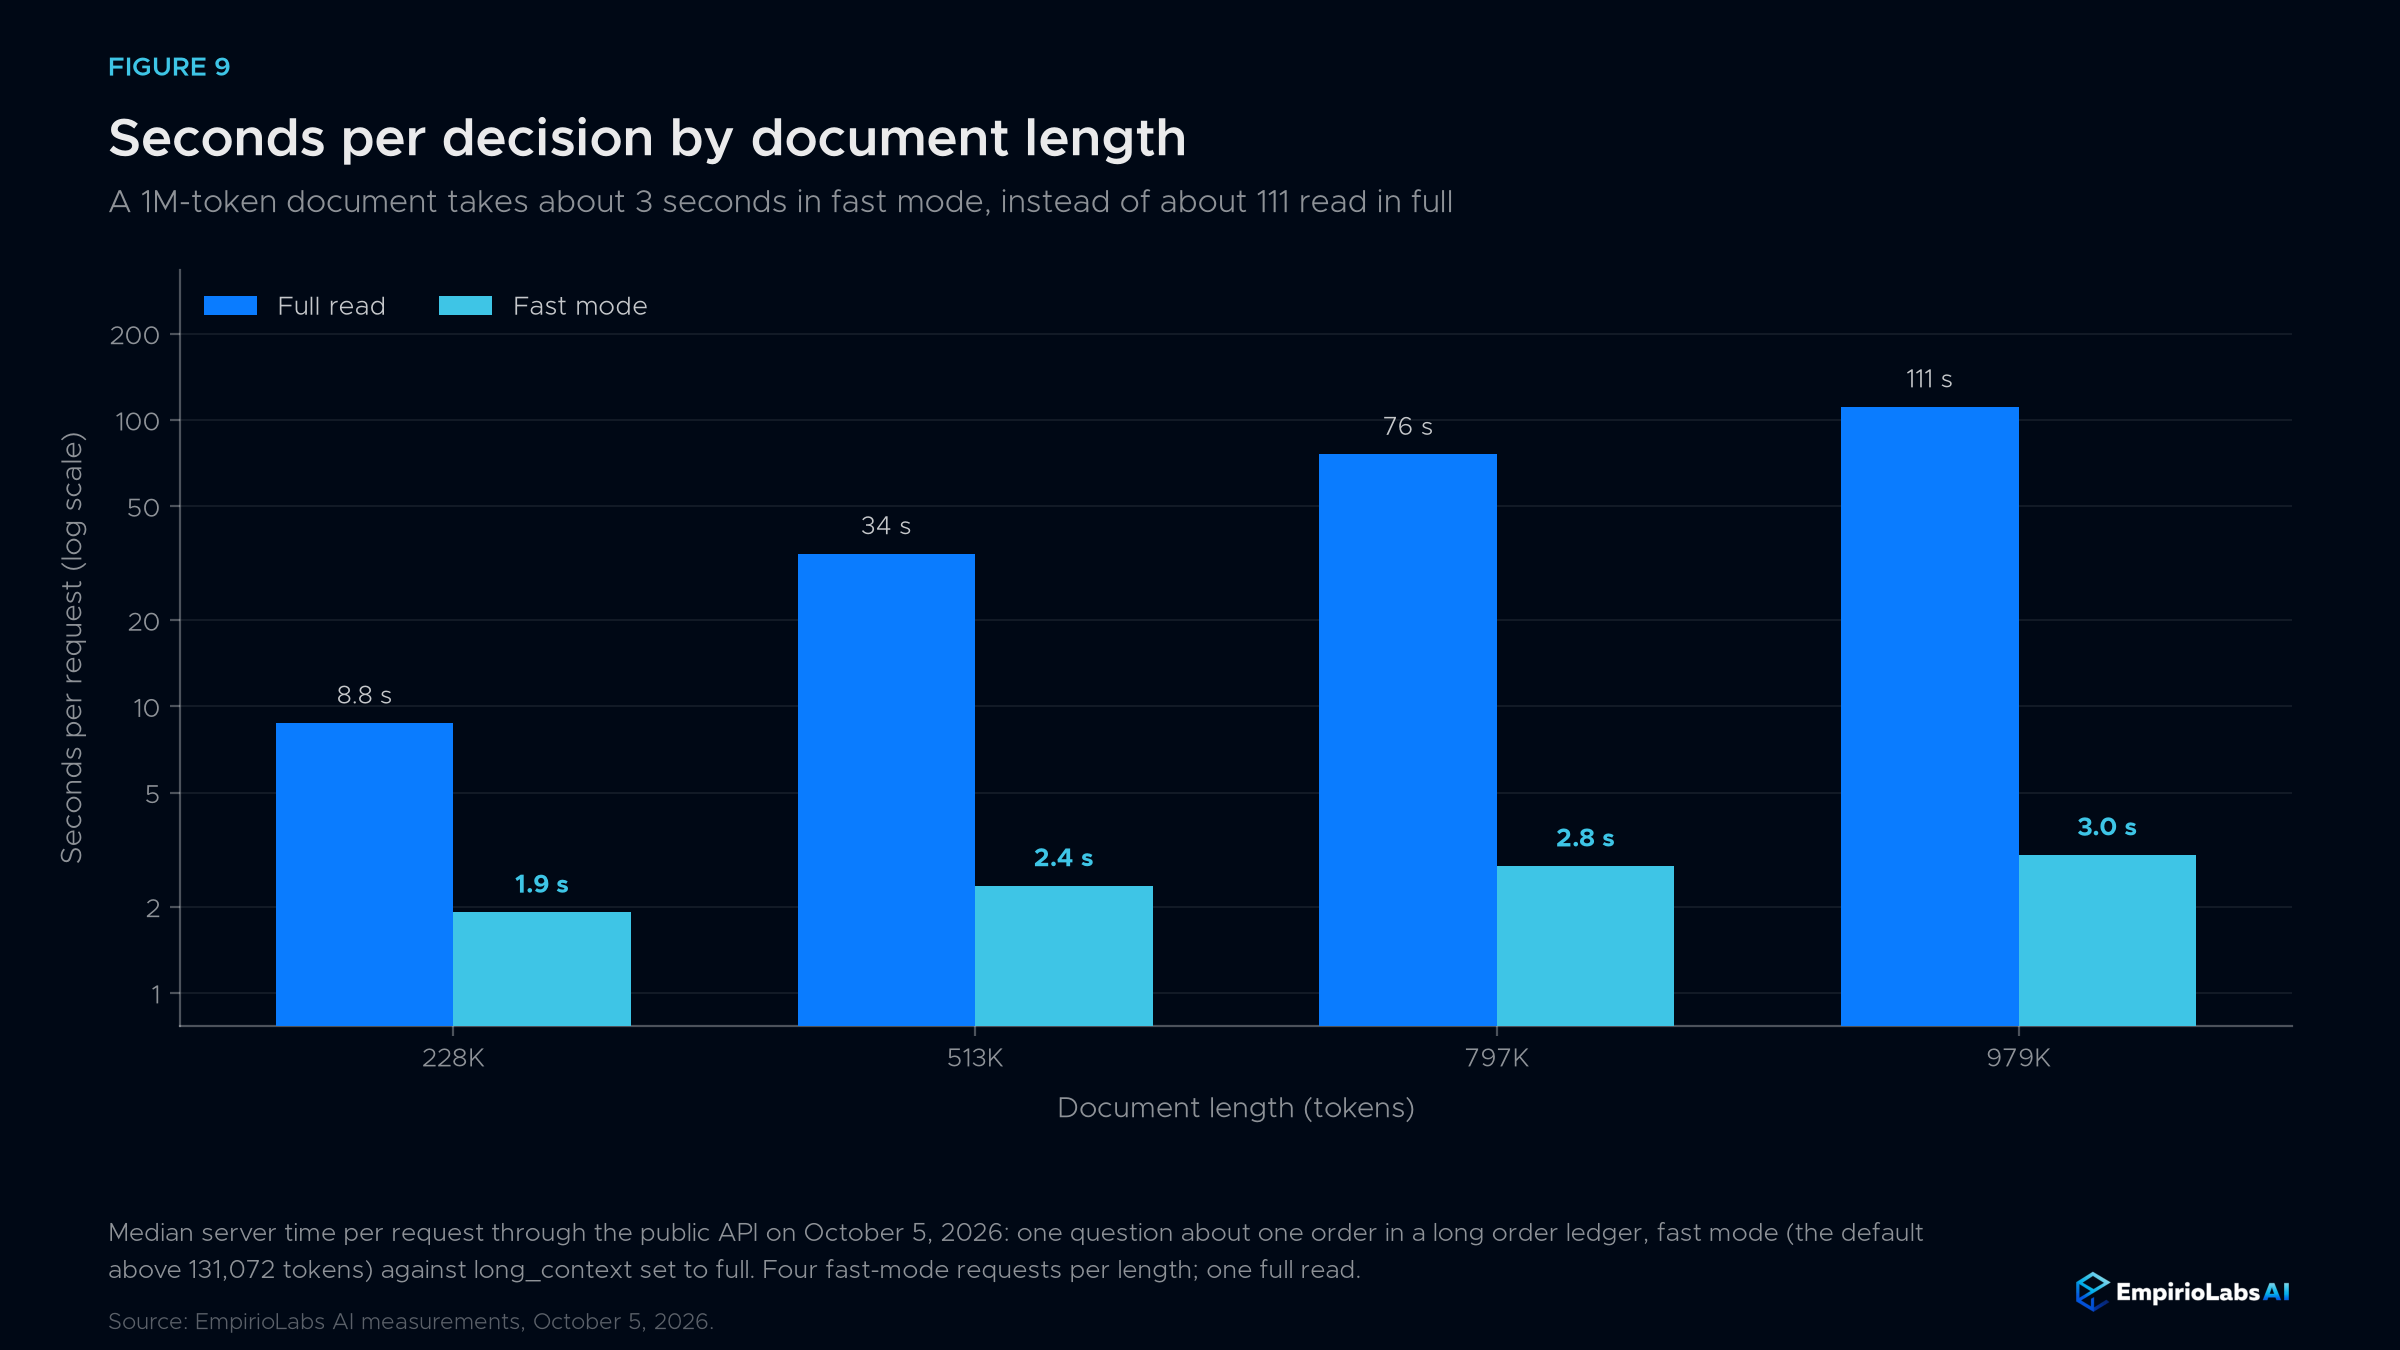
| 문서 길이 (토큰) | 228K | 513K | 797K | 979K |
|---|---|---|---|---|
| 빠른 모드 | 1.9초 | 2.4초 | 2.8초 | 3.0 s |
| 전체 읽기 | 8.8초 | 34초 | 76 s | 111 s |
지원하다 "long_context": "가득 찼다" 모든 토큰을 읽는 것. 전체 문서에 의존하는 답변, 예를 들어 개수, 전체 톤, 또는 어떤 것이 나타나지 않는지 확인하는 경우에는 전체 읽기가 더 나은 선택입니다: 이 질문들을 테스트하기 위해 만들어진 24개의 문서에서 빠른 모드는 50%의 결정에 맞았고, 전체 읽기는 61%에 맞았습니다. 응답 long_context 필드는 어떤 모드가 사용되었는지를 나타내며, 사용량은 두 모드 모두에서 전체 상태를 계산합니다. 빠른 롱컨텍스트 모드는 EmpirioLabs API와 Playground에서만 제공됩니다; 오픈 가중치는 모든 토큰을 읽습니다.
보정
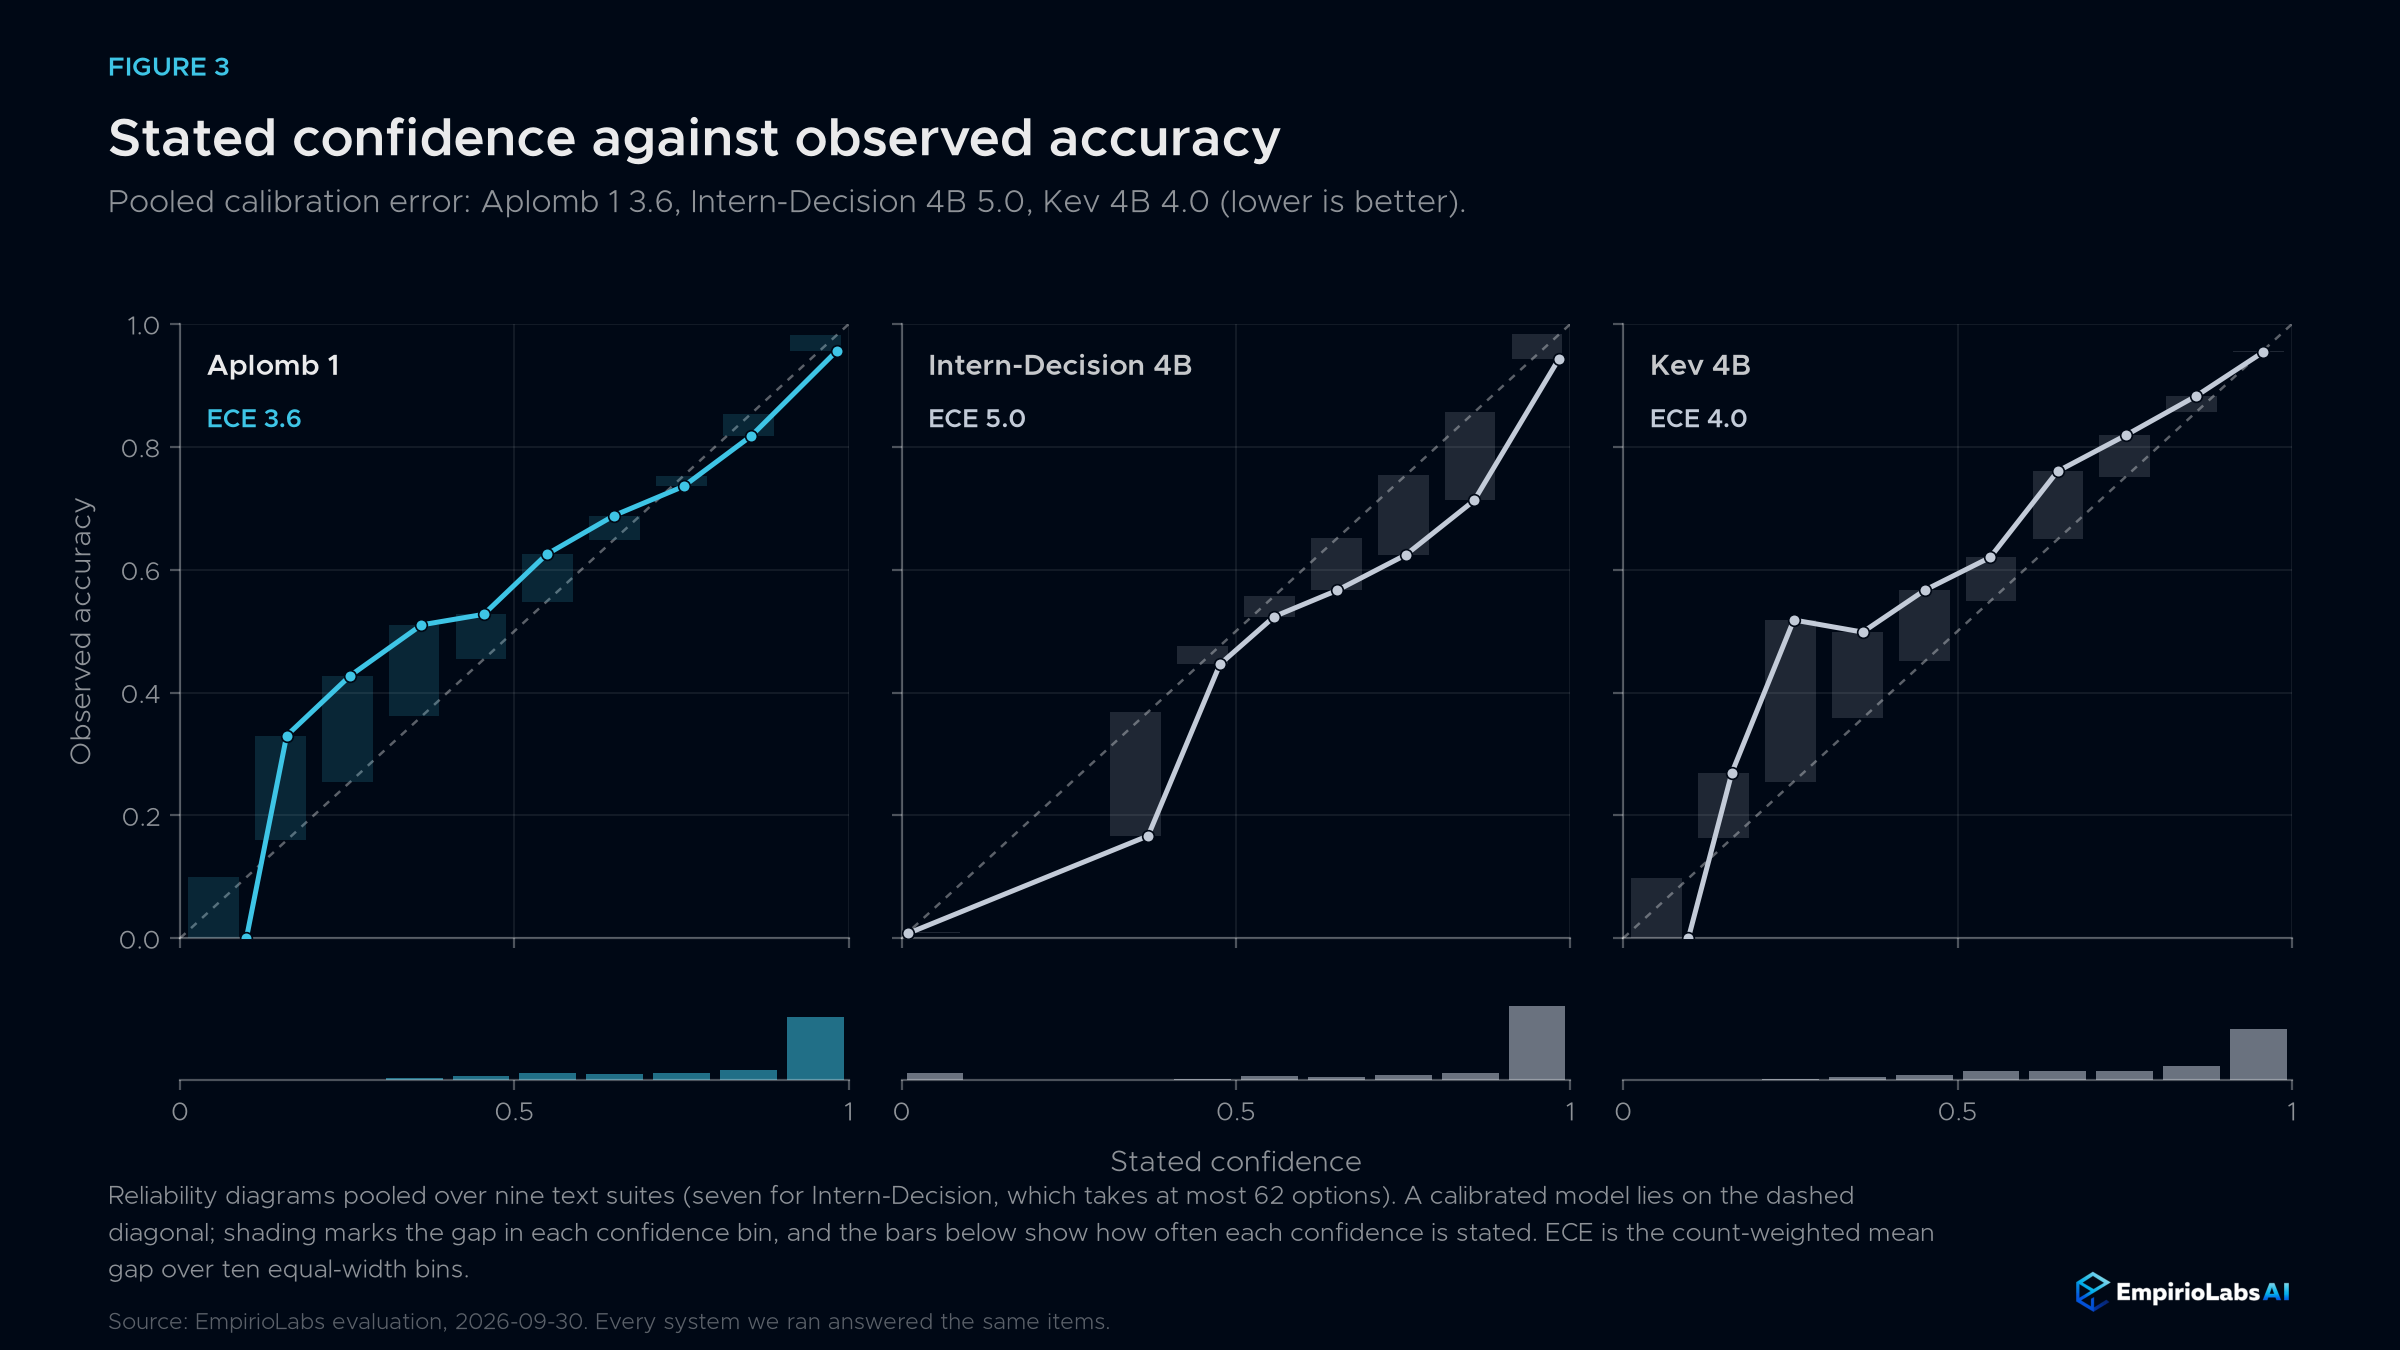
확률은 그것이 말하는 바를 의미할 때만 유용합니다. 9개의 텍스트 모음에 걸친 Aplomb 1의 명시된 신뢰도는 맞았던 빈도를 추적합니다: 통합 보정 오차는 3.6인 반면, Intern-Decision 4B는 5.0, Kev 4B는 4.0(낮을수록 좋습니다).
이미지, 비디오 및 오디오
| 벤치마크 (처음 500개 품목) | 아플롬 1 | 인턴-디시전 4B | 옴니제브 4B |
|---|---|---|---|
| 교황 | 89.0 | 89.2 | 88.4 |
| MMStar | 68.6 | 65.2 | 64.4 |
| AI2D | 87.0 | 81.0 | 83.4 |
| 음 | 57.2 | 57.0 | 56.0 |
| 홀루전벤치 | 79.8 | 79.4 | 71.2 |
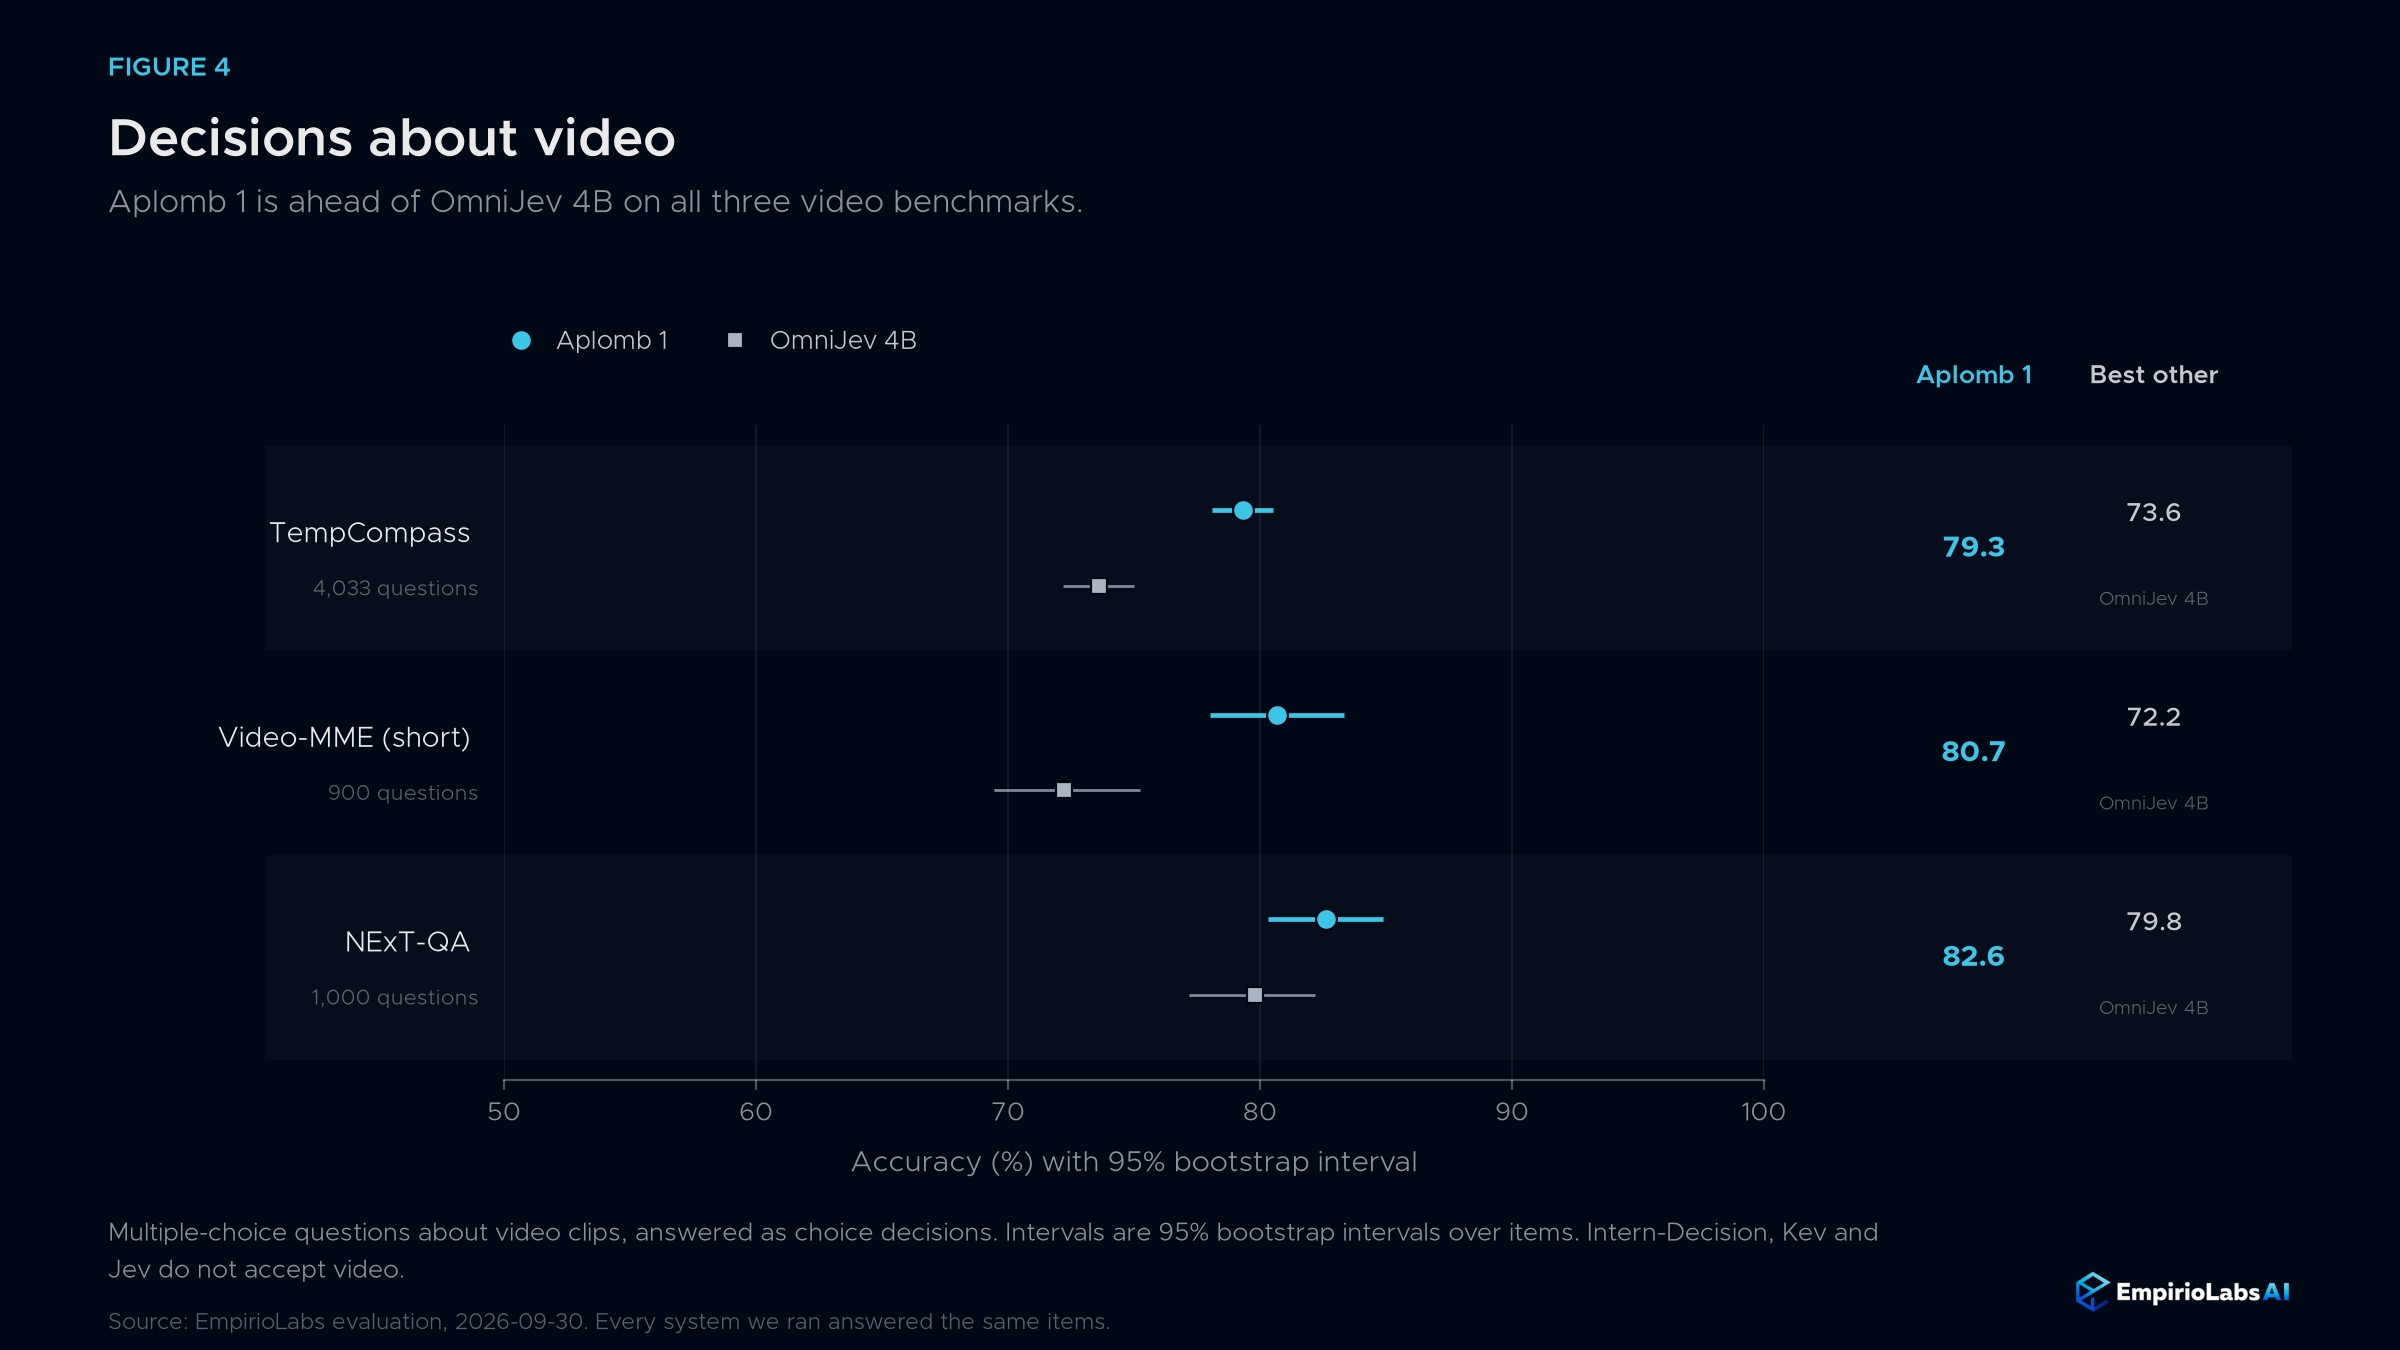
| 벤치마크 | 아플롬 1 | 옴니제브 4B |
|---|---|---|
| 템플로이스 | 79.3 | 73.6 |
| 비디오-MME (단축) | 80.7 | 72.2 |
| NExT-QA | 82.6 | 79.8 |
저희가 직접 Aplomb 1에 오디오를 추가했습니다; 위의 다른 결정 모델들은 이를 받아들이지 않습니다. 이 모델은 음성 및 음성 소리에 가장 강하며; 환경음과 오디오에 관한 개방형 질문은 더 어렵습니다:
| 벤치마크 | 아플롬 1 |
|---|---|
| 보컬사운드 (보컬 사운드) | 90.0 |
| CREMA-D (말 속 감정) | 65.0 |
| ESC-50 (환경음) | 8.4 |
| MMAU (오디오 질문) | 49.1 |
| MMSU (구어) | 43.3 |
51개 언어
Aplomb 1은 영어뿐만 아니라 여러 언어의 텍스트를 결정합니다. MASSIVE에서는 음성 비서에게 보내는 각 요청이 51개 언어 중 하나로 작성되지만, 질문과 59개의 의도 라벨은 영어로 유지됩니다. MASSIVE에 대한 교육 없이 Aplomb 1은 59가지 의도 중 51개 언어 모두에서 평균 75.0%, 영어 91.0%, 39개 언어에서 70% 이상을 기록합니다.
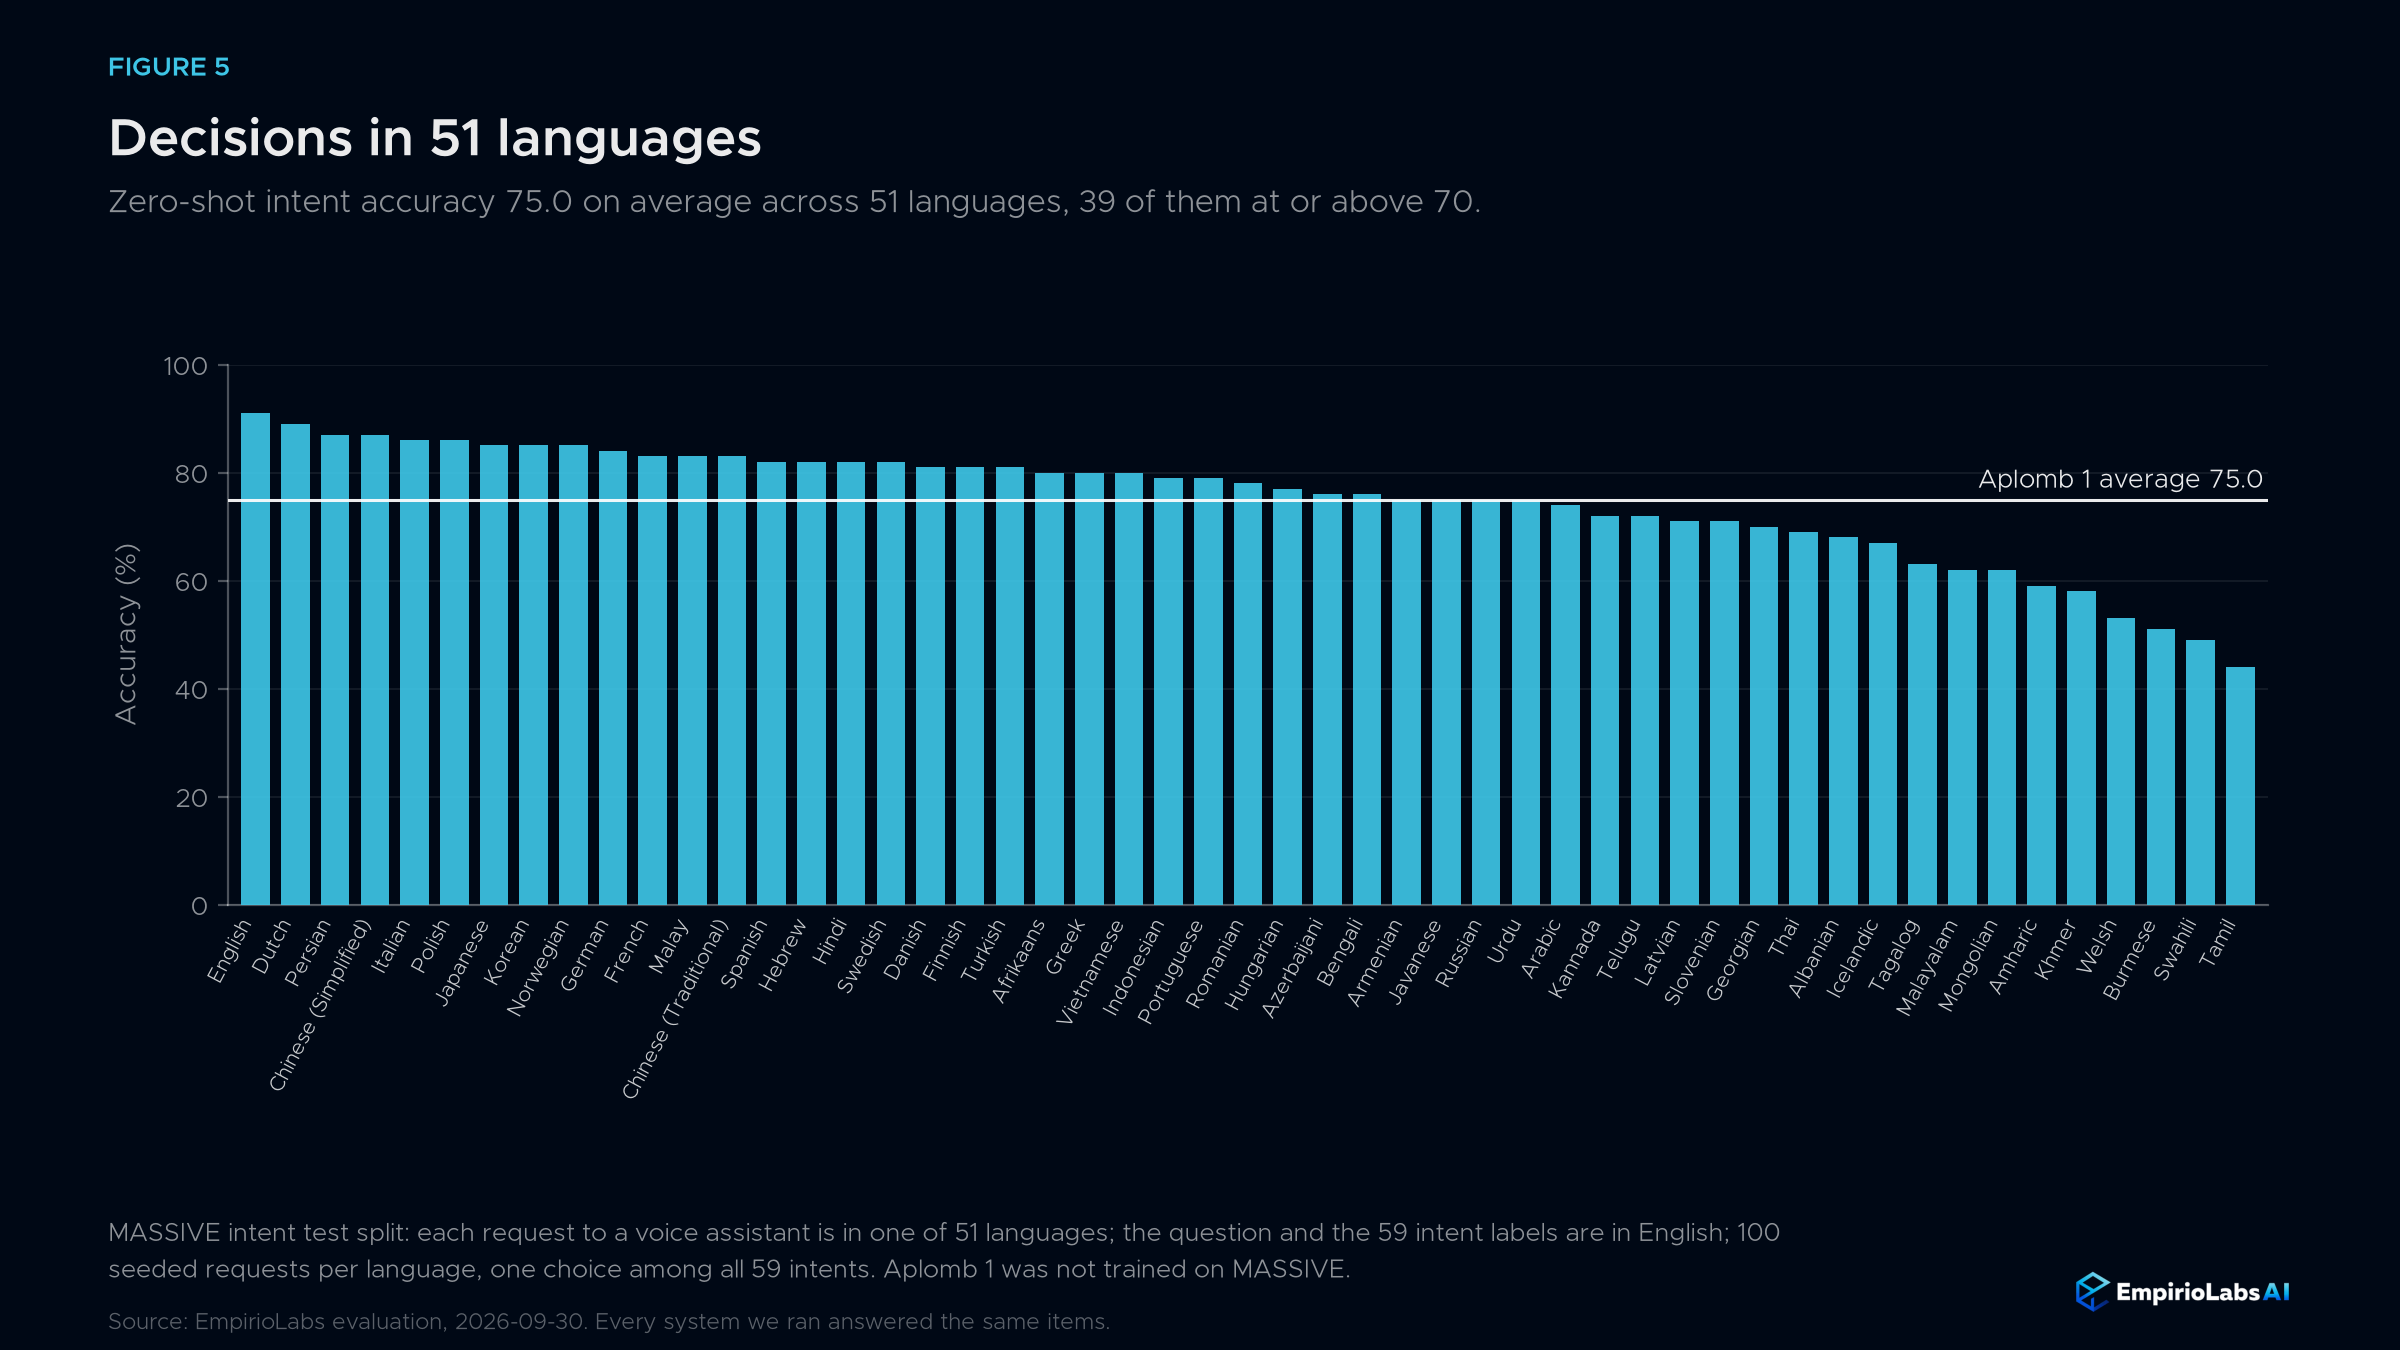
참고로, Laya 프로젝트는 동일한 51개 언어에서 20가지 의도 중 선택할 때 다국어 모델이 40.1%를 보고했고, JevK5 프로젝트는 영어에서 60가지 모든 의도를 적용할 때 73.8%를 보고했습니다.
결정 지수
의사결정 지수 0.2.1은 지식과 추론, 언어 이해, 검색 및 분류, 도구와 자동화, 예술과 인간 취향 등 다섯 영역에서 38개의 공개 벤치마크를 평균화합니다. 각 벤치마크는 우연 보정을 거쳐 0은 무작위 추측, 100은 완벽함을 의미합니다.
2026년 10월 5일 Aplomb 1에서 공식 키트를 실행했고, 150,317건의 점수 요청에 모두 응답했습니다. Aplomb 1은 44.86점을 받았습니다. 이것은 저희가 직접 키트를 사용한 것이지, 게시판에 올라온 항목이 아닙니다.
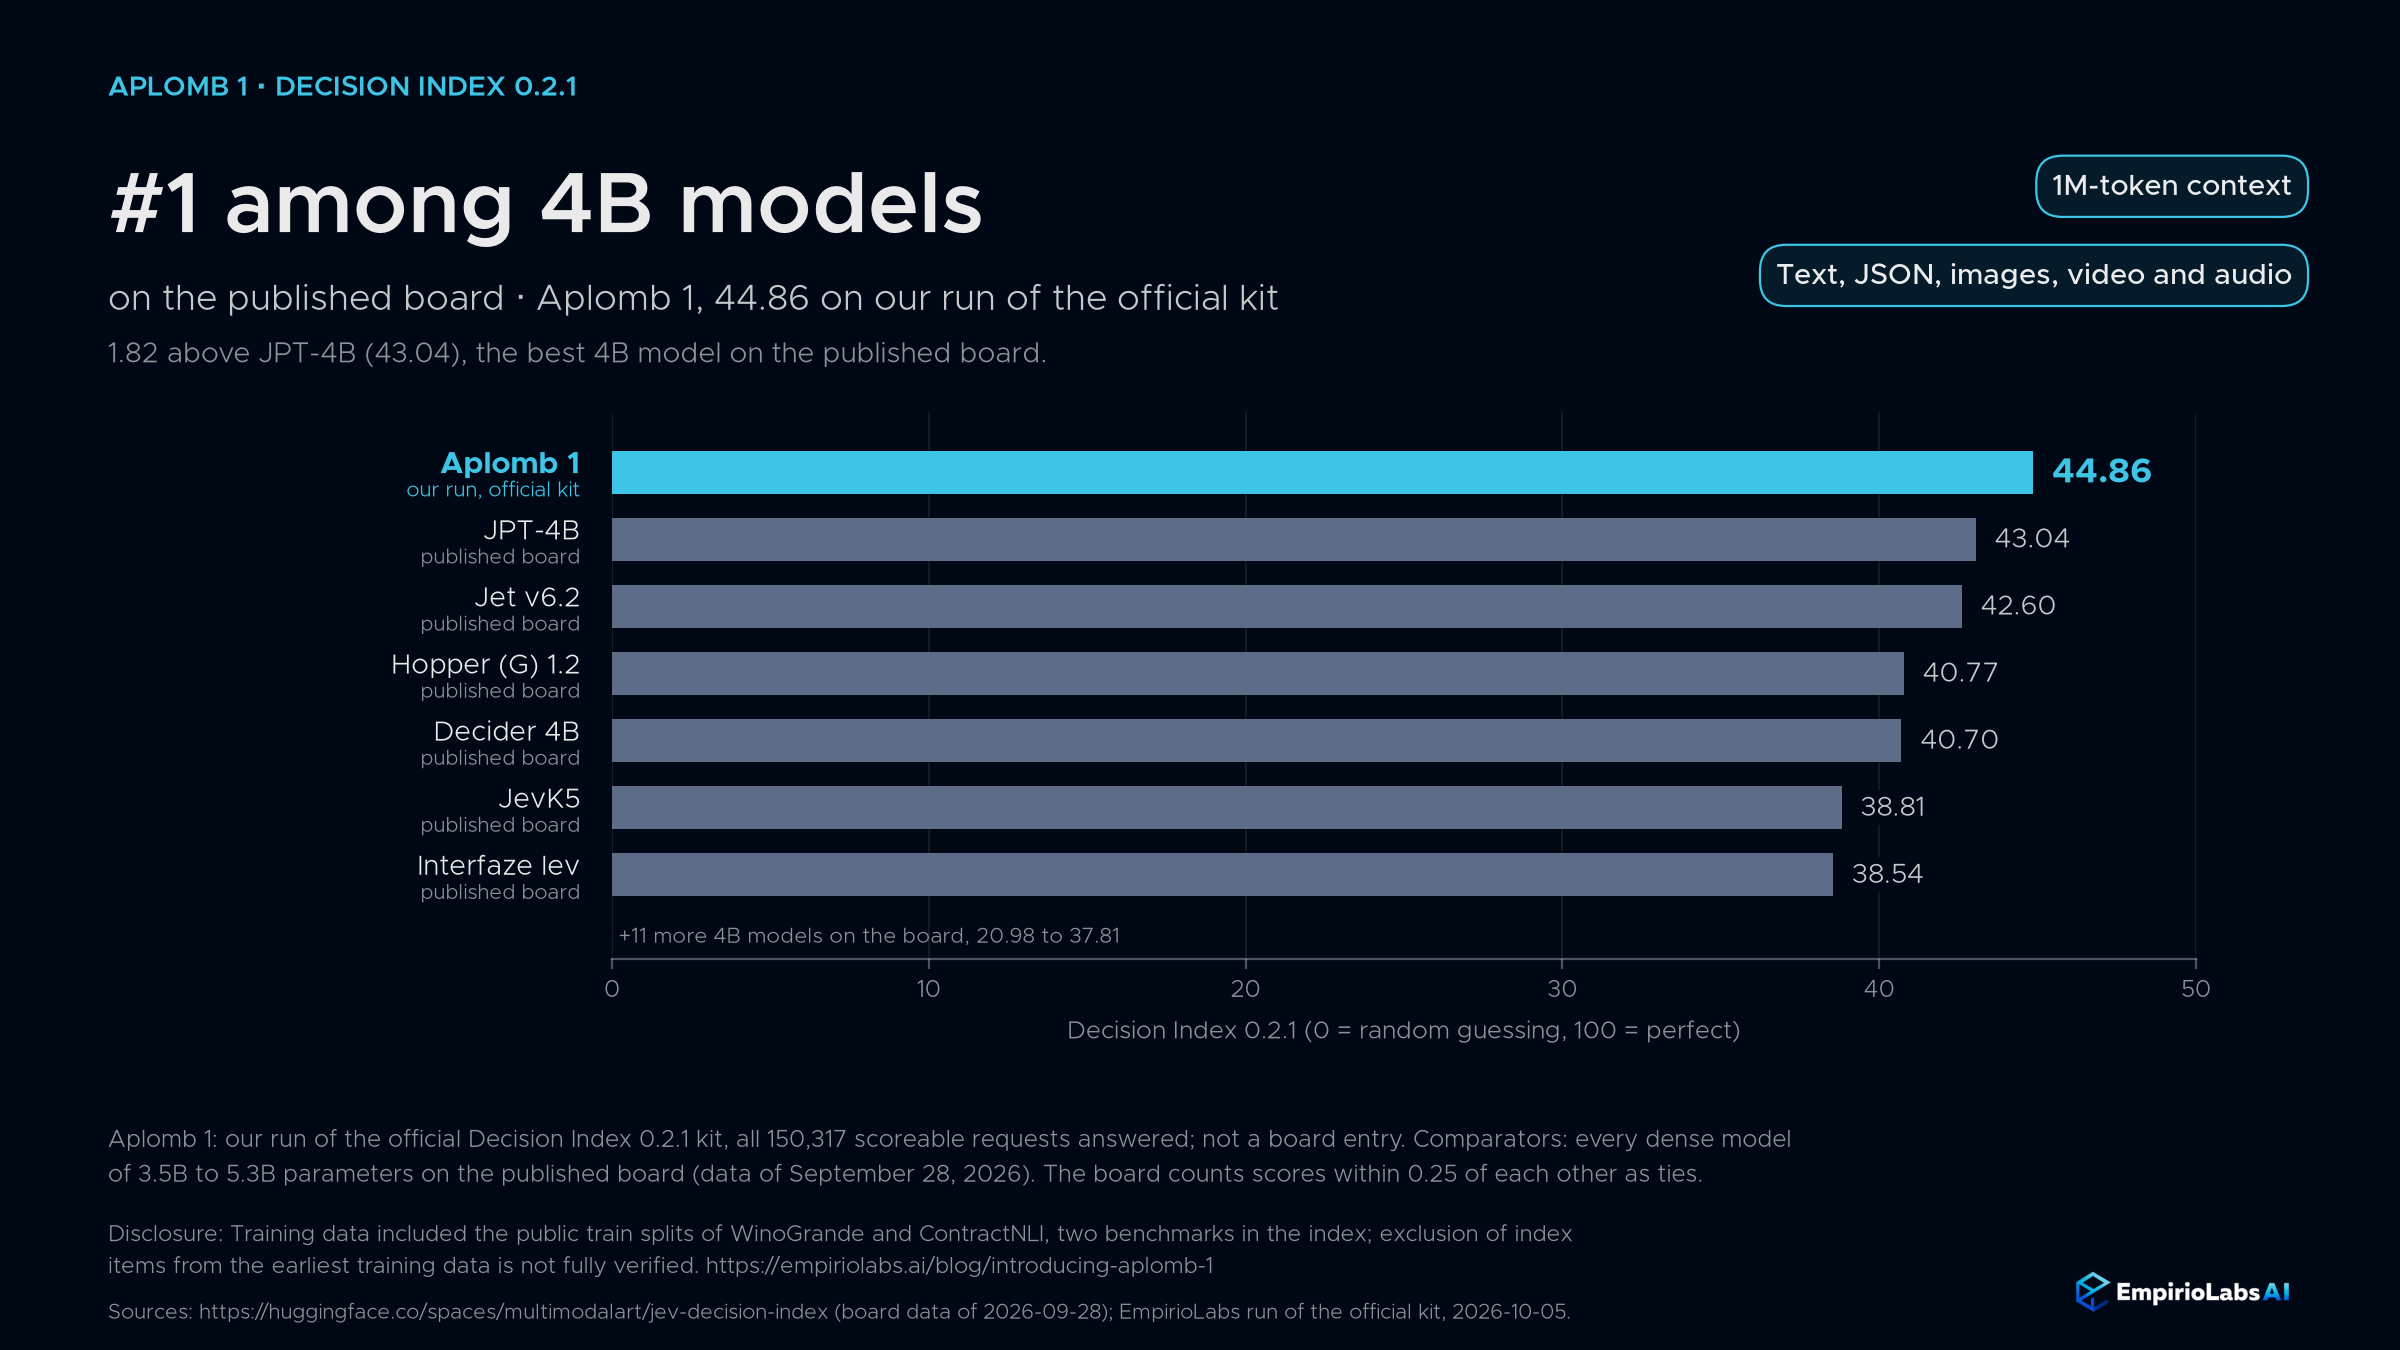
2026년 10월 6일 기준으로 Aplomb 1은 공개된 보드 내 4B 모델 중 #1위이며, MMLU-Pro, GPQA Diamond, BBH를 포함한 38개 벤치마크 중 8개 모델에서 53억 파라미터 이하 모델 중 #1위입니다. 2026년 9월 28일 기준 게시판에서 4B 모델 최고 점수는 JPT-4B의 43.04로, Aplomb 1보다 1.82 낮은 점수입니다.
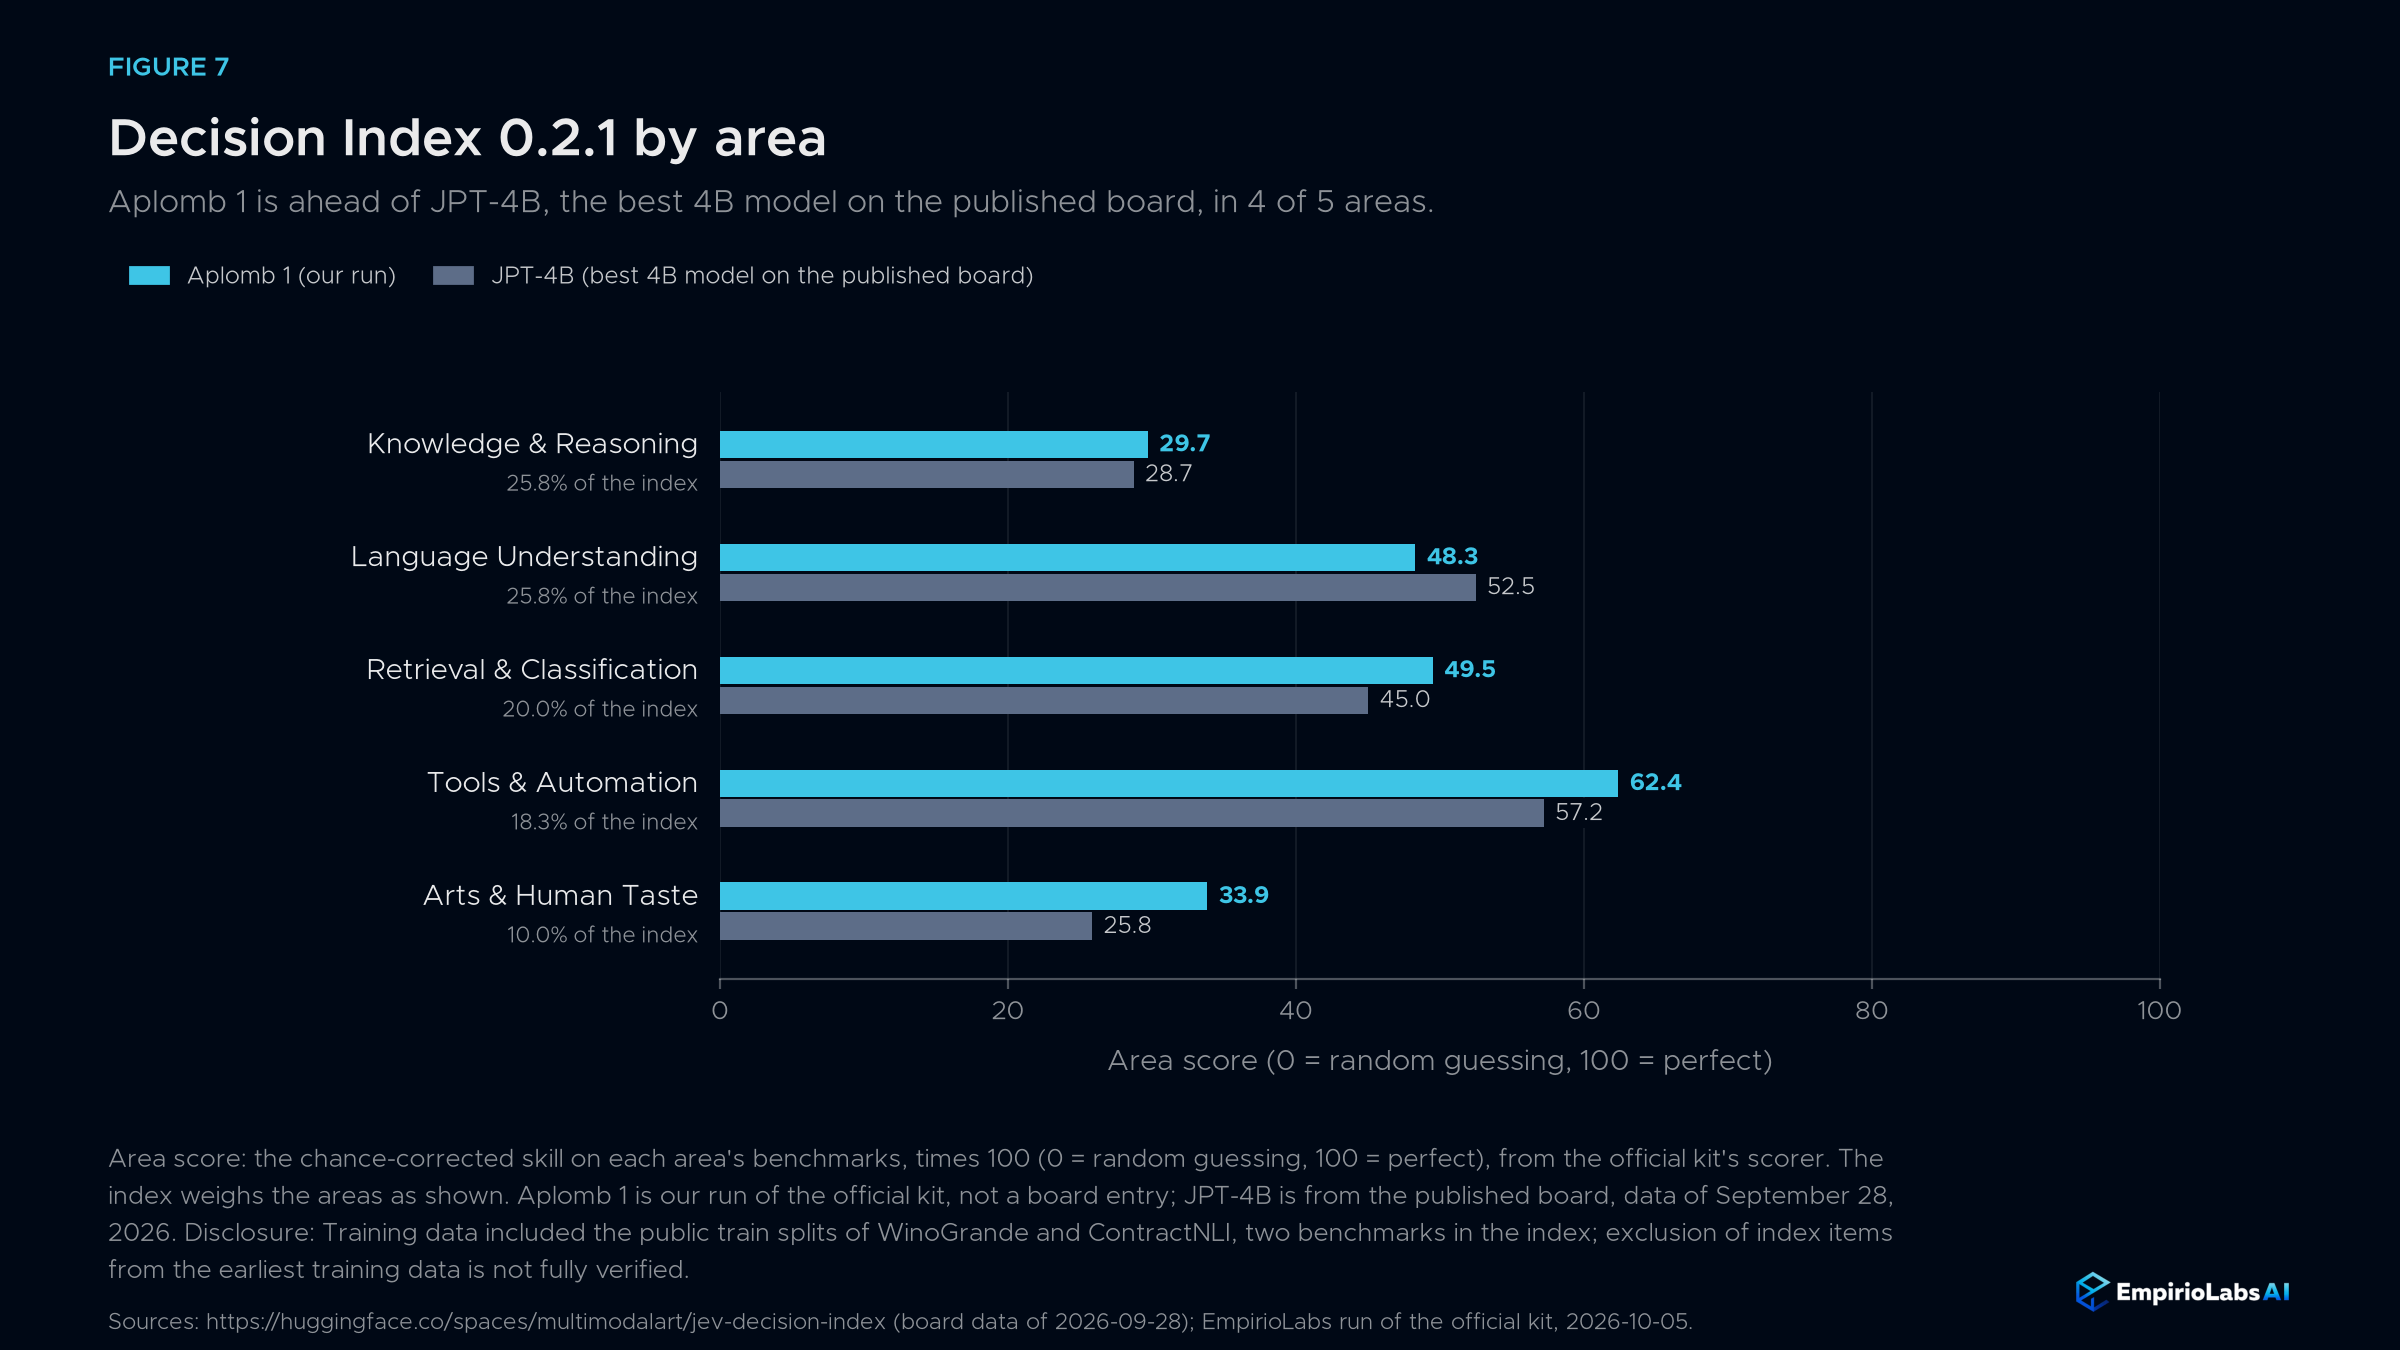
분야별로 Aplomb 1은 도구 및 자동화(62.4점)와 검색 및 분류(49.5점)에서 가장 높은 점수를 받았습니다. JPT-4B와 비교했을 때, 5개 영역 중 4개에서 앞서 있고 언어 이해에서는 뒤처져 있습니다(48.3점, 52.5점).
공개. Aplomb 1의 훈련 데이터에는 지수 내 38개 벤치마크 중 두 곳인 WinoGrande와 ContractNLI의 공개 열차 분할 데이터가 포함되어 있었습니다. 우리는 인덱스 항목이 가장 초기 학습 데이터에서 제외되었는지 완전히 검증하지 못했습니다.
비교
각 의사결정 모델 또는 API가 2026년 9월 29일 기준 자체 문서와 2026년 10월 6일 기준 가격에 따르면, 어떤 것을 수용하고 답변하는지:
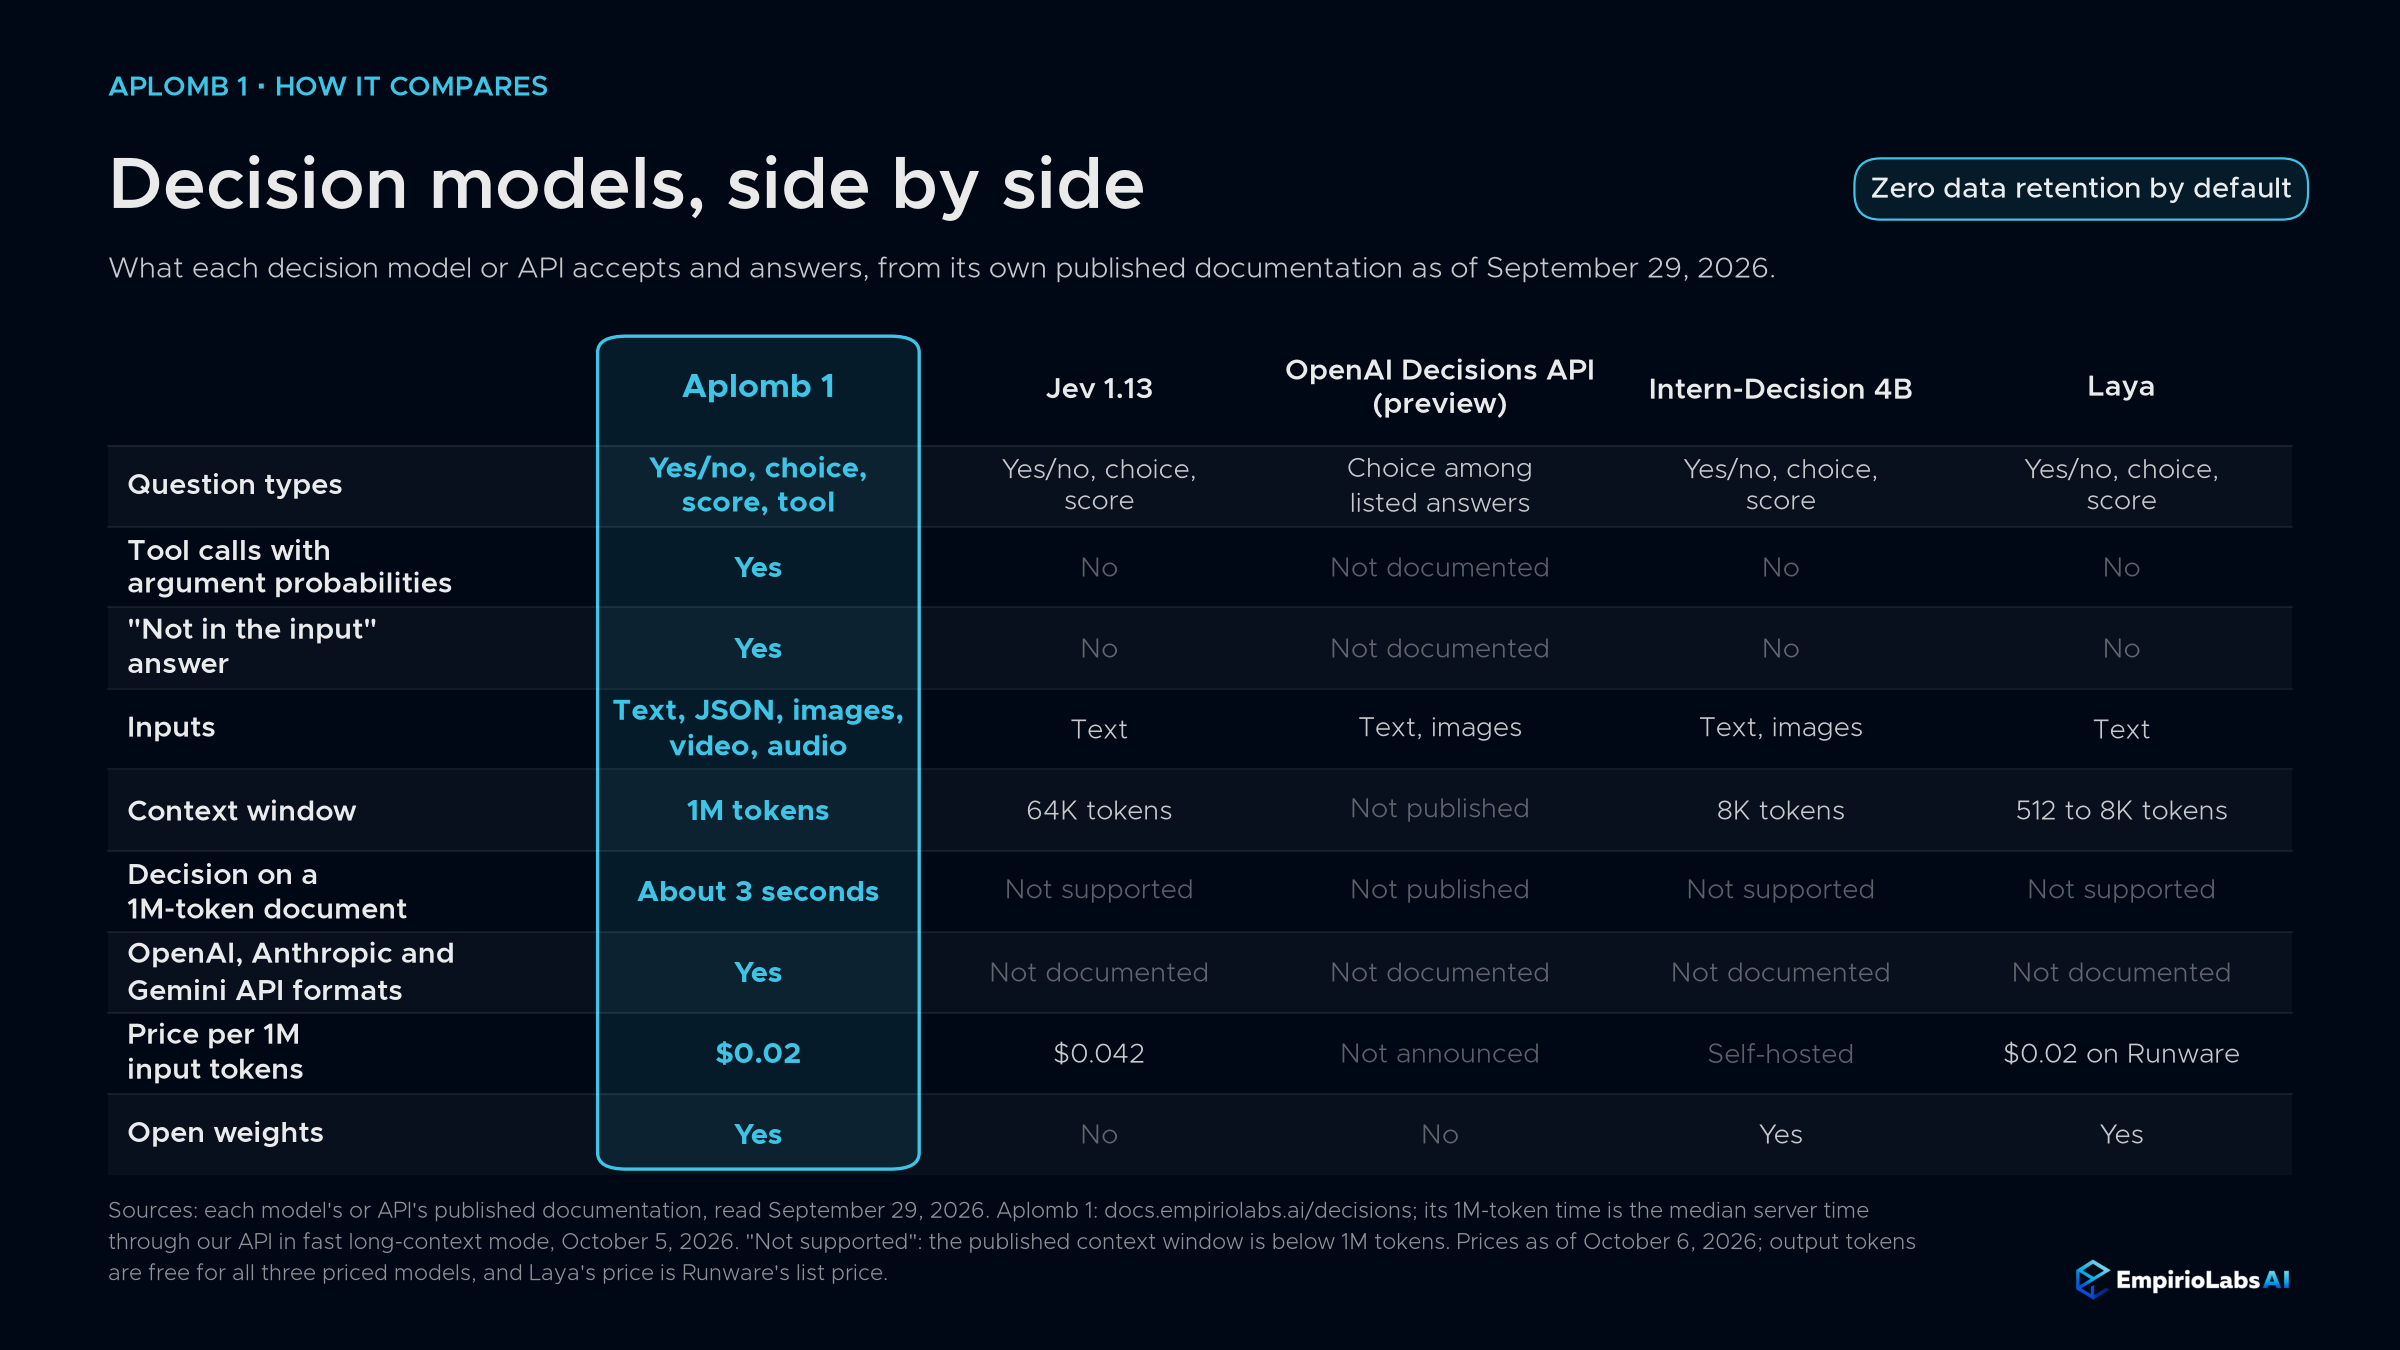
| 아플롬 1 | 제브 1.13 | OpenAI 의사결정 API (미리보기) | 인턴-디시전 4B | 라야 | |
|---|---|---|---|---|---|
| 문제 유형 | 예 아니오, 선택, 점수, 도구 | 예 아니오, 선택, 점수 | 나열된 답변 중 선택 | 예 아니오, 선택, 점수 | 예 아니오, 선택, 점수 |
| 인수 확률을 이용한 도구 선택 | 네 | 아니 | 문서화되지 않았습니다 | 아니 | 아니 |
| 주 정부 답변에는 그렇지 않습니다 | 네 | 아니 | 문서화되지 않았습니다 | 아니 | 아니 |
| 입력 | 텍스트, JSON, 이미지, 비디오, 오디오 | 본문 | 텍스트, 이미지 | 텍스트, 이미지 | 본문 |
| 창문 | 1,000,000 토큰 | 64K 토큰 | 출판되지 않음 | 8,192 토큰 | 512에서 8,192 토큰 |
| 100만 입력 토큰당 가격 | $0.02 | $0.042 | 발표되지 않았습니다 | 자체 호스팅 | 런웨어 $0.02 |
| 오픈 웨이트 | 네 | 아니 | 아니 | 네 | 네 |
속도 및 청구
Aplomb 1은 의사결정 모델에 대해 EmpirioLabs 자체 추론 런타임에서 실행됩니다. 짧은 질문은 약 15ms의 모델 시간이 소요되며, 이미지가 포함된 질문은 약 35ms, 15,000 토큰 문서는 약 0.3초, 1M 토큰 상태는 빠른 장기 컨텍스트 모드에서 약 3초 걸립니다. 기본값은 131,072 토큰 이상, 즉 전체 읽기 시 약 111초입니다.
입력 토큰에 대해서만 비용을 지불합니다: 요청당 상태 1회와 각 질문의 텍스트 자체에 대해 지불하며, 프롬프트 템플릿은 절대 지불하지 않습니다. 출력 토큰은 항상 0입니다. 현재 속도는 모델 페이지 그리고 가격표·.
기본적으로 데이터 보존 제로가 켜져 있습니다: 요청이나 응답의 내용은 저희가 보관하지 않습니다.
오픈 웨이트
Aplomb 1은 Qwen3.5-4B 기반으로 구축되었습니다. 우리는 창을 262K에서 1M 토큰으로 확장했고, Qwen3-Omni의 오디오 인코더로 오디오 입력을 추가했으며, 생성된 텍스트가 아닌 보정된 확률로 모든 답변을 반환하는 자체 의사결정 헤드를 추가했고, 도구 선택과 not-in-the-input 답변을 포함한 의사결정 모델을 학습시켰습니다. API와 Playground에 대해서는 자체 추론 런타임을 구축하고 최적화했습니다.
무게와 직접 실행할 수 있는 참조 스크립트는 다음과 같습니다 huggingface.co/empiriolabsai/aplomb-1. 스크립트의 답변은 API와 약간 다를 수 있습니다.
연간 매출이 US$1백만 달러 미만인 조직의 연구, 평가, 개인 사용 및 내부 사용은 EmpirioLabs 모델 라이선스 하에서 무료이며; Aplomb 1을 서비스로 호스팅하거나 타인에게 판매된 제품으로 배송하려면 상업용 라이선스가 필요합니다.
시작하기
curl https://api.empiriolabs.ai/v1/decisions \ -H "승인: 소지자 $EMPIRIOLABS_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "aplomb-1", "state": {"order": {"id": "B-44120", "status": "배송", "payment": "unpaid"}}, "questions": { "payed": {"type": "noul", "instructions": "주문 B-44120이 결제되었습니까?", "abstain": true}, "carrier": {"type": "choice", "instructions": "어느 운송업체가 B-44120 주문을 전달하나요?", "criteria": {"ups": null, "fedex": null, "dhl": null}, "abstain": true} } }'유료 확신에 찬 거절로 돌아옵니다. 캐리어 기분 좋게 돌아오면 자기 확률은 기록에 캐리어 이름이 명시되어 있지 않기 때문입니다. 전체 스키마, 미디어 입력 및 한계는 Decisions API 가이드. Aplomb 1은 OpenAI, Anthropic, Gemini 형식으로도 요청을 받아, 그들의 SDK에서 호출할 수 있습니다; 가이드의 채팅 형식 이 섹션은 채팅 요청이 결정에 어떻게 연결되는지 보여줍니다. 코드 없이 시도해 보세요. 팟캐스트·.
감사의 말
우리는 데이터, 교육, 평가, 배포 전반에 걸쳐 AI 에이전트 하네스의 도움을 받아 Aplomb 1을 구축했습니다. Aplomb 1이 기반으로 한 Qwen3.5와 Qwen3-Omni를 위한 Qwen 팀, 우리가 훈련하고 제공한 GPU에 대해 제공한 Lambda, 그리고 NVIDIA Inception 프로그램, Z.ai 스타트업 프로그램, StepFun 스타트업 프로그램의 지원에 감사드립니다.