LightOnOCR-3 4BはEmpirioLabsで利用可能です。 これはLightOnの文書OCRモデルで、PDFや画像を送信すると、各ページをMarkdownで返します。テキストは読書順、見出し、リスト、表、LaTeXの数学、そしてデータポイントの表としてチャートが入ります。各ページにはレイアウトも返ってきます:ページ上の各ブロックのタイプと位置。動作は続きます ポスト/v1/ocr、APIおよびPlaygroundで。
ベンチマーク。 LightOnは、LightOnOCR-3 4BのolmOCR-Bench総合スコアを86.3と報告しています リリース発表 2026年10月8日。
内容
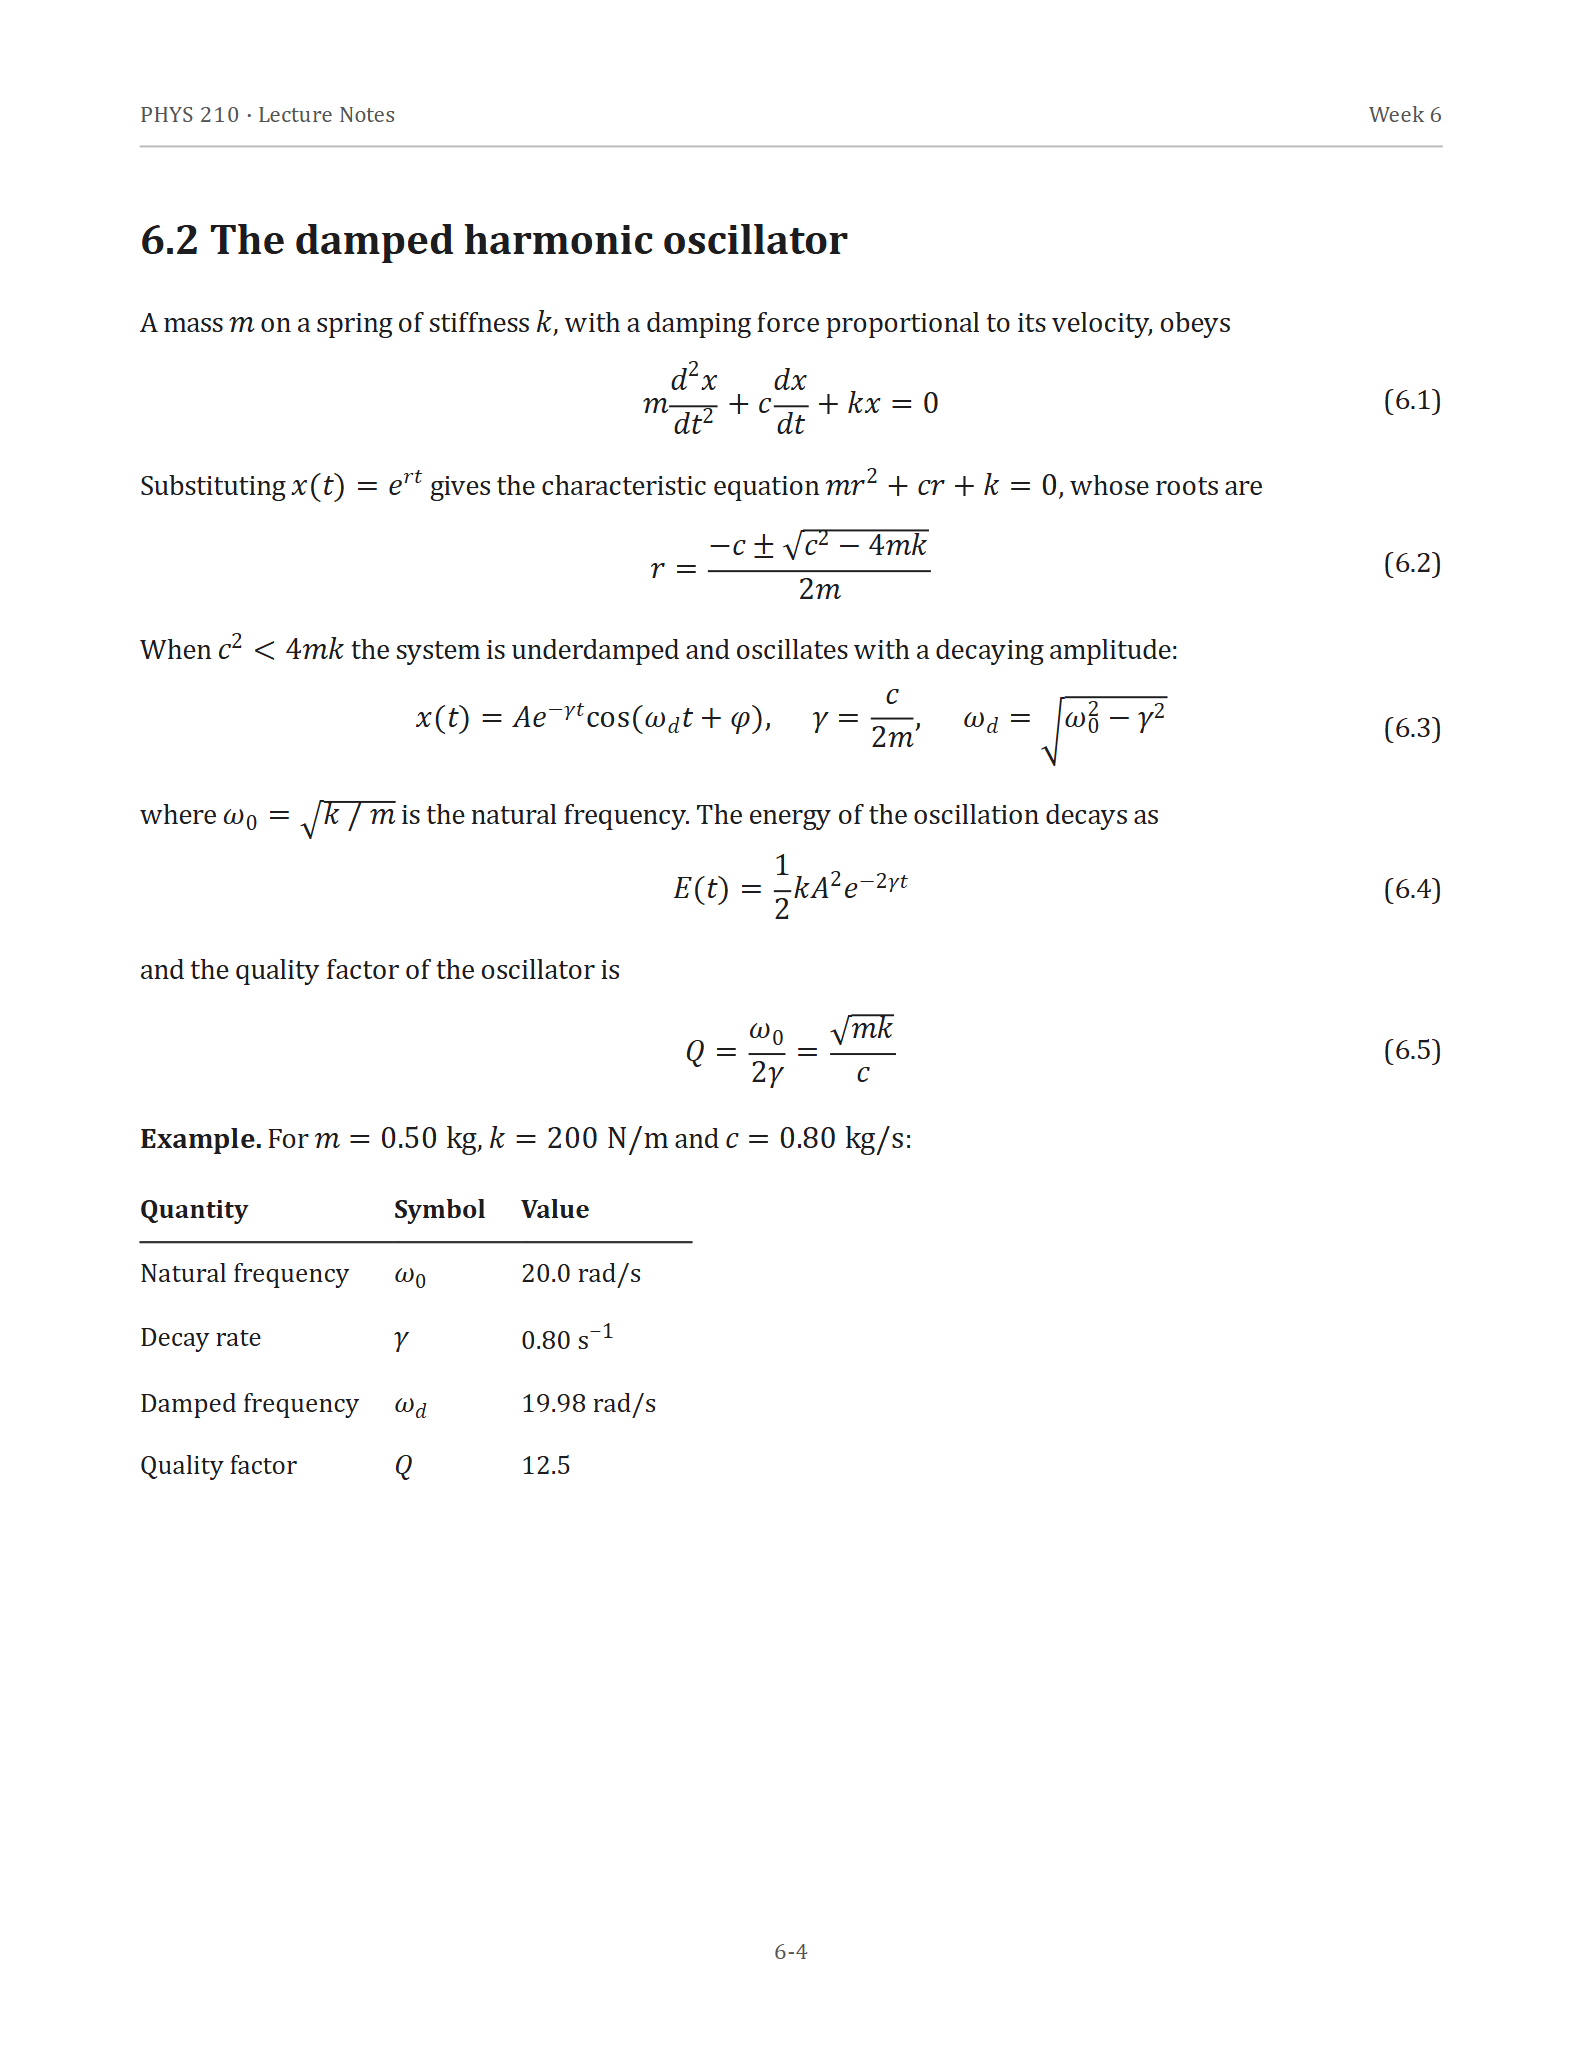
講義ノートのテストページを一つのリクエストで読んだ。このページと、3人のビジョンチャットモデルに対する他の2ページが掲載されている LightOnOCR-3 4B vs Qwen3.5 4B vs Gemma 4 26B-A4B vs Mistral Small 3.1お問い合わせ.
そのページで返されたMarkdownの開始ページ;他の3つの方程式、表、ページ番号も同じ回答で続きます:
PHYS 210 ·講義ノート 第6週 ## 6.2 減衰調和振動子 剛性バネ$k$上の質量 $m$ は、その速度に比例した減衰力を持ち、 $$ m \frac{d^2 x}{dt^2} + c \frac{dx}{dt} + kx = 0 \quad \text{(6.1)} $$ $x(t) = e^{rt}$ 代入すると特性方程式 $mr^2 + cr + k = 0$ 、その根は$$ r = \frac{-c \pm \sqrt{c^2 - 4mk}}{2m} \quad \text{(6.2)} $$あなたの最初のお願い
URLまたはbase64データURIで文書を送信してください。このリクエストはサンプルPDFの最初の2ページを読み込みます:
curl https://api.empiriolabs.ai/v1/ocr \ -h "Authorization: Bearer $EMPIRIOLABS_API_KEY" \ -H "Content-Type: application/json" \ -d '{ "model": "lightonocr-3-4b", "document": { "type": "document_url", "document_url": "https://media.empiriolabs.ai/assets/blog-images/lightonocr-3-4b-test-2026-10-25/sample-document.pdf" }, "pages": [0, 1] }'あなたのマシン上のファイルはデータURIとして入力され、ホスティングは不要です。
import base64 import os import request with open("report.pdf", "rb") をhandleとして: encoded = base64.b64encode(handle.read().decode() response = requests.post("https://api.empiriolabs.ai/v1/ocr", headers={"Authorization": f"Bearer {os.environ['EMPIRIOLABS_API_KEY']}}, json={ "model": "lightonocr-3-4b", "document": {"type": "document_url", "document_url": f"data:application/pdf;base64,{encoded}"}, }, timeout=300,) response.raise_for_status() for page in response.json()["pages"]: print(f"--- page {page['index'} ---") print(page["markdown"])画像も同様に動作します。 「タイプ」:「image_url」 およびURLまたはデータURIの image_url.文書はPDFまたはPNG、JPEG、WebP、TIFF、BMP、GIF、AVIF画像で最大50MBまであり、1回のリクエストで最大1,000ページを読み上げることができます。
何が返ってきますか
応答は1ページあたり1つのオブジェクトを保持します。 ページ.それぞれのページは 値下げ; ブロックページの各領域を読み順に、その型(タイトル, 本文, 一覧, 表, 方程式, キャプション, ヘッダー, フッターおよびピクセルのボックス; 画像、画像領域;および 寸法、ボックスが参照するページ画像のサイズ。 usage_info.pages_processed 読んだページ数を数えます。講義ノートページに戻された16ブロックのうちの一つ:
{ "type": "equation", "top_left_x": 641, "top_left_y": 526, "bottom_right_x": 1447, "bottom_right_y": 610, "content": "$$\nr = \\frac{-c \\pm \\sqrt{c^2 - 4mk}}{2m} \\quad \\text{(6.2)}\n$$" }リクエストはページが読まれると返事をする。約4分半の返答が続いている 202 with a 求人情報:世論調査 出て/v1/jobs/{job_id} しかし 状況 は 完了完了、そしてページが入っています 結果.ジョブIDを一度に取得するには、ヘッダーを送信してください 優先:レスポンス・アシンクお問い合わせ.
オプション
- ページ。
ページ0ベースページ番号をリストとして取ります([0, 2, 3])または文字列("0,2-4").すべてのページを読むためにそのままにしておきましょう。 - テーブル。
table_format設定値下げまたはHTML各テーブルを表その形式で、リンクを残します。[tbl-0.html](tbl-0.html)ページのMarkdownに残ります。それがなければ、テーブルはHTMLとしてMarkdownに残ります。 - 画像。
include_image_base64各画像領域をJPEGデータURIとして返します。image_limitドキュメント全体で戻ってくる画像数を制限し、image_min_sizeそのピクセル数より狭い領域や短い領域は省略されます。 - ヘッダーとフッター。
extract_headerおよびextract_footerマークダウンから自分たちの畑に移す。 - レイアウト。
include_blocks設定偽り葉ブロック出て行け。
作戦メモ
- ページ番号は0から始まります。
「ページ」:[1]二ページ目を読む。 - ドルの符号は逃げ出して戻ってくることもあります。 ページのテキストにはドル記号が書かれていることがあります
\$、HTMLテーブルの中にも& dollar;.Markdownを検索する前に、その状態を解除してください。 - 注釈フィールドは拒否されます。
bbox_annotation_format,document_annotation_format、およびdocument_annotation_prompt回答400ページが読まれる前に。
料金について
ページ数ごとに請求されます。 各リクエストは少なくとも5ページ分請求されるため、長い文書は1ページごとに1件のリクエストではなく1つのPDFとして送ってください。失敗したリクエストは、返送しなかったページ分の請求は受けません。現在の料金は以下の通りです。 モデルページ そして、 プライシングページお問い合わせ.
建設を始めろ
LightOnOCR-3 4Bを試してみてください Playground 自分の文書と一緒に、 ドキュメントOCRガイド そして、 APIドキュメント すべてのパラメータに対して。
ディスクロージャー:この記事は、EmpirioLabs AIによるAIの支援とレビューで書かれました.