Aplomb 1は私たちの最初のモデルです。テキスト、JSON、画像、音声、動画を1回のリクエストで処理し、最大1Mトークンのドキュメントを約3秒で読み込みます。短い質問はモデル時間で約15msかかります。
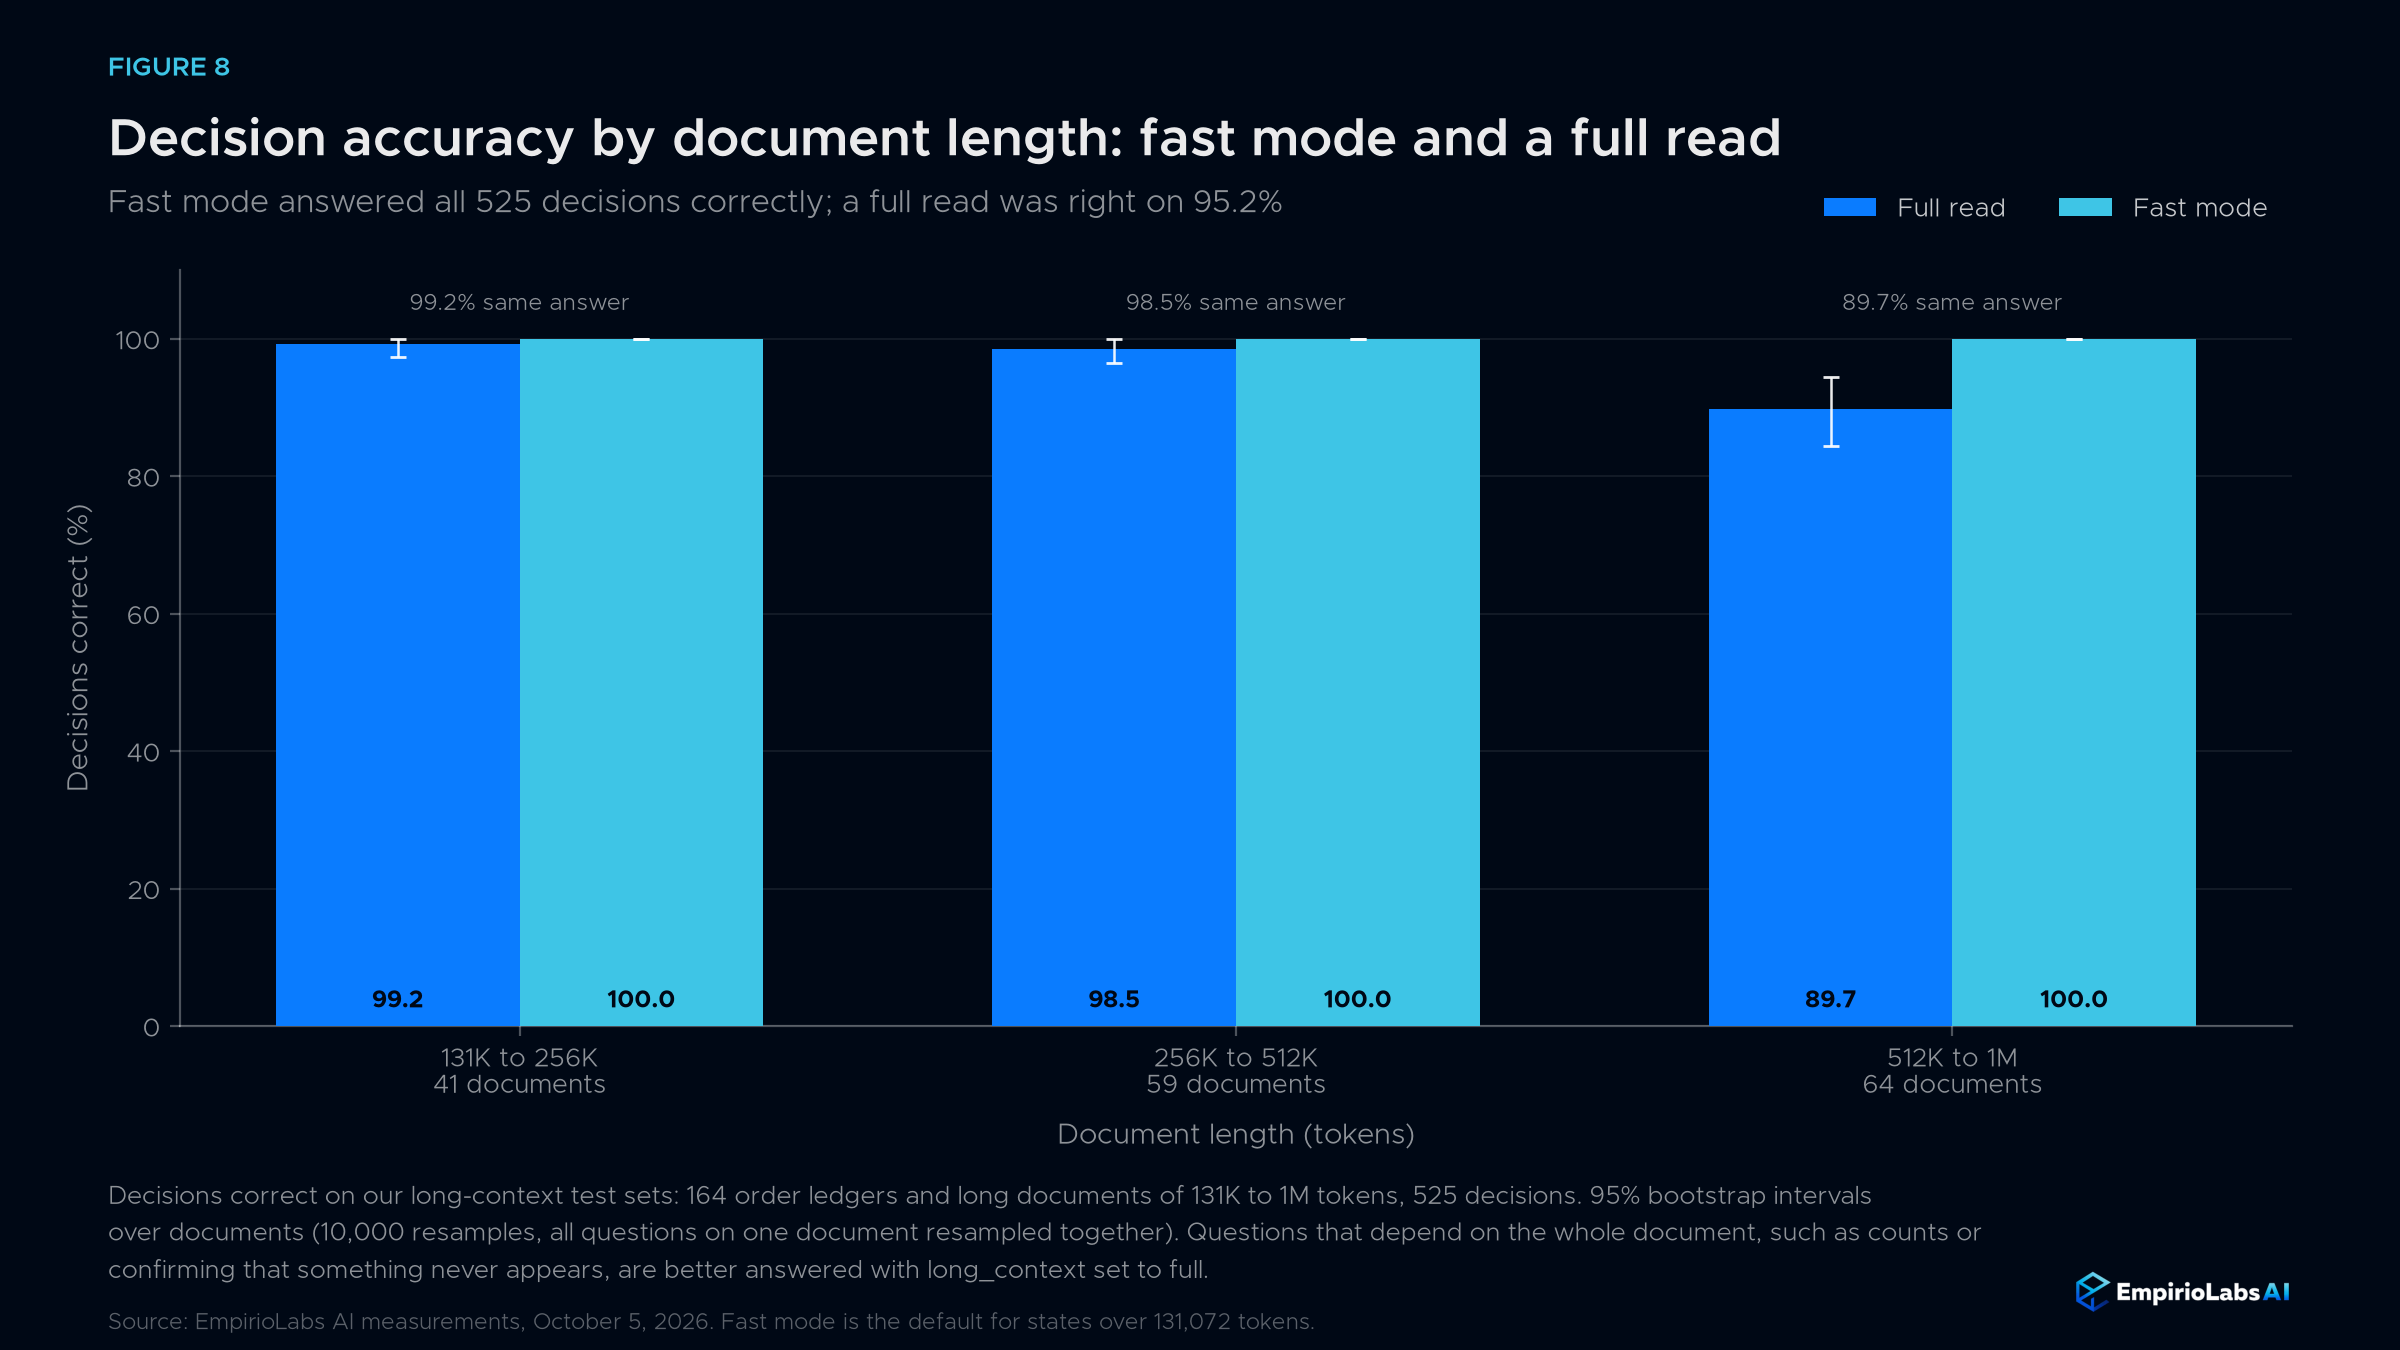
これは意思決定モデル用に構築した推論ランタイム上で動作します。APIやPlaygroundでは、長い文書は高速の長コンテキストモードを通過します。1Mトークン文書は約3秒で済み、111秒ではなく、高速モードで長コンテキストテストの525件すべてに正しく答えました。
エージェントの場合、Aplomb 1はすべてのツールと各enumおよびboolean引数に対して1つのリクエストで確率を返すため、モデルが確実なときにはエージェントが行動し、そうでないとエスカレーションします。すべての回答はキャリブレーションされており、入力が答えを保持していないと推測する代わりに判断できます。チケットのルーティングからエージェントの次のツールの選択まで、ソフトウェアが1日に何千回も行う意思決定のために構築されています。
2026年10月6日時点で、公開されたDecision Indexボードの4Bモデルの中で#1位、公式キットでは44.86、38ベンチマーク中8項目で最大5.3Bパラメータのモデルで#1位です。現在、EmpirioLabsAPIとPlaygroundで利用可能で、その重みはHugging FaceのEmpirioLabsモデルライセンスの下で公開されています。
| Aplomb 1 一目で | |
|---|---|
| 入力 | テキスト、JSON、画像、動画、音声、どんなミックスでも |
| 窓 | 1,000,000トークンの州と質問 |
| 質問 | はいかいいえ、選択肢(2から255まで)、スコア(2レベルから10レベル)、ツール選択 |
| 州内では | 入力が答えを保持しない確率 |
| 工具選択 | 次に呼び出すツールで、その列挙とブール値の確率を含みます |
| 速度 | 短い質問で約15msのモデル時間、高速長コンテキストモードで1Mトークン文書の場合は約3秒、 |
| APIフォーマット | Decisions APIに加え、OpenAI、Anthropic、Geminiフォーマットも含まれます |
| 請求 | 入力トークンのみ;出力トークンは常にゼロです |
| データ保持 | デフォルトでデータ保持はゼロです |
| サイズ | 53億パラメータ、Qwen3.5-4B上に構築;Hugging Face上のオープンウェイト |
| 決定指数 0.2.1 | 公式キットの44.86、2026年10月6日時点で公開された4Bモデルの中で#1です |
答えは何でしょうか
4つの問題タイプがあります。 ヌール 「はい」か「いいえ」と答える確率で。 選択 2から255の選択肢から1つを選び、全分配を返します。 スコア 州を2から10の秩序あるスケールに置く。 ツール どの関数ツールを呼び出しるかを選び、その列挙式とブール値の引数で分布を返します。
州内では。 追加 「棄権」:真 質問に対して、答えに対しても、その状態が質問に必要なものを含まない確率も伴います。キャリアフィールドが全くないレコードは、自信のある推測ではなく高い棄権確率を得ます。
独立した回答です。 最大128問が1つの状態を共有し、それぞれが個別に答えられるため、質問を追加しても他の答えが変わることはありません。
エージェントのためのツール選択
Aplomb 1にエージェントの関数ツールと現在の状態(チケット、会話、レコード)を与えると、次のツールを呼び出すツールを、すべてのツールごとに確率と、各エナックとブールの引数ごとに分布を返します。一般的なLLMはトークンごとにツールを呼び出し出し、ツールや引数の確信度は示しません。エージェントは確率が高い時に行動し、そうでないときはステップを大きなモデルに渡すため、通常のステップは生成された回答をスキップします。引数確率を返す他の意思決定モデルは見つかりませんでした。
「B-44120の注文が画面にひび割れて届きました。返金を要求します。」というチケットには、3つの工具が入っていました。 issue_refund (a 理由 エヌムと full_refund ブール数)、 track_package および escalate_to_humanは(要約、丸み切れ)として戻ってきます:
{"tool": "issue_refund", "probabilities": {"issue_refund": 0.969, "none": 0.025, "escalate_to_human": 0.005, "track_package": 0.002}, "arguments": {"issue_refund": {"reason": {"value": "damaged", "probabilities": {"damaged": 0.993, "not_as_described": 0.007, "late": 0.001}}, "full_refund": {"value": true, "probability_true": 0.761}}, "open_arguments": {"track_package": ["order_id"]}}
命令IDのような自由テキスト引数は以下に一覧表示されます open_arguments エージェントが埋めるためのものだ。
混合入力、最大100万トークン
テキスト、JSONオブジェクトや配列、画像、動画、音声は同じ状態に、どんな組み合わせでも分かります。アカウントレコードの横にサポート通話の録音、請求フォームの隣にドライブレコーダーのクリップ、出品の隣に商品写真などです。状態と最長の質問は1,000,000トークンに達し、長期契約バンドル、1年分のチケット、または1時間分のトランスクリプトを1回のリクエストで取得できます。
スコアの見方
同じ項目に対してAplomb 1と3つのオープン4B意思決定モデルを実行し、Intern-Decisionが公開したJev、JevK5、SemIfの数字をそれらの隣に配置しました。7スイートのIntern-Decisionレポート群では、Aplomb 1の平均は88.7%です。Jevの公開された行に対しては、JevBench Hardとタイプ判定でリードし、JevBench Easyでは並び、JevBench Original、ToolACE、AG News、WildJailbreakでは遅れています。最大のリードはJevBench Hardに対して+5.4ポイントです。
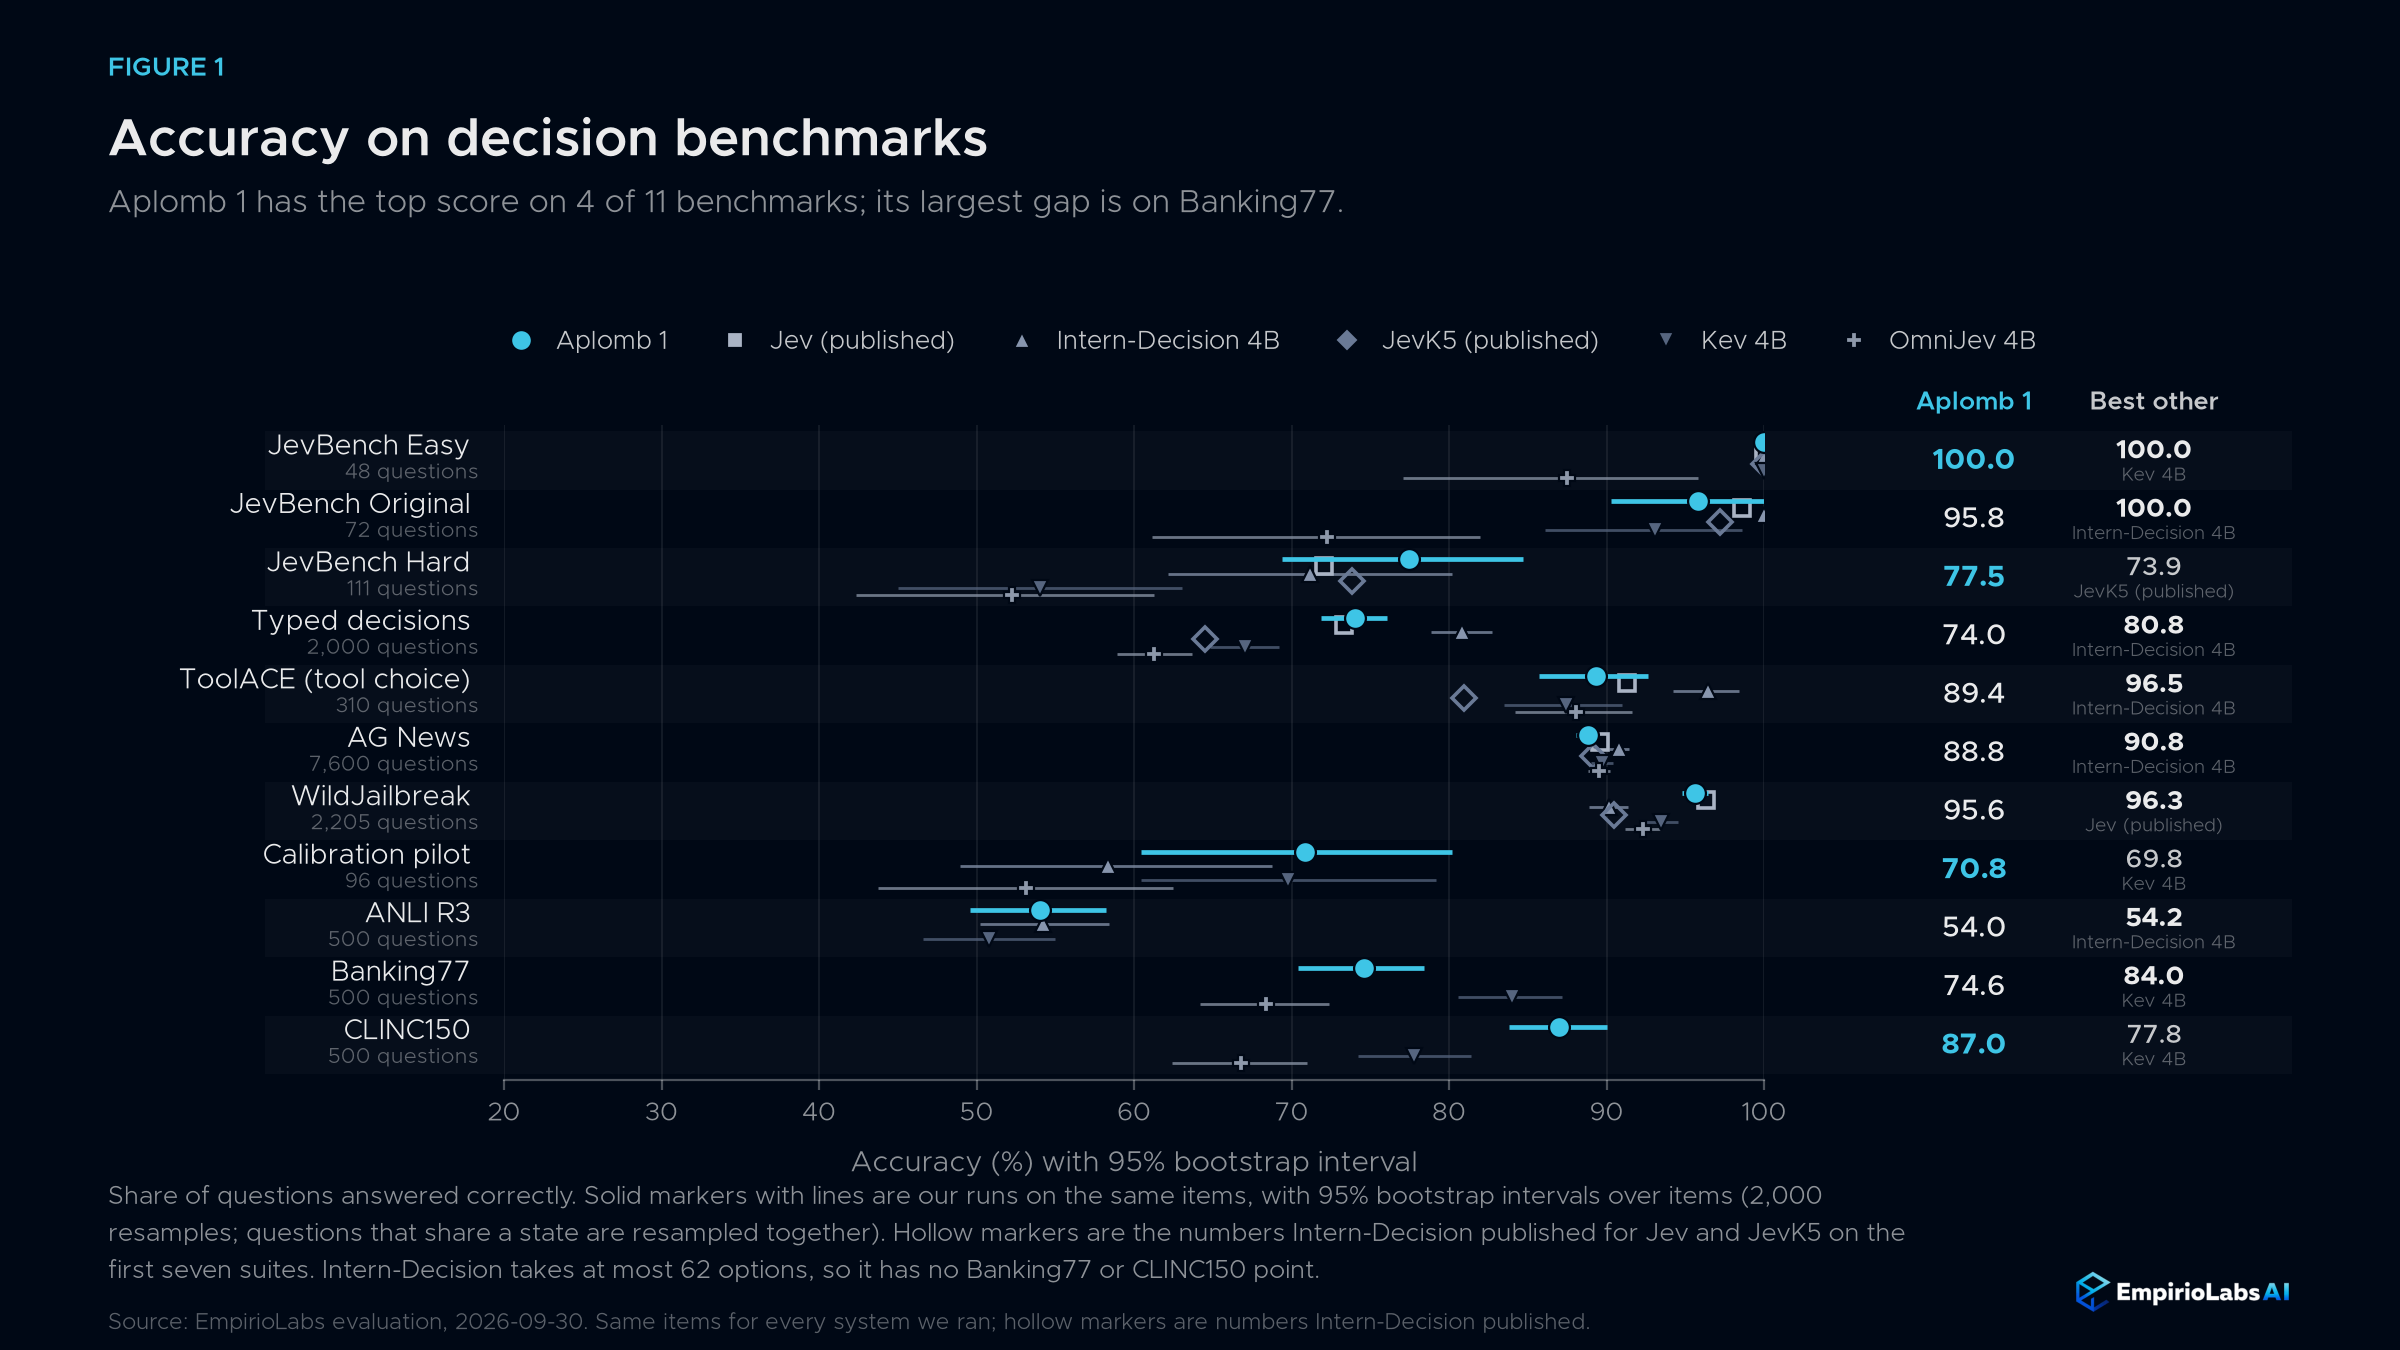
| ベンチマーク | アプロンブ1 | Jev(p) | JevK5 (p) | Semif (p) | インターン決定4B | ケブ4B | オムニジェヴ4B |
|---|---|---|---|---|---|---|---|
| ジェヴベンチ・イージー | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 87.5 |
| JevBenchオリジナル | 95.8 | 98.6 | 97.2 | 98.6 | 100.0 | 93.1 | 72.2 |
| ジェヴベンチハード | 77.5 | 72.1 | 73.9 | 61.3 | 71.2 | 54.1 | 52.3 |
| タイプされた決定 | 74.0 | 73.3 | 64.5 | 62.8 | 80.8 | 67.0 | 61.3 |
| ツールACE | 89.4 | 91.3 | 81.0 | 85.2 | 96.5 | 87.4 | 88.1 |
| AGニュース | 88.8 | 89.6 | 89.1 | 89.2 | 90.8 | 89.7 | 89.6 |
| ワイルドジェイルブレイク | 95.6 | 96.3 | 90.5 | 92.5 | 90.2 | 93.5 | 92.3 |
| 平均 | 88.7 | 88.7 | 85.2 | 84.2 | 89.9 | 83.5 | 77.6 |
(p) Intern-Decisionが同じ項目について公表したものです。Intern-Decisionはこのバンドルの4Bモデルで90.02を報告しています。列は私たちの実行結果を示しています。
| ベンチマーク | アプロンブ1 | インターン決定4B | ケブ4B | オムニジェヴ4B |
|---|---|---|---|---|
| キャリブレーションパイロット | 70.8 | 58.3 | 69.8 | 53.1 |
| ANLI R3 | 54.0 | 54.2 | 50.8 | n/a |
| Banking77(77オプション) | 74.6 | n/a | 84.0 | 68.4 |
| CLINC150(150の選択肢) | 87.0 | n/a | 77.8 | 66.8 |
長入力
16Kから1Mトークンまでのオーダーレッジの検索を測定し、ある注文に関する質問はランダムな深さで設定しました。
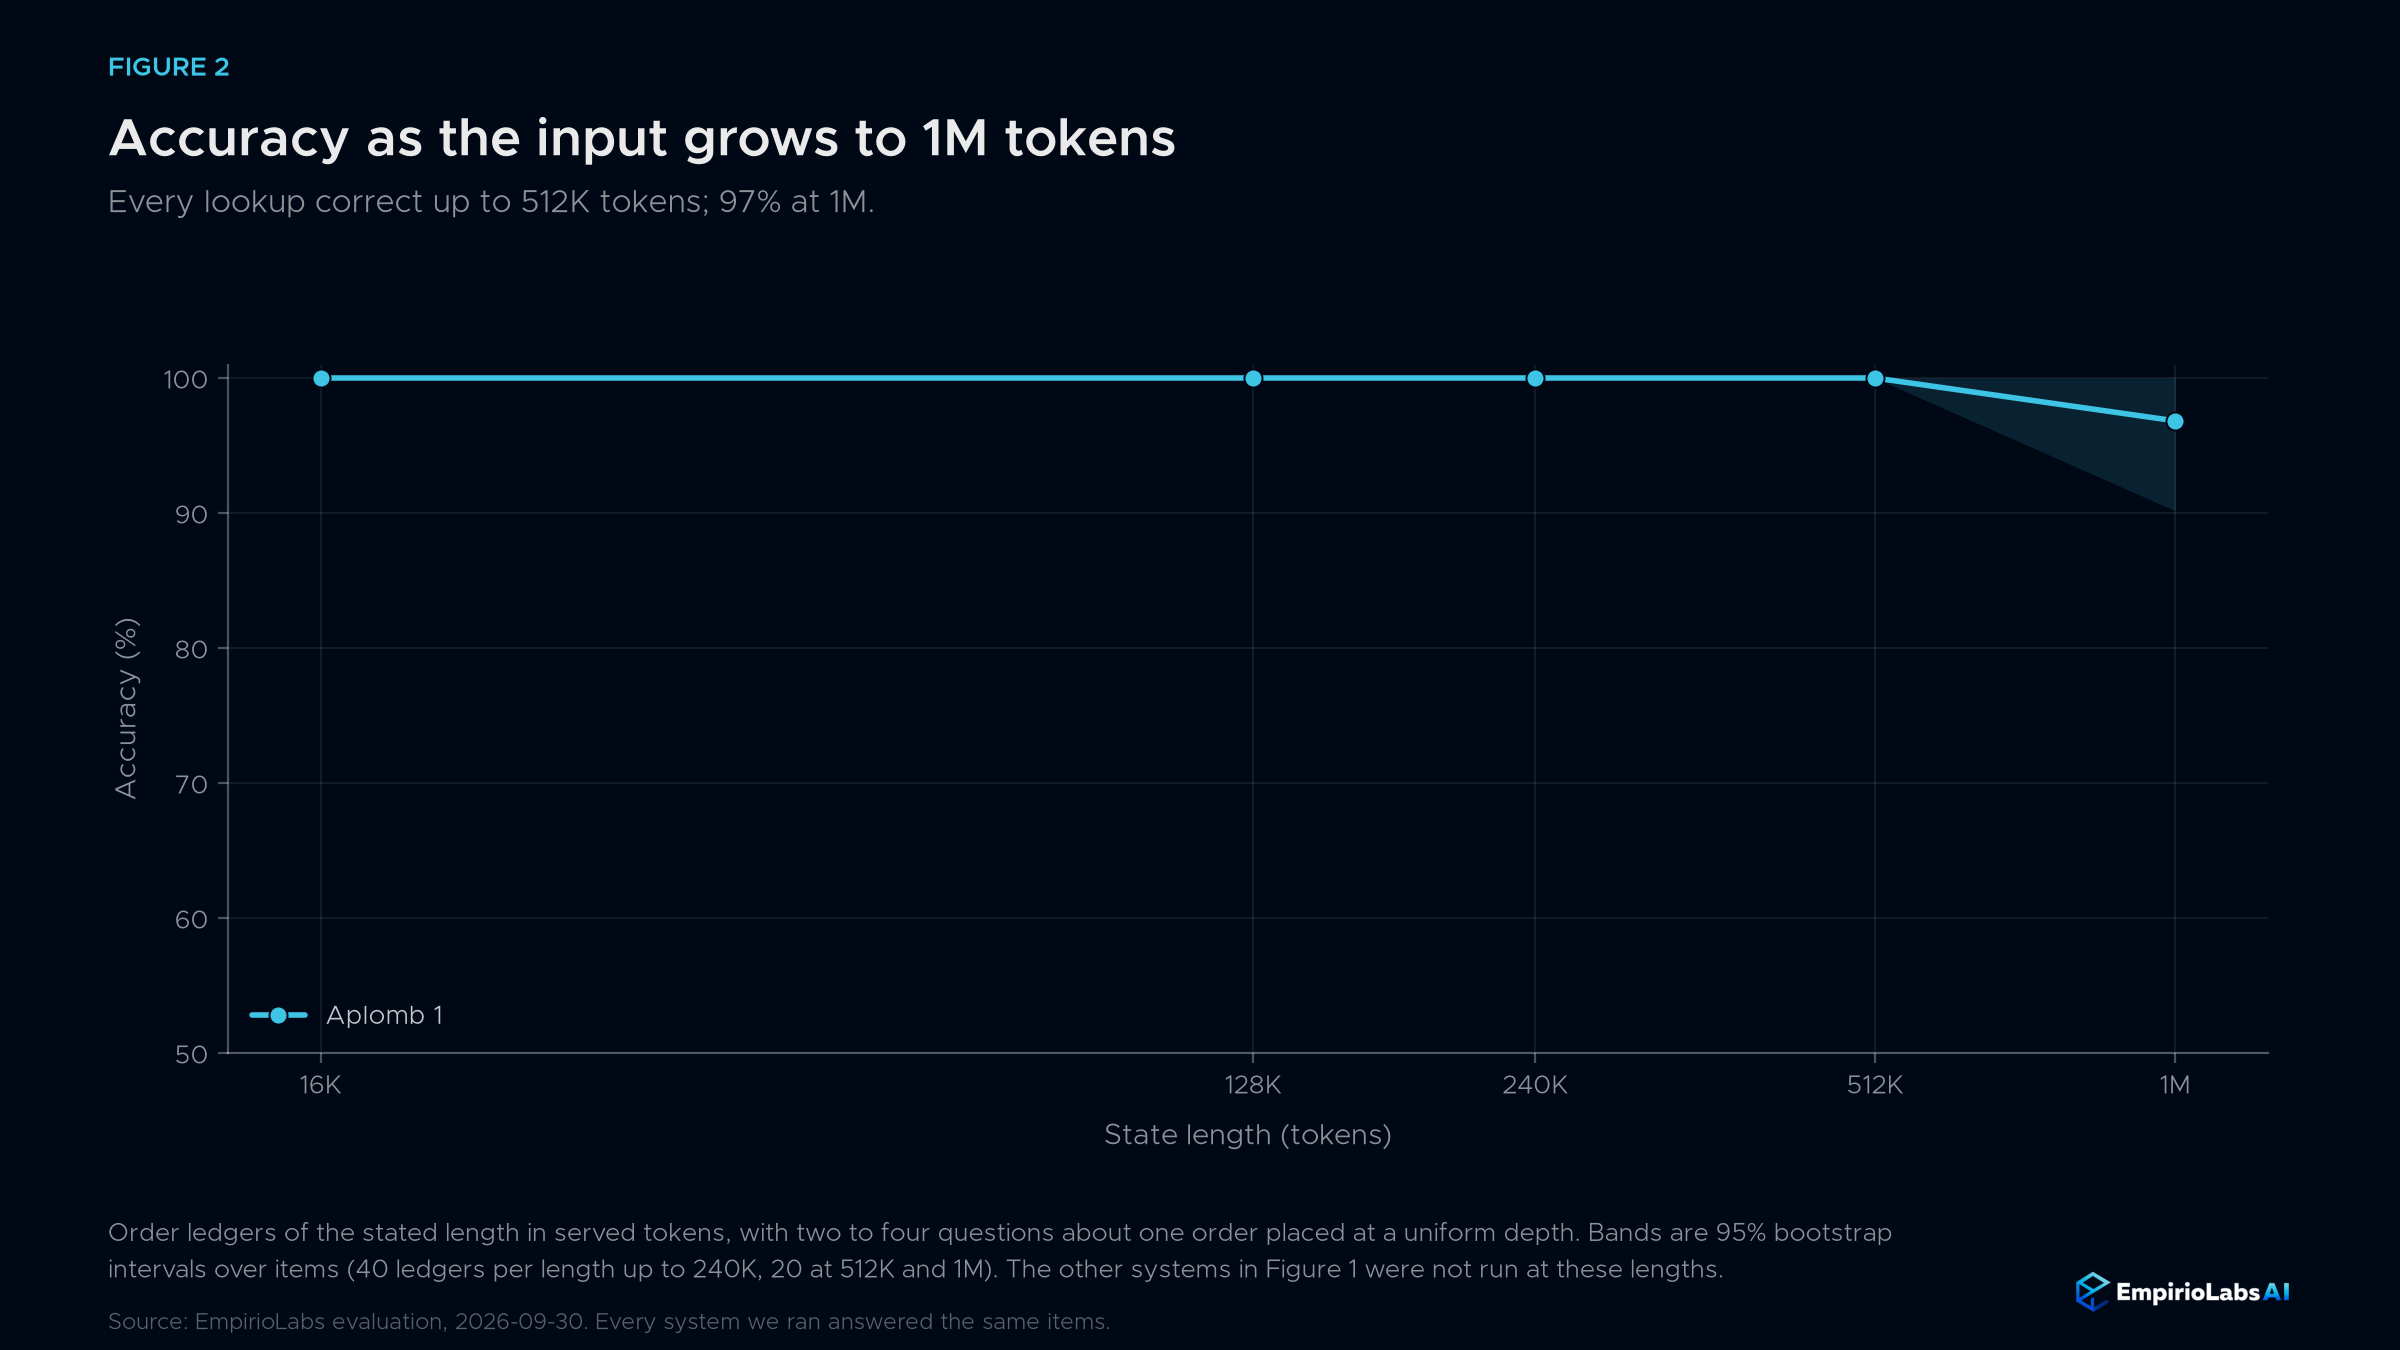
| 入力長(トークン) | 16K | 128K | 240K | 512K | 1M |
|---|---|---|---|---|---|
| アプロンブ1 | 100.0 | 100.0 | 100.0 | 100.0 | 96.8 |
数秒で長い文書が完成します
EmpirioLabsAPIおよびPlaygroundでは、131,072トークンを超える状態はデフォルトで高速長コンテキストモードで読み込まれます。1Mトークン文書は、全文を読み込むと約111秒ではなく約3秒かかり、長コンテキストテストセットではファストモードで525判定すべてに正解し、フルリードは95.2%でした。
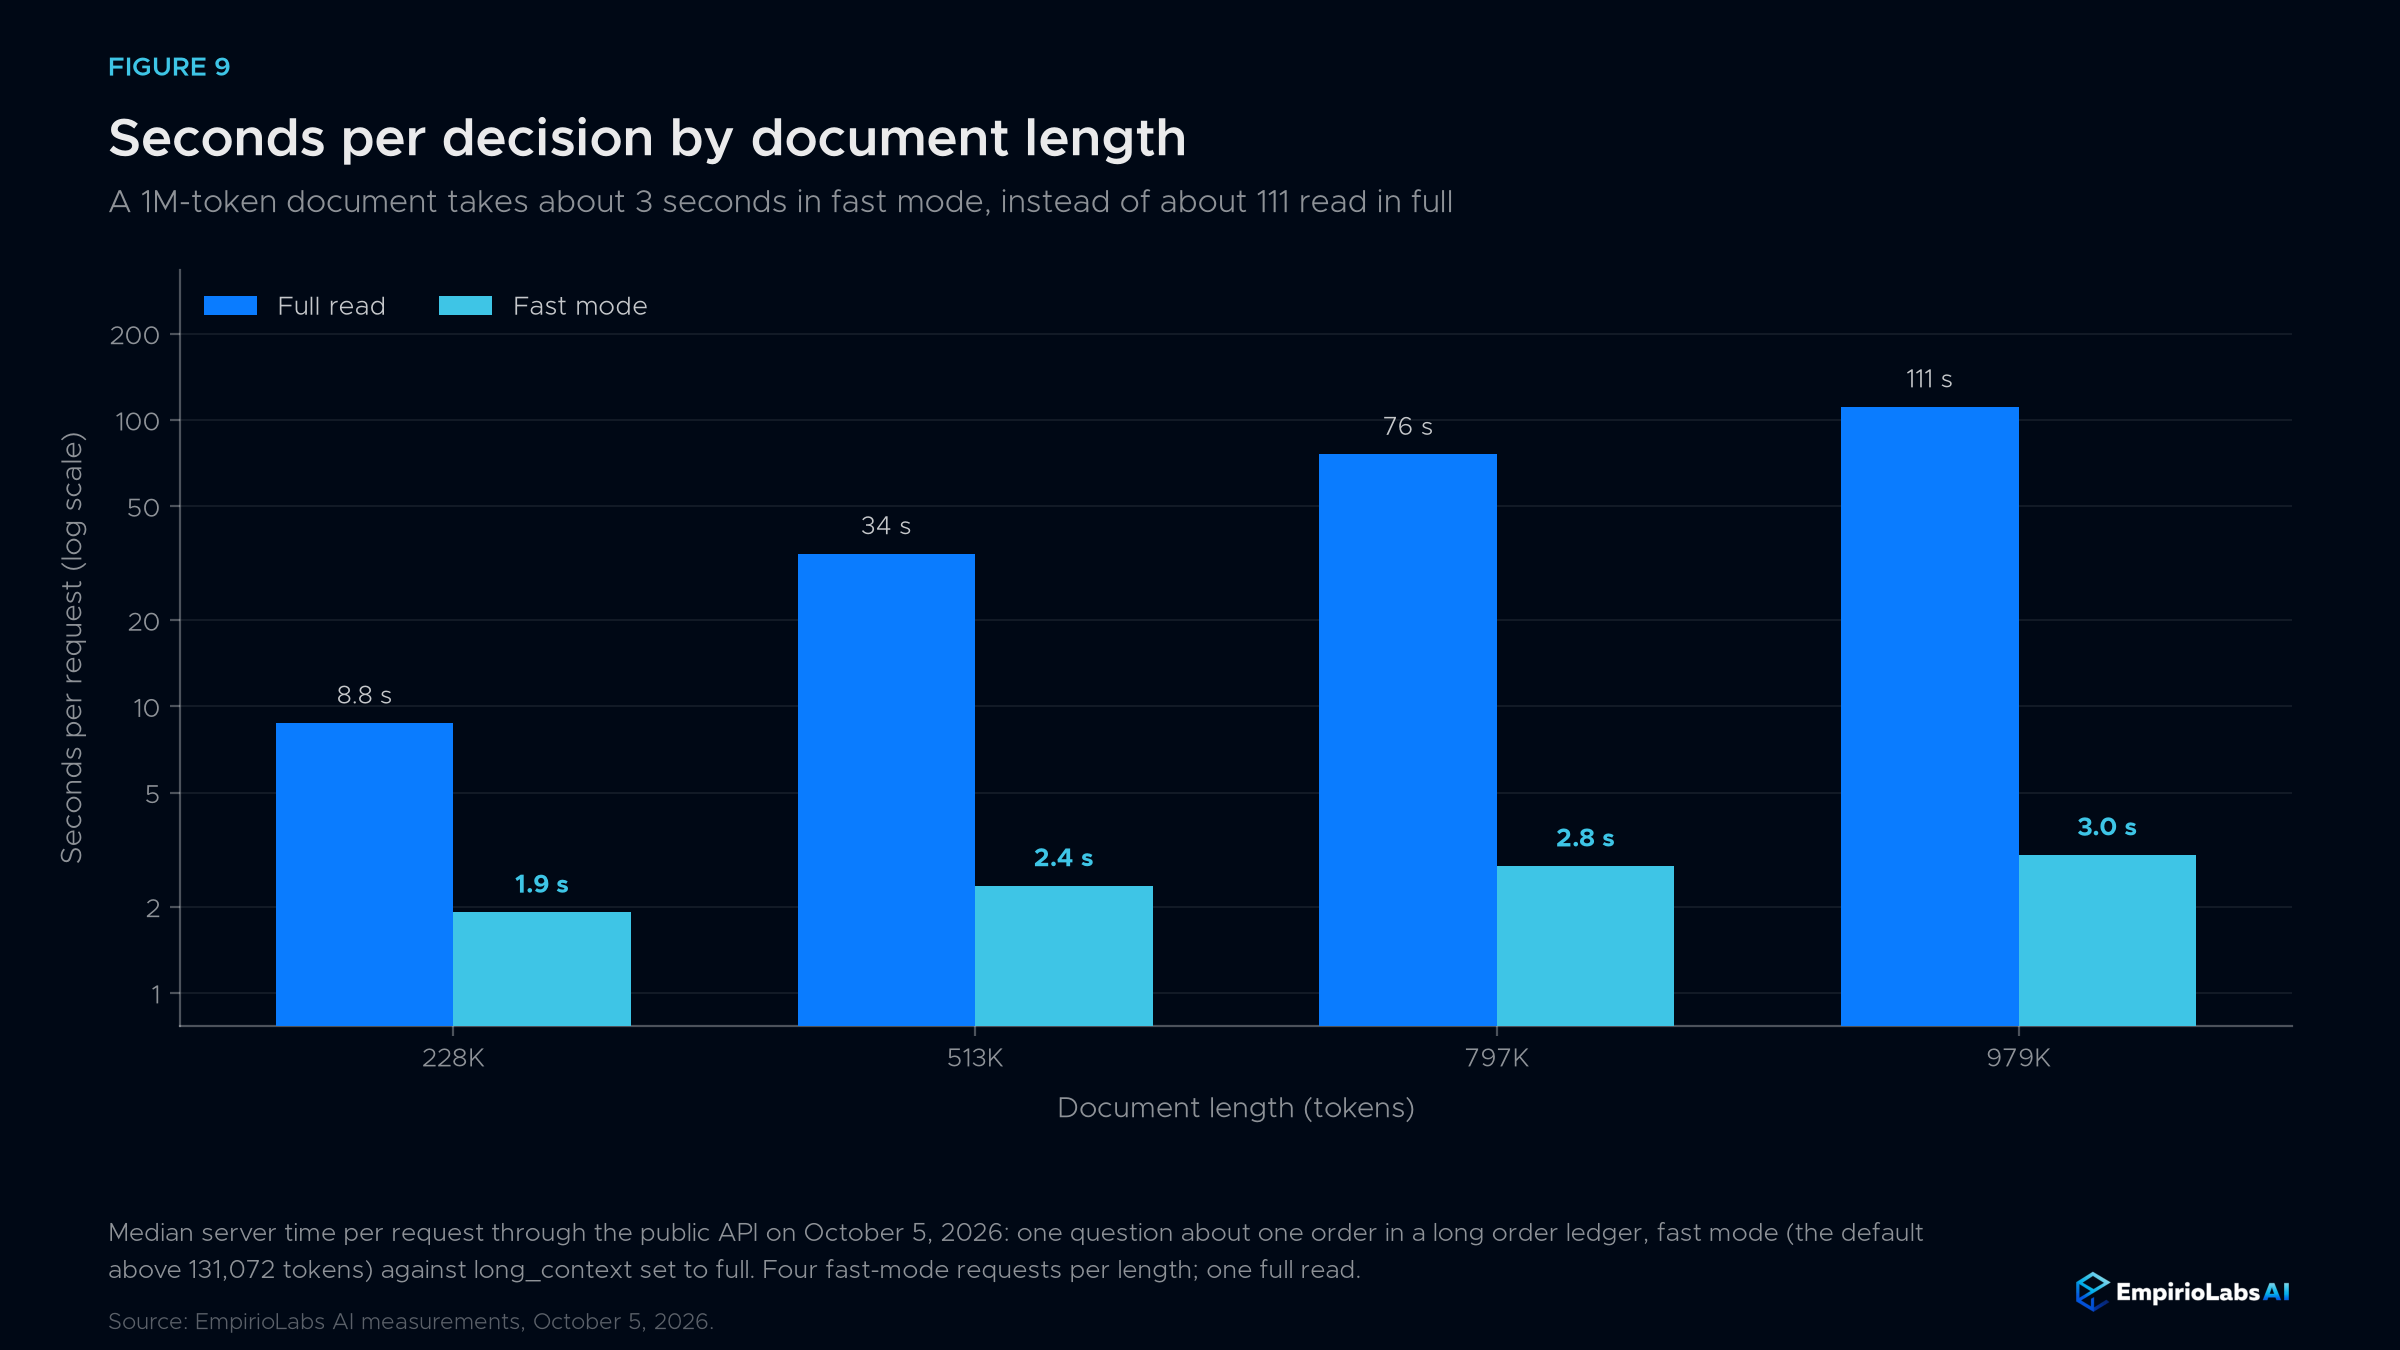
| ドキュメントの長さ(トークン) | 228K | 513K | 797K | 979K |
|---|---|---|---|---|
| 高速モード | 1.9秒 | 2.4秒 | 2.8秒 | 3.0秒 |
| 全文 | 8.8秒 | 34秒 | 76 s | 111 s |
お問い合わせ 「long_context」:「満杯」 すべてのトークンを読むこと。回答が文書全体に依存する場合、例えばカウントや全体のトーン、あるいは何も現れないことを確認する場合、フルリードがより良い選択です。これらの質問を検証するために作成された24の文書では、ファストモードが50%の決定で正解し、61%でフルリードが正解でした。回答は long_context fieldはどのモードが使われたかを示し、使用は両方のモードで全状態をカウントします。高速ロングコンテキストモードはEmpirioLabs APIとPlaygroundでのみ利用可能です。オープンウェイトはすべてのトークンを読み込みます。
キャリブレーション
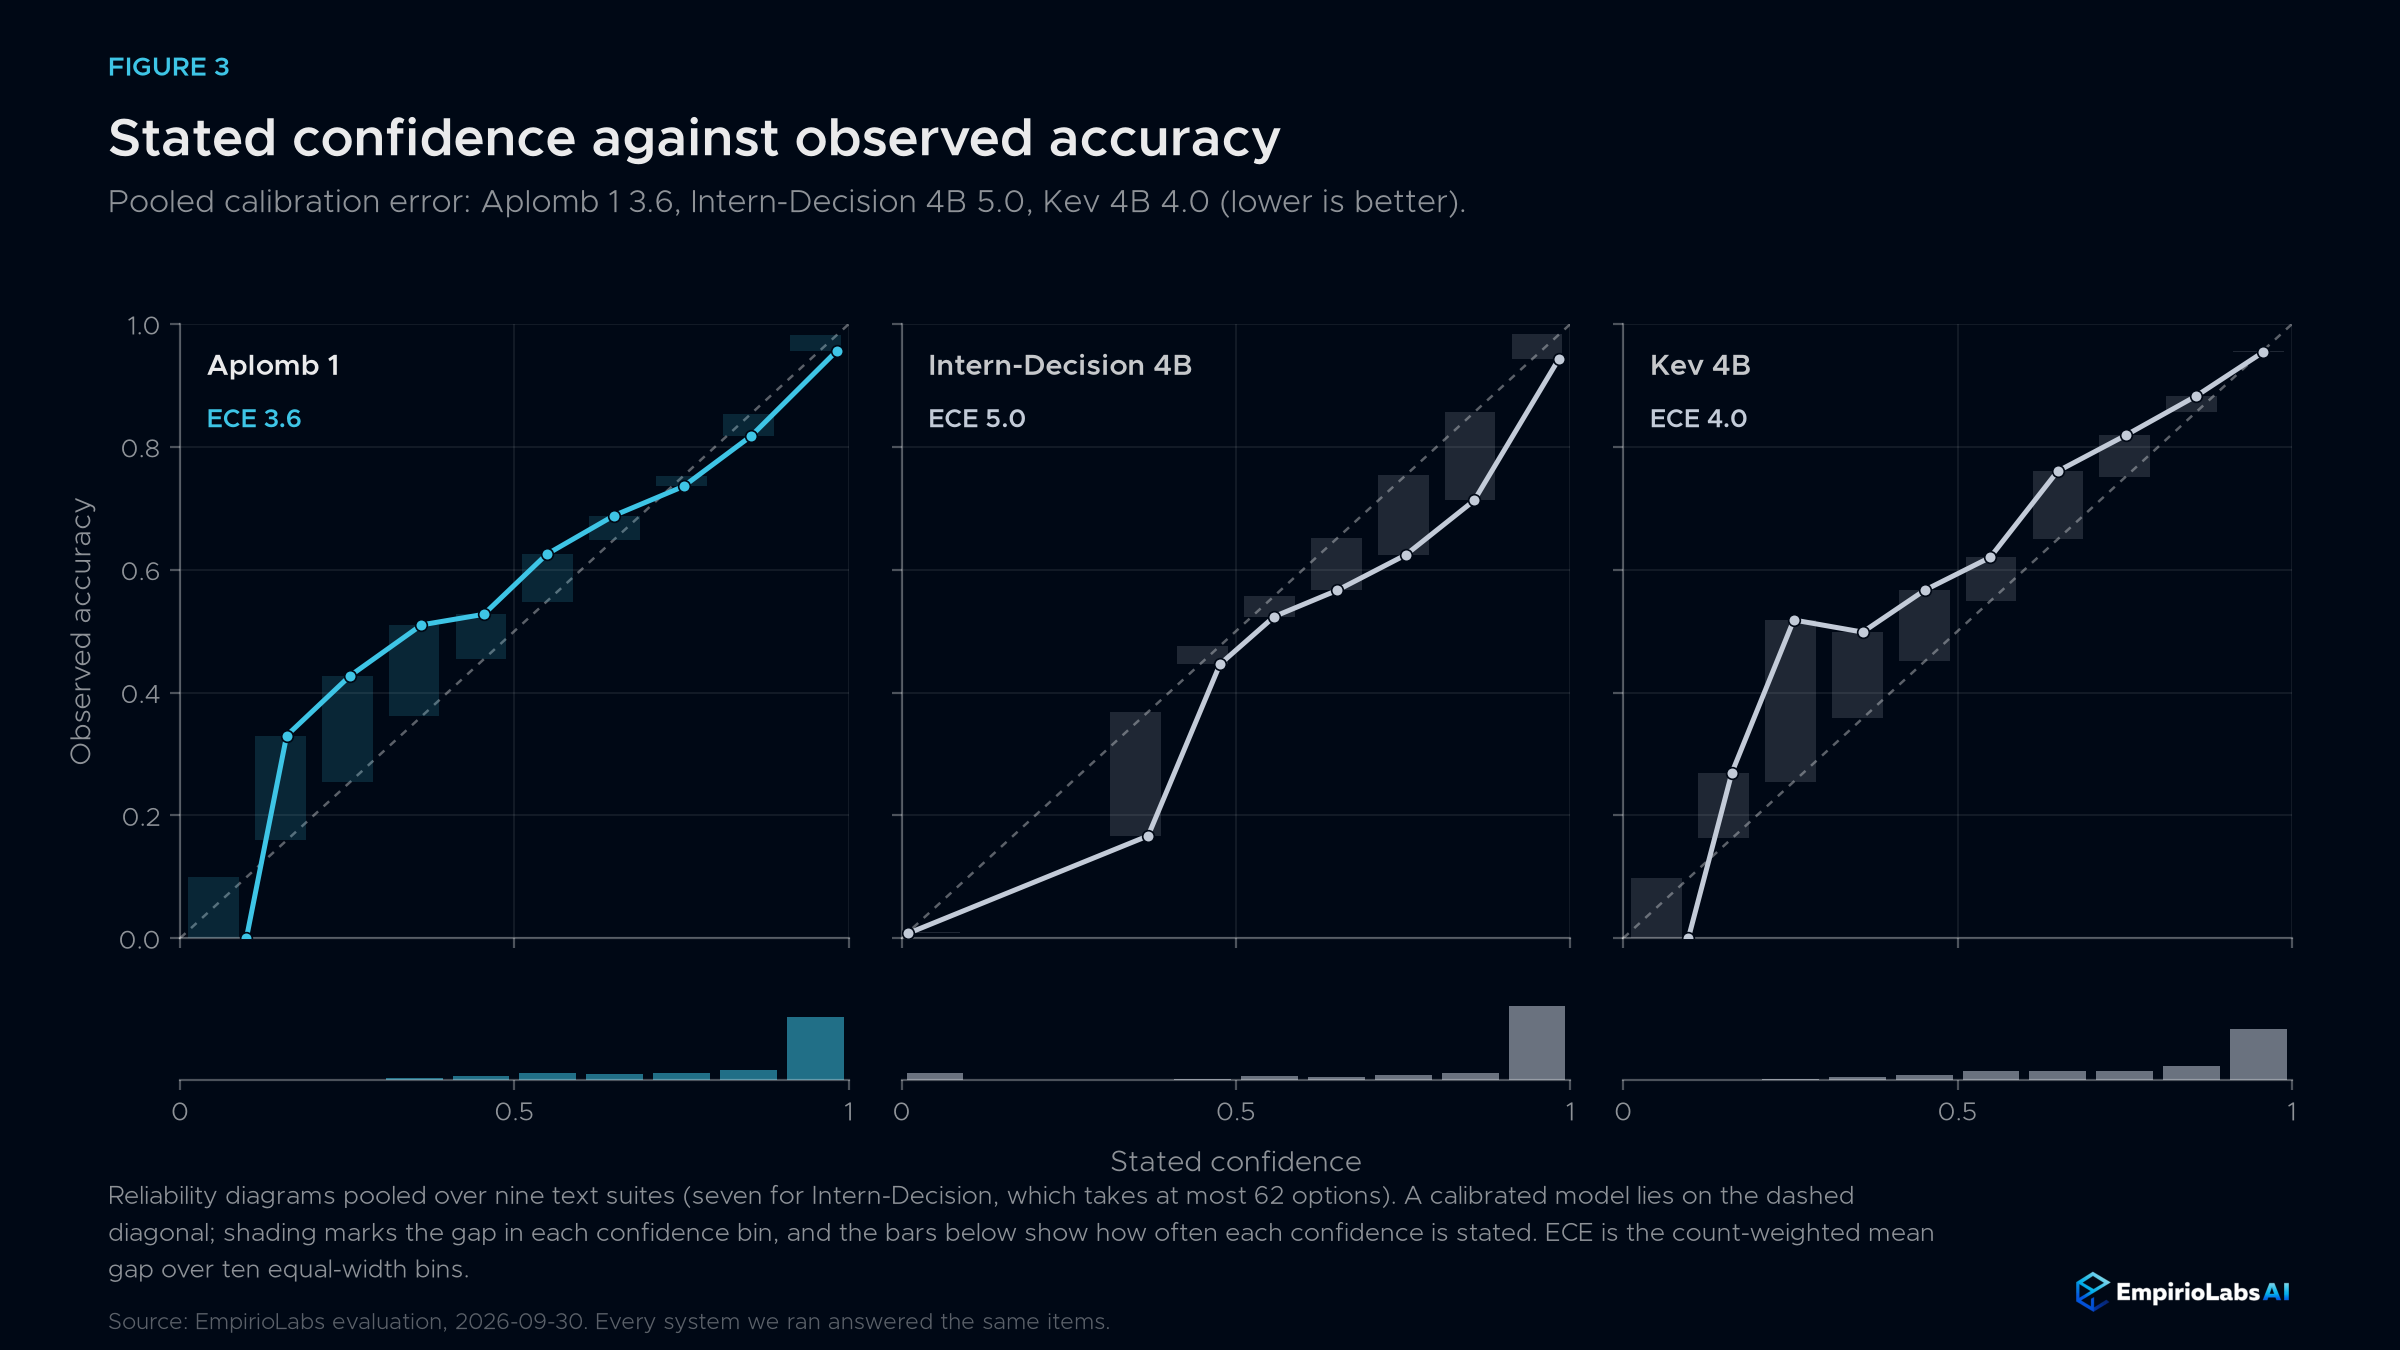
確率は、その意味がまさにその意味である場合にのみ有用です。9つのテキストスイートで、Aplomb 1の公表される信頼度は正しい頻度を追跡しています。プールされたキャリブレーション誤差は3.6で、Intern-Decision 4Bは5.0、Kev 4Bは4.0(低いほど良い)です。
画像、映像、音声
| ベンチマーク(最初の500点目) | アプロンブ1 | インターン決定4B | オムニジェヴ4B |
|---|---|---|---|
| ポープ | 89.0 | 89.2 | 88.4 |
| MMStar | 68.6 | 65.2 | 64.4 |
| AI2D | 87.0 | 81.0 | 83.4 |
| んー | 57.2 | 57.0 | 56.0 |
| ハルジョンベンチ | 79.8 | 79.4 | 71.2 |
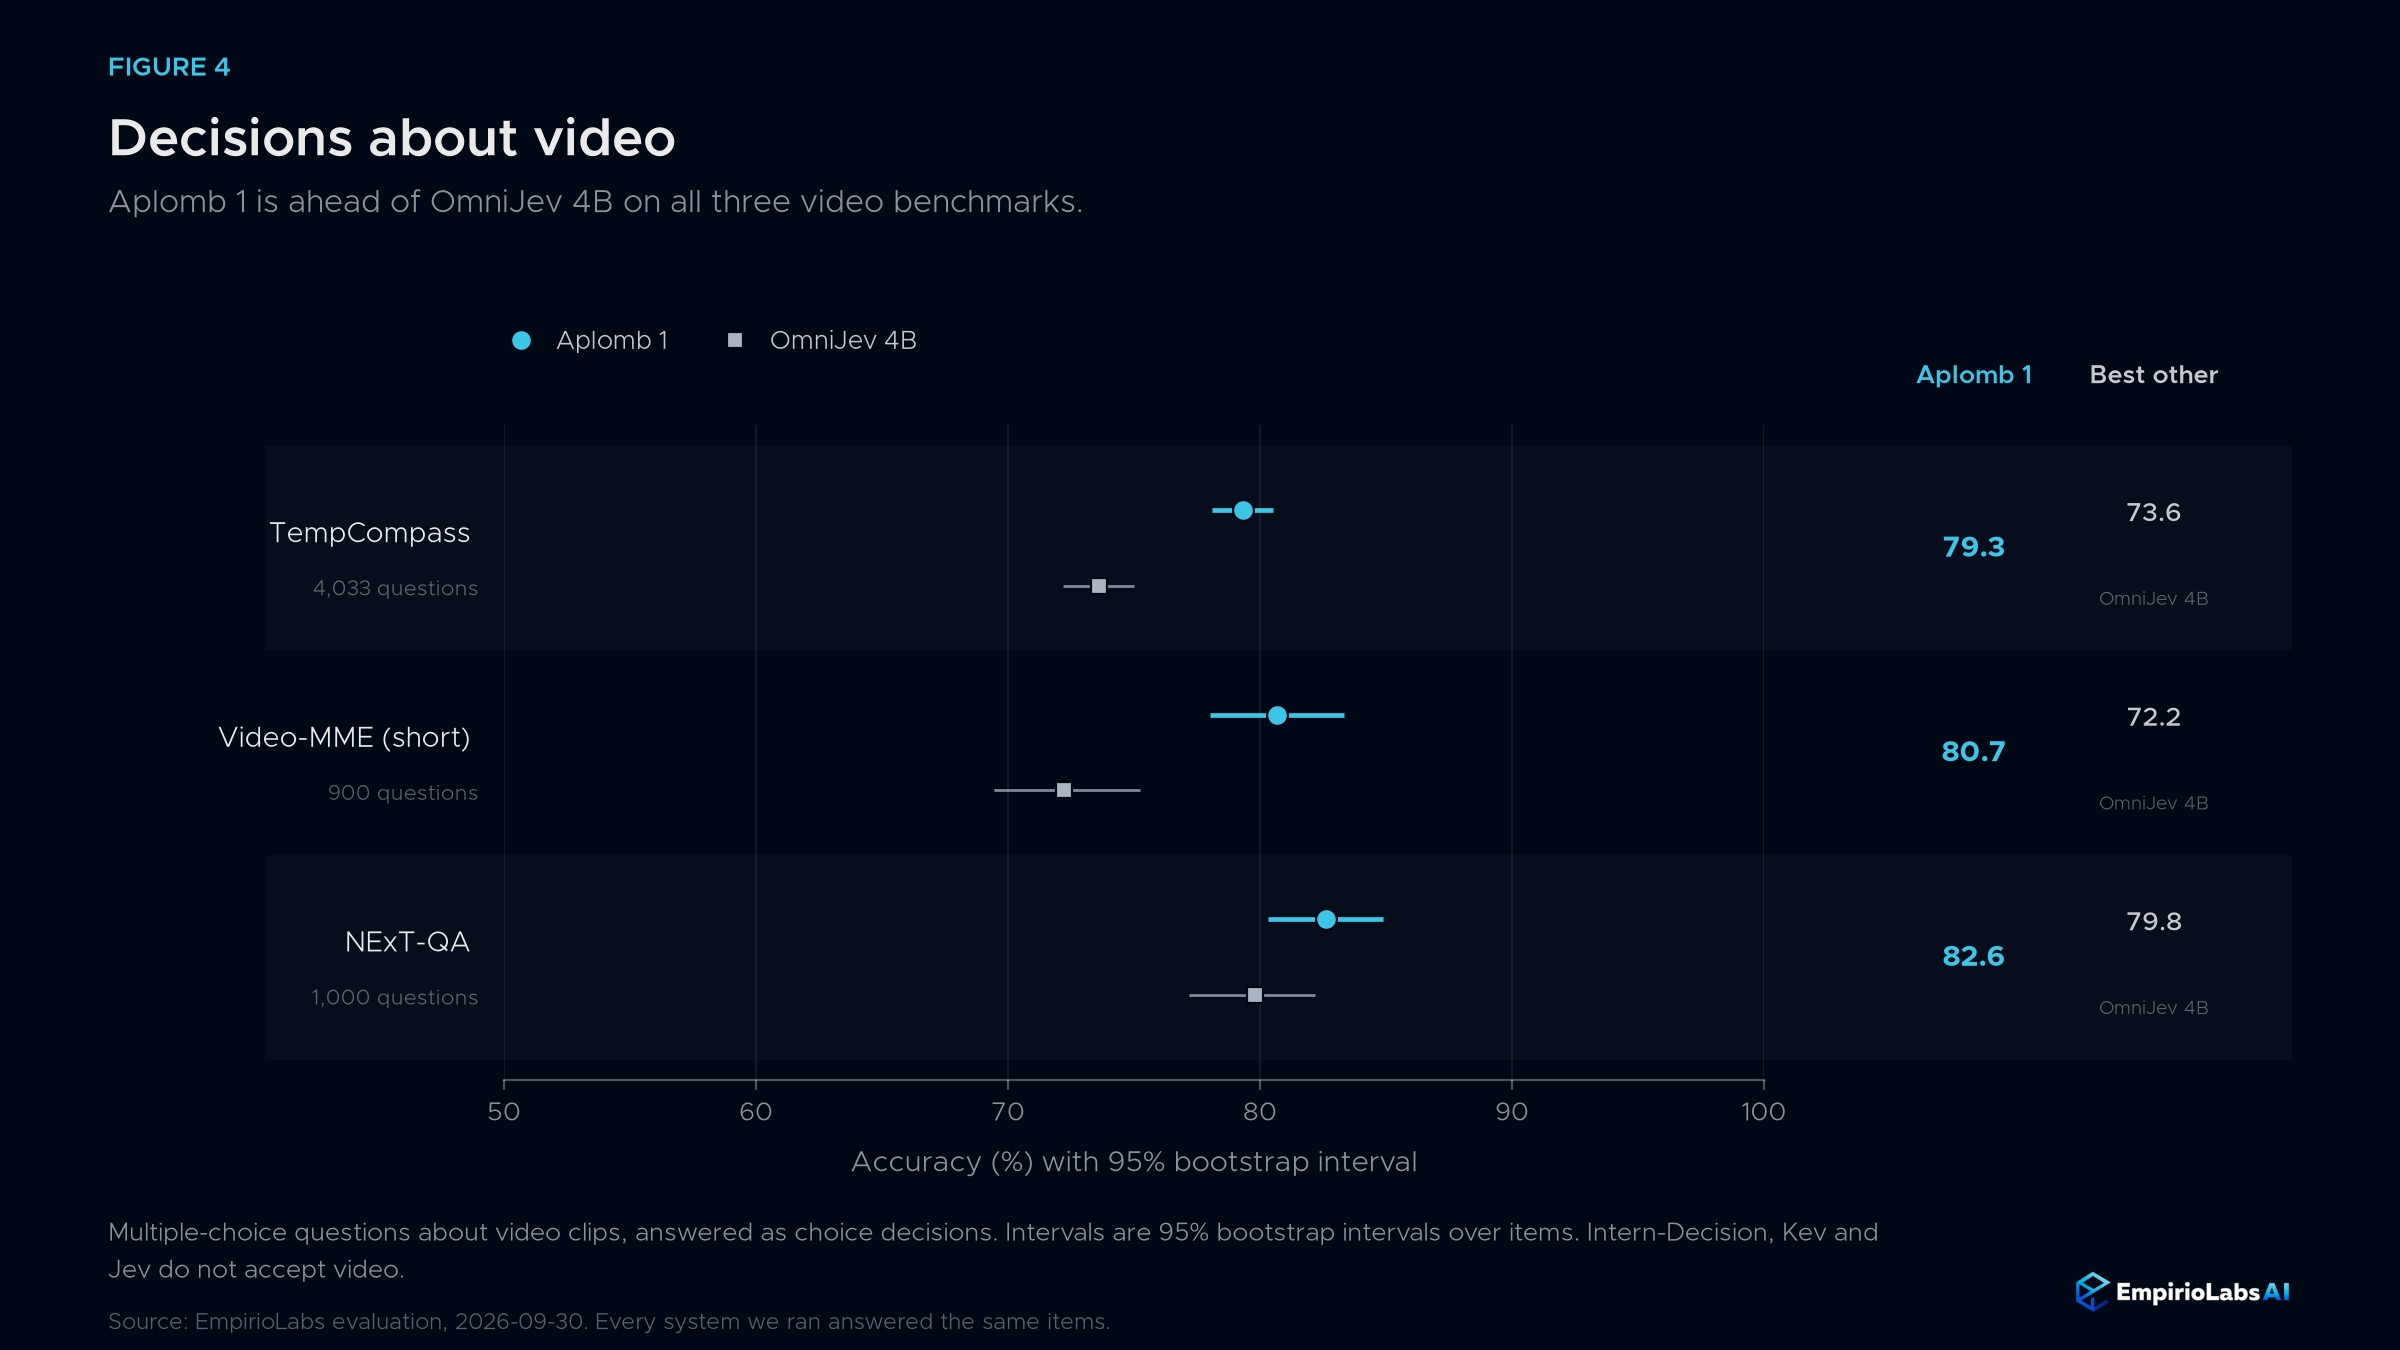
| ベンチマーク | アプロンブ1 | オムニジェヴ4B |
|---|---|---|
| テンプコンパス | 79.3 | 73.6 |
| Video-MME(短縮版) | 80.7 | 72.2 |
| NExT-QA | 82.6 | 79.8 |
私たち自身がAplomb 1に音声を追加しました。上記の他の意思決定モデルはこれを受け入れていません。音声や音声に最も強力です。環境音や音声に関するオープンエンドの質問はより難しいです:
| ベンチマーク | アプロンブ1 |
|---|---|
| ボーカルサウンド(ボーカルサウンド) | 90.0 |
| CREMA-D(発話中の感情) | 65.0 |
| ESC-50(環境音) | 8.4 |
| MMAU(音声質問) | 49.1 |
| MMSU(話し言葉) | 43.3 |
51言語
Aplomb 1は英語だけでなく多くの言語のテキストを決定します。MASSIVEでは、音声アシスタントへの各リクエストは51言語のいずれかで書かれ、質問と59の意図ラベルは英語のままです。MASSIVEでのトレーニングがない場合、Aplomb 1は51言語すべてで平均75.0%、英語で91.0%、39言語で70%以上を挙げています。
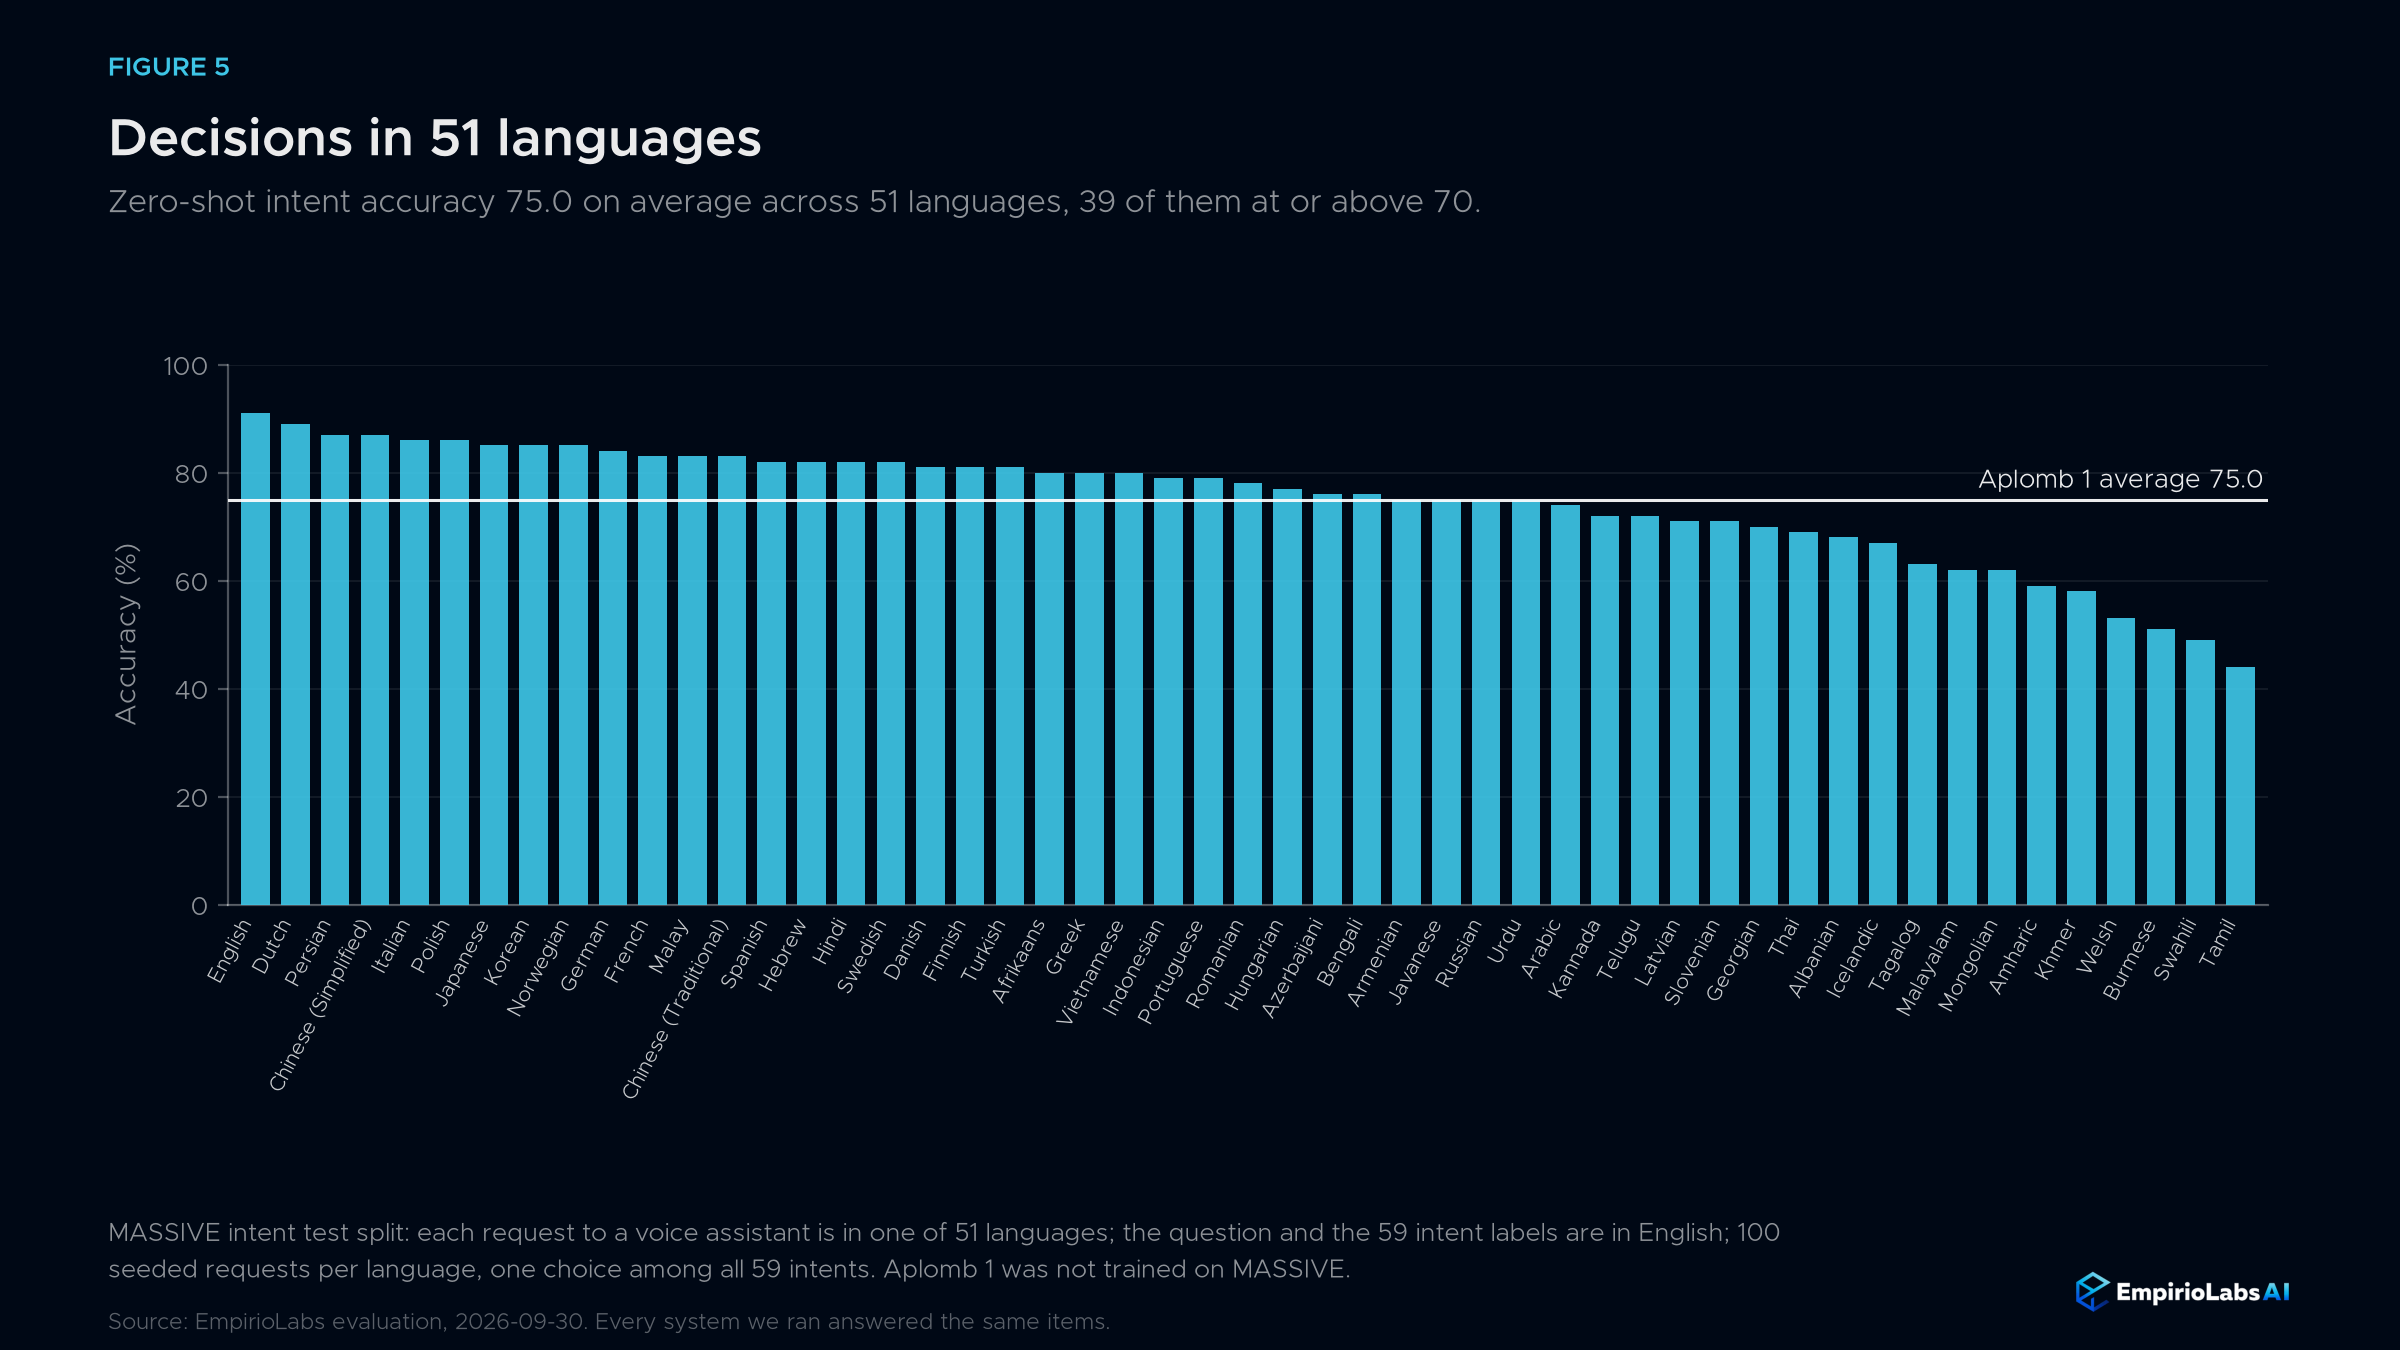
参考までに、Layaプロジェクトは同じ51言語で20の意図から選択した場合、多言語モデルが40.1%、JevK5プロジェクトは英語で60以上の意図を選んだ場合に73.8%と報告しています。
意思決定指数
Decision Index 0.2.1は、知識と推論、言語理解、検索と分類、ツールと自動化、芸術と人間の好みの5つの分野で38の公開ベンチマークを平均しています。各ベンチマークは偶然補正されており、0はランダムな推測、100は完璧を意味します。
2026年10月5日にAplomb 1で公式キットを使用し、150,317件のスコア可能なリクエストすべてに回答しました。Aplomb 1のスコアは44.86です。これは公開ボードのエントリーではなく、私たち自身のキットのランです。
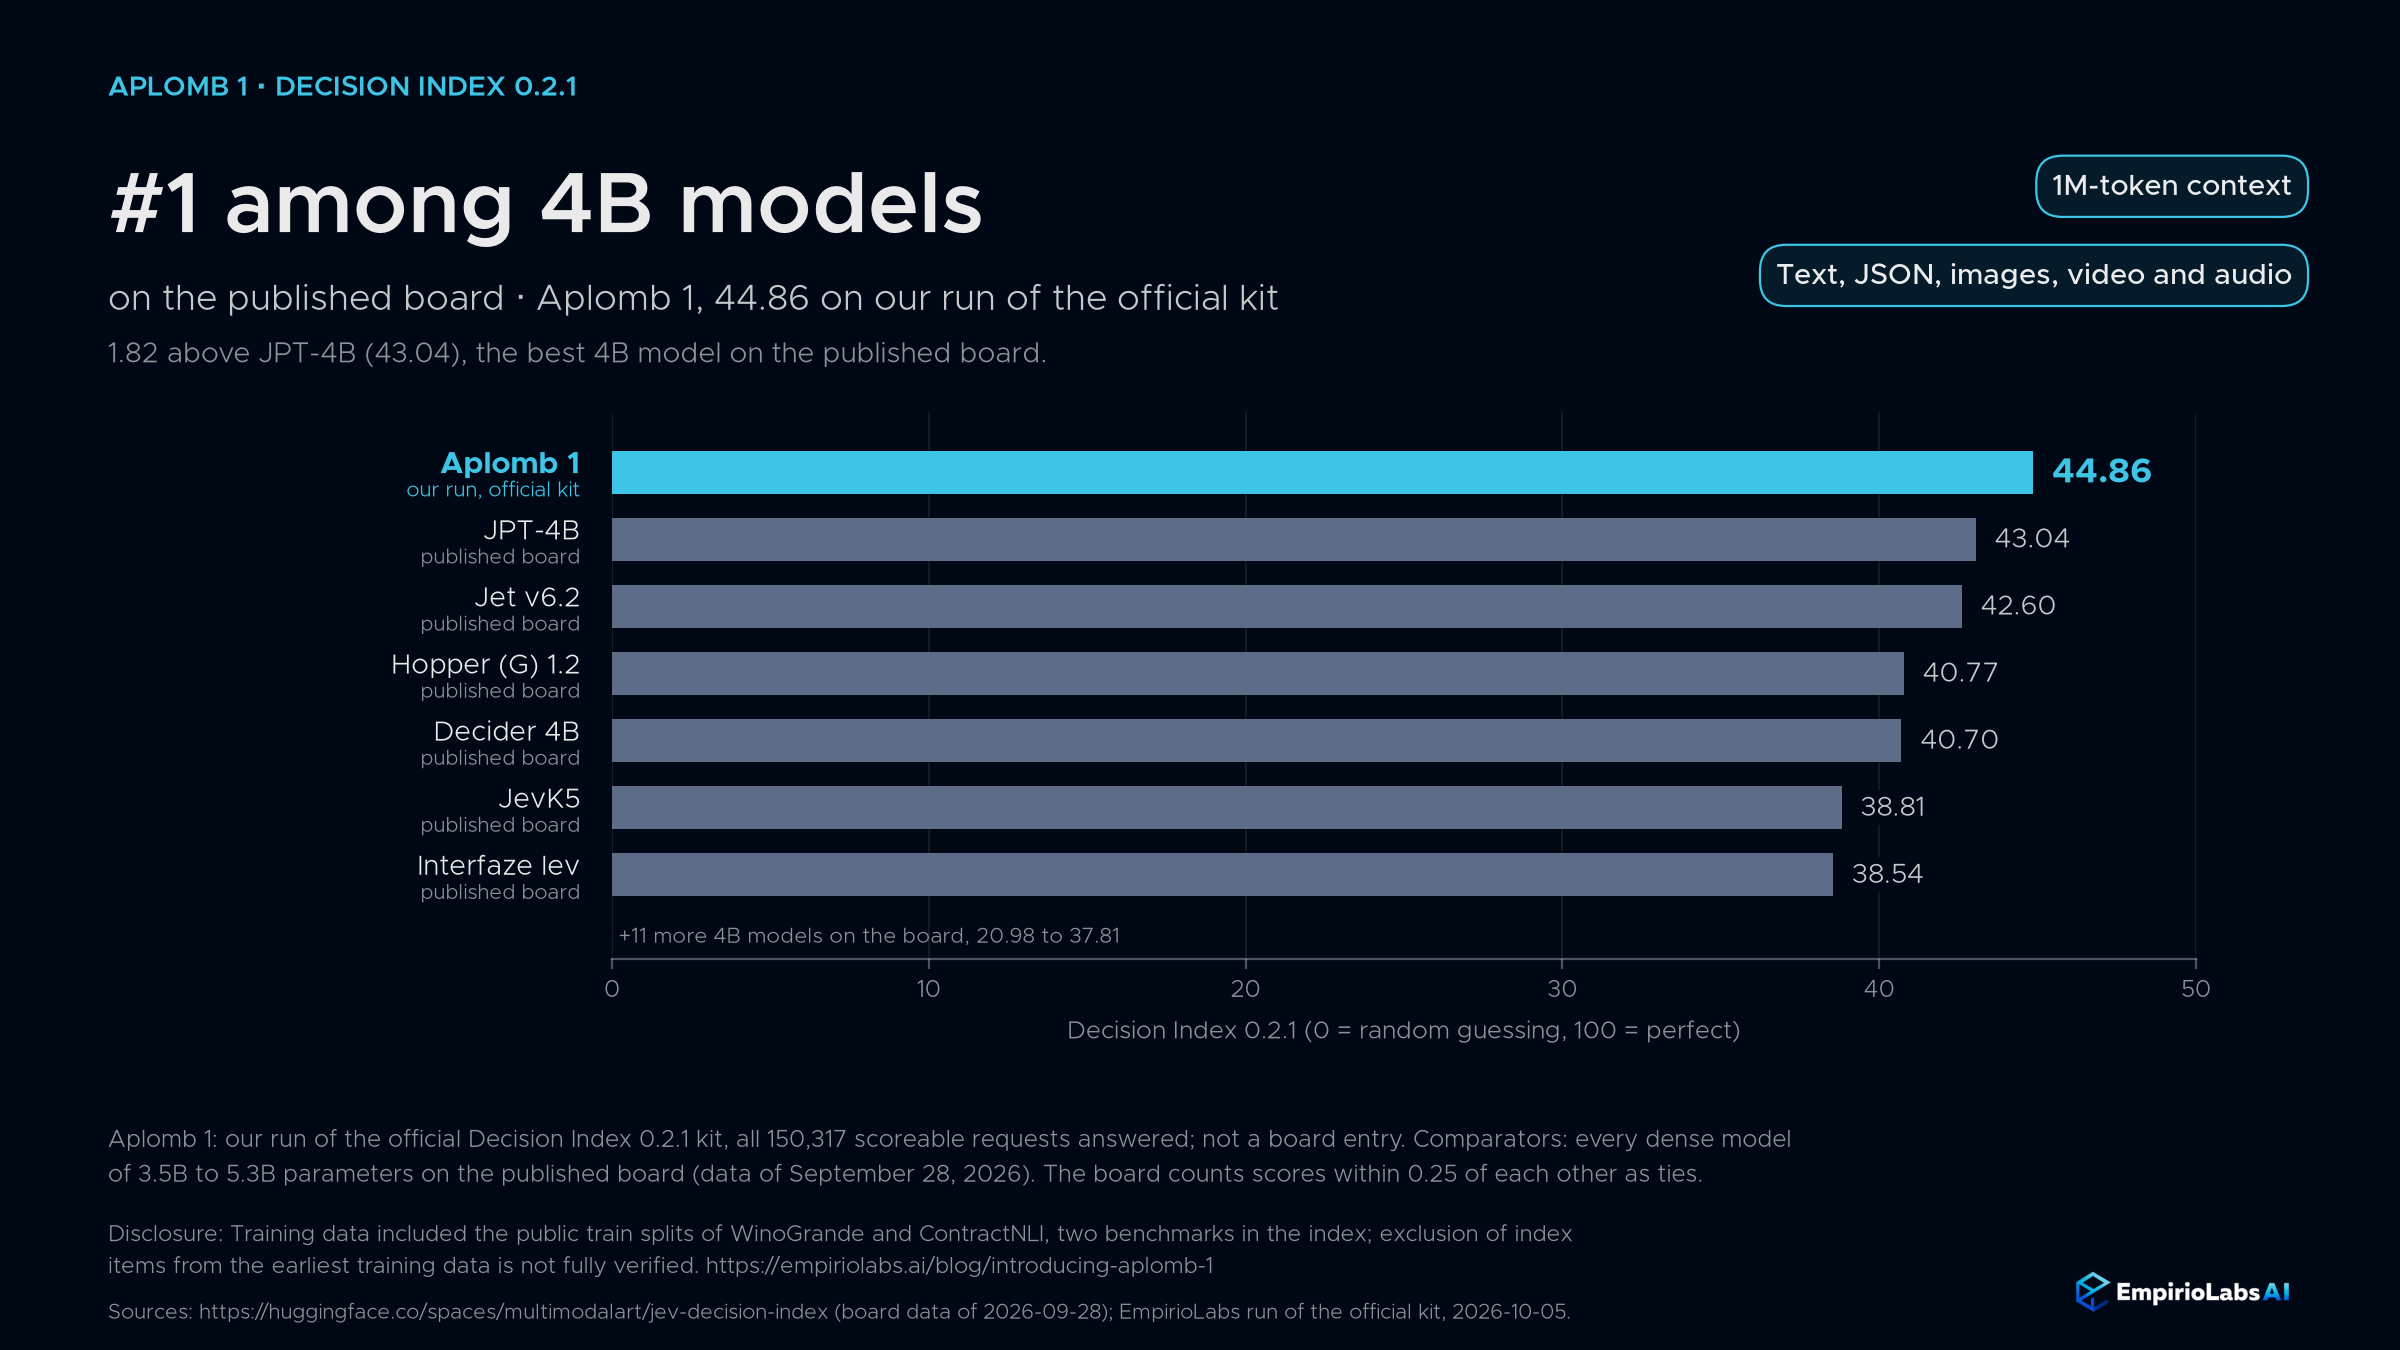
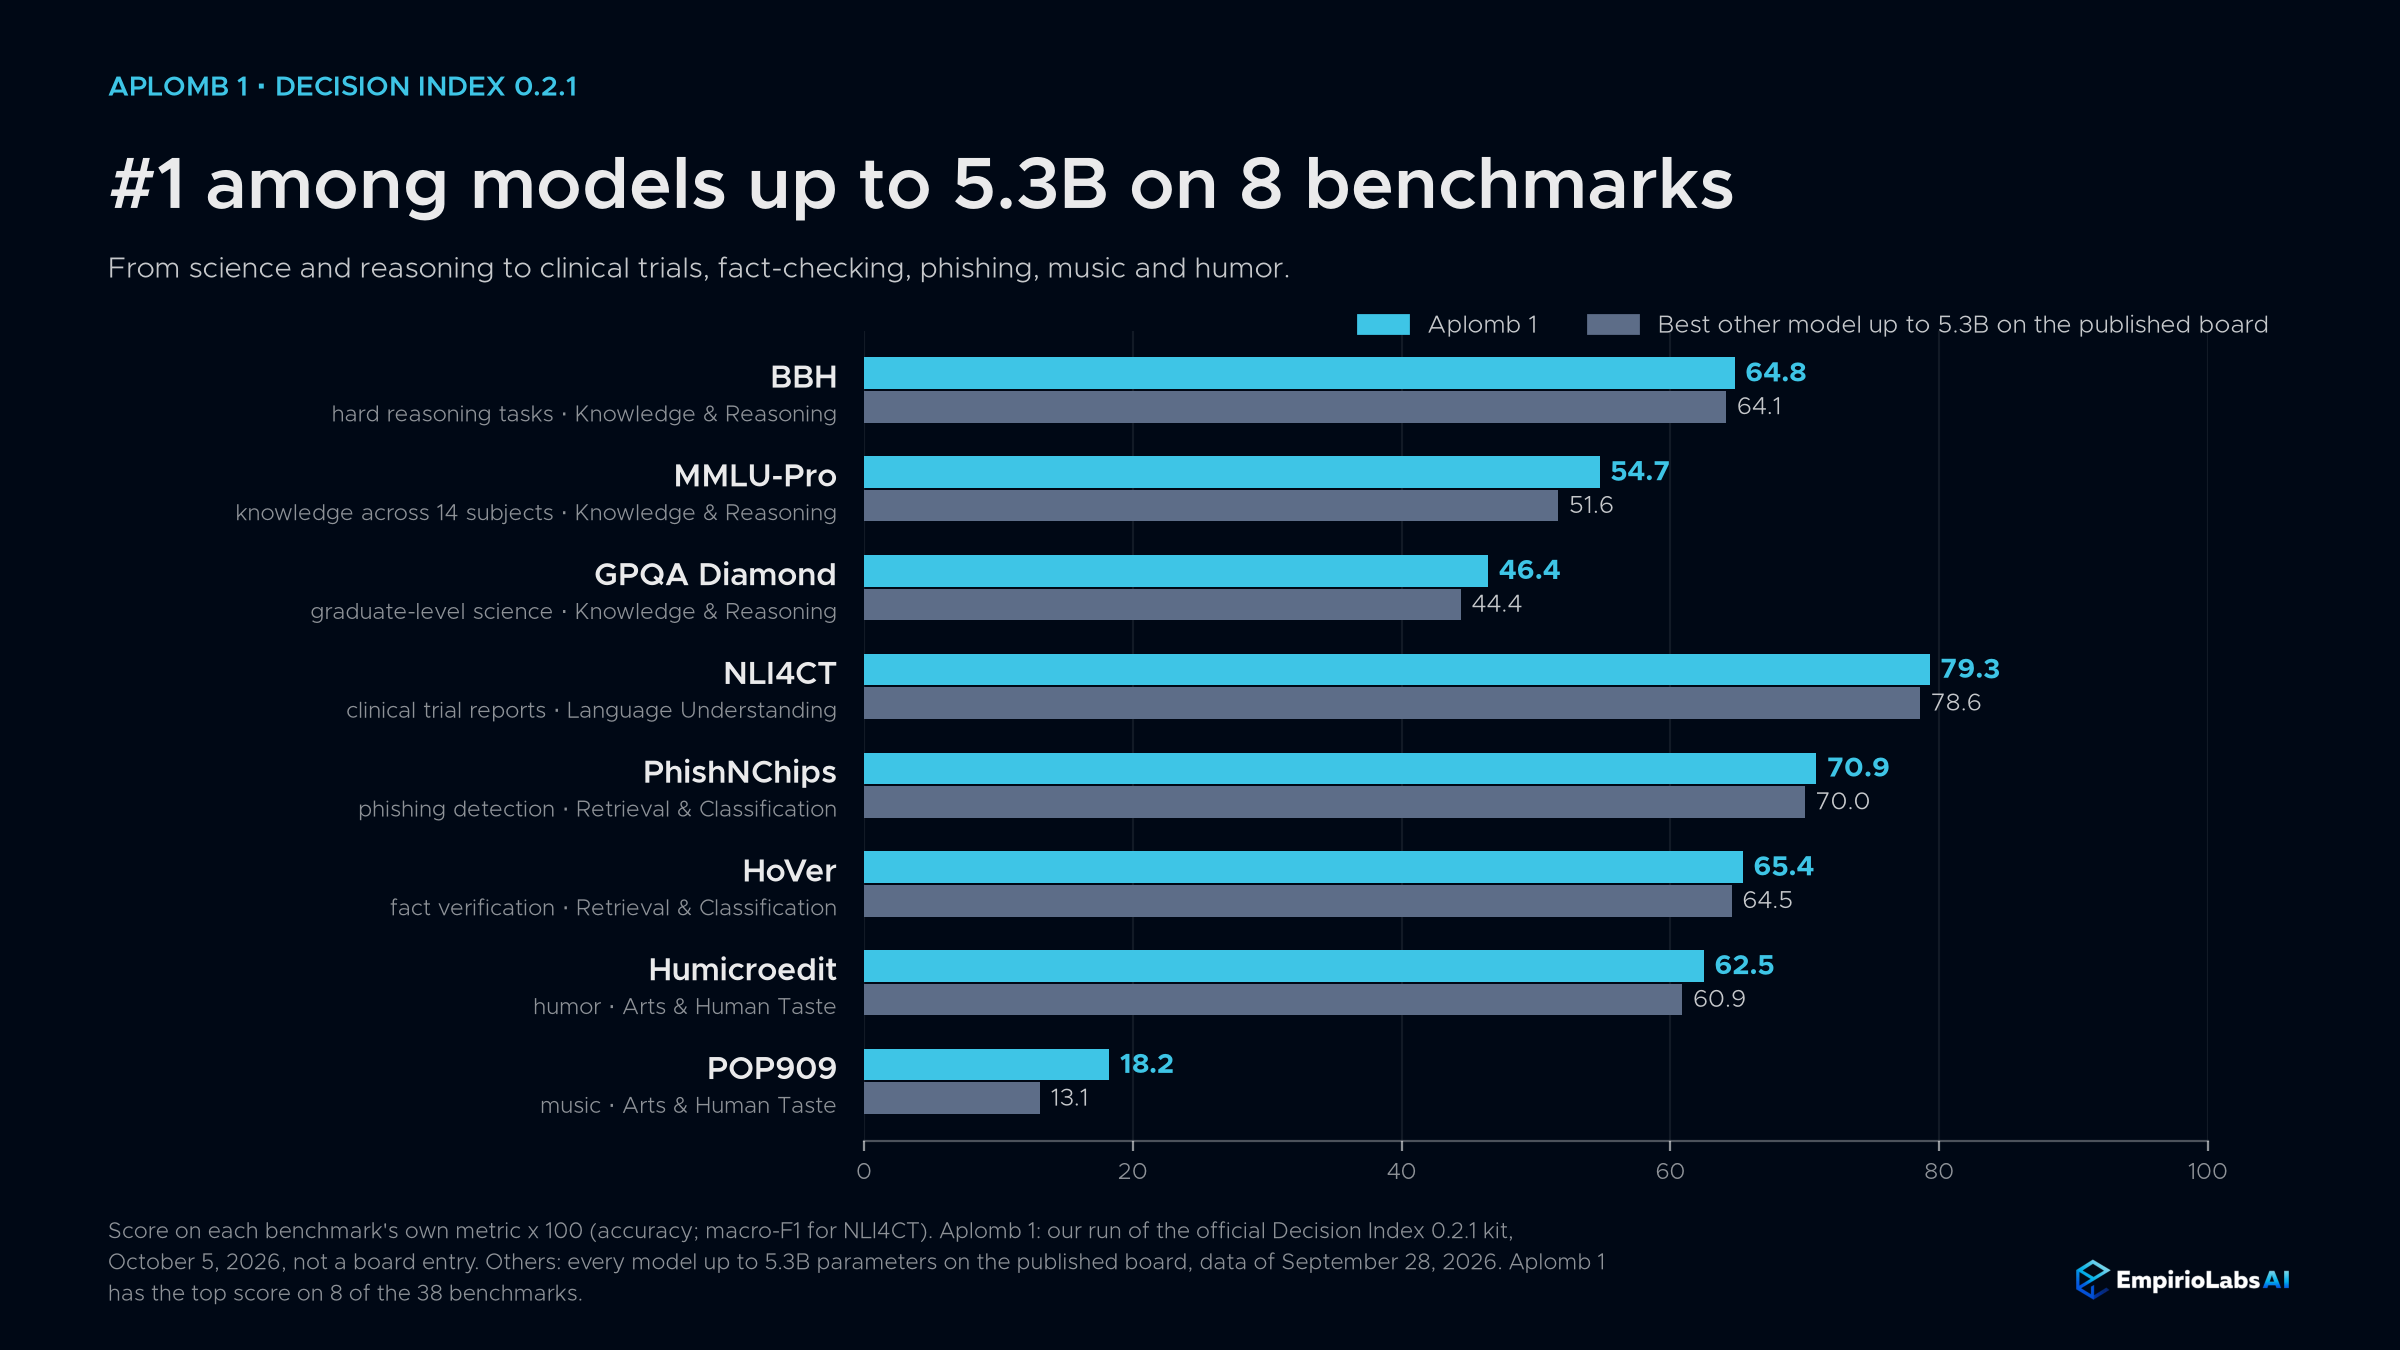
2026年10月6日時点で、Aplomb 1は公開されたボードの4Bモデルの中で#1位、38ベンチマークのうち8つのベンチマーク(MMLU-Pro、GPQA Diamond、BBH)で53億パラメータ以下のモデルで#1位です。公開されたボード(2026年9月28日のデータ)では、4Bモデルの最高スコアはJPT-4Bの43.04で、Aplomb 1より1.82下位です。
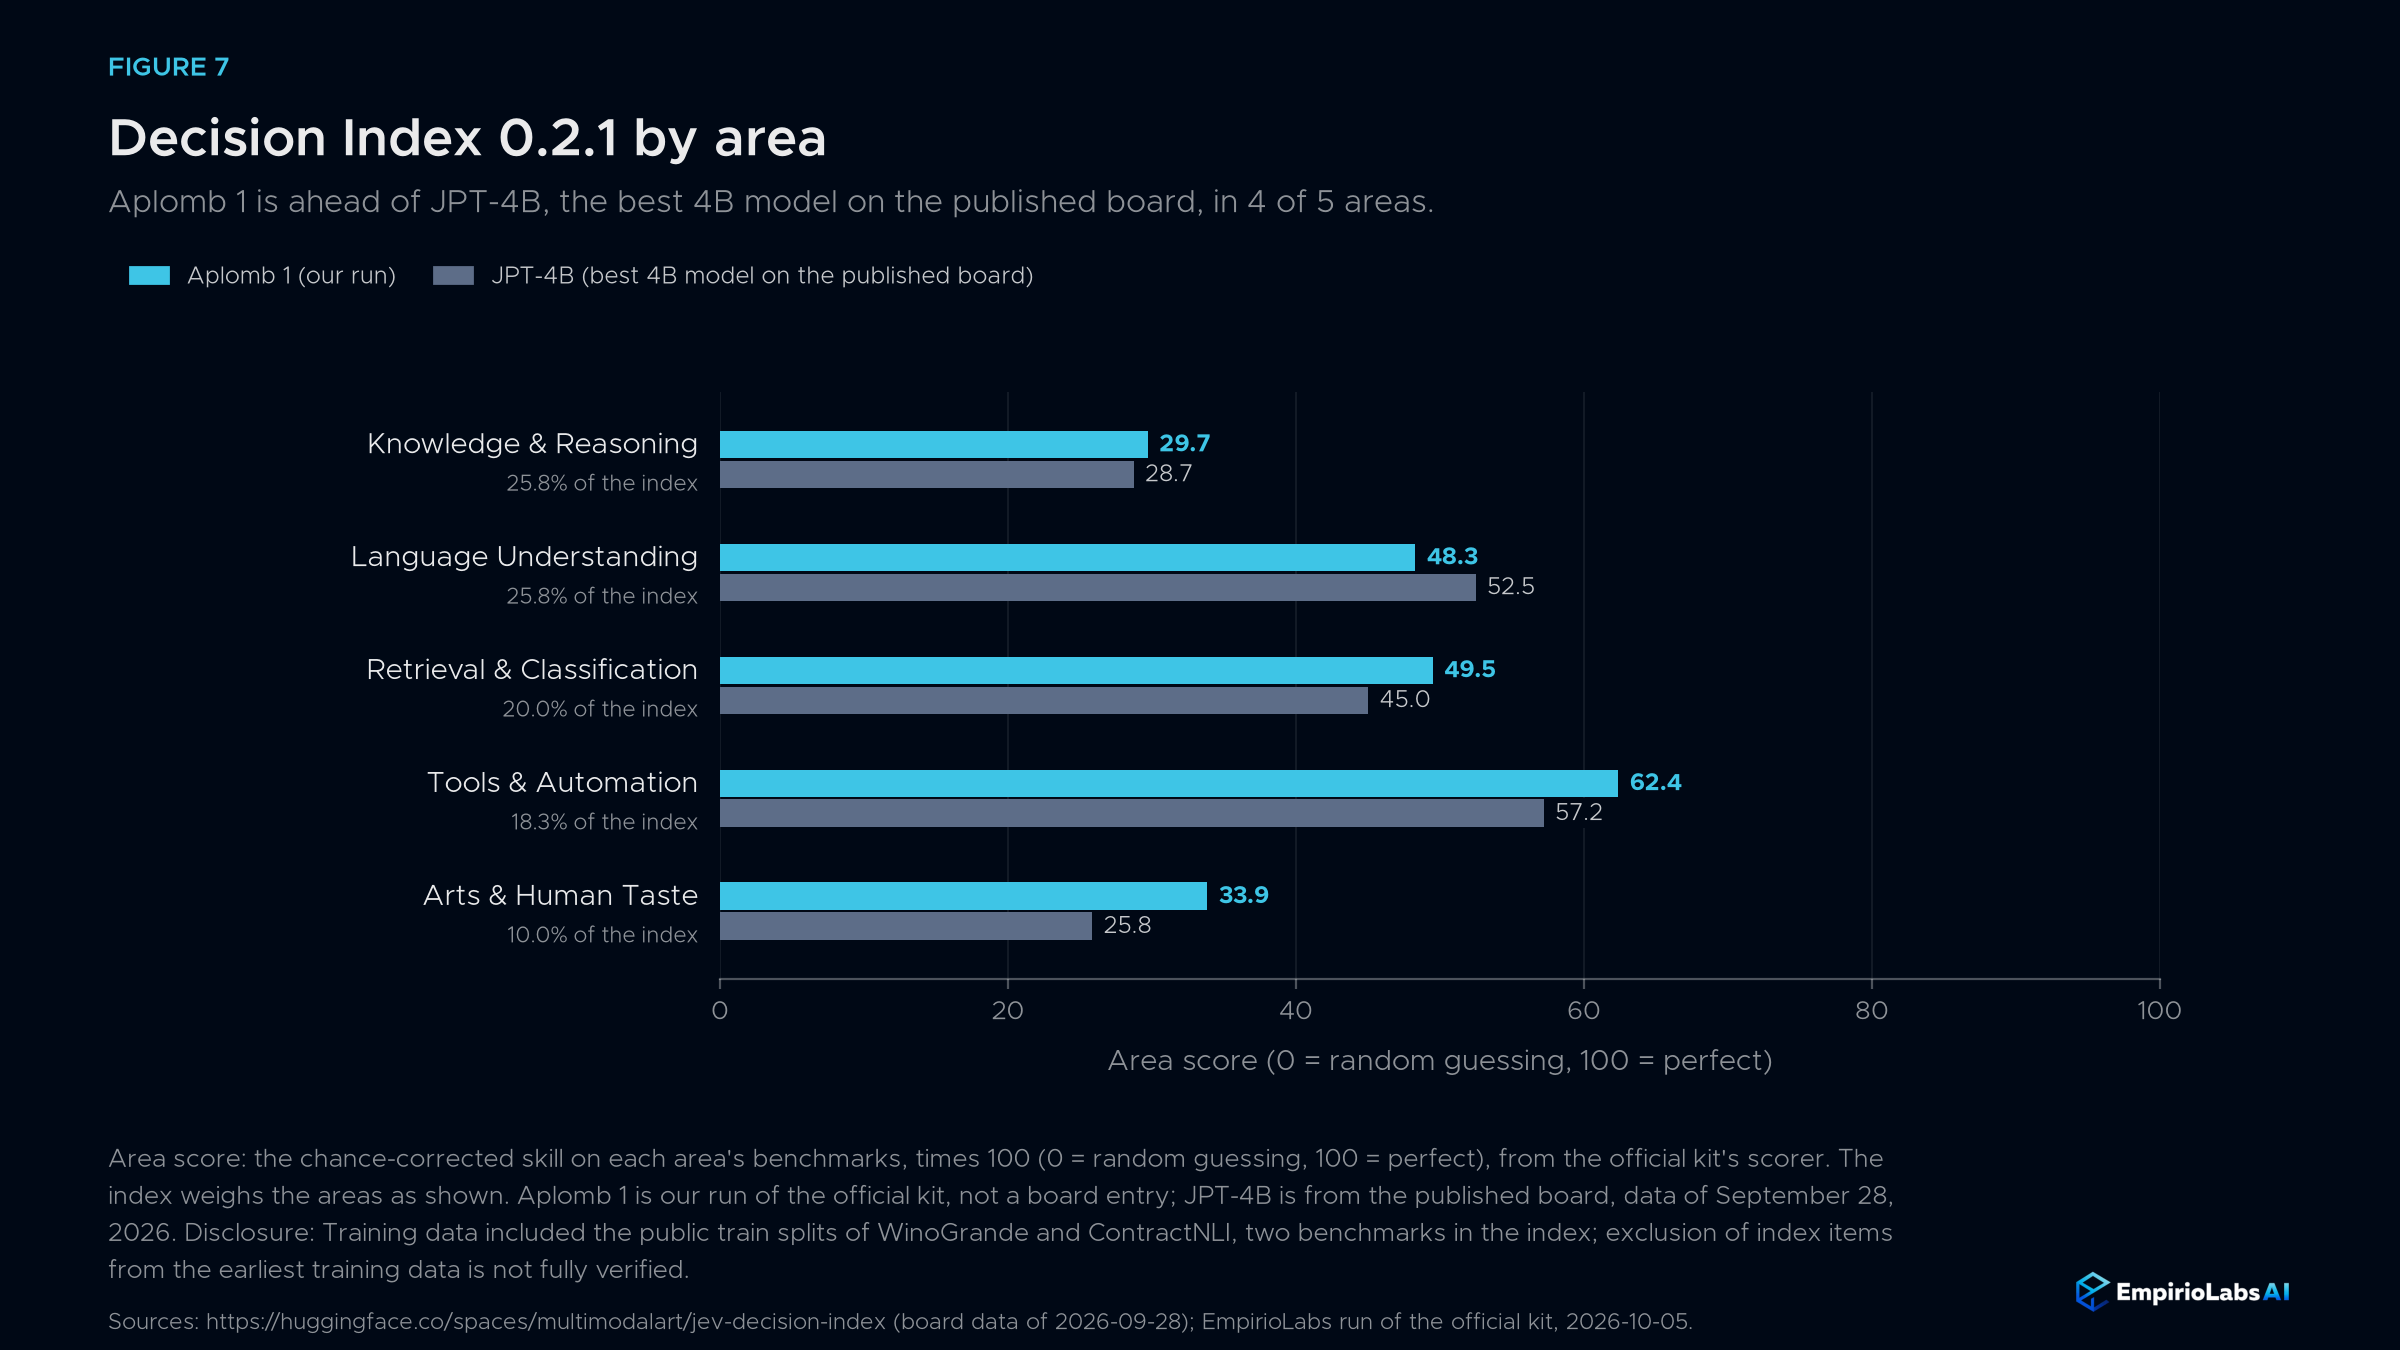
分野別では、Aplomb 1はツールと自動化(62.4)、検索・分類(49.5)で最高得点を獲得しています。JPT-4Bと比べると、5つの分野のうち4つで上位、言語理解では遅れをとっています(48.3点対52.5点)。
開示。 Aplomb 1のトレーニングデータには、指数内の38ベンチマークのうち2つであるWinoGrandeとContractNLIの公開列車分割が含まれていました。インデックス項目が最も初期のトレーニングデータから除外されていることを完全には検証できませんでした。
比較
各意思決定モデルまたはAPIが受け入れ、回答する内容は、2026年9月29日時点での公式ドキュメントおよび2026年10月6日時点の価格から示されています:
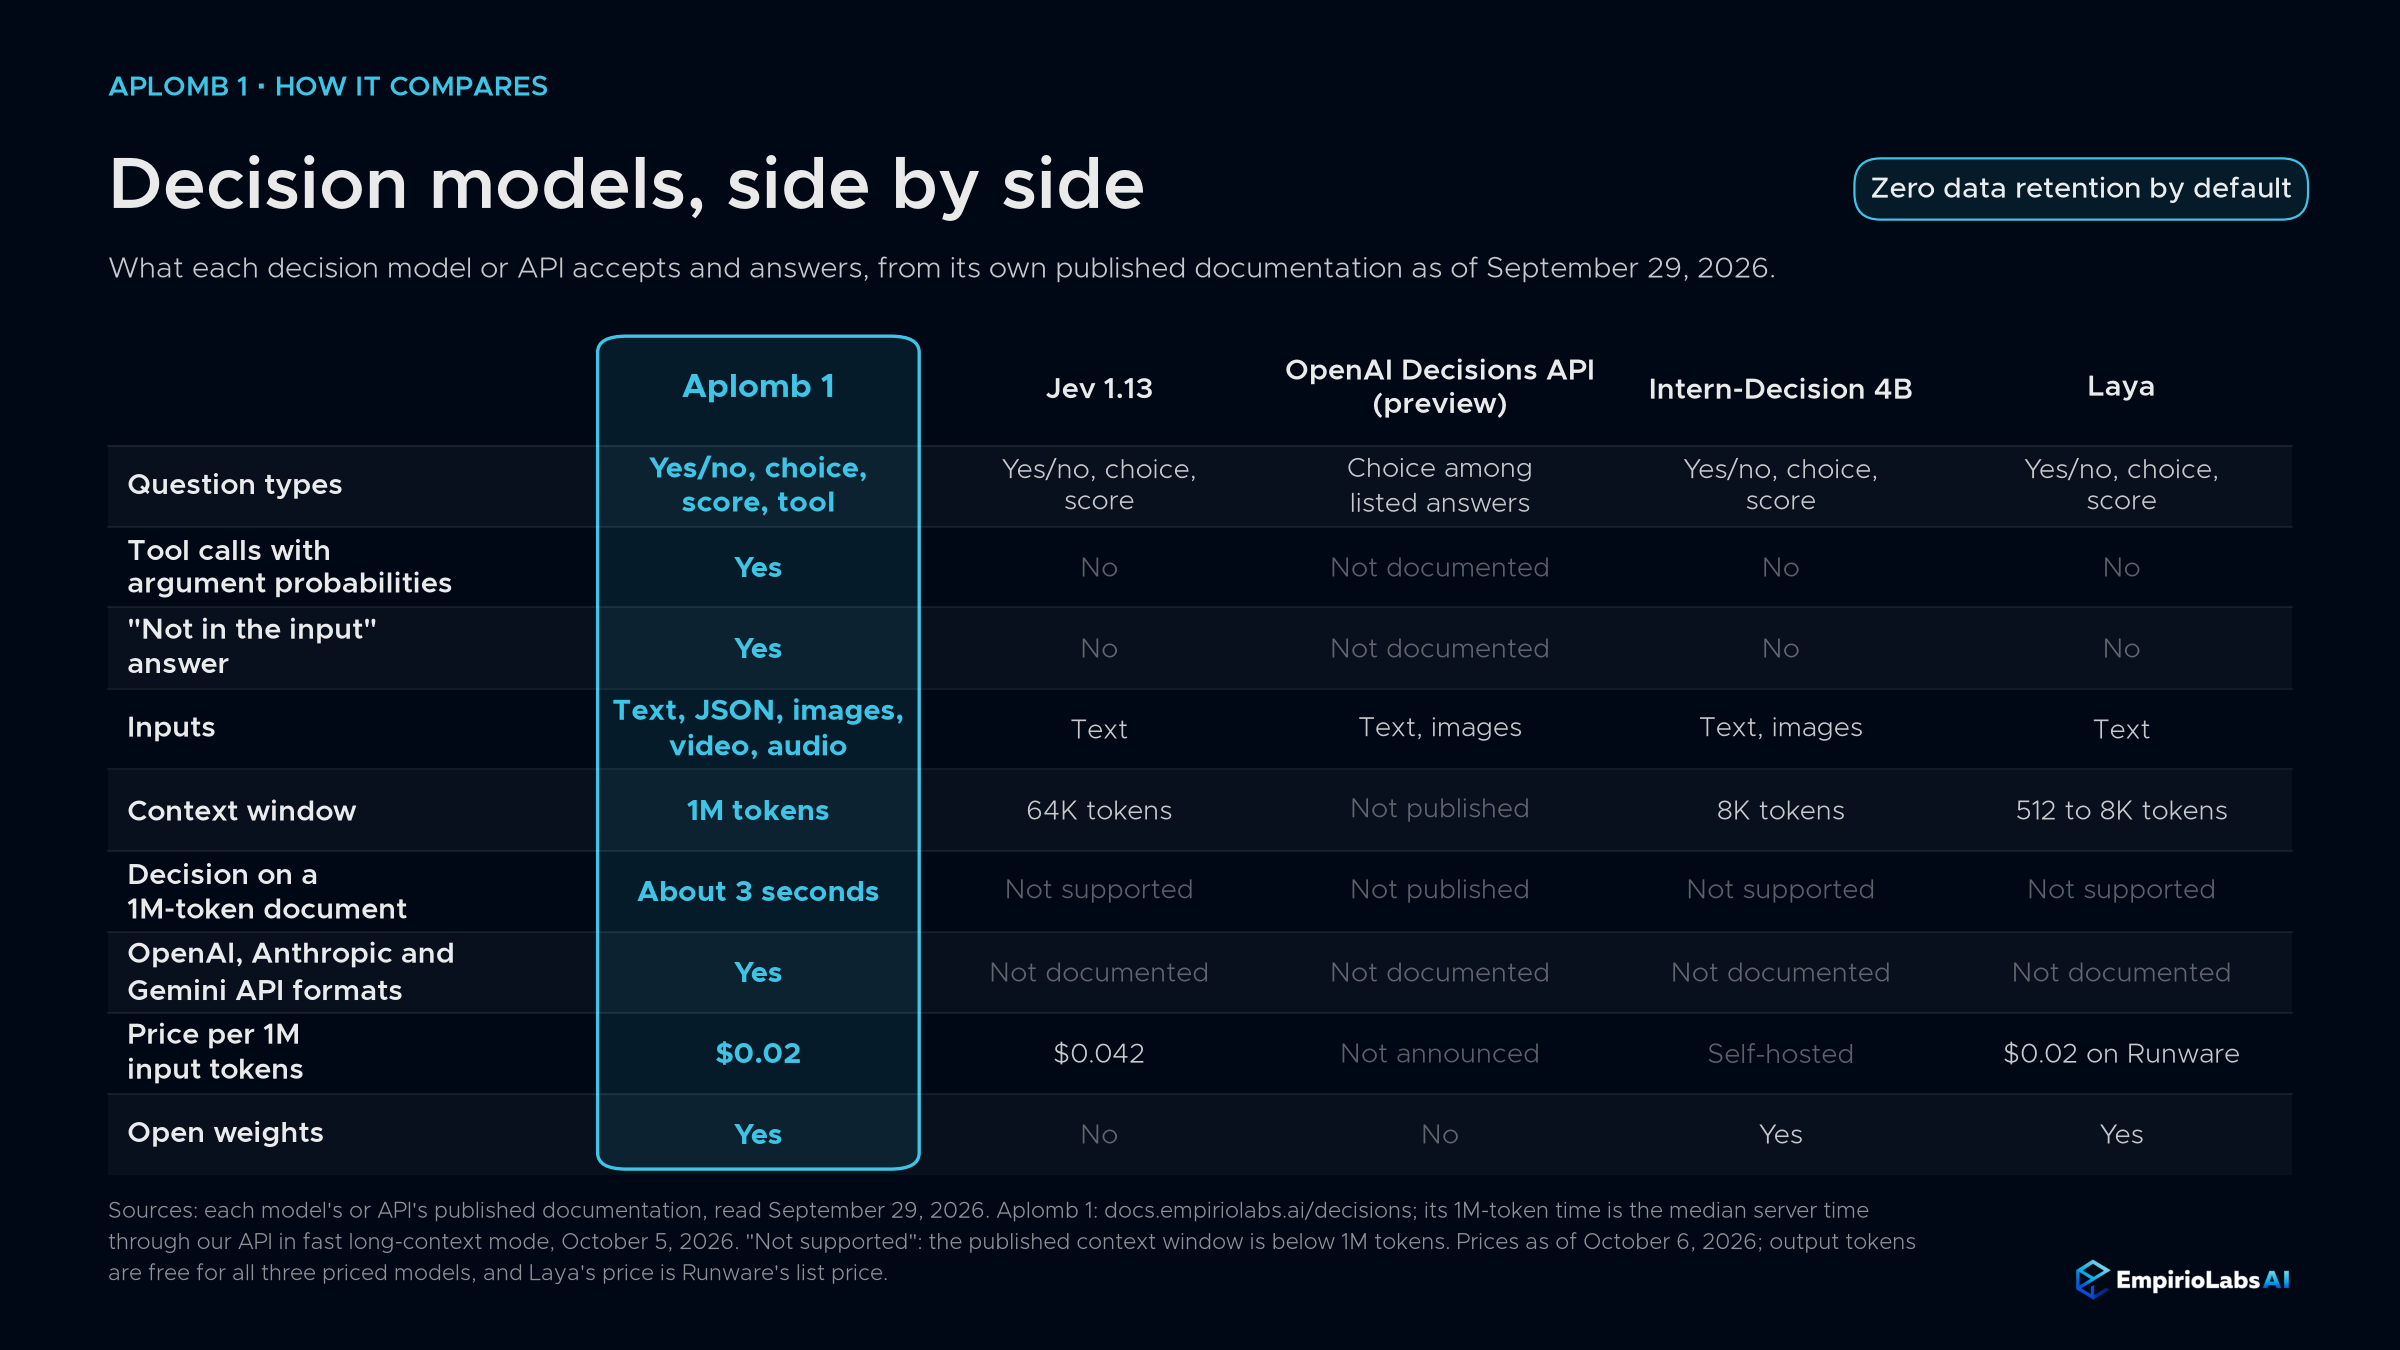
| アプロンブ1 | ジェヴ 1.13 | OpenAI Decisions API(プレビュー版) | インターン決定4B | ラヤ | |
|---|---|---|---|---|---|
| 問題の種類 | はいかいいえか、選択、スコア、ツール | はいかいいえか、選択、スコア | リストされた回答の中から選択 | はいかいいえか、選択、スコア | はいかいいえか、選択、スコア |
| 引数確率を用いた道具選択 | はい | いいえ | 記録されていません | いいえ | いいえ |
| 州の回答にはそうではありません | はい | いいえ | 記録されていません | いいえ | いいえ |
| 入力 | テキスト、JSON、画像、動画、音声 | 本文 | テキスト、画像 | テキスト、画像 | 本文 |
| 窓 | 1,000,000トークン | 64Kトークン | 未発表 | 8,192トークン | 512トークンから8,192トークン |
| 100万個入力トークンあたりの価格 | $0.02 | $0.042 | 発表されていません | セルフホスト | $0.02 Runwareについて |
| オープンウェイト | はい | いいえ | いいえ | はい | はい |
速度と請求
Aplomb 1は意思決定モデルのEmpirioLabs自身の推論ランタイム上で動作します。短い質問は約15msのモデル時間、画像を含む質問は約35ms、15,000トークンのドキュメントは約0.3秒、1Mトークンの状態は高速長コンテキストモードで約3秒、デフォルトは131,072トークンを超えると約111秒の読み込み時間です。
入力トークンに対してのみ料金を支払います。リクエストごとに状態を1回、各質問のテキストに対して支払い、プロンプトテンプレートは一切支払いません。出力トークンは常にゼロです。現在のレートは モデルページ そして、 プライシングページお問い合わせ.
デフォルトでゼロデータ保持は有効です。リクエストや回答の内容は保持しません。
オープンウェイト
Aplomb 1はQwen3.5-4Bに基づいて構築されています。ウィンドウを262Kから1Mトークンに拡張し、Qwen3-Omniのオーディオエンコーダによるオーディオ入力を追加し、生成されたテキストではなくキャリブレーション済みの確率としてすべての回答を返す独自の意思決定ヘッドを追加し、ツール選択やnot-in-the-input回答を含む意思決定モデルの訓練を行いました。APIとPlaygroundについては、独自の推論ランタイムを構築し最適化しました。
重みと自分で実行するためのリファレンススクリプトは以下の通りです huggingface.co/empiriolabsai/aplomb-1.スクリプトの回答はAPIのものと少し異なる場合があります。
年間収益がUS$1百万ドル未満の組織による研究、評価、個人利用および社内利用はEmpirioLabsモデルライセンスの下で無料です。Aplomb 1をサービスとしてホスティングしたり、他者に販売された製品で出荷する場合は商用ライセンスが必要です。
スタート
curl https://api.empiriolabs.ai/v1/decisions \ -h 「認可:ベアラー $EMPIRIOLABS_API_KEY」 \ -H 「Content-Type: application/json」 \ -d '{ 「model」: "aplomb-1", "state": {"order": {"id": "B-44120", "status": "発送", "payment": "unpaid"}}, "questions": { "payed": {"type": "noul", "instructions": "orders b-44120 は支払われましたか?", "abstain": true}, "carrier": {"type": "choice", "instructions": "どの運送業者が注文B-44120を配達していますか?", "criteria": {"ups": null, "fedex": null, "dhl": null}, "abstain": true} } }'支払い 自信満々にノーと返ってきました。 キャリア 高揚感を持って戻ってきます 棄権 確率は、レコードにキャリアの名前が記載されていないためです。完全なスキーマ、メディア入力、制限は Decisions APIガイド.Aplomb 1はOpenAI、Anthropic、Gemini形式でもリクエストを受け付けているので、SDKから呼び出すこともできます。ガイドの チャット形式 このセクションではチャットリクエストが決定にどのように対応するかを示しています。コードなしで試してみてください。 プレイグラウンドお問い合わせ.
謝辞
私たちは、データ、トレーニング、評価、展開にわたりAIエージェントハーネスの助けを借りてAplomb 1を構築しました。QwenチームのQwen3.5およびQwen3-Omni(Aplomb 1が構築されているもの)、LambdaのGPUのトレーニングと提供、そしてNVIDIA Inceptionプログラム、Z.ai スタートアッププログラム、StepFunスタートアッププログラムのサポートに感謝します。