LightOnOCR-3 4B EmpirioLabs पर उपलब्ध है। यह लाइटऑन का दस्तावेज़ ओसीआर मॉडल है: एक पीडीएफ या एक छवि भेजें, और यह प्रत्येक पृष्ठ को मार्कडाउन के रूप में लौटाता है, पाठ को पढ़ने के क्रम में पाठ, शीर्षक, सूचियाँ, तालिकाएँ, LaTeX में गणित, और चार्ट उनके डेटा बिंदुओं की तालिकाओं के रूप में। प्रत्येक पृष्ठ अपने लेआउट के साथ भी वापस आता है: पृष्ठ पर प्रत्येक ब्लॉक का प्रकार और स्थिति। यह चालू रहता है पोस्ट /v1/ocr, एपीआई में और Playground में।
कसौटी। LightOn ने LightOnOCR-86.3B के लिए 3 4B का समग्र olmOCR-बेंच स्कोर रिपोर्ट किया है रिलीज की घोषणा 8 अक्टूबर, 2026 का।
यह क्या पढ़ता है
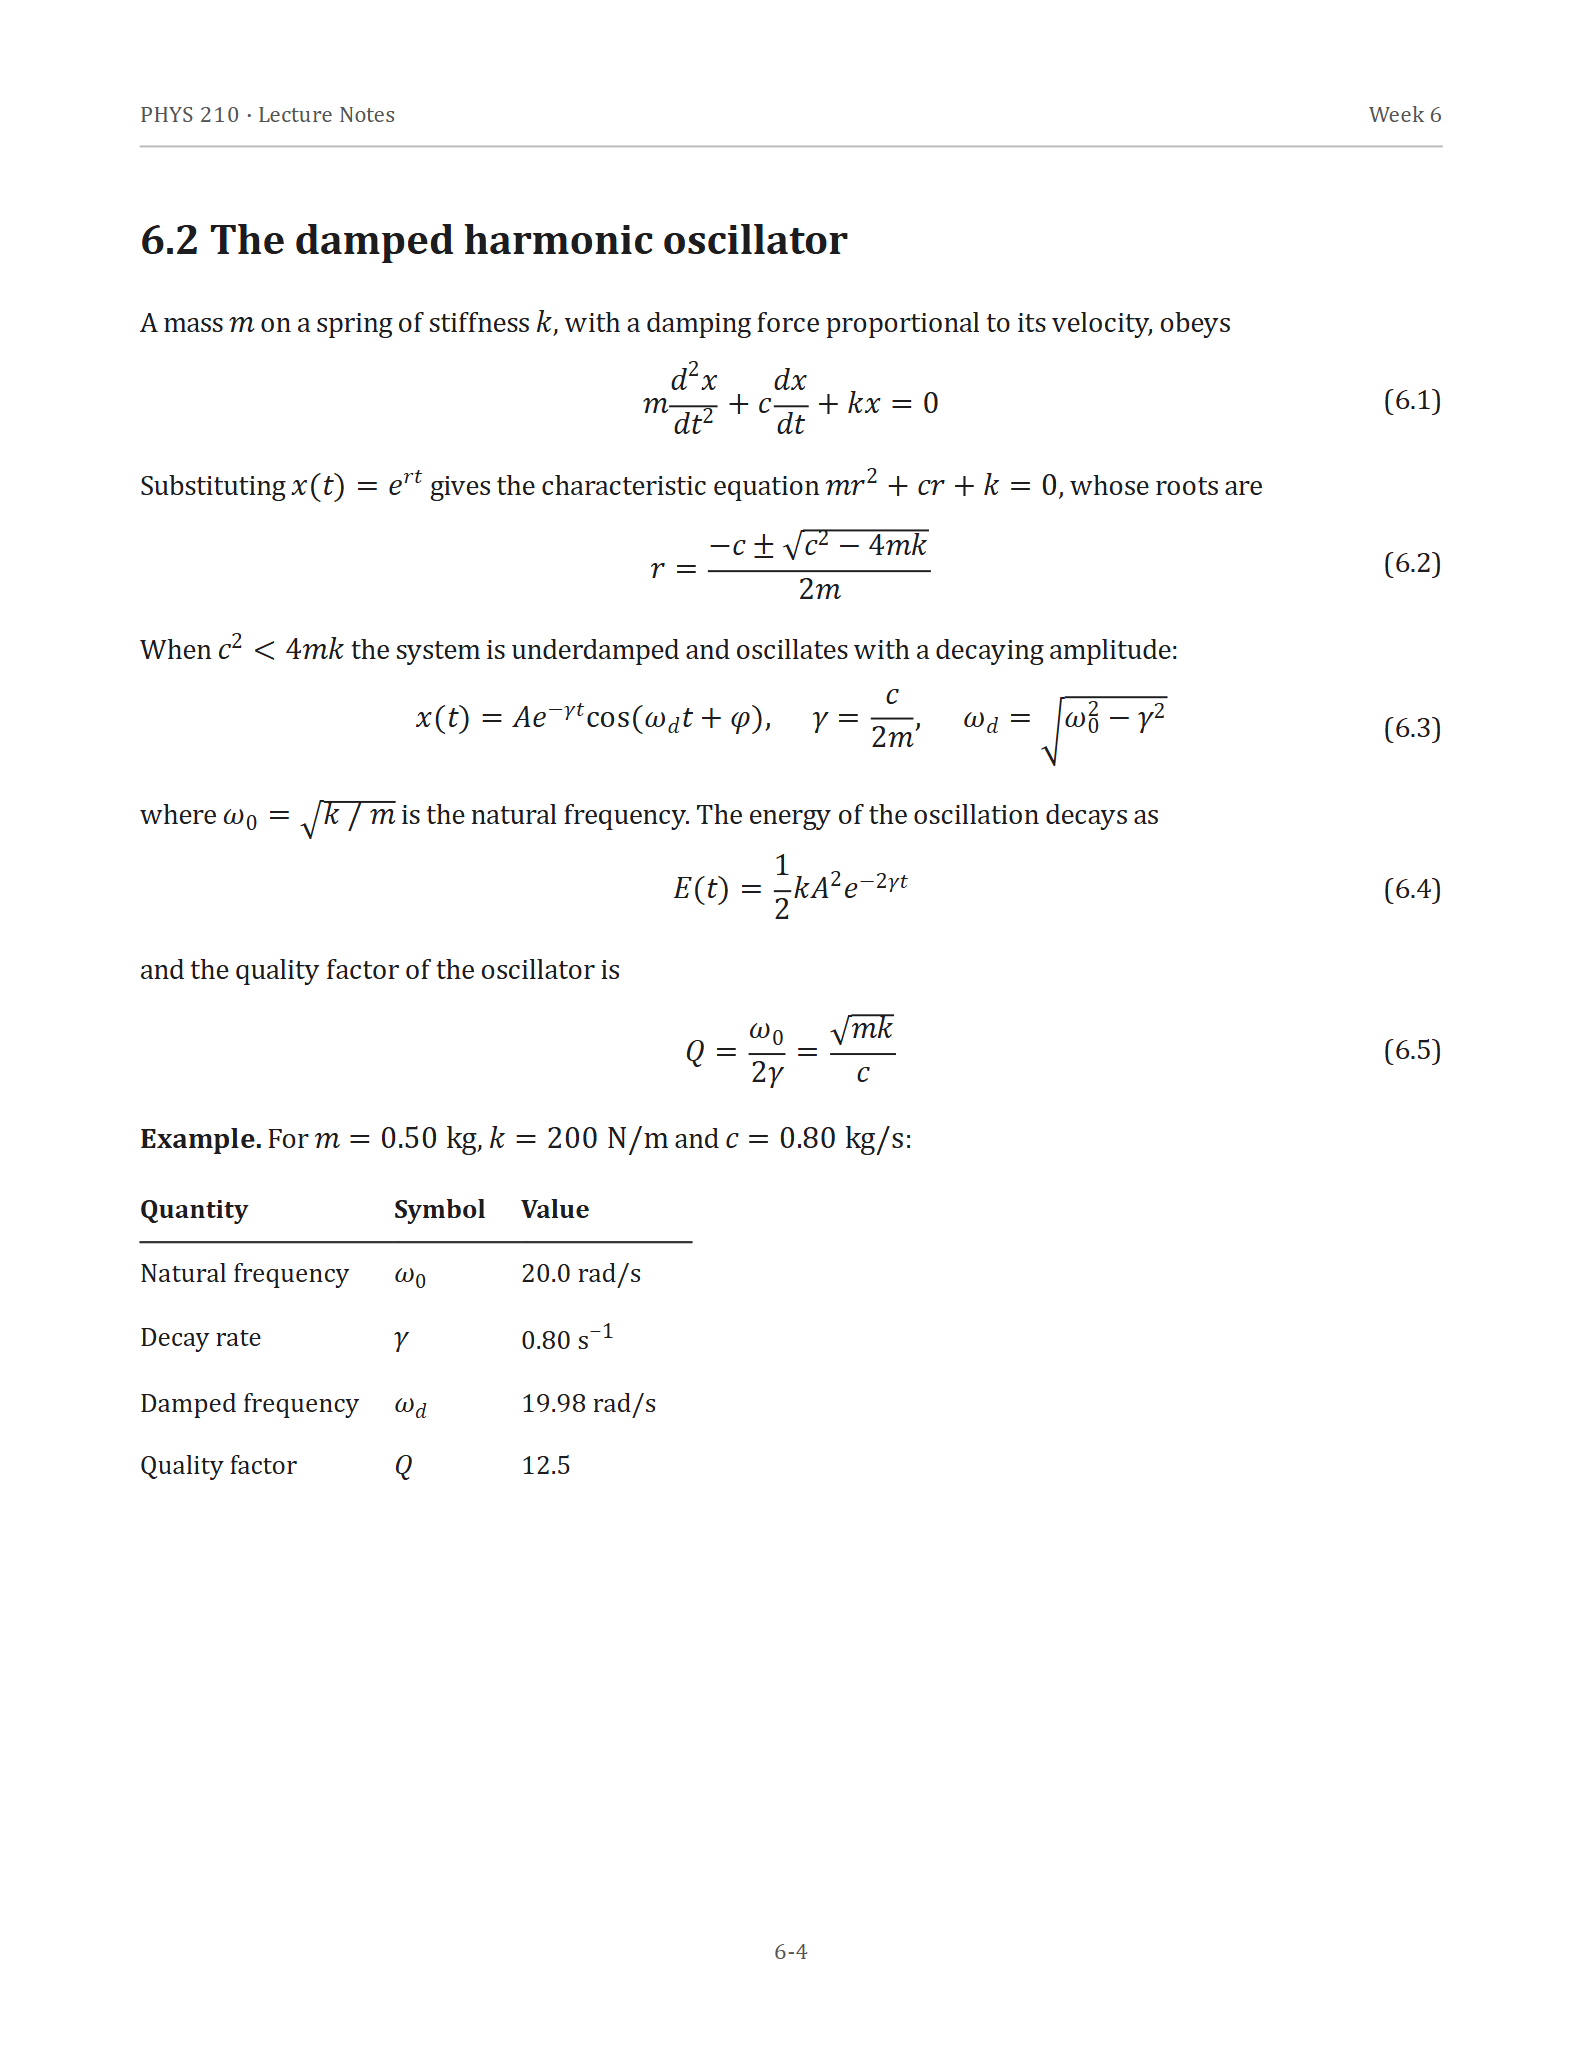
व्याख्यान नोट्स का एक परीक्षण पृष्ठ, एक अनुरोध में पढ़ा जाता है। यह पृष्ठ और तीन दृष्टि चैट मॉडल के खिलाफ दो और में हैं LightOnOCR-3 4B बनाम Qwen3.5 4B बनाम जेम्मा 4 26B-A4B बनाम मिस्ट्रल स्मॉल 3.1।.
मार्कडाउन की शुरुआत यह उस पृष्ठ के लिए वापस आ गया; अन्य तीन समीकरण, तालिका और पृष्ठ संख्या एक ही प्रतिक्रिया में अनुसरण करते हैं:
भौतिक विज्ञान 210 · व्याख्यान नोट्स सप्ताह 6 ## 6.2 नम हार्मोनिक ऑसिलेटर एक द्रव्यमान $m$ कठोरता के झरने पर $k$, अपने वेग के समानुपाती एक भिगोना बल के साथ, $$ m \frac{d^2 x}{dt^2} + c \frac{dx}{dt} + kx = 0 \quad \text{(6.1)} $$ $x(t) = e^{rt}$ को प्रतिस्थापित करने से विशेषता समीकरण मिलता है $mr^2 + cr + k = 0$, जिसकी जड़ें $$ r = \frac{-c \pm \sqrt{c^2 - 4mk}}{2m} \quad \text{(6.2)} $$ हैंआपका पहला अनुरोध
URL द्वारा या आधार 64 डेटा URI के रूप में दस्तावेज़ भेजें। यह अनुरोध नमूना PDF के पहले दो पृष्ठों को पढ़ता है:
कर्ल https://api.empiriolabs.ai/v1/ocr \ -एच "प्राधिकरण: वाहक $EMPIRIOLABS_एपीआई_की" \ -एच "सामग्री-प्रकार: application/json" \ -डी '{ "मॉडल": "lightonocr-3-4b", "दस्तावेज़": { "प्रकार": "document_url", "document_url": "https://media.empiriolabs.ai/assets/blog-images/lightonocr-3-4b-test-2026-10-25/sample-document.pdf" }, "पृष्ठ": [0, 1] }'आपकी मशीन पर एक फ़ाइल डेटा यूआरआई के रूप में जाती है, जिसमें किसी होस्टिंग की आवश्यकता नहीं होती है:
आयात base64 आयात OS आयात अनुरोधों को खुले ("report.pdf", "rb") के साथ हैंडल के रूप में: एन्कोडेड = base64.b64encode(handle.read()).decode() प्रतिक्रिया = requests.post("https://api.empiriolabs.ai/v1/ocr", हेडर = {"प्राधिकरण": f"Bearer {os.environ['EMPIRIOLABS_API_KEY']}"}, json={ "model": "lightonocr-3-4b", "दस्तावेज़": {"प्रकार": "document_url", "document_url": f"data:application/pdf; base64,{encoded}"}, }, timeout=300,) response.raise_for_status() response.json()["page"]: print(f"--- page {page['index']} ---") print(page["markdown"])एक छवि उसी तरह काम करती है, साथ "प्रकार": "image_url" और URL या डेटा URI image_url. एक दस्तावेज़ एक पीडीएफ या एक पीएनजी, जेपीईजी, वेबपी, टीआईएफएफ, बीएमपी, जीआईएफ या एवीआईएफ छवि 50 एमबी तक हो सकता है, और एक अनुरोध 1,000 पृष्ठों तक पढ़ता है।
क्या वापस आता है
प्रतिक्रिया प्रति पृष्ठ एक ऑब्जेक्ट रखती है पृष्ठों. प्रत्येक के पास पृष्ठ के रूप में है मार्कडाउन; ब्लॉक, पृष्ठ के प्रत्येक क्षेत्र को उसके प्रकार के साथ पढ़ने के क्रम में (शीर्षक, टेक्स्ट, तालिका, सारणी, समीकरण, अनुशीर्षक, शीर्ष लेख, पाद लेख, और अन्य) और पिक्सेल में इसका बॉक्स; छवियां, छवि क्षेत्र; तथा आयाम, पृष्ठ छवि का आकार जिसे बॉक्स संदर्भित करते हैं। usage_info.pages_processed पढ़े गए पृष्ठों की गणना करता है। व्याख्यान-नोट्स पृष्ठ के लिए लौटाए गए 16 ब्लॉकों में से एक:
{ "प्रकार": "समीकरण", "top_left_x": 641, "top_left_y": 526, "bottom_right_x": 1447, "bottom_right_y": 610, "सामग्री": "$$\nr = \\frac{-c \\pm \\sqrt{c^2 - 4mk}}{2m} \\quad \\text{(6.2)}\n$$" }एक अनुरोध उत्तर देता है जब उसके पृष्ठ पढ़े जाते हैं। लगभग साढ़े चार मिनट के उत्तर के बाद भी एक चल रहा है 202 एक के साथ नौकरी id: पोल /v1/jobs/{job_id} जब तक स्थिति है पूरा, और पृष्ठ में हैं परिणाम. नौकरी आईडी एक बार में प्राप्त करने के लिए, हेडर भेजें पसंद: प्रतिक्रिया-async।.
विकल्प
- पन्ने।
पृष्ठोंशून्य-आधारित पृष्ठ संख्याओं को सूची के रूप में लेता है ([0, 2, 3]) या एक स्ट्रिंग ("0,2-4"). हर पृष्ठ को पढ़ने के लिए इसे छोड़ दें। - टेबल्स।
table_formatपर सेट करेंमार्कडाउनयाएचटीएमएलप्रत्येक तालिका को इसमें ले जाता हैटेबल्सउस प्रारूप में और एक लिंक छोड़ता है जैसे[tbl-0.html] (tbl-0.html)पेज में मार्कडाउन पर टैप करें. इसके बिना, टेबल मार्कडाउन में HTML के रूप में रहती हैं. - छवियां।
include_image_base64प्रत्येक छवि क्षेत्र को JPEG डेटा URI के रूप में लौटाता है।image_limitपूरे दस्तावेज़ के लिए कितनी छवियाँ वापस आती हैं, औरimage_min_sizeउन कई पिक्सेल की तुलना में संकरे या छोटे क्षेत्रों को छोड़ देता है। - हेडर और फुटर।
extract_headerतथाextract_footerउन्हें मार्कडाउन से बाहर निकालकर अपने खेतों में ले जाएं। - अभिन्यास।
include_blocksपर सेट करेंगलतरूपब्लॉकबाहर।
परिचालन नोट्स
- पृष्ठ संख्याएँ 0 से शुरू होती हैं।
"पन्ने": [1]दूसरा पृष्ठ पढ़ता है। - डॉलर के संकेत बचकर वापस आ सकते हैं। पृष्ठ पाठ में एक डॉलर चिह्न पढ़ सकता है
\$, और HTML तालिकाओं के अंदरऔर डॉलर;. मार्कडाउन को खोजने से पहले उसे अनएस्केप करें। - एनोटेशन फ़ील्ड को अस्वीकार कर दिया जाता है।
bbox_annotation_format,document_annotation_format, औरdocument_annotation_promptहल400किसी भी पेज को पढ़ने से पहले।
मूल्य निर्धारण
प्रति पृष्ठ पढ़ा गया बिल। प्रत्येक अनुरोध को कम से कम 5 पृष्ठों का बिल भेजा जाता है, इसलिए प्रति पृष्ठ एक अनुरोध के बजाय एक पीडीएफ के रूप में एक लंबा दस्तावेज़ भेजें। विफल होने वाले अनुरोध को उन पृष्ठों के लिए बिल नहीं किया जाता है जिन्हें वह वापस नहीं करता है। वर्तमान दरें इस पर हैं मॉडल पेज और मूल्य निर्धारण पृष्ठ।.
निर्माण शुरू करें
LightOnOCR-3 4B में प्रयास करें Playground अपने स्वयं के दस्तावेज़ के साथ, और पढ़ें दस्तावेज़ ओसीआर गाइड और एपीआई दस्तावेज़ीकरण प्रत्येक पैरामीटर के लिए।
प्रकटीकरण: यह लेख एआई सहायता के साथ लिखा गया था और EmpirioLabs AI द्वारा समीक्षा की गई थी।.