Aplomb 1 हमारा पहला मॉडल है। यह एक ही अनुरोध में टेक्स्ट, JSON, छवियां, ऑडियो और वीडियो लेता है, 1M टोकन तक पढ़ता है, और लगभग 3 सेकंड में 1M-टोकन दस्तावेज़ पर निर्णय लेता है। एक छोटे से प्रश्न में लगभग 15 एमएस मॉडल समय लगता है।
यह एक अनुमान रनटाइम पर चलता है जिसे हमने निर्णय मॉडल के लिए बनाया था। हमारे एपीआई पर और Playground में, लंबे दस्तावेज़ तेजी से लंबे-संदर्भ मोड से गुजरते हैं: 1 एम-टोकन दस्तावेज़ में 111 के बजाय लगभग 3 सेकंड लगते हैं, और फास्ट मोड ने हमारे लंबे संदर्भ वाले परीक्षणों में सभी 525 निर्णयों का सही उत्तर दिया।
एजेंटों के लिए, Aplomb 1 प्रत्येक उपकरण के लिए और एक अनुरोध में प्रत्येक एनम और बूलियन तर्क के लिए एक संभावना लौटाता है, इसलिए एक एजेंट तब कार्य करता है जब मॉडल सुनिश्चित होता है और जब यह नहीं होता है तो बढ़ जाता है। प्रत्येक उत्तर को कैलिब्रेट किया जाता है, और यह कह सकता है कि इनपुट अनुमान लगाने के बजाय उत्तर नहीं रखता है। यह उन निर्णयों के लिए बनाया गया है जो सॉफ़्टवेयर दिन में हजारों बार बनाता है, टिकट रूट करने से लेकर एजेंट के अगले टूल को चुनने तक।
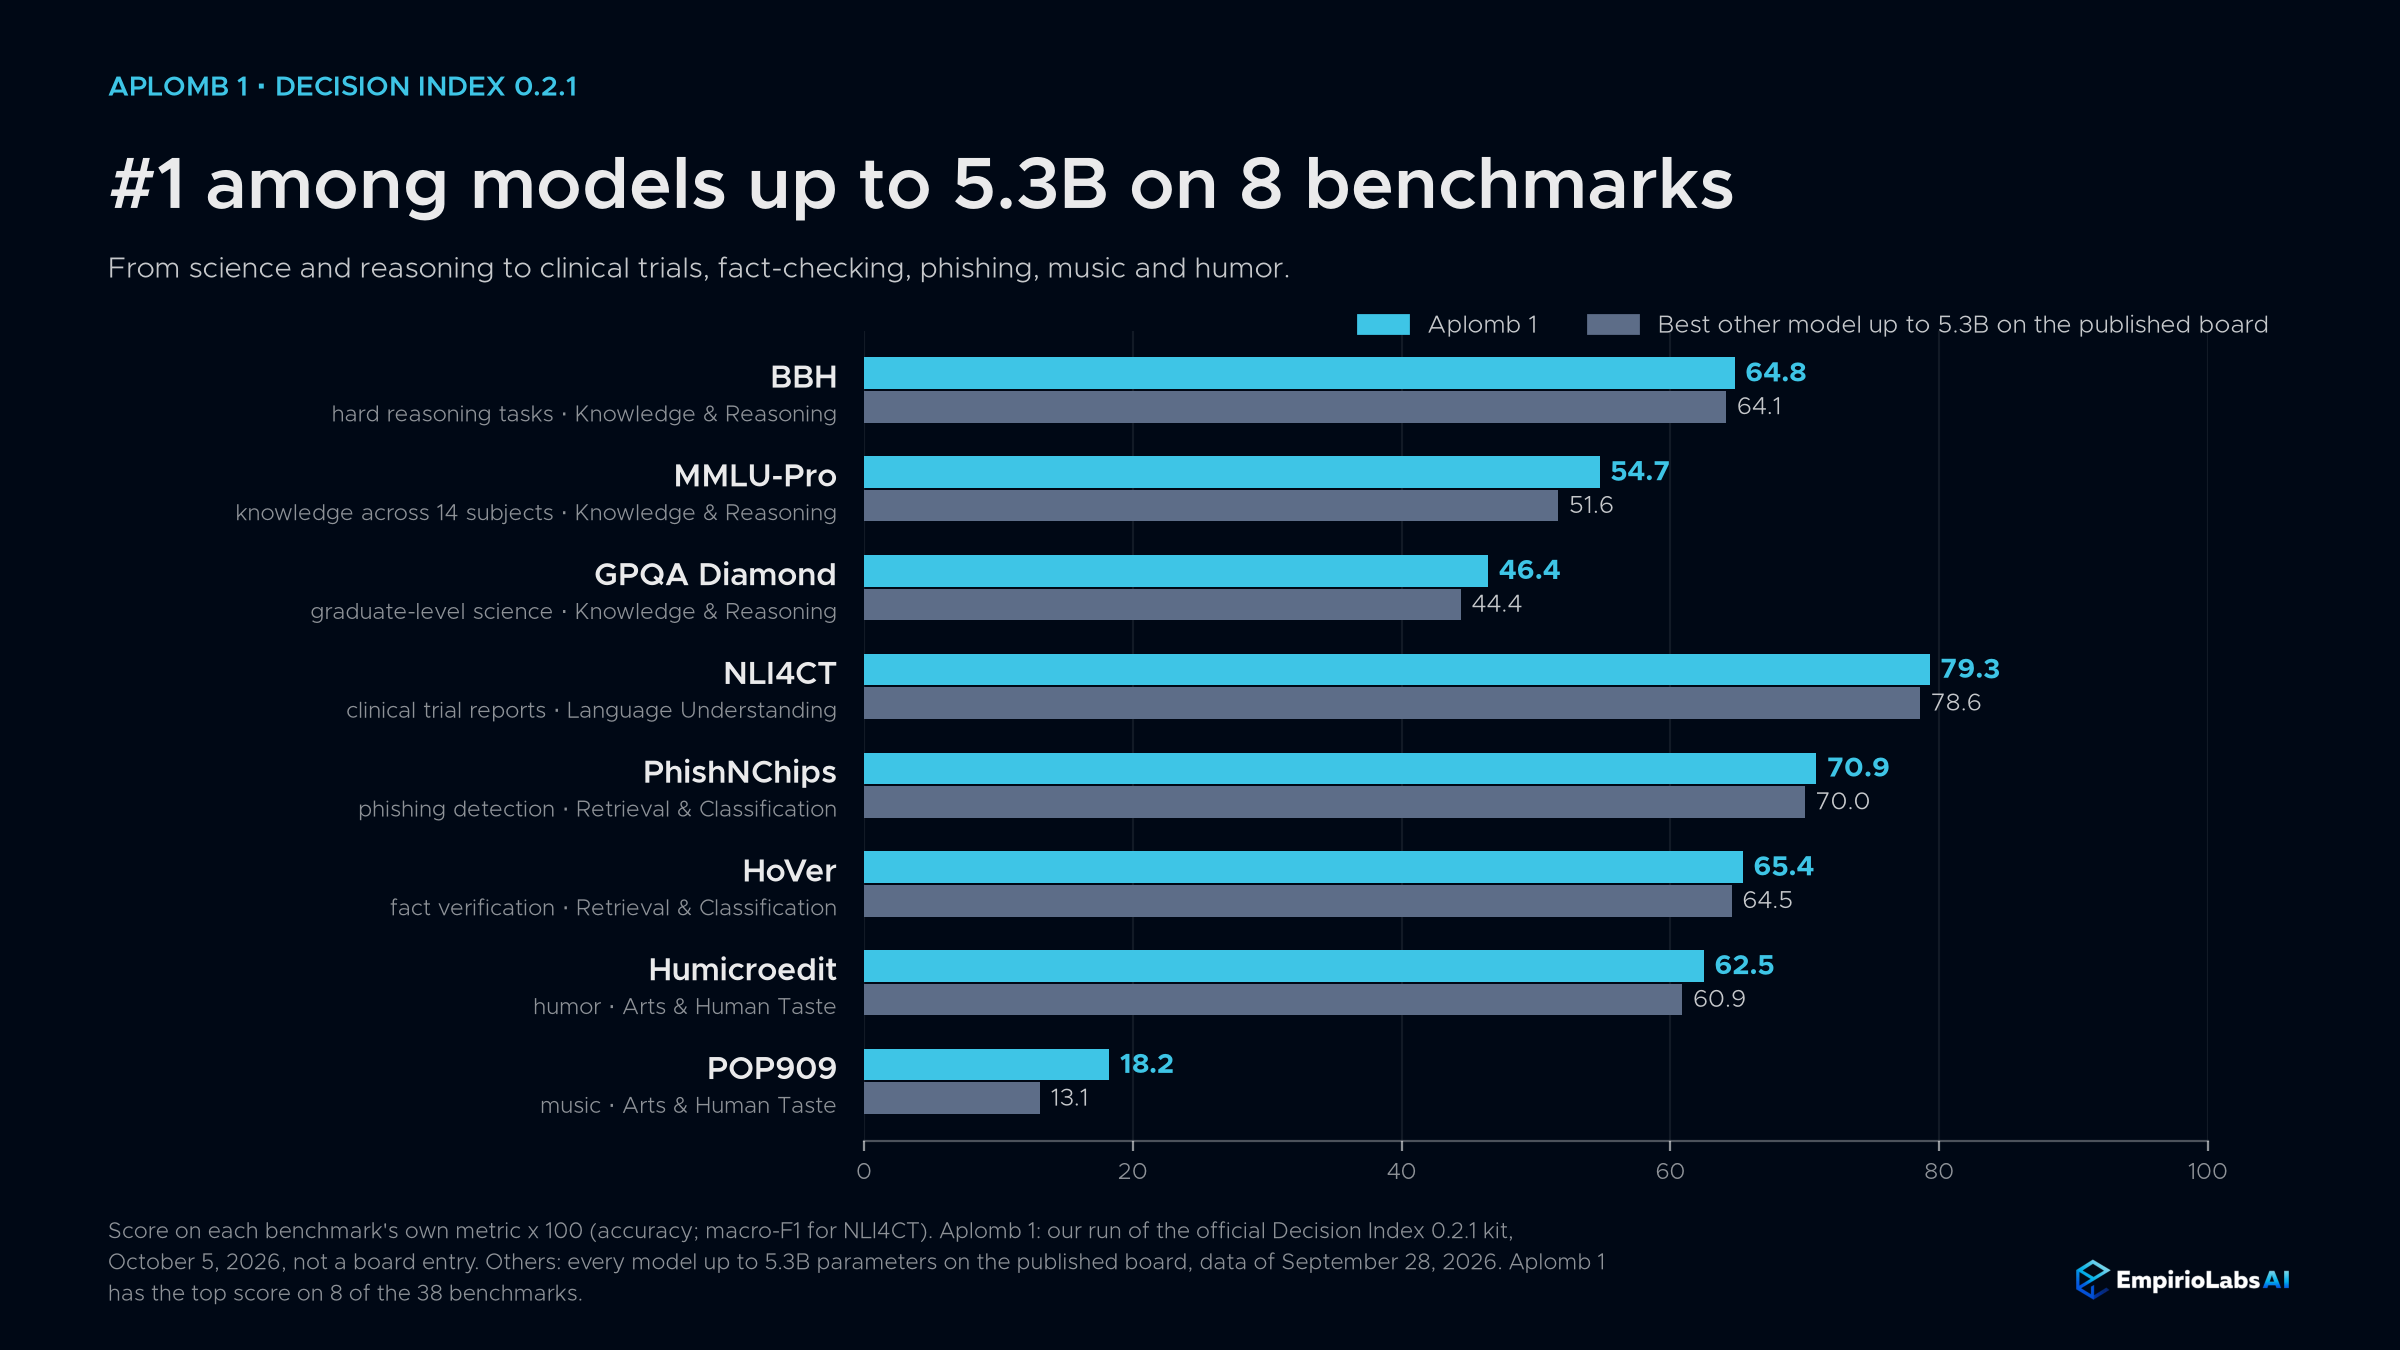
प्रकाशित निर्णय सूचकांक 0.2.1 बोर्ड (28 सितंबर, 2026 का डेटा) पर, यह 4B मॉडल में #1 है, जिसमें हमारे आधिकारिक किट के रन पर 44.86 है, और 1 बेंचमार्क में से 8 पर 5.3B पैरामीटर तक के मॉडलों में #38 है। 0.3.2 अक्टूबर, 12 के डिसीजन इंडेक्स 2026 बोर्ड पर, यह R-Bench-M, GPQA डायमंड और cfcolor पर अपने आकार वर्ग में #1 है। यह आज EmpirioLabs एपीआई और Playground में उपलब्ध है, और इसका वजन EmpirioLabs मॉडल लाइसेंस के तहत हगिंग फेस पर है।
| Aplomb 1 एक नज़र में | |
|---|---|
| इनपुट | टेक्स्ट, JSON, छवियां, वीडियो और ऑडियो, किसी भी मिश्रण में |
| खिड़की | राज्य प्लस प्रश्न के 1,000,000 टोकन |
| प्रश्न | हां या नहीं, विकल्प (2 से 255 विकल्प), स्कोर (2 से 10 स्तर), उपकरण चयन |
| राज्य में नहीं | एक संभावना है कि इनपुट उत्तर नहीं रखता है |
| उपकरण चयन | कॉल करने के लिए अगला उपकरण, इसके एनम और बूलियन तर्कों की संभावनाओं के साथ |
| गति | एक छोटे से प्रश्न के लिए लगभग 15 एमएस मॉडल समय; तेज लंबे-संदर्भ मोड में 1M-टोकन दस्तावेज़ के लिए लगभग 3 सेकंड |
| एपीआई प्रारूप | निर्णय एपीआई, साथ ही ओपनएआई, एंथ्रोपिक और जेमिनी प्रारूप |
| बिलिंग | केवल इनपुट टोकन; आउटपुट टोकन हमेशा शून्य होते हैं |
| डेटा प्रतिधारण | डिफ़ॉल्ट रूप से शून्य डेटा प्रतिधारण |
| आकार वाला | 5.3 बिलियन पैरामीटर, Qwen3.5-4B पर निर्मित; गले लगाने वाले चेहरे पर खुले वजन |
| निर्णय सूचकांक 0.2.1 | 44.86 हमारे आधिकारिक किट के संचालन पर, प्रकाशित 1 बोर्ड पर 4B मॉडल के बीच #0.2.1 (28 सितंबर, 2026 का डेटा) |
| निर्णय सूचकांक 0.3.2 | #1 R-Bench-M (25B तक), GPQA डायमंड और cfcolor (8B से कम), 12 अक्टूबर, 2026 के बोर्ड पर अपने आकार वर्ग में |
| टाइप किए गए निर्णय | हगिंग फेस लीडरबोर्ड के डिफ़ॉल्ट दृश्य में KL डाइवर्जेंस (0.123) और ब्रियर स्कोर (0.065) पर #8, 2026 |
यह क्या जवाब देता है
चार प्रश्न प्रकार। नोल हां या ना में हां की प्रायिकता के साथ जवाब दें। चुनिंदा 2 से 255 विकल्पों में से एक चुनता है और पूर्ण वितरण लौटाता है। स्कोर करना राज्य को 2 से 10 स्तरों के क्रमबद्ध पैमाने पर रखता है। उपकरण कॉल करने के लिए आपके कौन से फ़ंक्शन टूल चुनता है और इसके enum और बूलियन तर्कों पर वितरण देता है.
राज्य में नहीं। आगे कहना "परहेज": सच एक प्रश्न और उत्तर में यह भी संभावना होती है कि राज्य में वह नहीं है जो प्रश्न की आवश्यकता है। बिना वाहक क्षेत्र वाले रिकॉर्ड को एक आश्वस्त अनुमान के बजाय एक उच्च परहेज संभावना मिलती है।
स्वतंत्र उत्तर। अधिकतम 128 प्रश्न एक राज्य साझा करते हैं, और प्रत्येक का उत्तर अपने आप दिया जाता है, इसलिए एक प्रश्न जोड़ने से दूसरा उत्तर कभी नहीं बदलता है।
एजेंटों के लिए उपकरण चयन
Aplomb 1 को अपने एजेंट के फ़ंक्शन टूल और वर्तमान स्थिति (एक टिकट, एक बातचीत, एक रिकॉर्ड) दें, और यह एक अनुरोध में प्रत्येक उपकरण के लिए एक संभावना और प्रत्येक एनम और बूलियन तर्क के लिए वितरण के साथ अगला कॉल करने के लिए टूल लौटाता है। एक सामान्य एलएलएम टोकन द्वारा एक टूल कॉल आउट टोकन लिखता है और यह नहीं कहता है कि यह टूल या किसी भी तर्क के बारे में कितना निश्चित है। एजेंट तब कार्य करता है जब संभावना अधिक होती है और जब यह नहीं होता है तो एक बड़े मॉडल को कदम देता है, इसलिए नियमित चरण एक उत्पन्न उत्तर को छोड़ देते हैं। हमें कोई अन्य निर्णय मॉडल नहीं मिला जो तर्क संभावनाओं को लौटाता है।
एक टिकट जिस पर लिखा है "ऑर्डर बी-44120 एक फटी हुई स्क्रीन के साथ आया। मुझे अपना पैसा वापस चाहिए। तीन उपकरणों के साथ, issue_refund (ए कारण एनम और ए full_refund बूलियन), track_package तथा escalate_to_human, (संक्षिप्त, गोल) के रूप में वापस आता है:
{"टूल": "issue_refund", "संभावनाएं": {"issue_refund": 0.969, "कोई नहीं": 0.025, "escalate_to_human": 0.005, "track_package": 0.002}, "तर्क": {"issue_refund": { "कारण": {"मान": "क्षतिग्रस्त", "संभावनाएं": {"क्षतिग्रस्त": 0.993, "not_as_described": 0.007, "देर से": 0.001}}, "full_refund": {"मान": सच, "probability_true": 0.761}}}, "open_arguments": {"track_package": ["order_id"]}}
मुक्त-पाठ तर्क, जैसे कि ऑर्डर आईडी, के तहत सूचीबद्ध हैं open_arguments एजेंट को भरने के लिए।
मिश्रित इनपुट, 1M टोकन तक
टेक्स्ट, JSON ऑब्जेक्ट और सरणियाँ, चित्र, वीडियो और ऑडियो किसी भी संयोजन में एक ही स्थिति में जाते हैं: खाता रिकॉर्ड के बगल में एक समर्थन कॉल रिकॉर्डिंग, दावा प्रपत्र के बगल में एक डैशकैम क्लिप, लिस्टिंग के बगल में एक उत्पाद फोटो। राज्य और सबसे लंबा प्रश्न 1,000,000 टोकन तक चल सकता है, जो एक लंबे अनुबंध बंडल के लिए पर्याप्त है, एक वर्ष के टिकट या एक अनुरोध में प्रतिलेखों के घंटे।
यह कैसे स्कोर करता है
हमने एक ही आइटम पर Aplomb 1 और तीन खुले 4B निर्णय मॉडल चलाए, और उनके बगल में Jev, JevK5 और Semif के लिए प्रकाशित इंटर्न-निर्णय नंबर सेट किए। सात-सुइट बंडल इंटर्न-डिसीजन रिपोर्ट पर, Aplomb 1 का औसत 88.7% है। Jev की प्रकाशित पंक्ति के खिलाफ यह JevBench हार्ड और टाइप किए गए निर्णयों पर आगे है, JevBench Easy पर स्तर, और JevBench Original, ToolACE, AG News और WildJailbreak पर पीछे है। इसकी सबसे बड़ी बढ़त JevBench Hard, +5.4 अंक पर है।
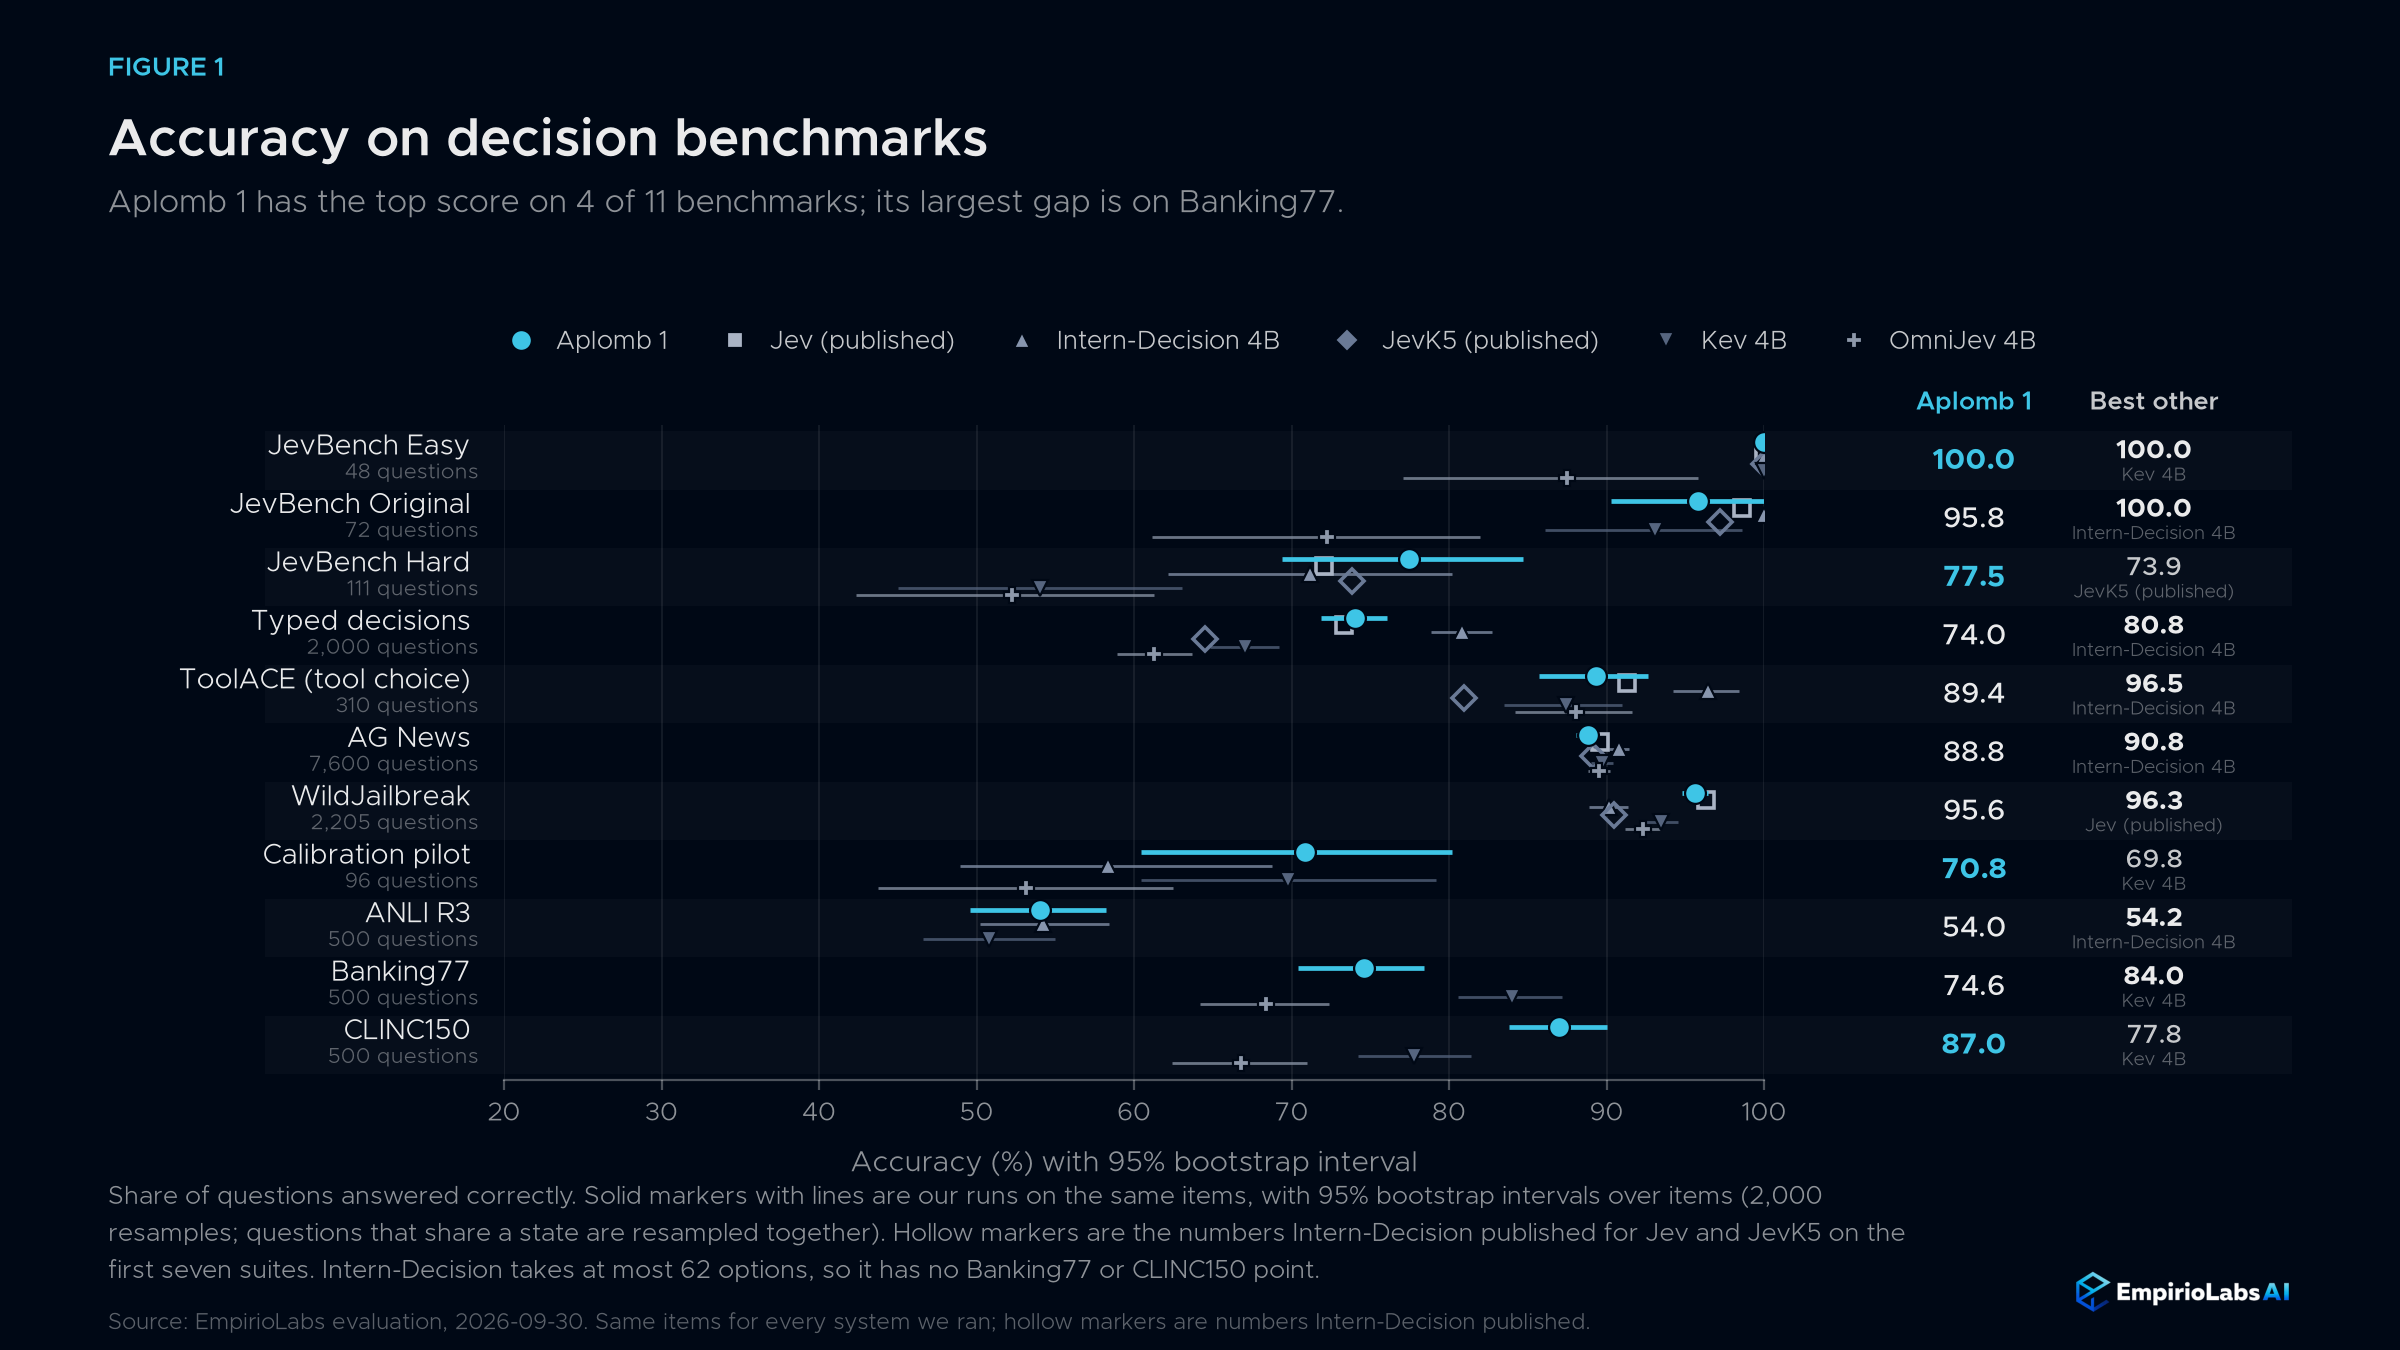
| कसौटी | आत्मविश्वास 1 | जेवी (पी) | जेवीके5 (पी) | सेमिफ (पी) | इंटर्न-निर्णय 4B | कीव 4बी | ओमनीजेव 4बी |
|---|---|---|---|---|---|---|---|
| जेवबेंच आसान | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 87.5 |
| जेवबेंच मूल | 95.8 | 98.6 | 97.2 | 98.6 | 100.0 | 93.1 | 72.2 |
| जेवबेंच हार्ड | 77.5 | 72.1 | 73.9 | 61.3 | 71.2 | 54.1 | 52.3 |
| टाइप किए गए निर्णय | 74.0 | 73.3 | 64.5 | 62.8 | 80.8 | 67.0 | 61.3 |
| टूलएसीई | 89.4 | 91.3 | 81.0 | 85.2 | 96.5 | 87.4 | 88.1 |
| एजी न्यूज | 88.8 | 89.6 | 89.1 | 89.2 | 90.8 | 89.7 | 89.6 |
| वाइल्डजेलब्रेक | 95.6 | 96.3 | 90.5 | 92.5 | 90.2 | 93.5 | 92.3 |
| औसत निकालना | 88.7 | 88.7 | 85.2 | 84.2 | 89.9 | 83.5 | 77.6 |
(पी) जैसा कि समान वस्तुओं के लिए इंटर्न-डिसीजन द्वारा प्रकाशित किया गया है। इंटर्न-डिसीजन इस बंडल पर अपने 4बी मॉडल के लिए 90.02 की रिपोर्ट करता है; कॉलम हमारे रन को दिखाता है।
| कसौटी | आत्मविश्वास 1 | इंटर्न-निर्णय 4B | कीव 4बी | ओमनीजेव 4बी |
|---|---|---|---|---|
| अंशांकन पायलट | 70.8 | 58.3 | 69.8 | 53.1 |
| एएनएलआई आर3 | 54.0 | 54.2 | 50.8 | n/a |
| बैंकिंग77 (77 विकल्प) | 74.6 | n/a | 84.0 | 68.4 |
| CLINC150 (150 विकल्प) | 87.0 | n/a | 77.8 | 66.8 |
लंबे इनपुट
हमने 16K से 1M टोकन तक ऑर्डर लेजर में लुकअप को मापा, जिसमें एक ऑर्डर के बारे में प्रश्न यादृच्छिक गहराई पर रखे गए थे।
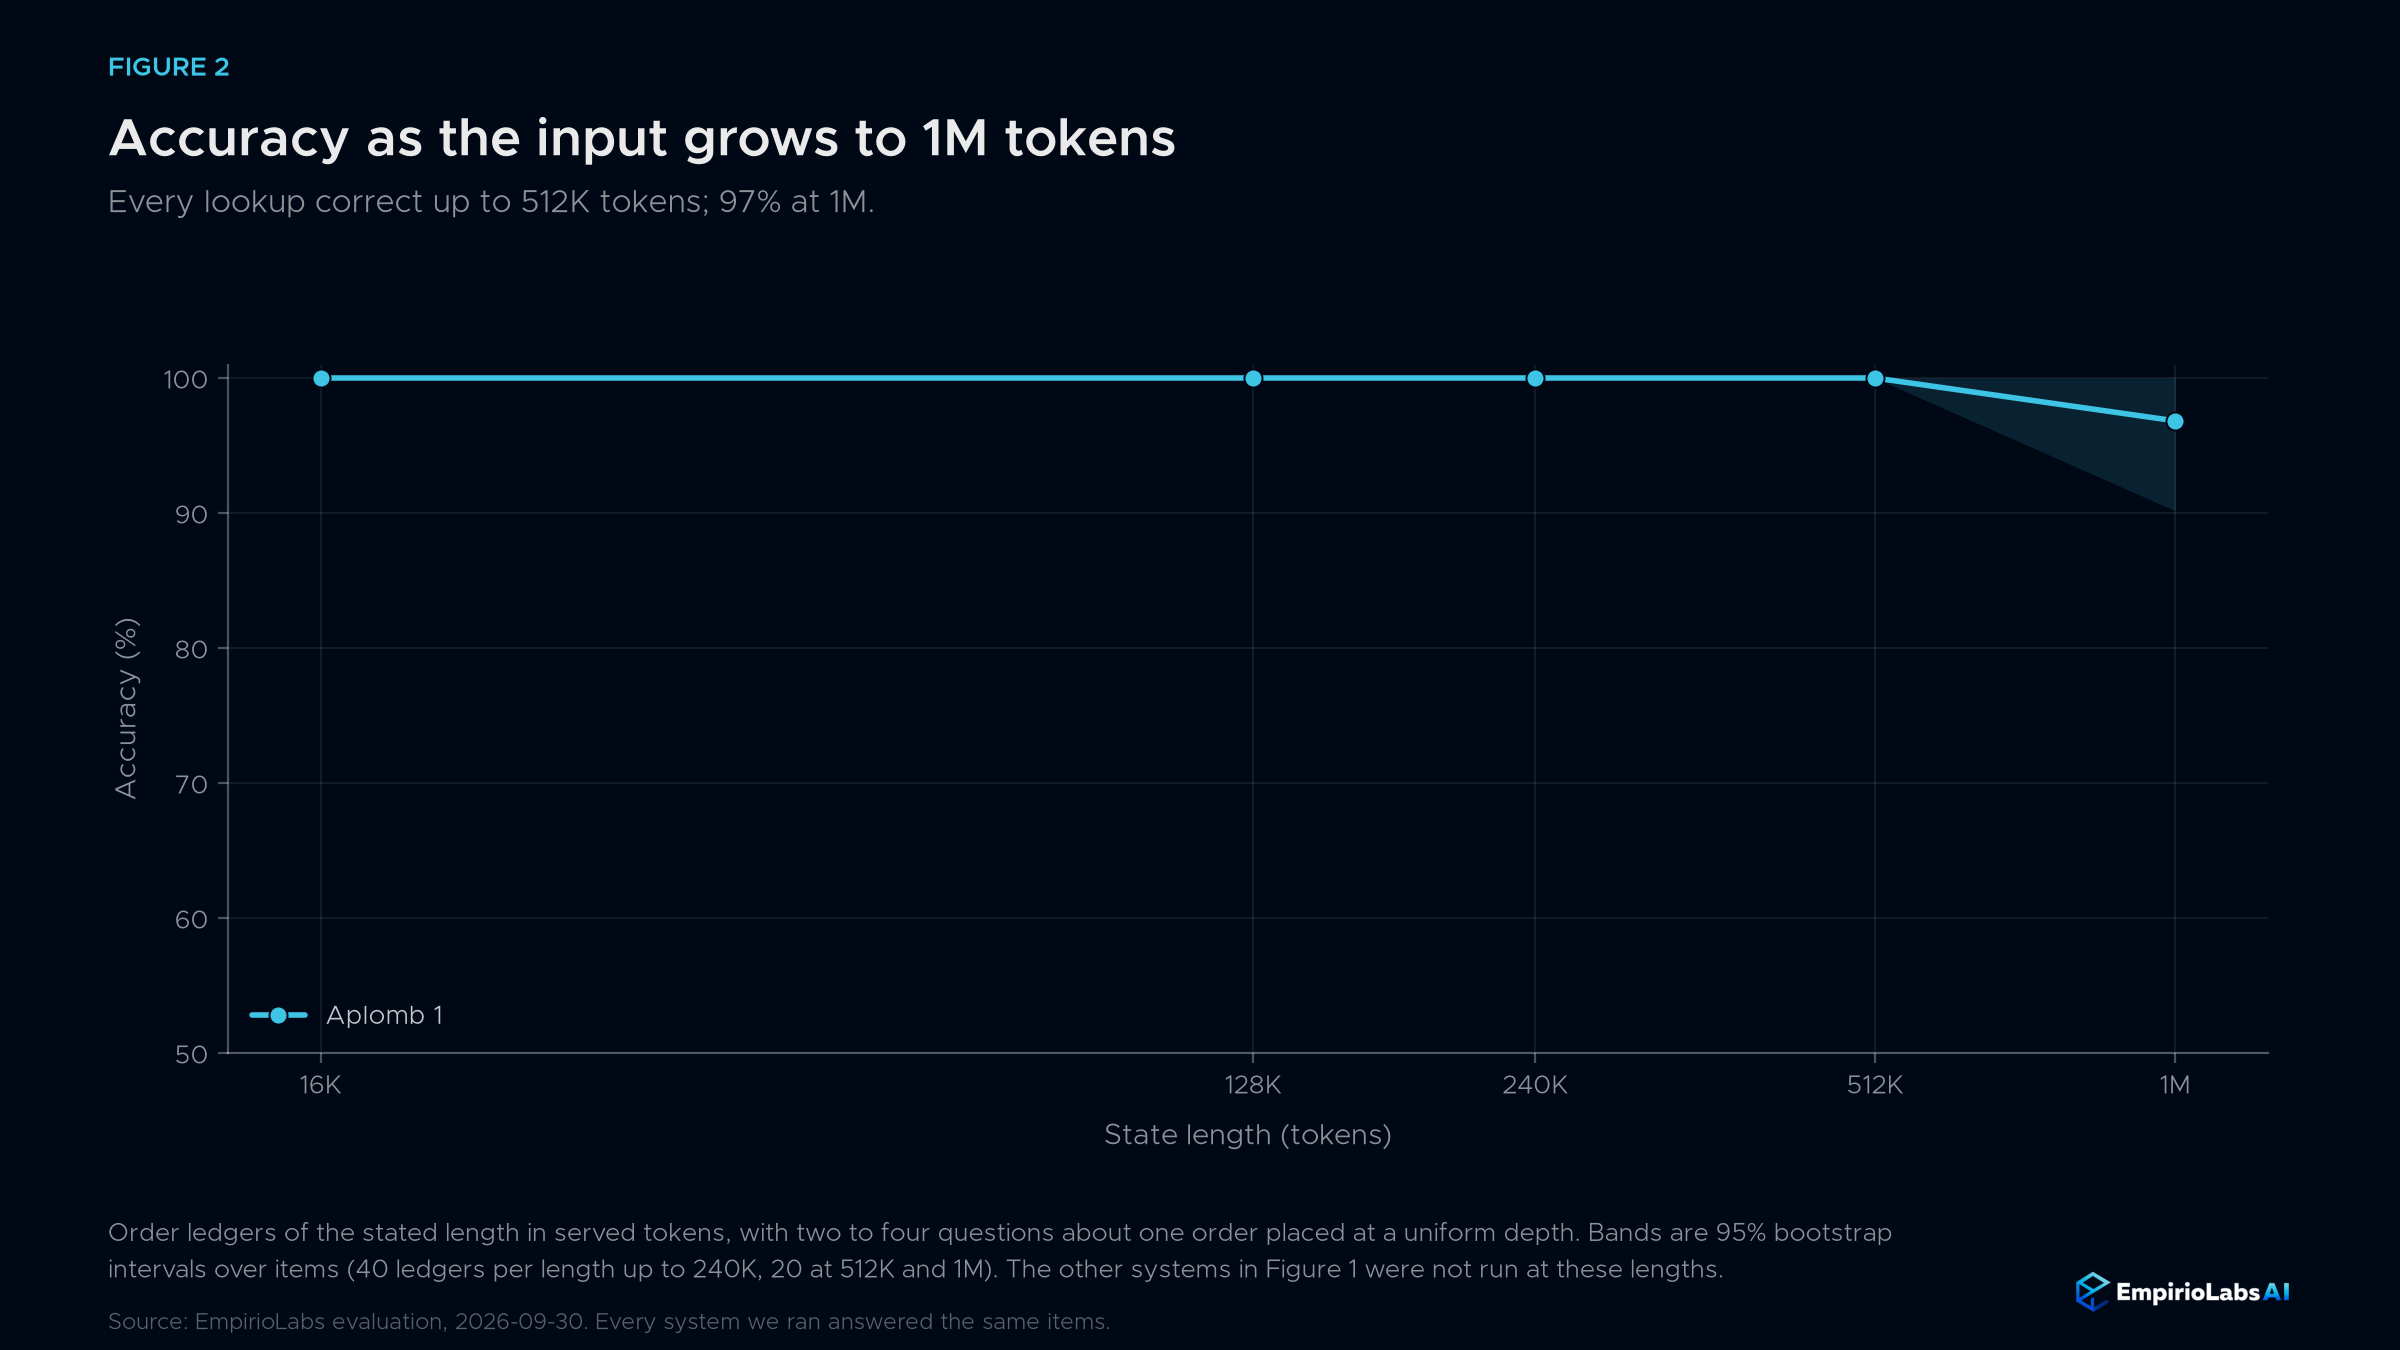
| इनपुट लंबाई (टोकन) | 16 हजार | 128 हजार | 240 हजार | 512कश्मीर | 1 मी |
|---|---|---|---|---|---|
| आत्मविश्वास 1 | 100.0 | 100.0 | 100.0 | 100.0 | 96.8 |
सेकंड में लंबे दस्तावेज़
EmpirioLabs एपीआई पर और Playground में, 131,072 टोकन से अधिक लंबे समय तक की स्थिति डिफ़ॉल्ट रूप से तेज लंबे-संदर्भ मोड में पढ़ी जाती है। एक 1M-टोकन दस्तावेज़ को पूर्ण रूप से पढ़ने के लिए लगभग 3 सेकंड के बजाय लगभग 111 सेकंड लगते हैं, और हमारे लंबे-संदर्भ परीक्षण सेट पर फास्ट मोड ने सभी 525 निर्णयों का सही उत्तर दिया, जबकि पूर्ण पढ़ने के लिए 95.2% था।
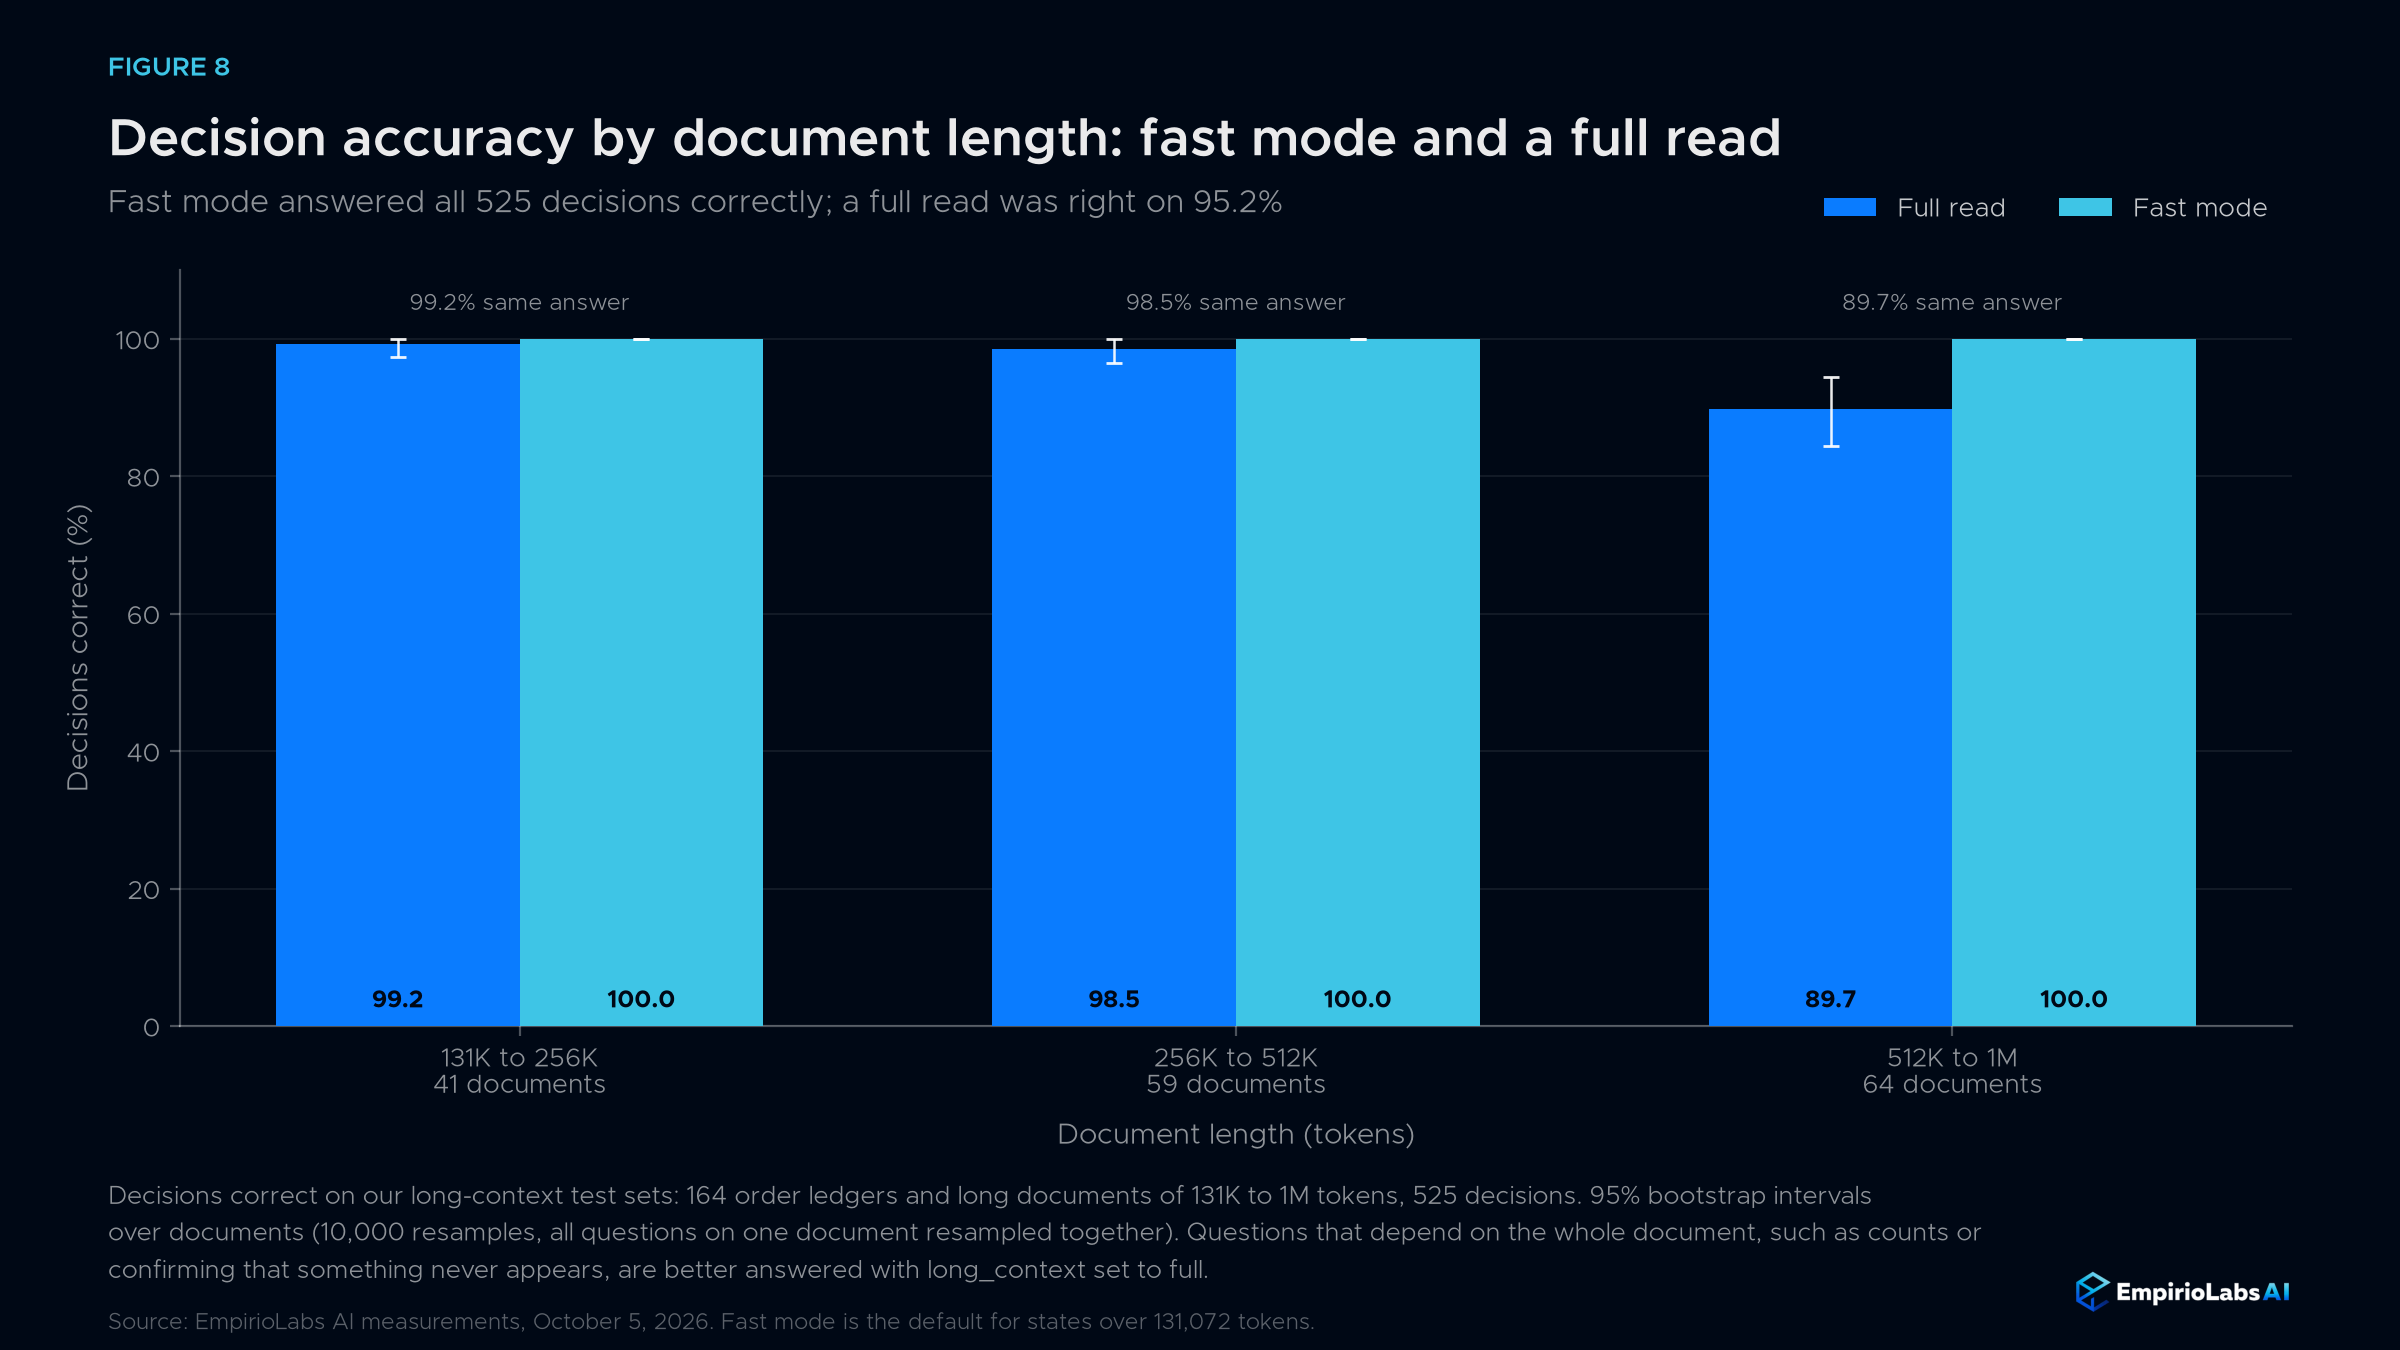
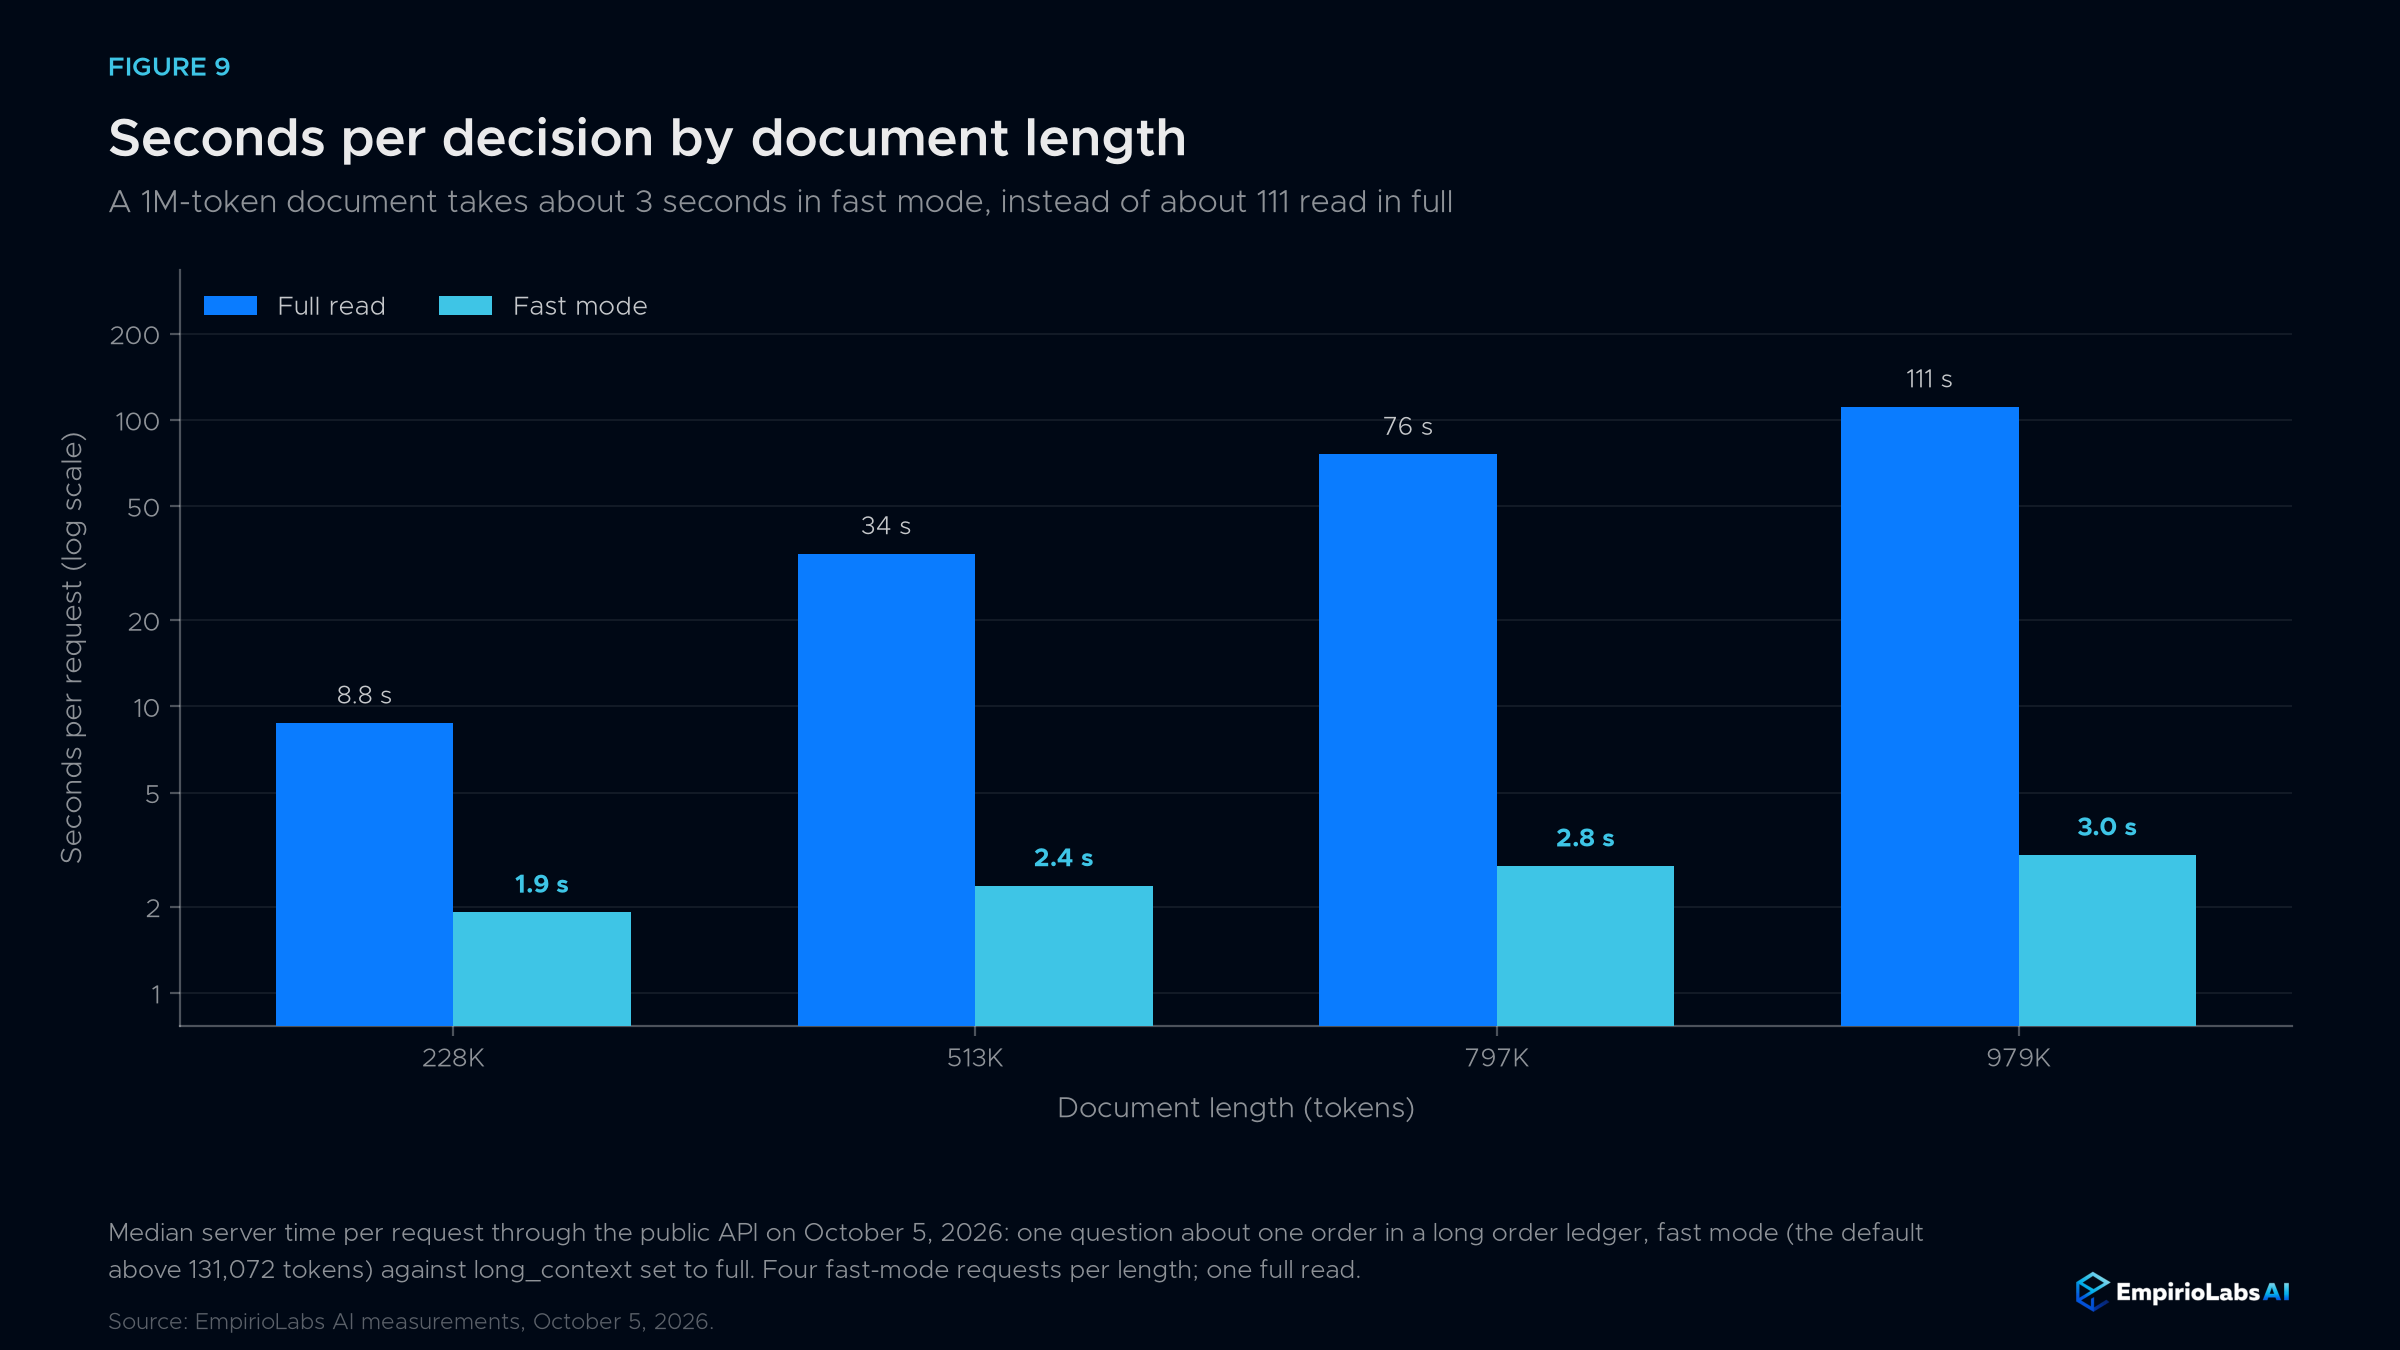
| दस्तावेज़ की लंबाई (टोकन) | 228K | 513कश्मीर | 797कश्मीर | 979कश्मीर |
|---|---|---|---|---|
| फास्ट मोड | 1.9 एस | 2.4 एस | 2.8 एस | 3.0 एस |
| पूरा पढ़ें | 8.8 एस | 34 एस | 76 एस | 111 एस |
भेजें "long_context": "पूर्ण" हर टोकन को पढ़ने के लिए। एक पूर्ण पठन बेहतर विकल्प है जब कोई उत्तर पूरे दस्तावेज़ पर निर्भर करता है, जैसे कि गिनती, समग्र स्वर, या यह पुष्टि करना कि कुछ कभी प्रकट नहीं होता है: उन प्रश्नों का परीक्षण करने के लिए बनाए गए 24 दस्तावेज़ों पर, फास्ट मोड 50% निर्णयों पर सही था और 61% पर पूर्ण पढ़ा गया था। प्रतिक्रिया का long_context फ़ील्ड कहता है कि किस मोड का उपयोग किया गया था, और उपयोग दोनों मोड में पूरे राज्य की गणना करता है। तेज़ लंबा-संदर्भ मोड केवल EmpirioLabs एपीआई और Playground में उपलब्ध है; खुले वजन हर टोकन को पढ़ते हैं।
कैलिब्रेशन
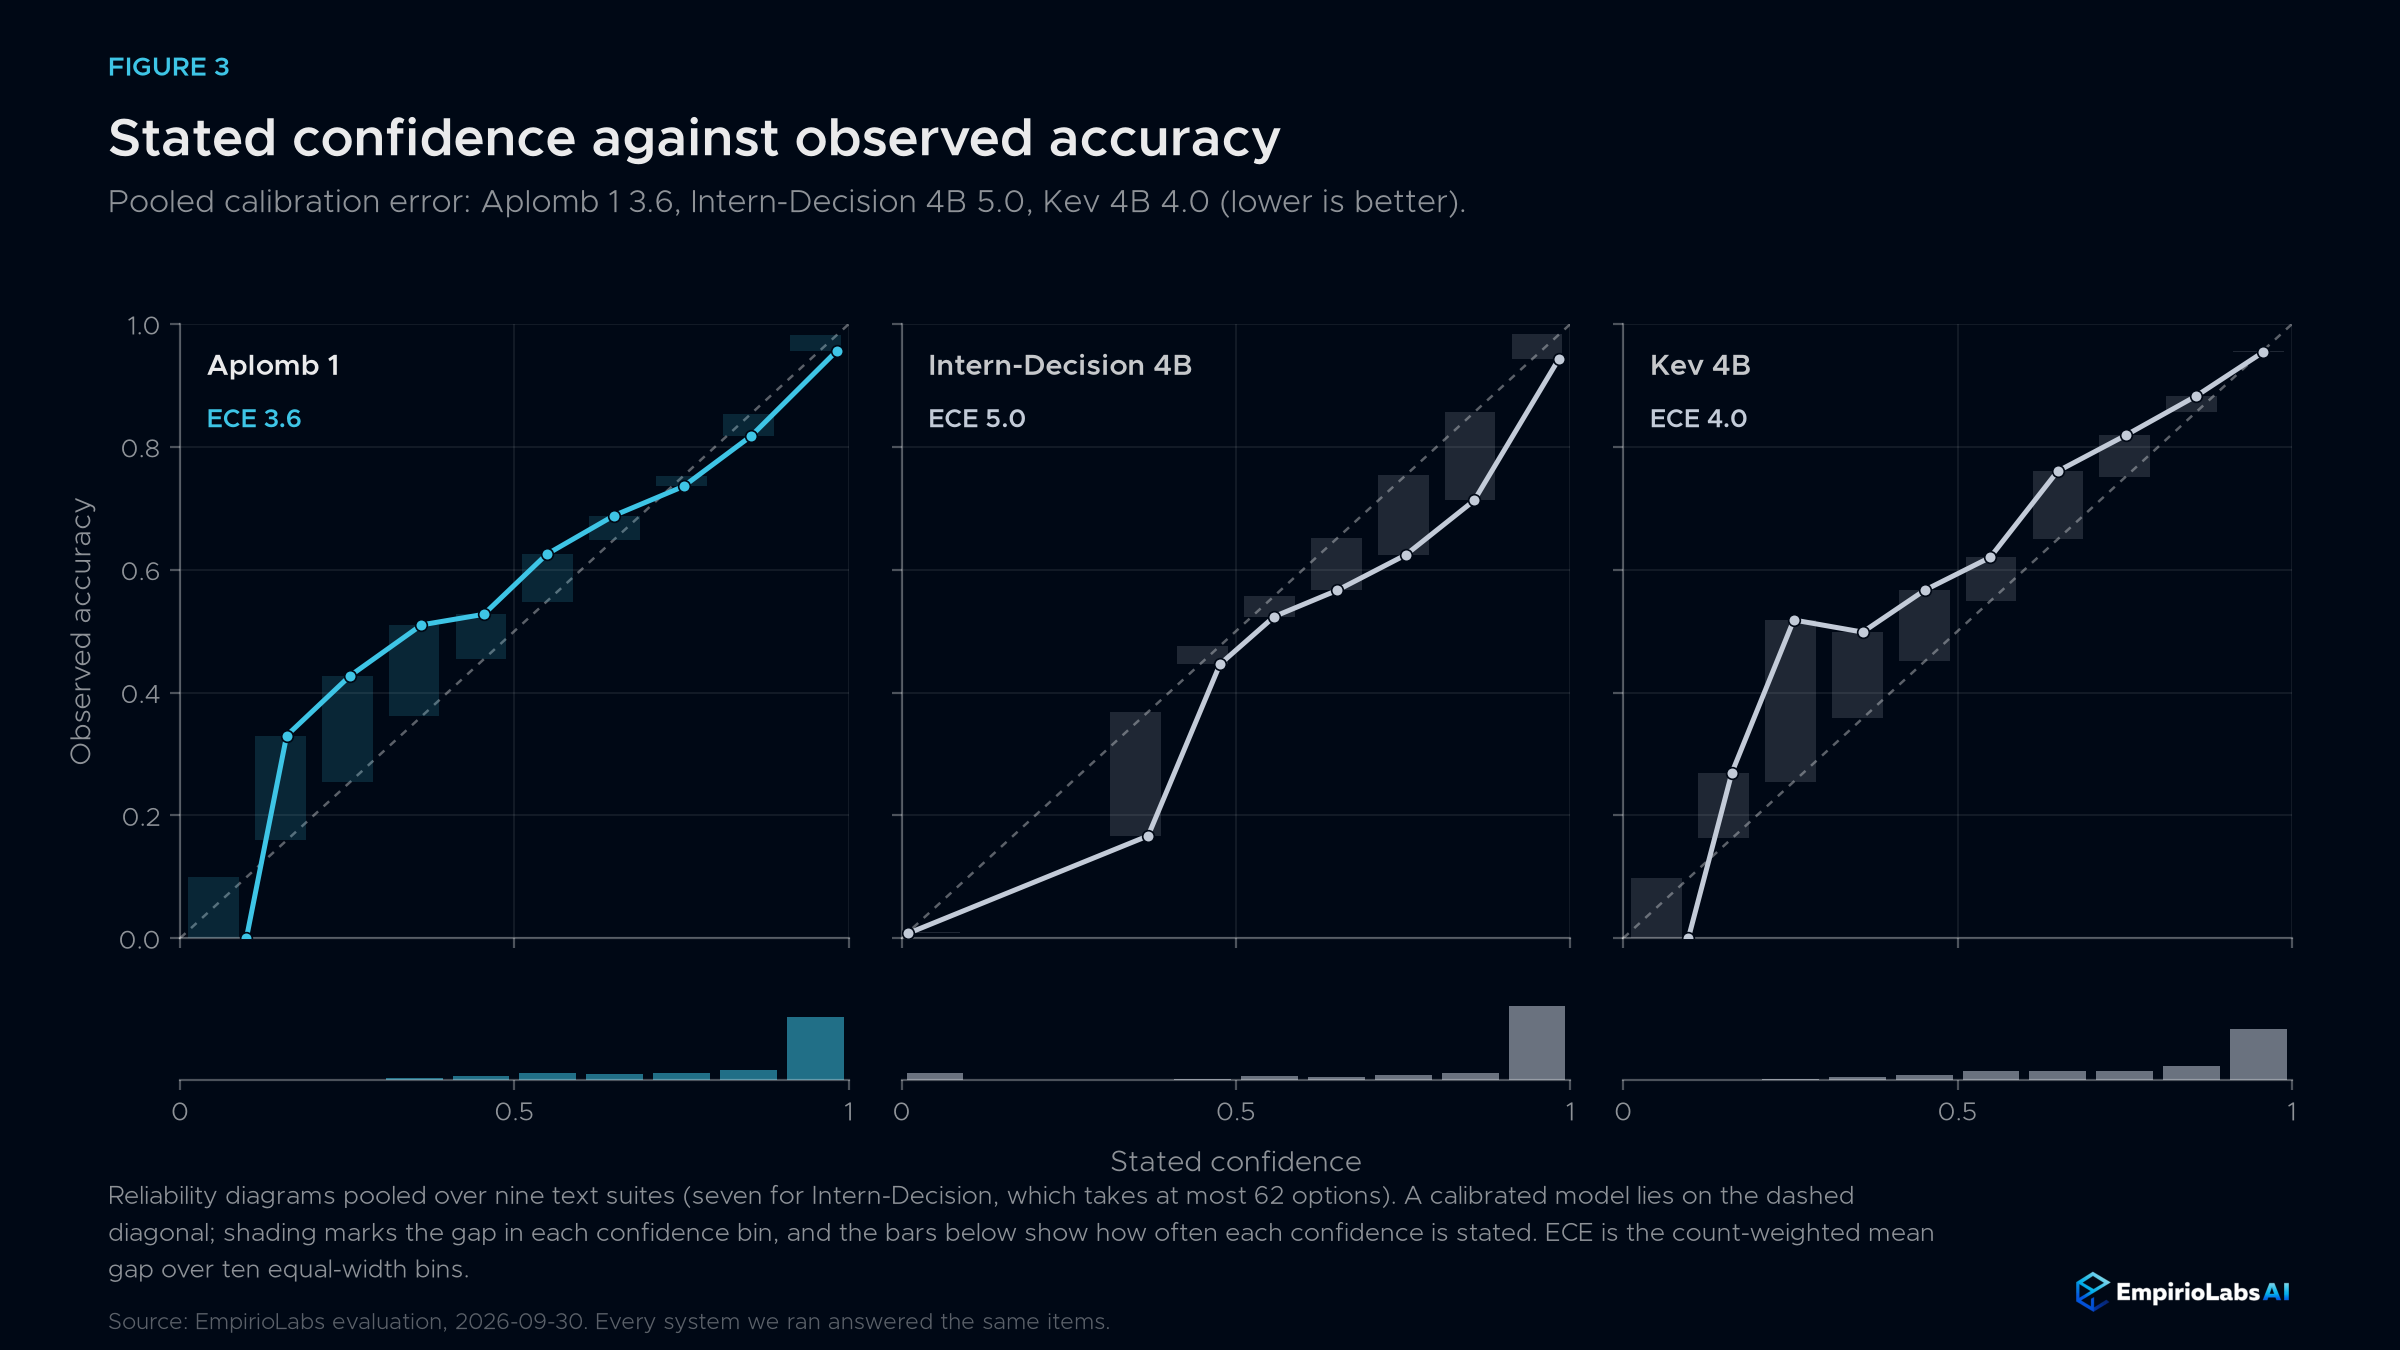
एक संभावना केवल उपयोगी है अगर यह क्या यह कहते हैं इसका मतलब है. नौ पाठ सुइट्स में, Aplomb 1 का कहा विश्वास ट्रैक करता है कि यह कितनी बार सही है: इसकी पूल अंशांकन त्रुटि है 3.6, के खिलाफ 5.0 इंटर्न-निर्णय के लिए 4B और 4.0 Kev 4B के लिए (कम बेहतर है).
छवियाँ, वीडियो और ऑडियो
| बेंचमार्क (पहले 500 आइटम) | आत्मविश्वास 1 | इंटर्न-निर्णय 4B | ओमनीजेव 4बी |
|---|---|---|---|
| पोप | 89.0 | 89.2 | 88.4 |
| एमएमस्टार | 68.6 | 65.2 | 64.4 |
| एआई2डी | 87.0 | 81.0 | 83.4 |
| एमएमएमयू | 57.2 | 57.0 | 56.0 |
| मतिभ्रमबेंच | 79.8 | 79.4 | 71.2 |
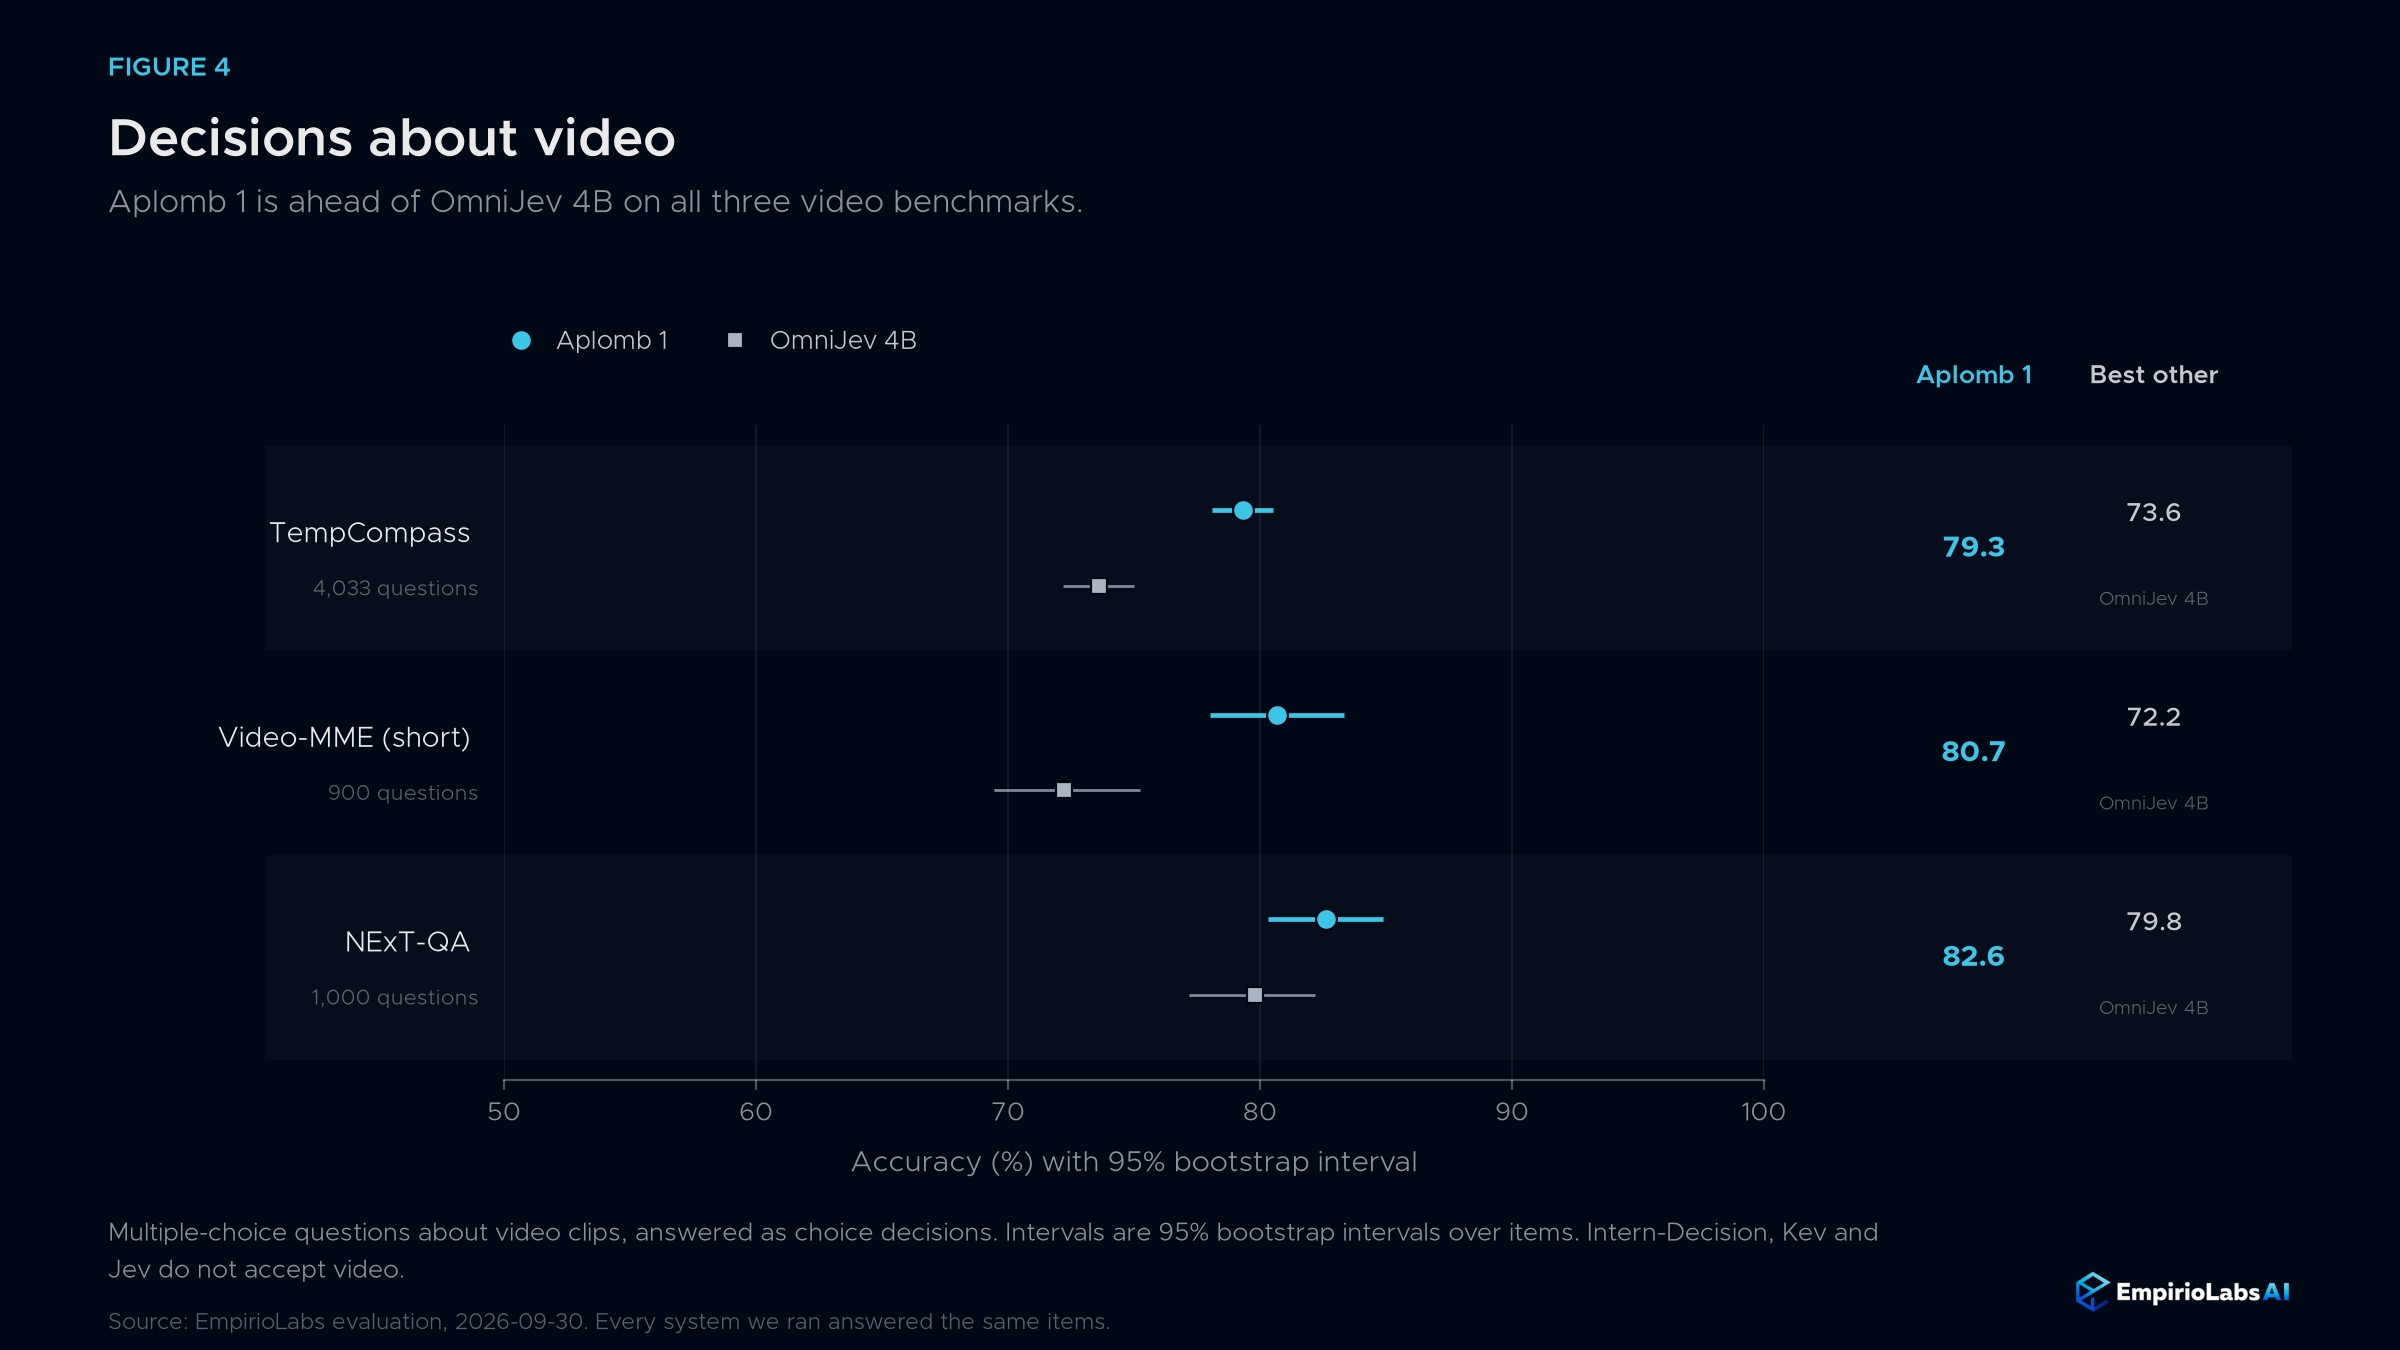
| कसौटी | आत्मविश्वास 1 | ओमनीजेव 4बी |
|---|---|---|
| टेम्पकम्पास | 79.3 | 73.6 |
| वीडियो-एमएमई (छोटा) | 80.7 | 72.2 |
| नेक्स्ट-क्यूए | 82.6 | 79.8 |
हमने स्वयं Aplomb 1 में ऑडियो जोड़ा; ऊपर दिए गए अन्य निर्णय मॉडलों में से कोई भी इसे स्वीकार नहीं करता है। यह मुखर ध्वनियों, भाषण और रोजमर्रा की आवाज़ों में भावनाओं को पहचानता है, और जो कहा जाता है उसके बारे में सवालों के जवाब देता है:
| कसौटी | आत्मविश्वास 1 |
|---|---|
| वोकलसाउंड (मुखर ध्वनियाँ) | 91.9 |
| क्रेमा-डी (भाषण में भावना) | 78.7 |
| ESC-50 (पर्यावरणीय ध्वनियाँ) | 77.0 |
| MMAU (ऑडियो प्रश्न) | 68.3 |
| एमएमएसयू (बोली जाने की भाषा) | 63.2 |
ऑडियो परिणाम 6 अक्टूबर, 2026 को अपडेट किए गए थे, जिसमें Aplomb 1 के लिए नए ऑडियो वेट थे; टेक्स्ट, इमेज और वीडियो परिणाम अपरिवर्तित हैं।
51 भाषाएँ
Aplomb 1 केवल अंग्रेजी ही नहीं, बल्कि कई भाषाओं में पाठ के बारे में निर्णय लेता है। MASSIVE पर, वॉयस असिस्टेंट से प्रत्येक अनुरोध 51 भाषाओं में से एक में लिखा जाता है, जबकि प्रश्न और 59 इंटेंट लेबल अंग्रेजी में रहते हैं। MASSIVE पर किसी भी प्रशिक्षण के बिना, Aplomb 1 का औसतन 75.0 भाषाओं में 51%, अंग्रेजी में 91.0% और उनमें से 39 में 70% या उससे अधिक है।
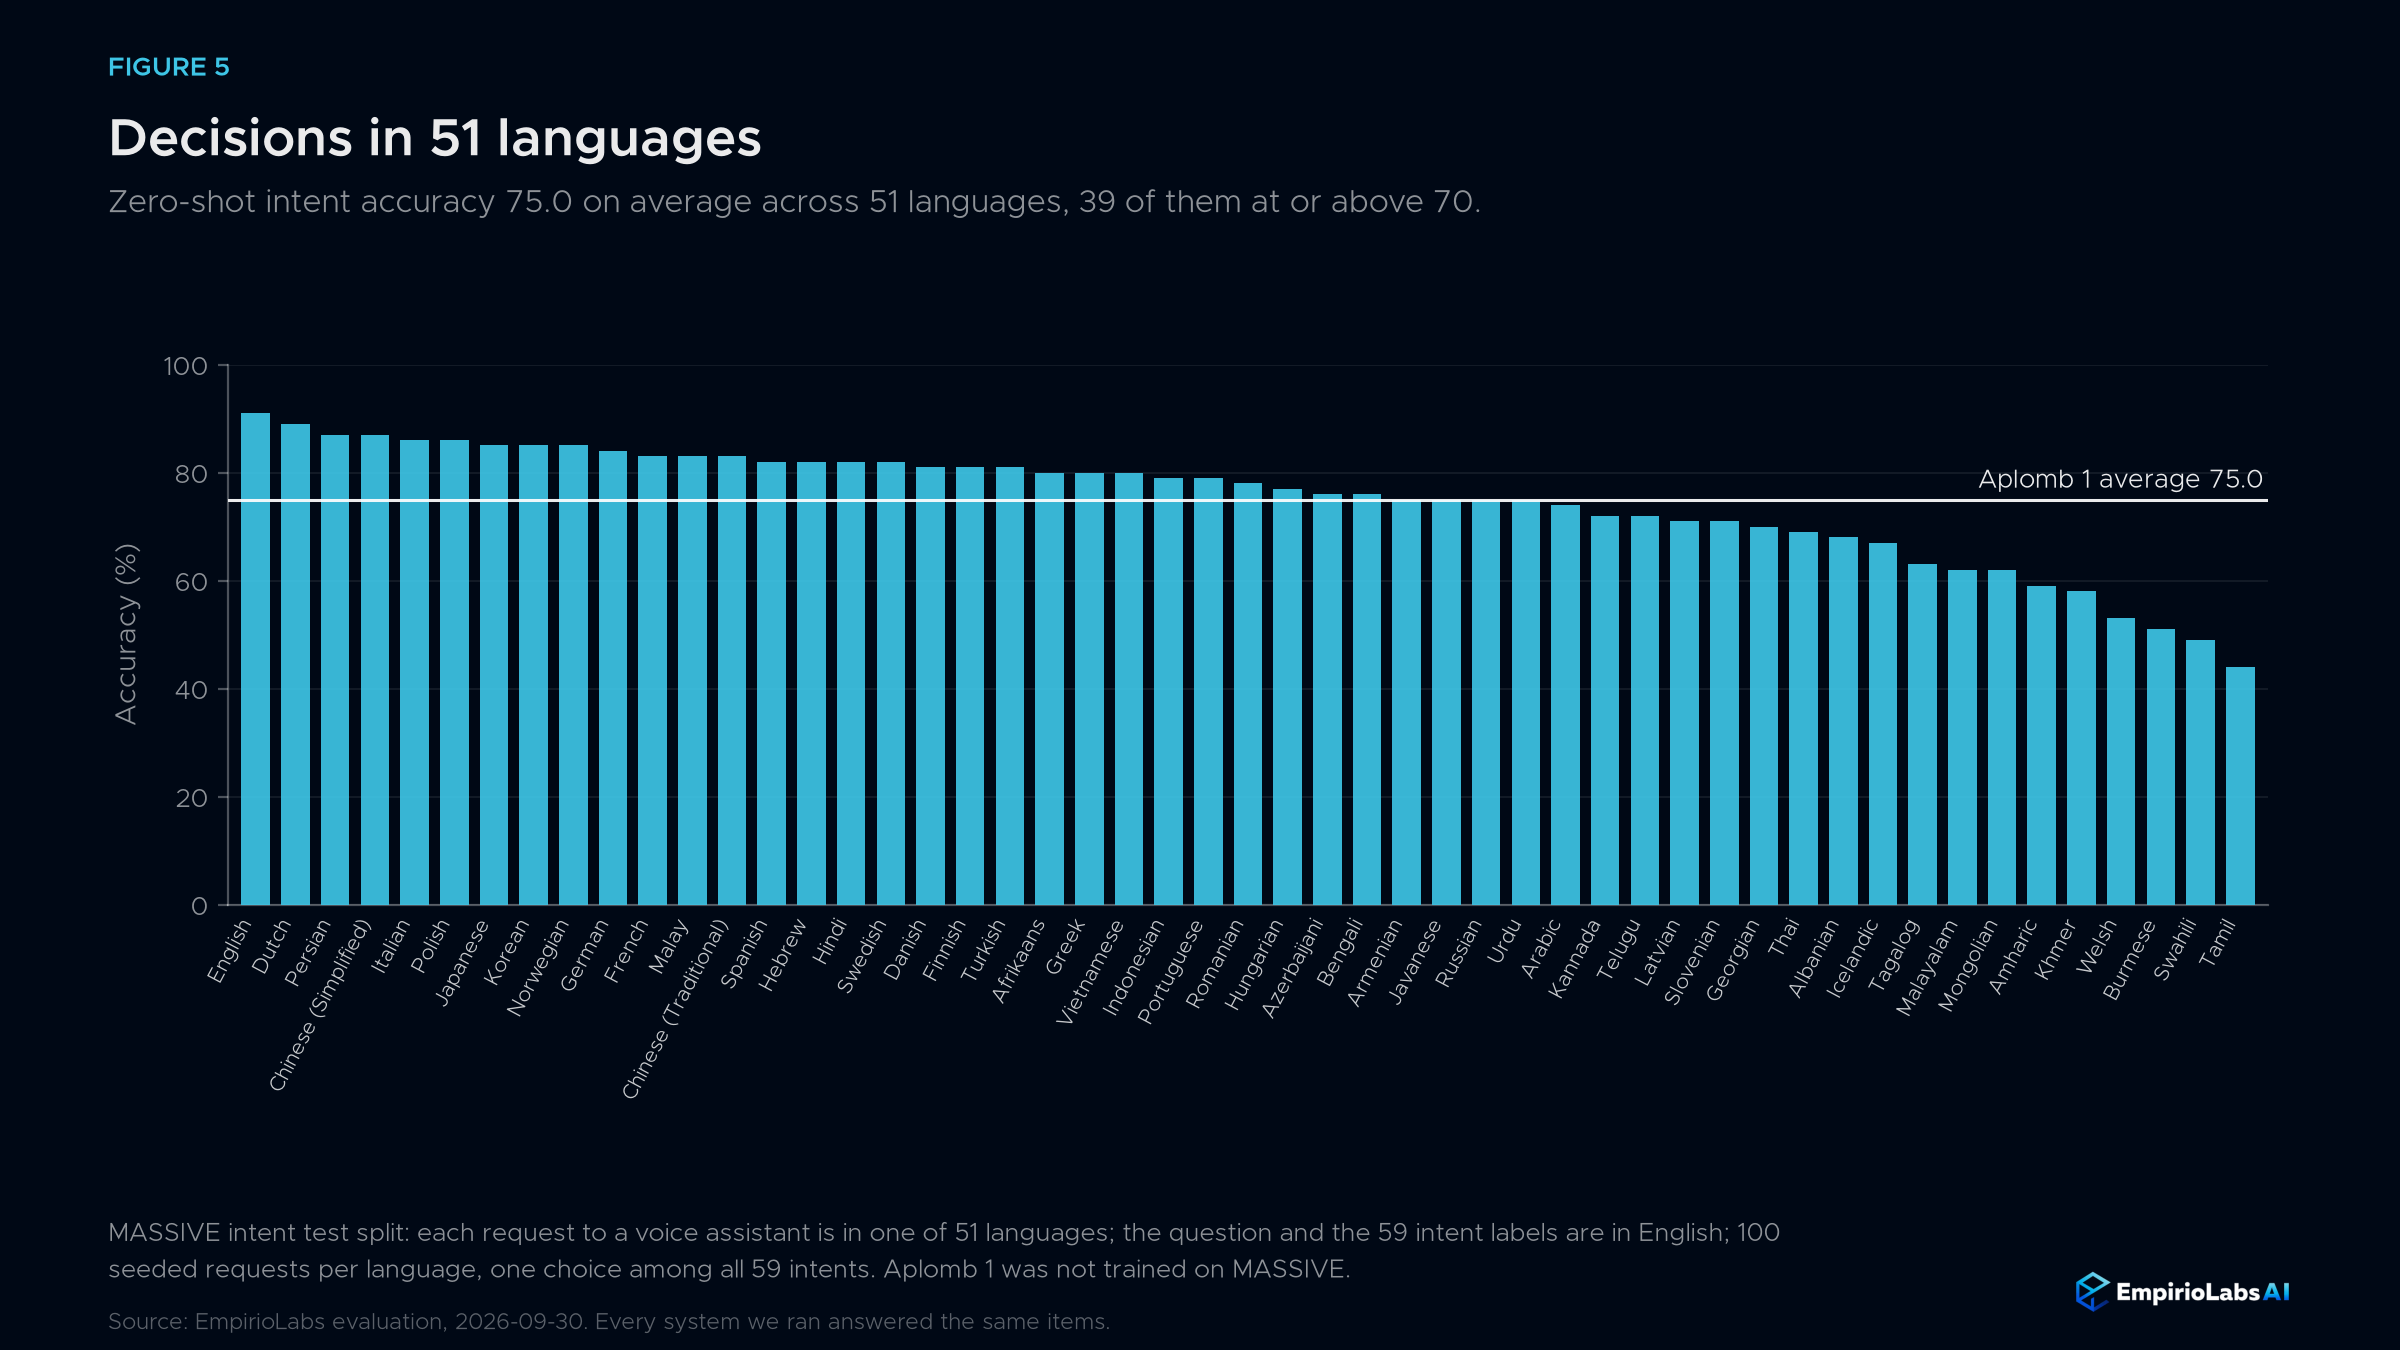
संदर्भ के लिए, लाया परियोजना 20 इरादों में से चयन करते समय समान 51 भाषाओं में अपने बहुभाषी मॉडल के लिए 40.1% की रिपोर्ट करती है, और JevK5 परियोजना सभी 60 इरादों के साथ अंग्रेजी में 73.8% की रिपोर्ट करती है।
निर्णय सूचकांक
निर्णय सूचकांक 0.2.1 (5 अक्टूबर, 2026)
निर्णय सूचकांक 0.2.1 पांच क्षेत्रों में 38 सार्वजनिक बेंचमार्क का औसत है: ज्ञान और तर्क, भाषा की समझ, पुनर्प्राप्ति और वर्गीकरण, उपकरण और स्वचालन, और कला और मानव स्वाद। प्रत्येक बेंचमार्क को मौका-सही किया जाता है, इसलिए 0 का अर्थ है यादृच्छिक अनुमान लगाना और 100 का अर्थ है परिपूर्ण।
हमने 1 अक्टूबर, 5 को Aplomb 2026 पर आधिकारिक किट चलाई, और इसने सभी 150,317 स्कोरेबल अनुरोधों का उत्तर दिया। Aplomb 1 का स्कोर 44.86 है। यह किट का हमारा अपना रन है, प्रकाशित बोर्ड पर प्रविष्टि नहीं।
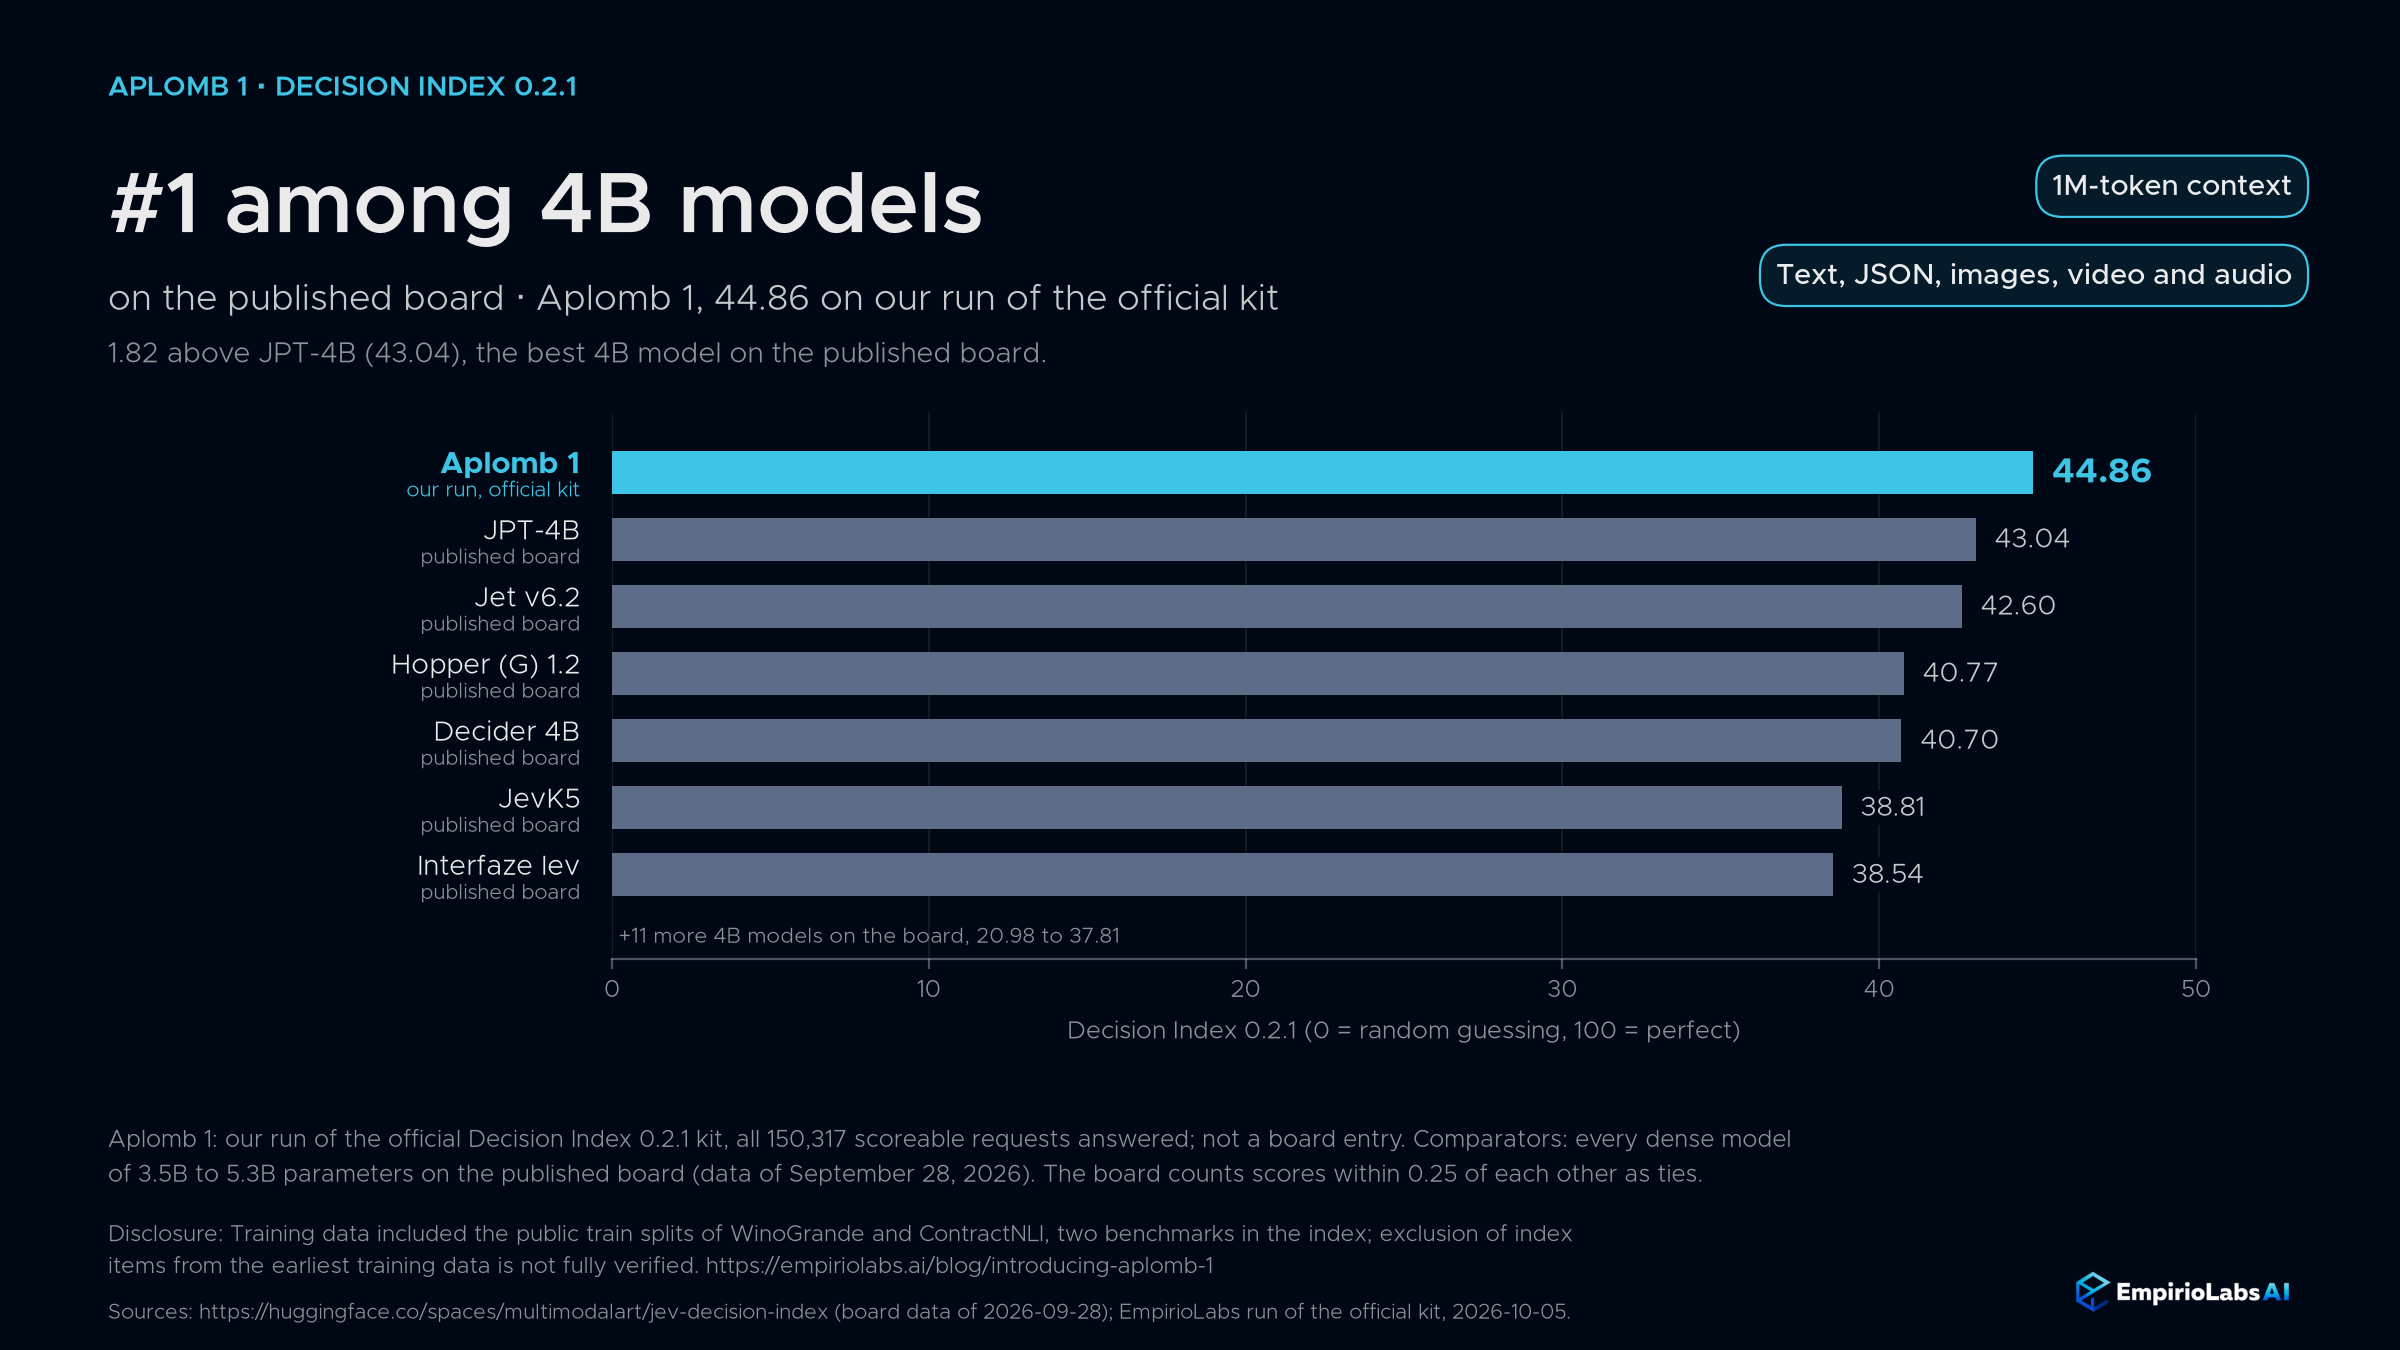
प्रकाशित निर्णय सूचकांक 0.2.1 बोर्ड (28 सितंबर, 2026 का डेटा) पर, Aplomb 1 4B मॉडल में #1 है, और MMLU-Pro, GPQA डायमंड और BBH सहित 38 बेंचमार्क में से 5.3B मापदंडों तक के मॉडलों में #1 है। उस बोर्ड पर, 4B मॉडल के लिए उच्चतम स्कोर JPT-4B का 43.04 है, जो Aplomb 1 से 1.82 नीचे है।
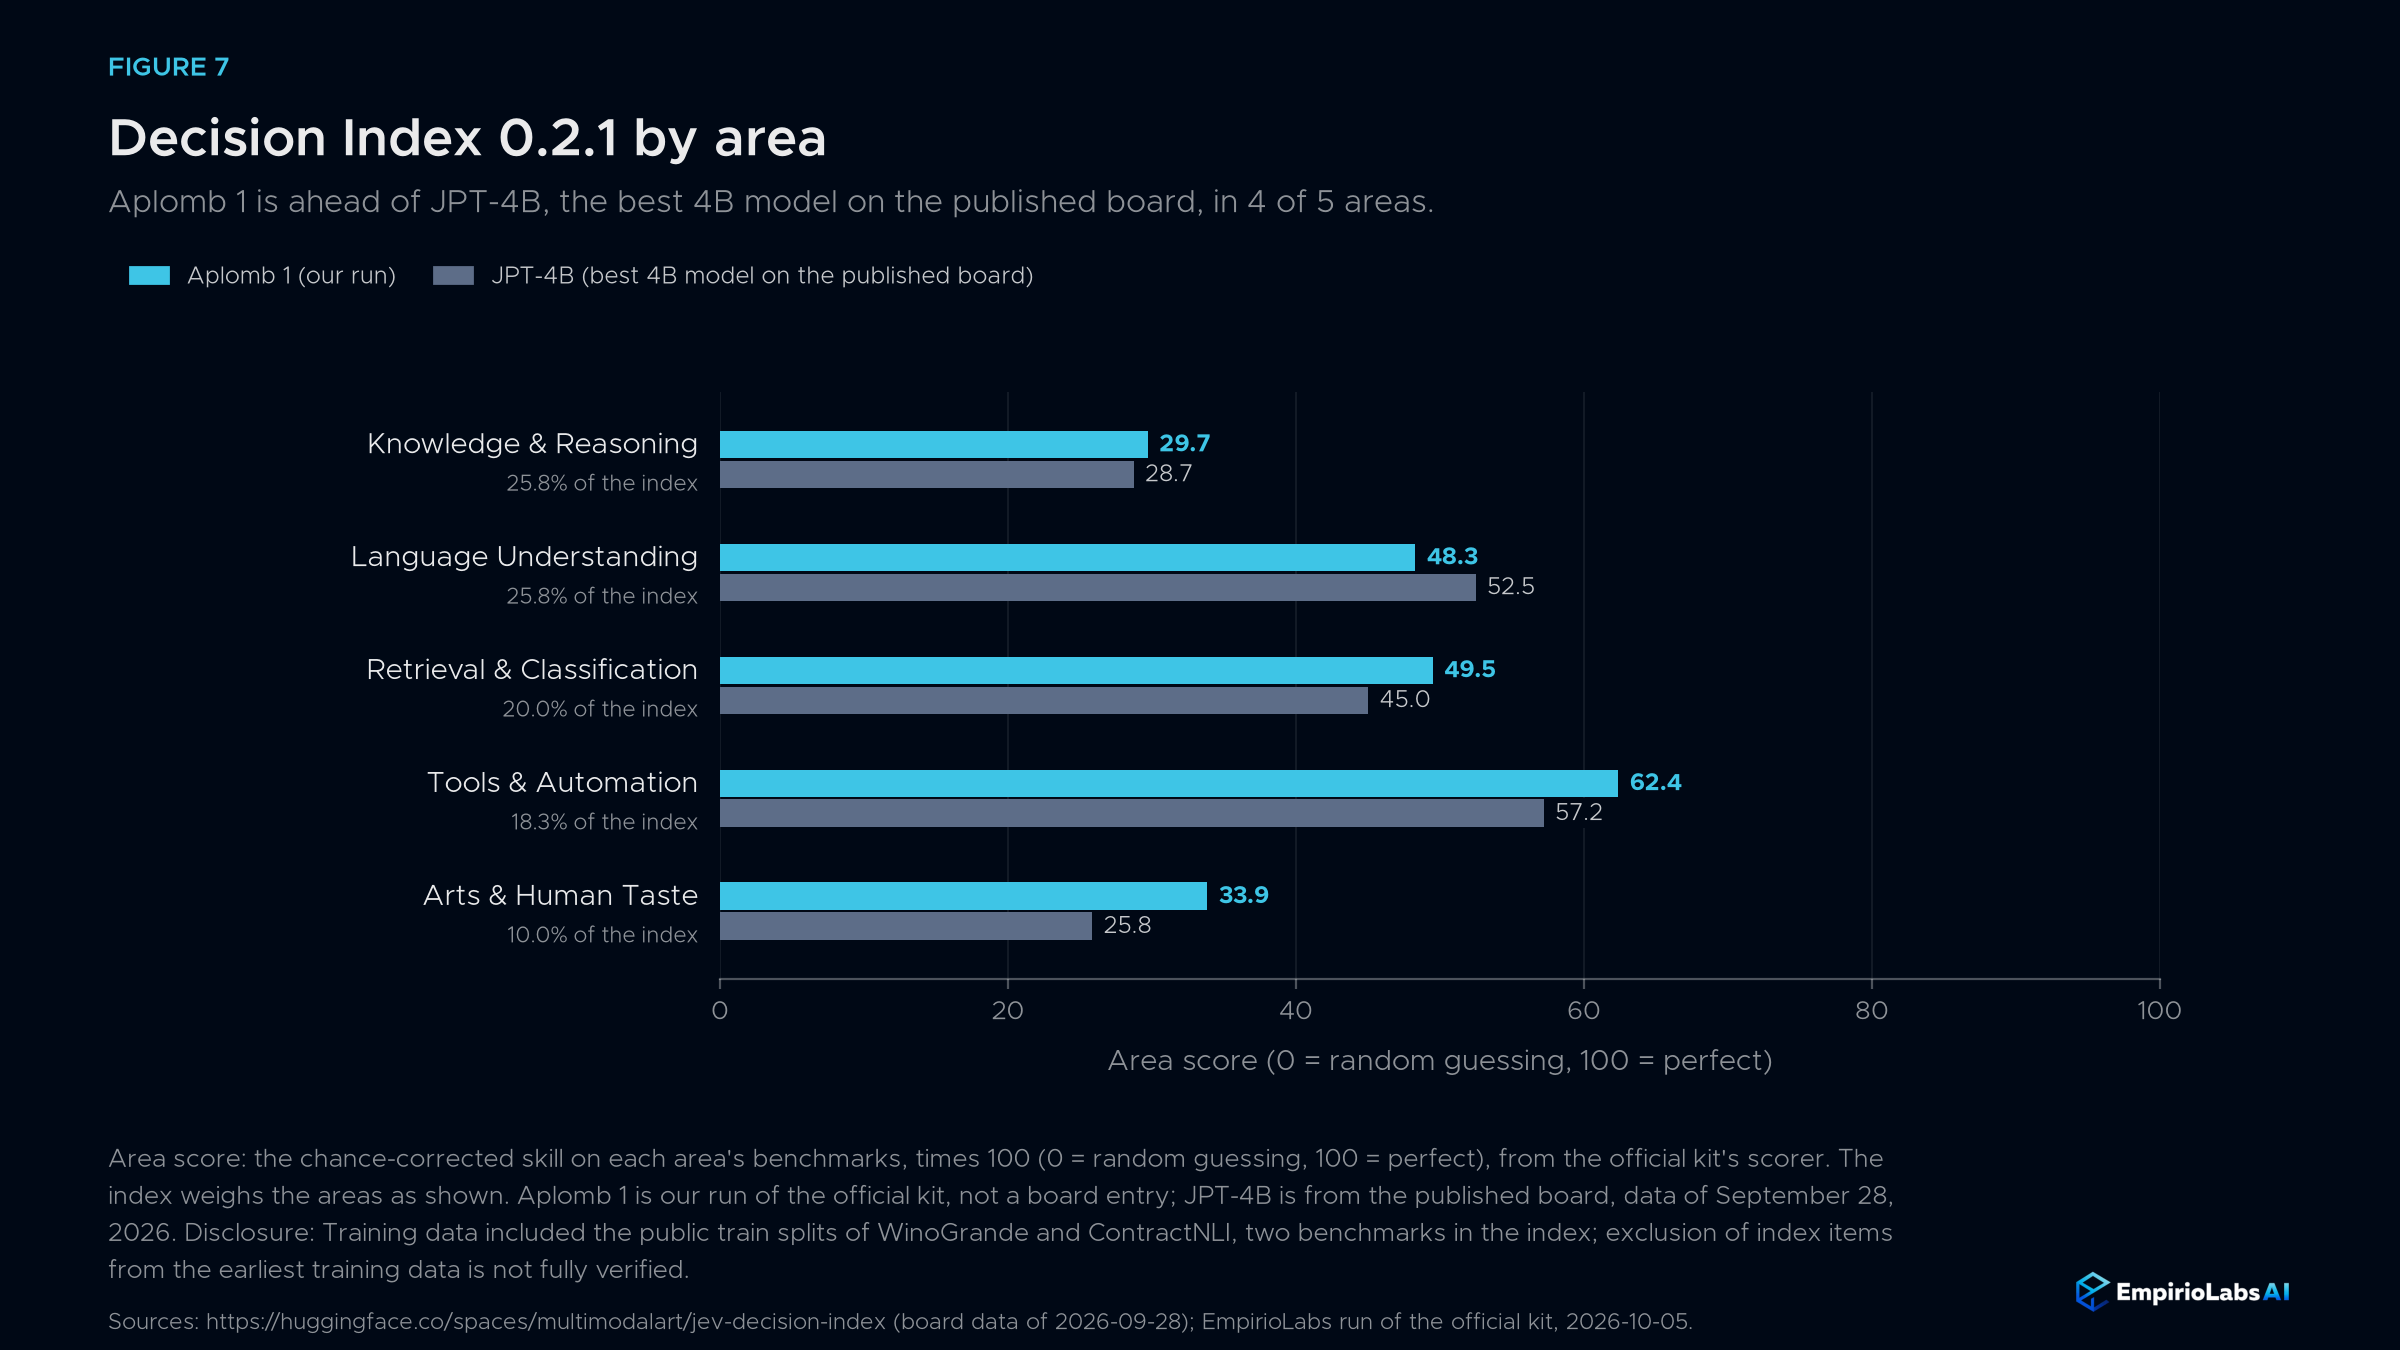
क्षेत्र के अनुसार, Aplomb 1 उपकरण और स्वचालन (62.4) और पुनर्प्राप्ति और वर्गीकरण (49.5) में उच्चतम स्कोर करता है। JPT-4B की तुलना में, यह पांच में से चार क्षेत्रों में आगे है और भाषा की समझ में पीछे है (52.5 के मुकाबले 48.3)।
निर्णय सूचकांक 0.3.2 (12 अक्टूबर, 2026)
Aplomb 1 हगिंग फेस पर प्रकाशित निर्णय सूचकांक 0.3.2 बोर्ड पर है, जो 149 सार्वजनिक पाठ बेंचमार्क पर 37 निर्णय मॉडल और 33 अन्य पर 11 विज़न मॉडल को रैंक करता है। 12 अक्टूबर, 2026 के बोर्ड पर, यह तीन परीक्षणों पर अपने आकार वर्ग में #1 है:
- आर-बेंच-एम, विज्ञान, इंजीनियरिंग और चिकित्सा से एक छवि के बारे में 665 विशेषज्ञ प्रश्न: 29.6, विजन बोर्ड पर 25B तक के मॉडल के बीच #1। 25B तक का अगला मॉडल, 12B, 24.9 स्कोर करता है, और सर्वश्रेष्ठ 4B मॉडल 19.5 स्कोर करता है। केवल 26B से 36B के मॉडल ही अधिक स्कोर करते हैं।
- जीपीक्यूए डायमंड, 196 पीएचडी-स्तर के विज्ञान प्रश्न: 48.0%, टेक्स्ट बोर्ड पर 8B के तहत मॉडल के बीच #1 (अगले 44.9%)।
- सीएफकलर, 5,000 रंग-पैलेट वरीयता भविष्यवाणियां: टेक्स्ट बोर्ड पर 65.6% से कम के मॉडल में #1%, #8 (अगला 64.7%)।
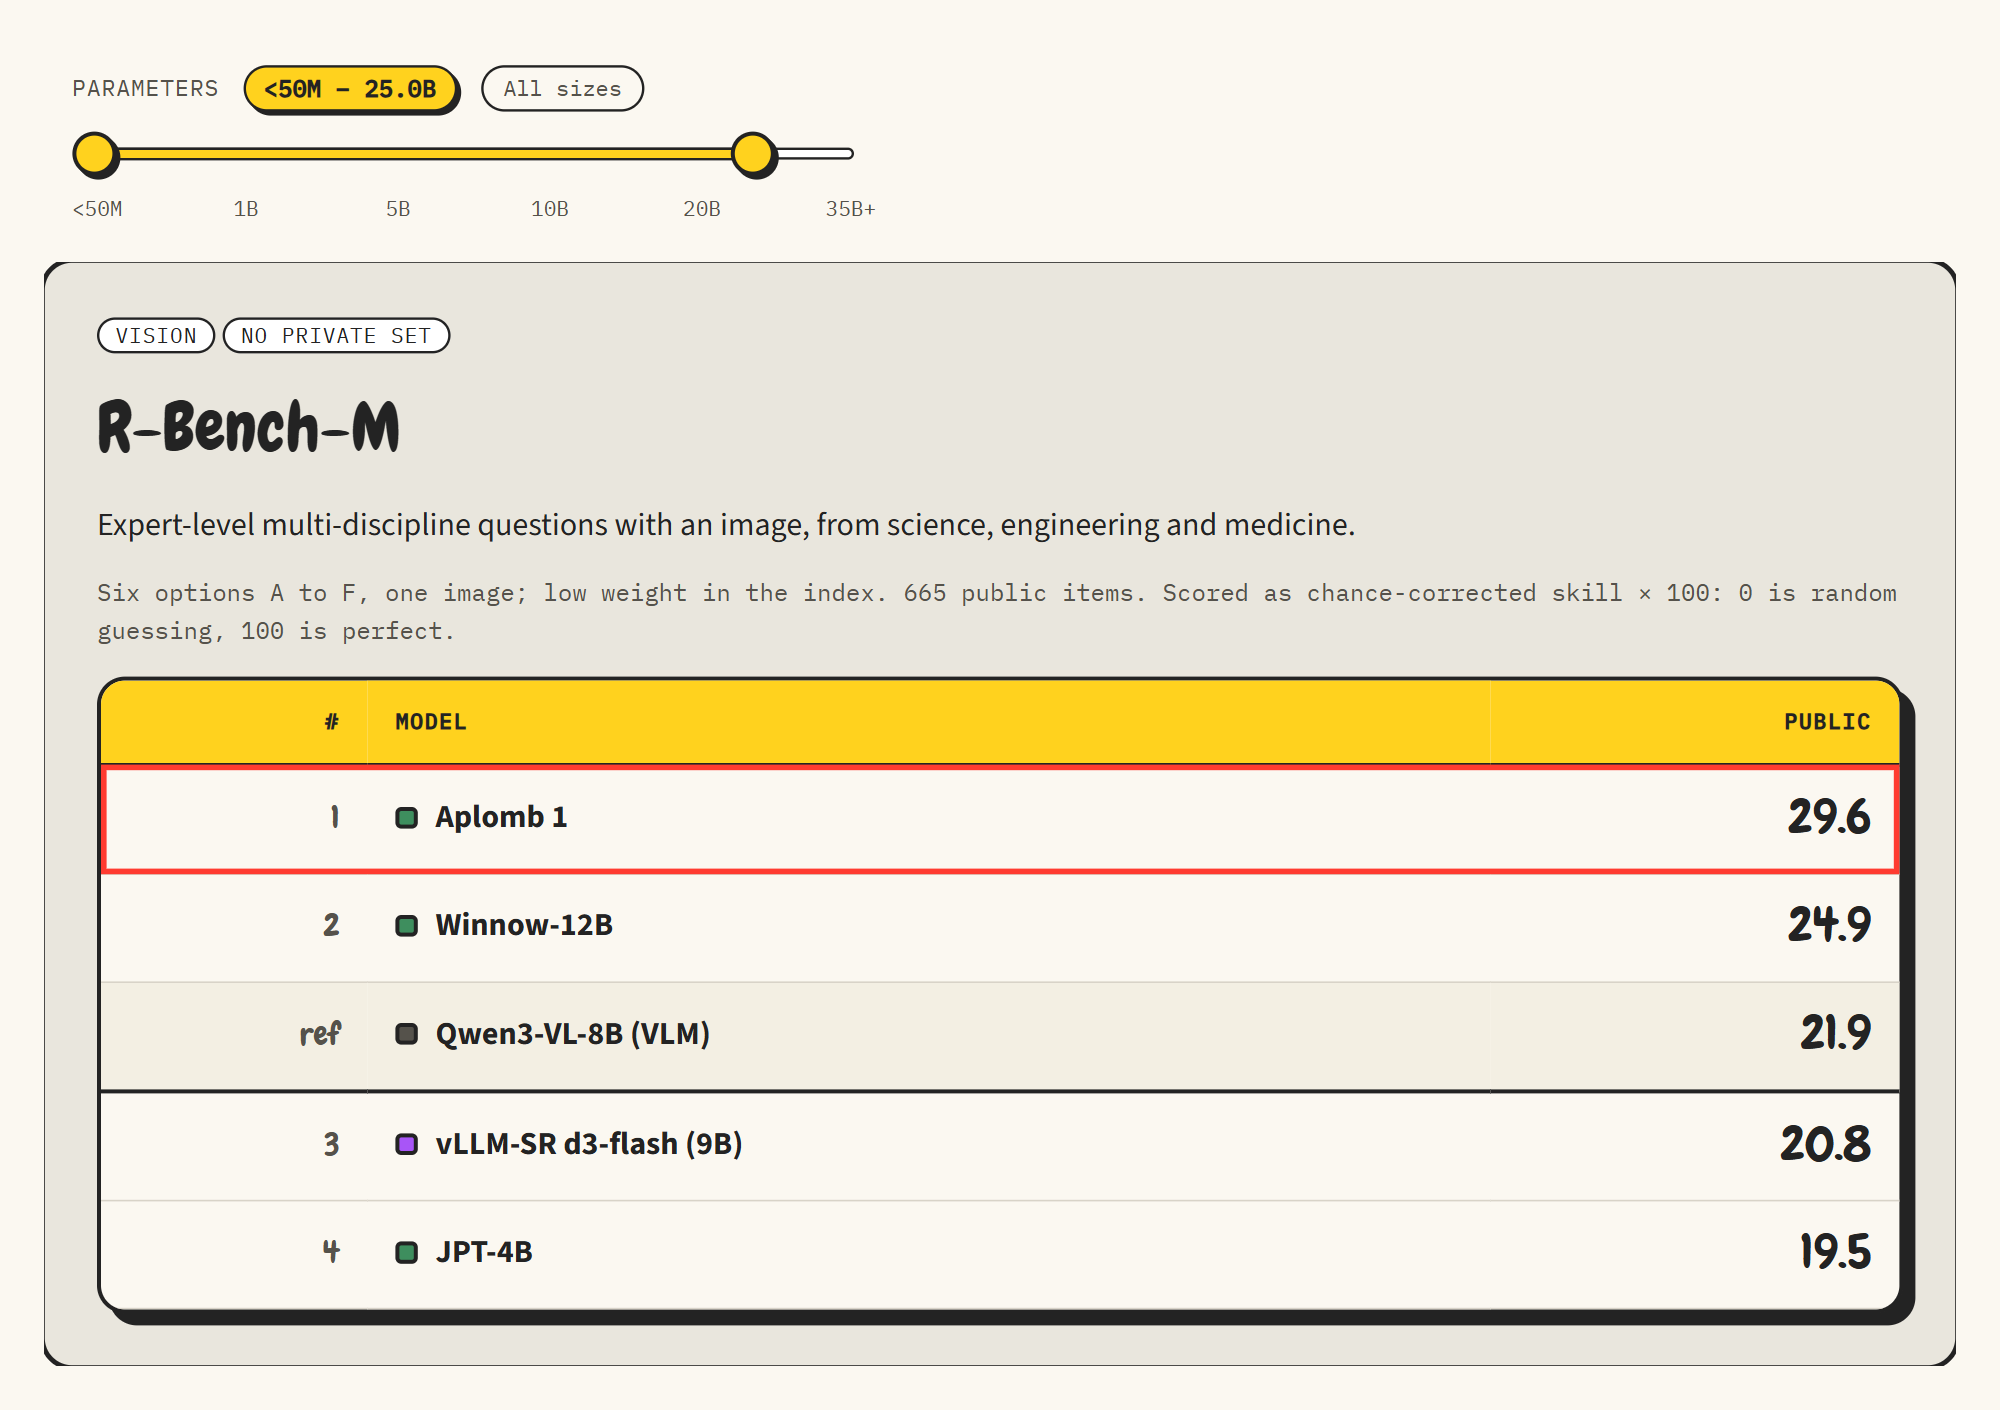
यह दृश्य देखने के लिए, खोलें विजन बोर्ड, पैरामीटर्स को 25B पर सेट करें और R-Bench-M की पूर्ण रैंकिंग खोलें।
प्रकटीकरण। Aplomb 1 के प्रशिक्षण डेटा में WinoGrande और ContractNLI के सार्वजनिक ट्रेन विभाजन शामिल थे, जो निर्णय सूचकांक 0.2.1 और 0.3.2 में दो बेंचमार्क थे। हम पूरी तरह से सत्यापित नहीं कर सके कि इंडेक्स आइटम को शुरुआती प्रशिक्षण डेटा से बाहर रखा गया था।
टाइप किए गए निर्णय
टाइप किए गए निर्णय एक आधिकारिक हगिंग फेस बेंचमार्क है (LocalLLaMA/typed-decisions). इसके परीक्षण विभाजन में 400 मामले और 2,000 निर्णय हैं, और प्रत्येक उत्तर सोने के मुकाबले स्कोर किया गया एक संभाव्यता वितरण है। 8 अक्टूबर, 2026 को, इसके लीडरबोर्ड ने अपने डिफ़ॉल्ट दृश्य में सोने के वितरण (0.123) और ब्रियर स्कोर (0.065) से KL विचलन पर Aplomb 1 #1 को स्थान दिया; दोनों के लिए कम बेहतर है। 5.3B पर, यह अपने आकार से लगभग पांच गुना 27B मॉडल से आगे था, जिसने 0.204 और 0.097 स्कोर किया।
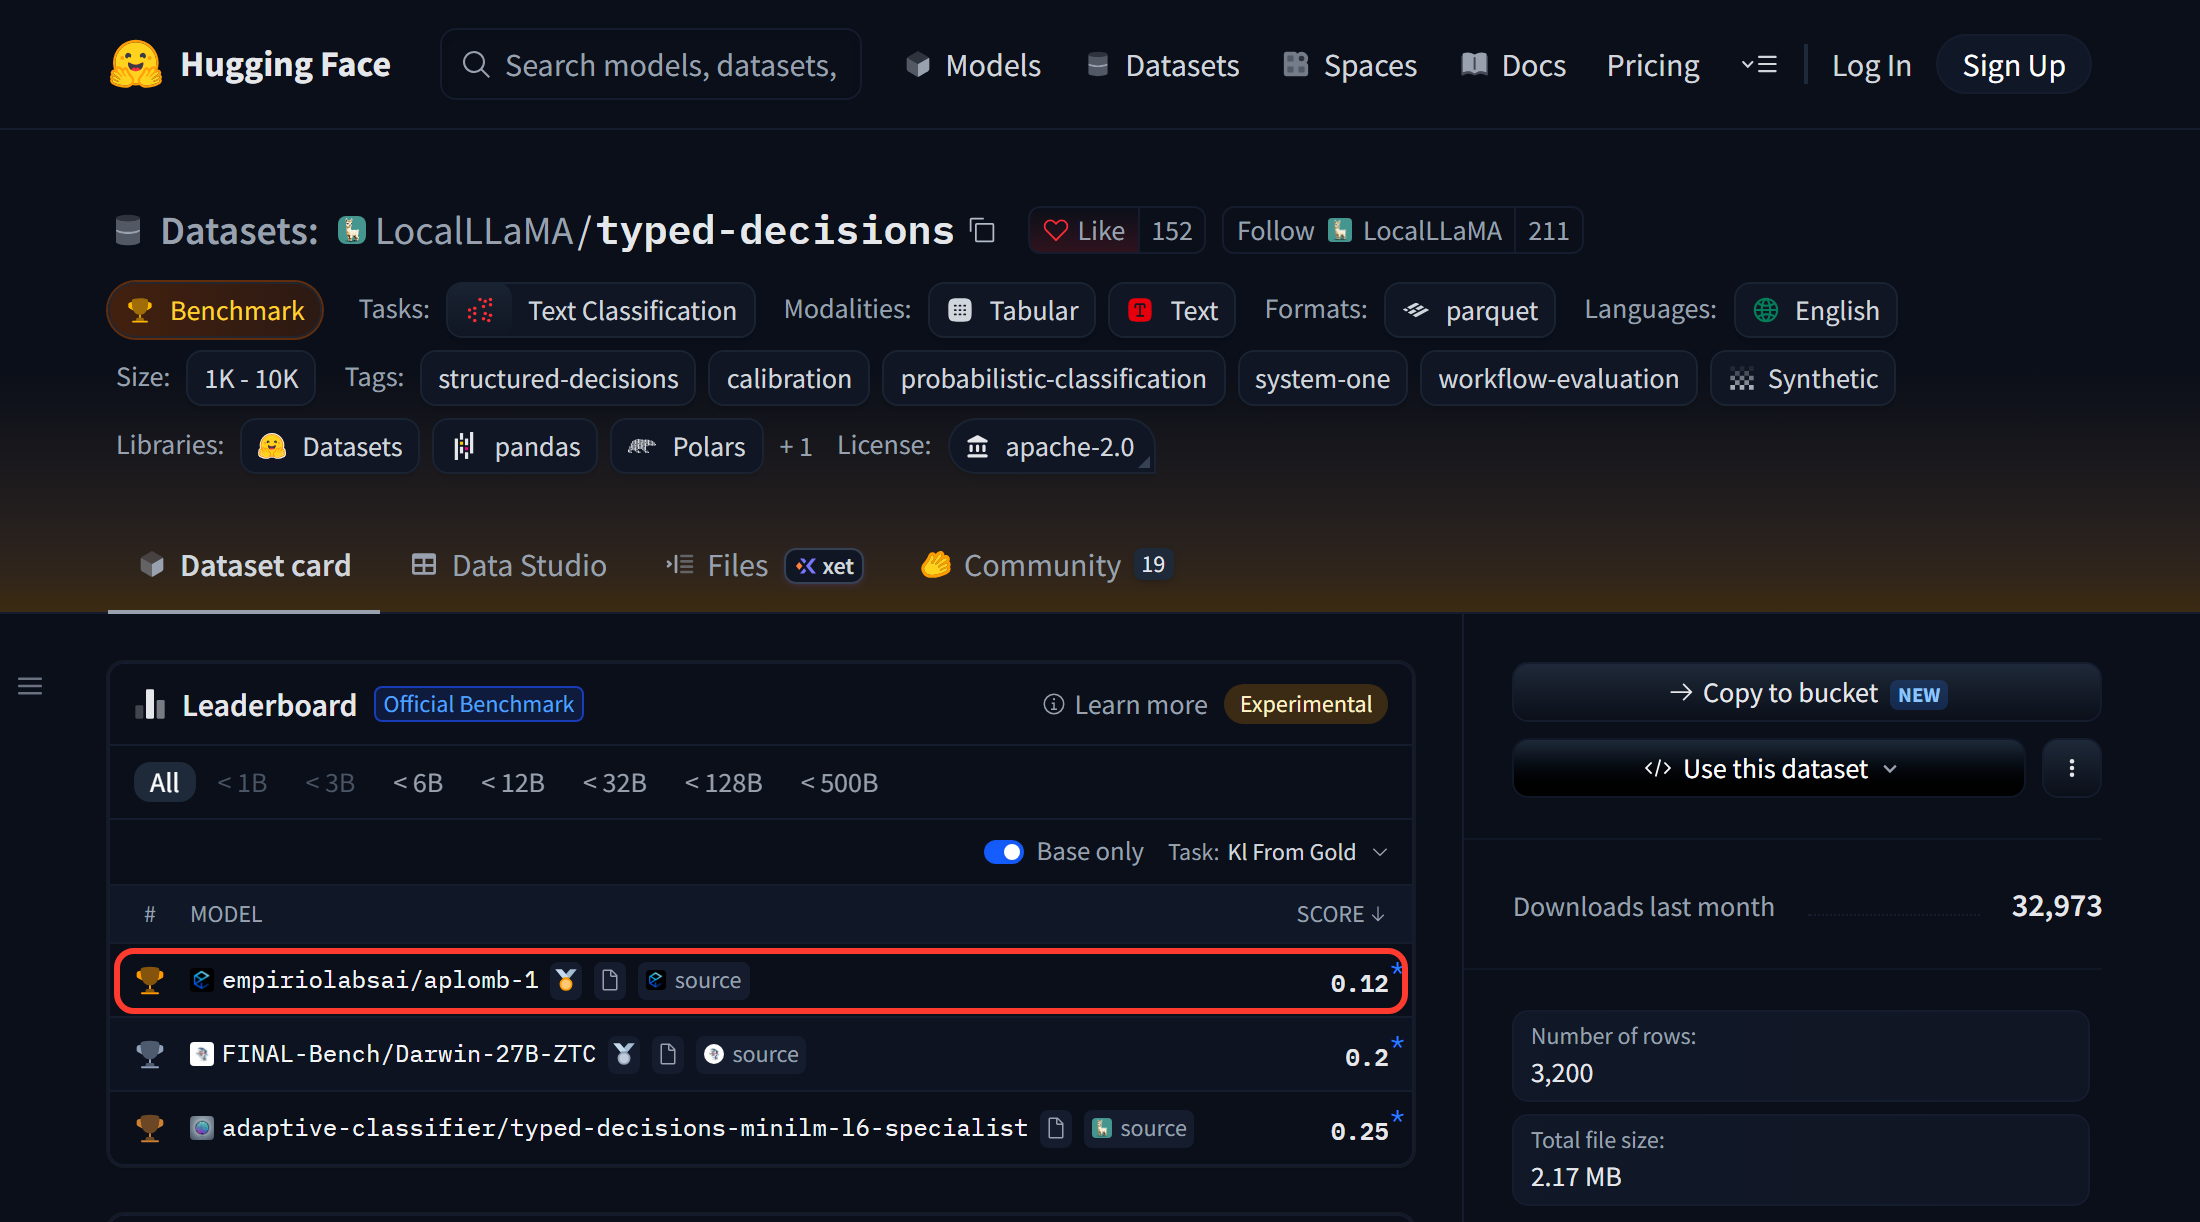
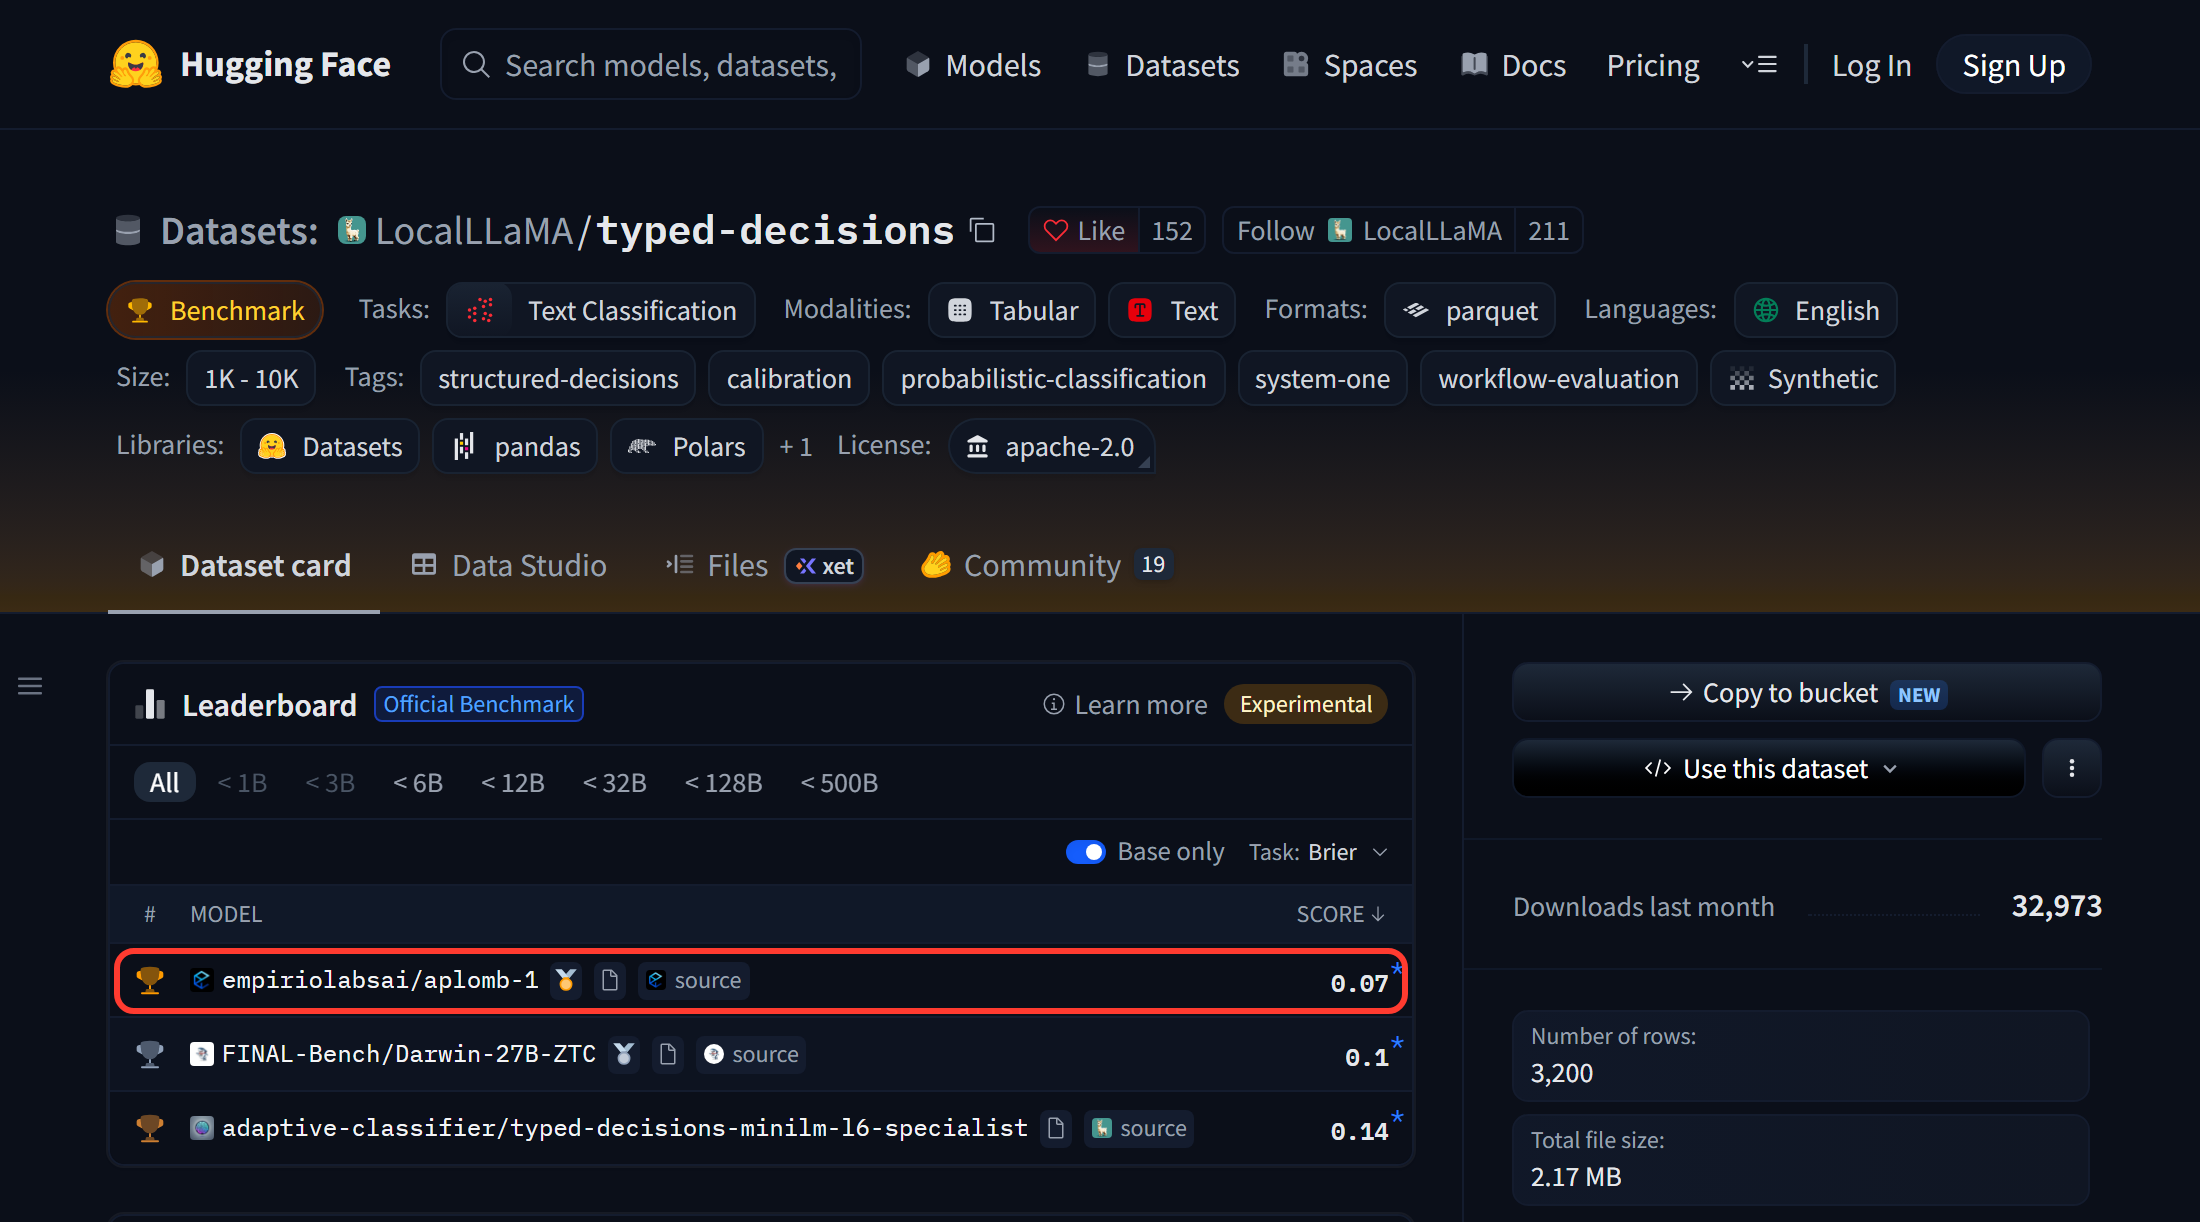
लीडरबोर्ड पर परिणाम प्रत्येक मॉडल के लेखकों द्वारा स्व-रिपोर्ट किए जाते हैं। Aplomb 1 के प्रशिक्षण डेटा में बेंचमार्क का ट्रेन विभाजन शामिल था; प्रशिक्षण के लिए परीक्षण विभाजन का उपयोग नहीं किया गया था।
यह कैसे तुलना करता है
प्रत्येक निर्णय मॉडल या एपीआई 29 सितंबर, 2026 तक 6 अक्टूबर, 2026 तक की कीमतों के साथ अपने स्वयं के प्रकाशित दस्तावेज़ों से क्या स्वीकार करता है और क्या उत्तर देता है:
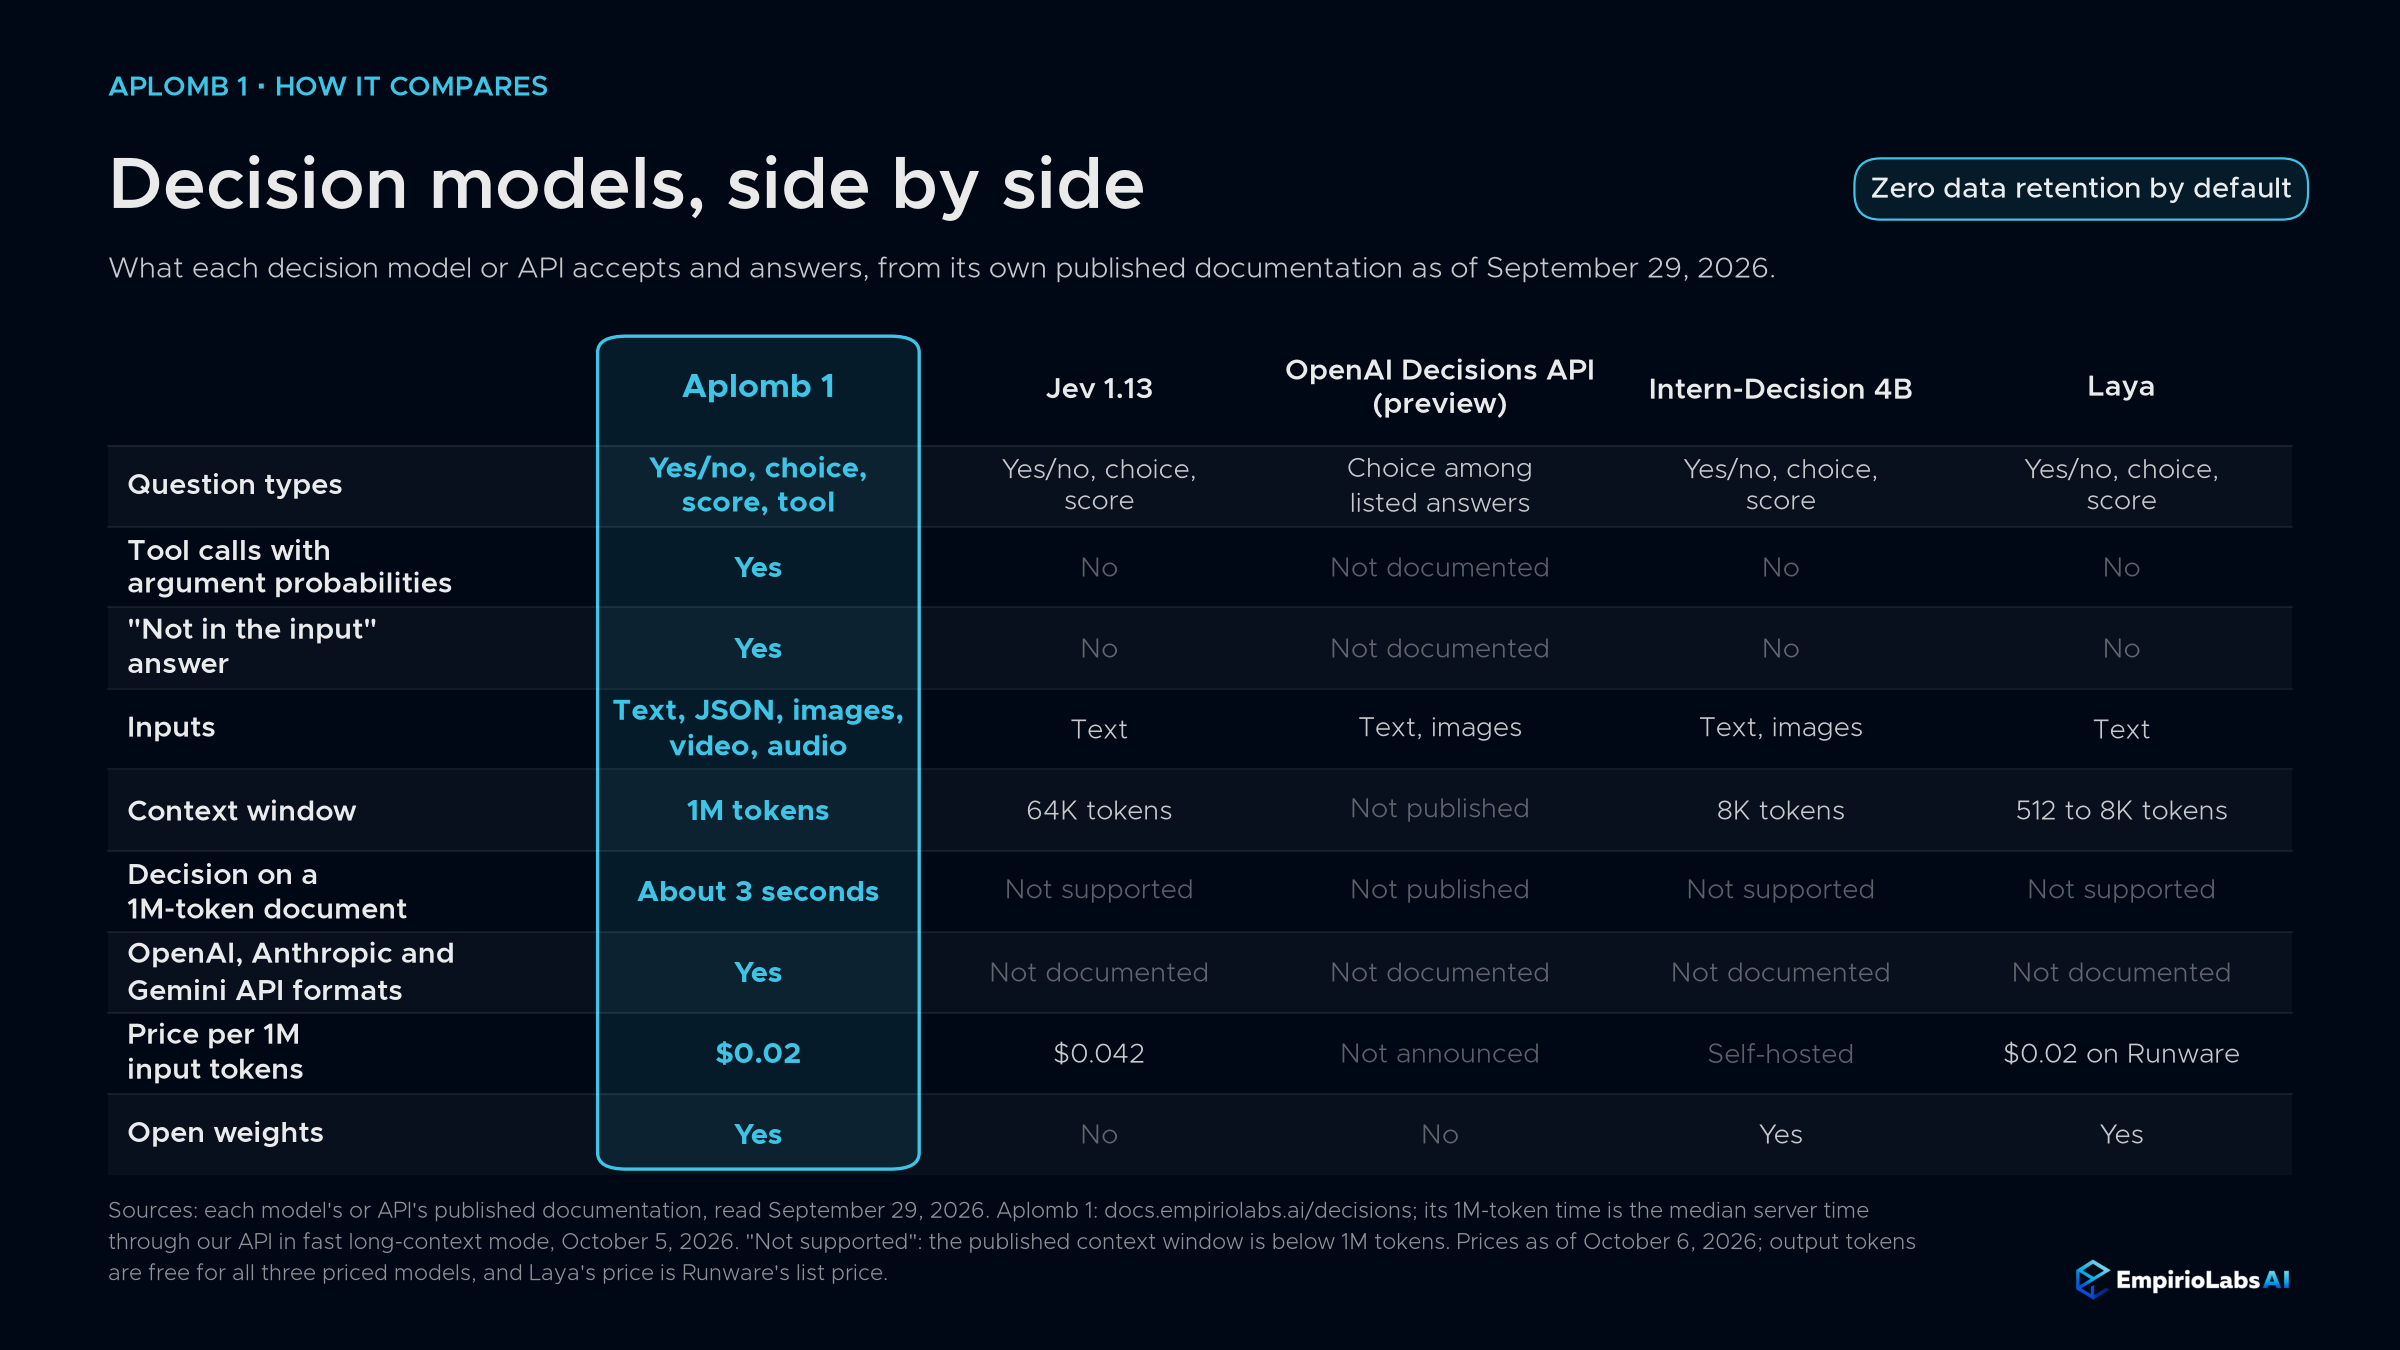
| आत्मविश्वास 1 | यहूदी 1.13 | OpenAI निर्णय API (पूर्वावलोकन) | इंटर्न-निर्णय 4B | लया | |
|---|---|---|---|---|---|
| प्रश्नों के प्रकार | हां या नहीं, पसंद, स्कोर, उपकरण | हां या नहीं, पसंद, स्कोर | सूचीबद्ध उत्तरों में से विकल्प | हां या नहीं, पसंद, स्कोर | हां या नहीं, पसंद, स्कोर |
| तर्क संभावनाओं के साथ उपकरण चयन | हाँ | नहीं | प्रलेखित नहीं | नहीं | नहीं |
| राज्य में नहीं जवाब | हाँ | नहीं | प्रलेखित नहीं | नहीं | नहीं |
| इनपुट | टेक्स्ट, JSON, छवियाँ, वीडियो, ऑडियो | टेक्स्ट | पाठ, चित्र | पाठ, चित्र | टेक्स्ट |
| खिड़की | 1,000,000 टोकन | 64K टोकन | प्रकाशित नहीं हुआ | 8,192 टोकन | 512 से 8,192 टोकन |
| मूल्य प्रति 1M इनपुट टोकन | $0.02 | $0.042 | घोषणा नहीं की गई | स्व-होस्टेड | रनवेयर पर $0.02 |
| खुले वजन | हाँ | नहीं | नहीं | हाँ | हाँ |
गति और बिलिंग
Aplomb 1 निर्णय मॉडल के लिए EmpirioLabs के अपने अनुमान रनटाइम पर चलता है। एक छोटे से प्रश्न में लगभग 15 एमएस मॉडल समय लगता है, लगभग 35 एमएस की छवि वाला एक प्रश्न, लगभग 0.3 सेकंड का 15,000-टोकन दस्तावेज़, और तेज़ लंबे-संदर्भ मोड में लगभग 3 सेकंड की 1M-टोकन स्थिति, 131,072 टोकन से ऊपर का डिफ़ॉल्ट, या लगभग 111 सेकंड पूरा पढ़ा जाता है।
आप केवल इनपुट टोकन के लिए भुगतान करते हैं: राज्य प्रति अनुरोध एक बार और प्रत्येक प्रश्न का अपना पाठ, कभी भी एक त्वरित टेम्पलेट नहीं। आउटपुट टोकन हमेशा शून्य होते हैं। वर्तमान दर पर है मॉडल पेज और मूल्य निर्धारण पृष्ठ।.
शून्य डेटा प्रतिधारण डिफ़ॉल्ट रूप से चालू है: हम आपके अनुरोधों या प्रतिक्रियाओं की सामग्री को बरकरार नहीं रखते हैं।
खुले वजन
Aplomb 1 Qwen3.5-4B पर बनाया गया है। हमने इसकी विंडो को 262K से 1M टोकन तक बढ़ाया, Qwen3-Omni के ऑडियो एनकोडर के साथ ऑडियो इनपुट जोड़ा, अपना स्वयं का निर्णय सिर जोड़ा, जो उत्पन्न पाठ के बजाय कैलिब्रेटेड संभावनाओं के रूप में हर उत्तर लौटाता है, और उपकरण चयन और not-in-the-input उत्तर सहित निर्णयों के लिए मॉडल को प्रशिक्षित करता है। एपीआई और Playground के लिए, हमने अपना स्वयं का अनुमान रनटाइम बनाया और अनुकूलित किया।
वज़न और उन्हें स्वयं चलाने के लिए एक संदर्भ स्क्रिप्ट पर हैं huggingface.co/empiriolabsai/aplomb-1. स्क्रिप्ट के उत्तर एपीआई से थोड़े भिन्न हो सकते हैं।
US$1 मिलियन से कम वार्षिक राजस्व वाले संगठनों द्वारा अनुसंधान, मूल्यांकन, व्यक्तिगत उपयोग और आंतरिक उपयोग EmpirioLabs मॉडल लाइसेंस के तहत मुफ्त हैं; Aplomb 1 को एक सेवा के रूप में होस्ट करना या इसे दूसरों को बेचे गए उत्पाद में शिपिंग करना एक वाणिज्यिक लाइसेंस की आवश्यकता होती है।
शुरू हो जाओ
कर्ल https://api.empiriolabs.ai/v1/decisions \ -एच "प्राधिकरण: वाहक $EMPIRIOLABS_एपीआई_की" \ -एच "सामग्री-प्रकार: application/json" \ -डी '{ "मॉडल": "aplomb-1", "state": {"order": {"id": "B-44120", "status": "भेज दिया गया", "भुगतान": "अवैतनिक"}}, "प्रश्न": { "भुगतान": {"प्रकार": "noul", "निर्देश": "क्या ऑर्डर B-44120 का भुगतान किया गया है?", "परहेज": true}, "वाहक": {"प्रकार": "पसंद", "निर्देश": "कौन सा वाहक ऑर्डर B-44120 वितरित कर रहा है?", "मानदंड": {"UPS": शून्य, "फेडेक्स": शून्य, "डीएचएल": शून्य}, "परहेज": सच}} }'भुगतान किया एक आत्मविश्वास के रूप में वापस आता है। रोग संवाहक उच्च के साथ वापस आता है तटस्थ रहना संभाव्यता, क्योंकि रिकॉर्ड एक वाहक का नाम नहीं देता है। पूर्ण स्कीमा, मीडिया इनपुट और सीमाएं निर्णय एपीआई गाइड. Aplomb 1 OpenAI, Anthropic और Gemini प्रारूपों में भी अनुरोध स्वीकार करता है, ताकि आप इसे उनके SDK से कॉल कर सकें; गाइड का चैट प्रारूप सेक्शन दिखाता है कि चैट अनुरोध किसी निर्णय के लिए कैसे मैप करता है. इसमें कोड के बिना इसे आज़माएं Playground।.
स्वीकृतियाँ
हमने डेटा, प्रशिक्षण, मूल्यांकन और तैनाती में अपने एआई एजेंट हार्नेस की मदद से Aplomb 1 का निर्माण किया। Qwen3.5 और Qwen3-Omni के लिए Qwen टीम को धन्यवाद, जिस पर Aplomb 1 बनाता है, लैम्ब्डा को उन GPU के लिए जिन्हें हमने प्रशिक्षित किया और इसे परोसा, और NVIDIA इंसेप्शन प्रोग्राम, Z.ai स्टार्टअप प्रोग्राम और स्टेपफन स्टार्टअप प्रोग्राम को उनके समर्थन के लिए।