Aplomb 1 est notre premier modèle. Il prend du texte, du JSON, des images, de l’audio et de la vidéo en une seule requête, lit jusqu’à 1 million de jetons, et prend une décision sur un document à 1 million de jetons en environ 3 secondes. Une question courte prend environ 15 ms de temps de modèle.
Il fonctionne sur un runtime d’inférence que nous avons construit pour les modèles décisionnels. Sur notre API et dans le Playground, les documents longs passent en mode rapide à long contexte: un document à 1M de jeton prend environ 3 secondes au lieu de 111, et le mode rapide a répondu correctement à toutes les 525 décisions de nos tests à long contexte.
Pour les agents, Aplomb 1 retourne une probabilité pour chaque outil et pour chaque argument enum et booléen dans une requête, donc un agent agit lorsque le modèle est sûr et escalade quand il ne l’est pas. Chaque réponse est calibrée, et elle peut indiquer quand l’entrée ne contient pas la réponse au lieu de deviner. Elle est conçue pour les décisions prises par logiciel des milliers de fois par jour, du routage d’un ticket au choix du prochain outil d’un agent.
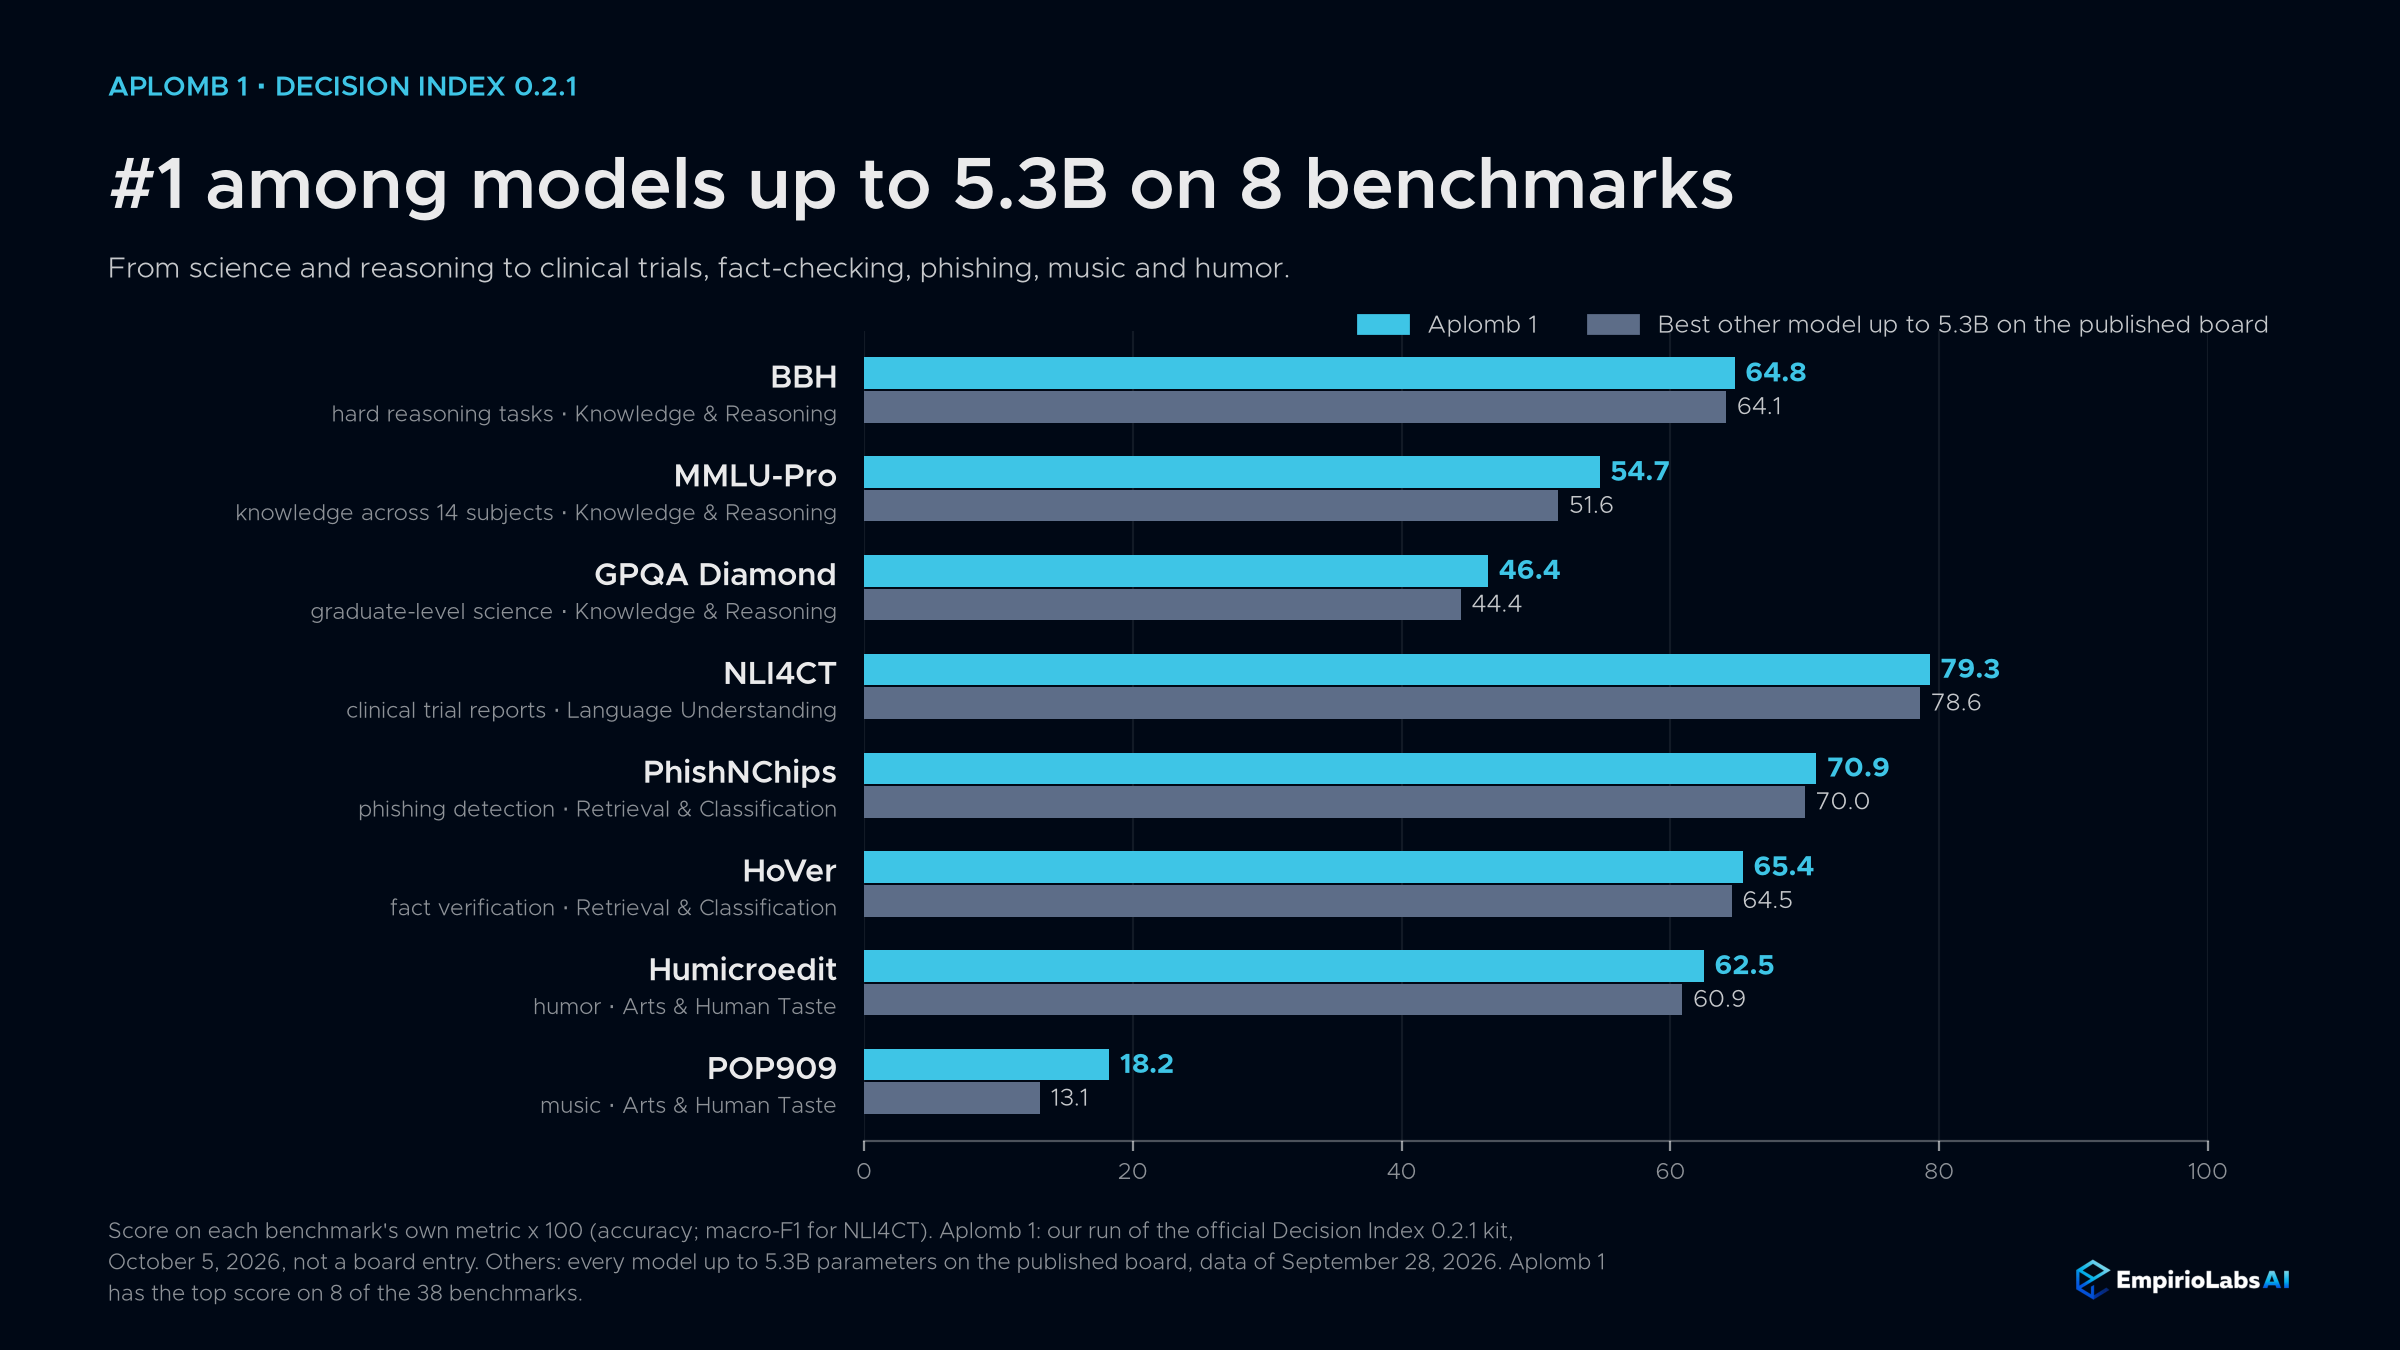
Sur le tableau publié de l’Indice de décision 0.2.1 (données du 28 septembre 2026), il est #1 parmi les modèles 4B, avec 44,86 sur notre version officielle, et #1 parmi les modèles jusqu’à 5,3 milliards de paramètres sur 8 des 38 benchmarks. Sur le tableau Decision Index 0.3.2 du 12 octobre 2026, il est #1 dans sa catégorie de taille sur R-Bench-M, GPQA Diamond et cfcolor. Il est disponible aujourd’hui dans l’API EmpirioLabs et Playground, et ses poids sont sur Hugging Face sous licence EmpirioLabs Modèle.
| Aplomb 1 en un coup d’œil | |
|---|---|
| Entrées | Texte, JSON, images, vidéo et audio, dans tous les mélanges |
| Fenêtre | 1 000 000 de jetons d’État plus question |
| Questions | Oui ou non, choix (2 à 255 options), score (2 à 10 niveaux), sélection d’outils |
| Pas dans l’État | Une probabilité que l’entrée ne détient pas la réponse |
| Sélection d’outils | L’outil suivant à appeler, avec les probabilités pour ses arguments énum et booléens |
| Vitesse | Environ 15 ms de temps de modélisation pour une question courte; environ 3 secondes pour un document de 1 M de jeton en mode rapide à long contexte |
| Formats API | L’API Decisions, ainsi que les formats OpenAI, Anthropic et Gemini |
| Facturation | Uniquement les jetons d’entrée; les jetons de sortie sont toujours à zéro |
| Conservation des données | Aucune conservation des données par défaut |
| Taille | 5,3 milliards de paramètres, construits sur Qwen3.5-4B; poids ouverts sur Hugging Face |
| Indice de décision 0.2.1 | 44,86 sur notre édition du kit officiel, #1 parmi les modèles 4B sur la carte 0.2.1 publiée (données du 28 septembre 2026) |
| Indice de décision 0.3.2 | #1 dans sa catégorie de taille sur R-Bench-M (jusqu’à 25B), GPQA Diamond et cfcolor (sous 8B), planches du 12 octobre 2026 |
| Décisions dactylographiées | #1 sur la divergence KL (0,123) et le score Brier (0,065) dans la vue par défaut du classement Hugging Face, 8 octobre 2026 |
Ce qu’il répond
Quatre types de questions. Noul Répond par oui ou non avec la probabilité de oui. Choix Il choisit l’une des 2 à 255 options et retourne la distribution complète. Partition place l’État sur une échelle ordonnée de 2 à 10 niveaux. outil choisit quels outils de fonction appeler et retourne des distributions au lieu de ses arguments enum et booléen.
Pas dans l’État. Ajouter « abstenir »: vrai à une question et la réponse comporte aussi la probabilité que l’état ne contienne pas ce dont la question a besoin. Un enregistrement sans champ porteuse obtient une forte probabilité d’abstinence au lieu d’une supposition confiante.
Réponses indépendantes. Jusqu’à 128 questions partagent un même état, et chacune est répondue seule, donc ajouter une question ne change jamais une autre réponse.
Sélection d’outils pour les agents
Donnez à Aplomb 1 les outils de fonction de votre agent et l’état actuel (un ticket, une conversation, un enregistrement), et il renvoie l’outil à appeler ensuite avec une probabilité pour chaque outil et une distribution pour chaque argument enum et booléen, dans une seule requête. Un LLM général écrit un outil qui appelle jeton par jeton sans préciser à quel point il est certain de l’outil ou d’un argument. L’agent agit lorsque la probabilité est élevée et transmet l’étape à un modèle plus large quand ce n’est pas le cas, donc les étapes de routine sautent une réponse générée. Nous n’avons trouvé aucun autre modèle décisionnel qui renvoie les probabilités d’arguments.
Un ticket qui dit « Commande B-44120 arrivée avec un écran fissuré. Je veux récupérer mon argent. » avec trois outils, issue_refund (a Raison enum et a full_refund booléen), track_package et escalate_to_human, revient comme (abrégé, arrondi):
{"outil »: « issue_refund », « probabilités »: {"issue_refund »: 0,969, « aucune »: 0,025, « escalate_to_human »: 0,005, « track_package »: 0,002}, « arguments »: {"issue_refund »: { « raison »: {"valeur »: « endommagée », « probabilités »: {"endommagée »: 0,993, « not_as_described »: 0,007, « tardive »: 0,001}, « full_refund »: {"valeur »: vraie, « probability_true »: 0,761}}, « open_arguments »: {"track_package »: ["order_id"]}}
Les arguments en texte libre, tels qu’un identifiant d’ordre, sont listés sous open_arguments pour que l’agent le remplisse.
Entrées mixtes, jusqu’à 1 million de jetons
Le texte, les objets JSON et les tableaux, les images, la vidéo et l’audio entrent dans le même état, dans n’importe quelle combinaison: un enregistrement d’appel support à côté de l’enregistrement du compte, un clip de dashcam à côté du formulaire de réclamation, une photo de produit à côté de l’annonce. L’État plus la question la plus longue peut atteindre 1 000 000 de jetons, ce qui suffit pour un long contrat, une année de tickets ou des heures de transcriptions en une seule demande.
Comment il marque
Nous avons exécuté Aplomb 1 et trois modèles de décision ouverts 4B sur les mêmes éléments, et fixé les chiffres publiés par Intern-Decision pour Jev, JevK5 et Semif à côté. Sur les rapports Intern-Decision en set suites, Aplomb 1 affiche en moyenne 88,7 %. Face à la ligne publiée par Jev, il est en tête sur JevBench Hard et les décisions typées, au niveau sur JevBench Easy, et en retard sur JevBench Original, ToolACE, AG News et WildJailbreak. Sa plus grande avance est sur JevBench Hard, +5,4 points.
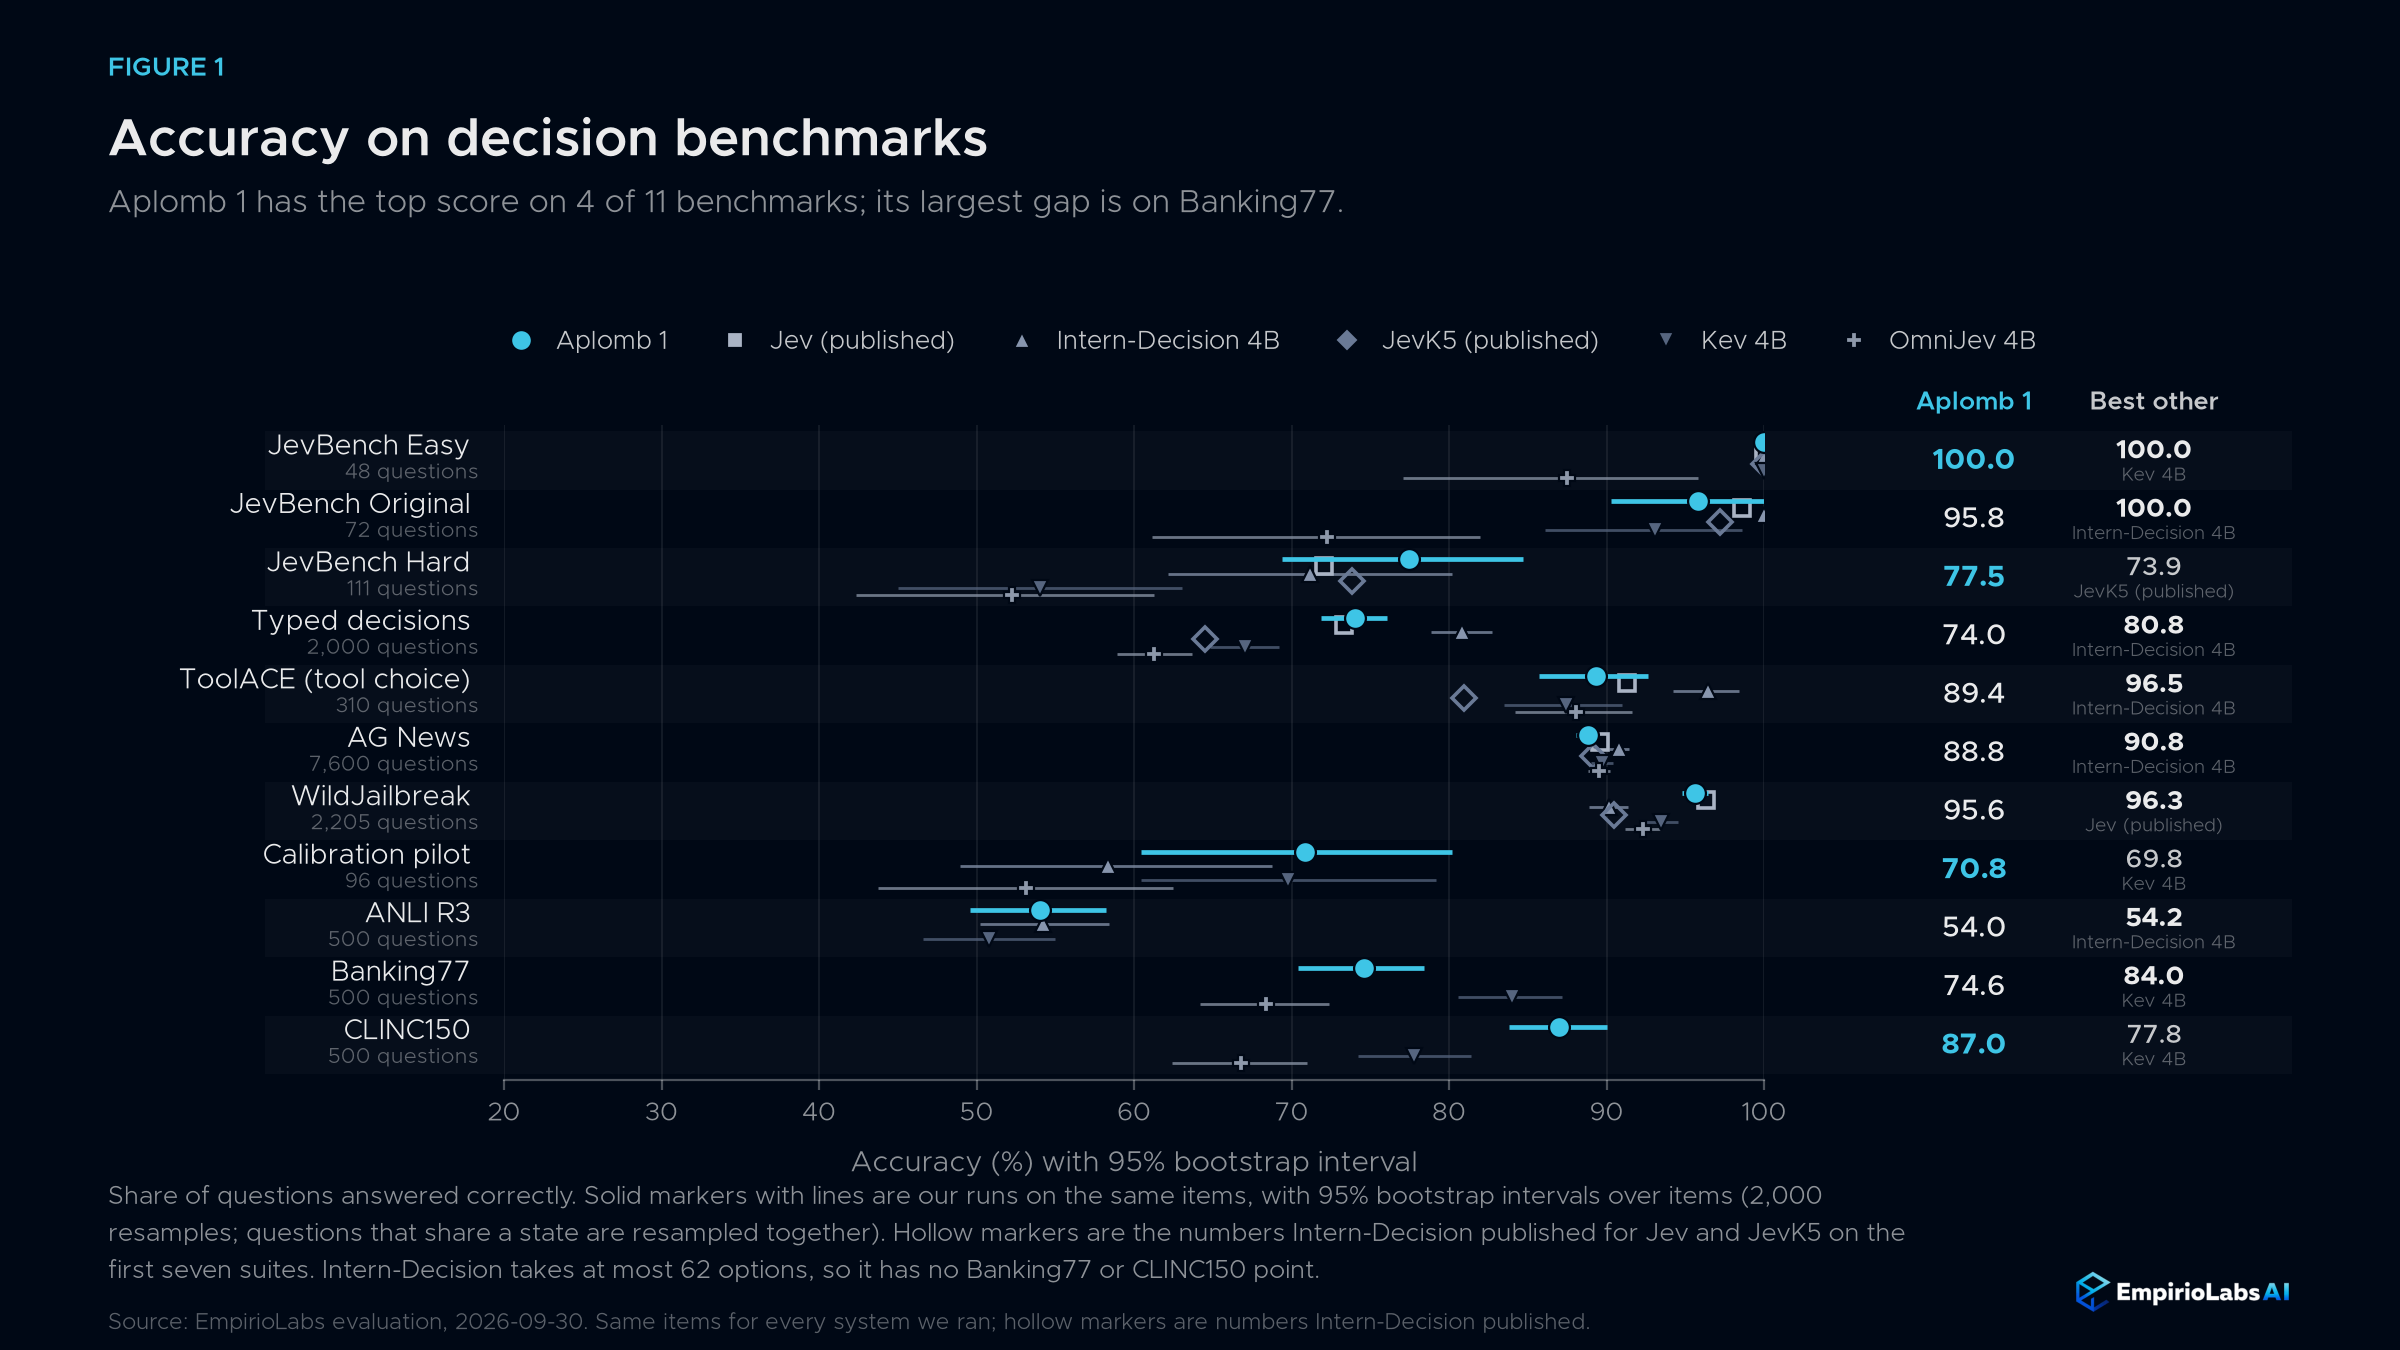
| Référence | Aplomb 1 | Jev (p) | JevK5 (p) | Semif (p) | Décision de stage 4B | Kev 4B | OmniJev 4B |
|---|---|---|---|---|---|---|---|
| JevBench Easy | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 87.5 |
| JevBench Original | 95.8 | 98.6 | 97.2 | 98.6 | 100.0 | 93.1 | 72.2 |
| JevBench Difficile | 77.5 | 72.1 | 73.9 | 61.3 | 71.2 | 54.1 | 52.3 |
| Décisions dactylographiées | 74.0 | 73.3 | 64.5 | 62.8 | 80.8 | 67.0 | 61.3 |
| ToolACE | 89.4 | 91.3 | 81.0 | 85.2 | 96.5 | 87.4 | 88.1 |
| AG News | 88.8 | 89.6 | 89.1 | 89.2 | 90.8 | 89.7 | 89.6 |
| WildJailbreak | 95.6 | 96.3 | 90.5 | 92.5 | 90.2 | 93.5 | 92.3 |
| Moyenne | 88.7 | 88.7 | 85.2 | 84.2 | 89.9 | 83.5 | 77.6 |
(p) Comme publié par Intern-Decision pour les mêmes éléments. Intern-Decision rapporte 90,02 pour son modèle 4B sur ce pack; la colonne montre notre parcours.
| Référence | Aplomb 1 | Décision de stage 4B | Kev 4B | OmniJev 4B |
|---|---|---|---|---|
| Pilote d’étalonnage | 70.8 | 58.3 | 69.8 | 53.1 |
| ANLI R3 | 54.0 | 54.2 | 50.8 | n/a |
| Banking77 (77 options) | 74.6 | n/a | 84.0 | 68.4 |
| CLINC150 (150 options) | 87.0 | n/a | 77.8 | 66.8 |
Entrées longues
Nous avons mesuré les recherches dans des registres d’ordre allant de 16K à 1M de jetons, avec les questions sur un ordre placées à une profondeur aléatoire.
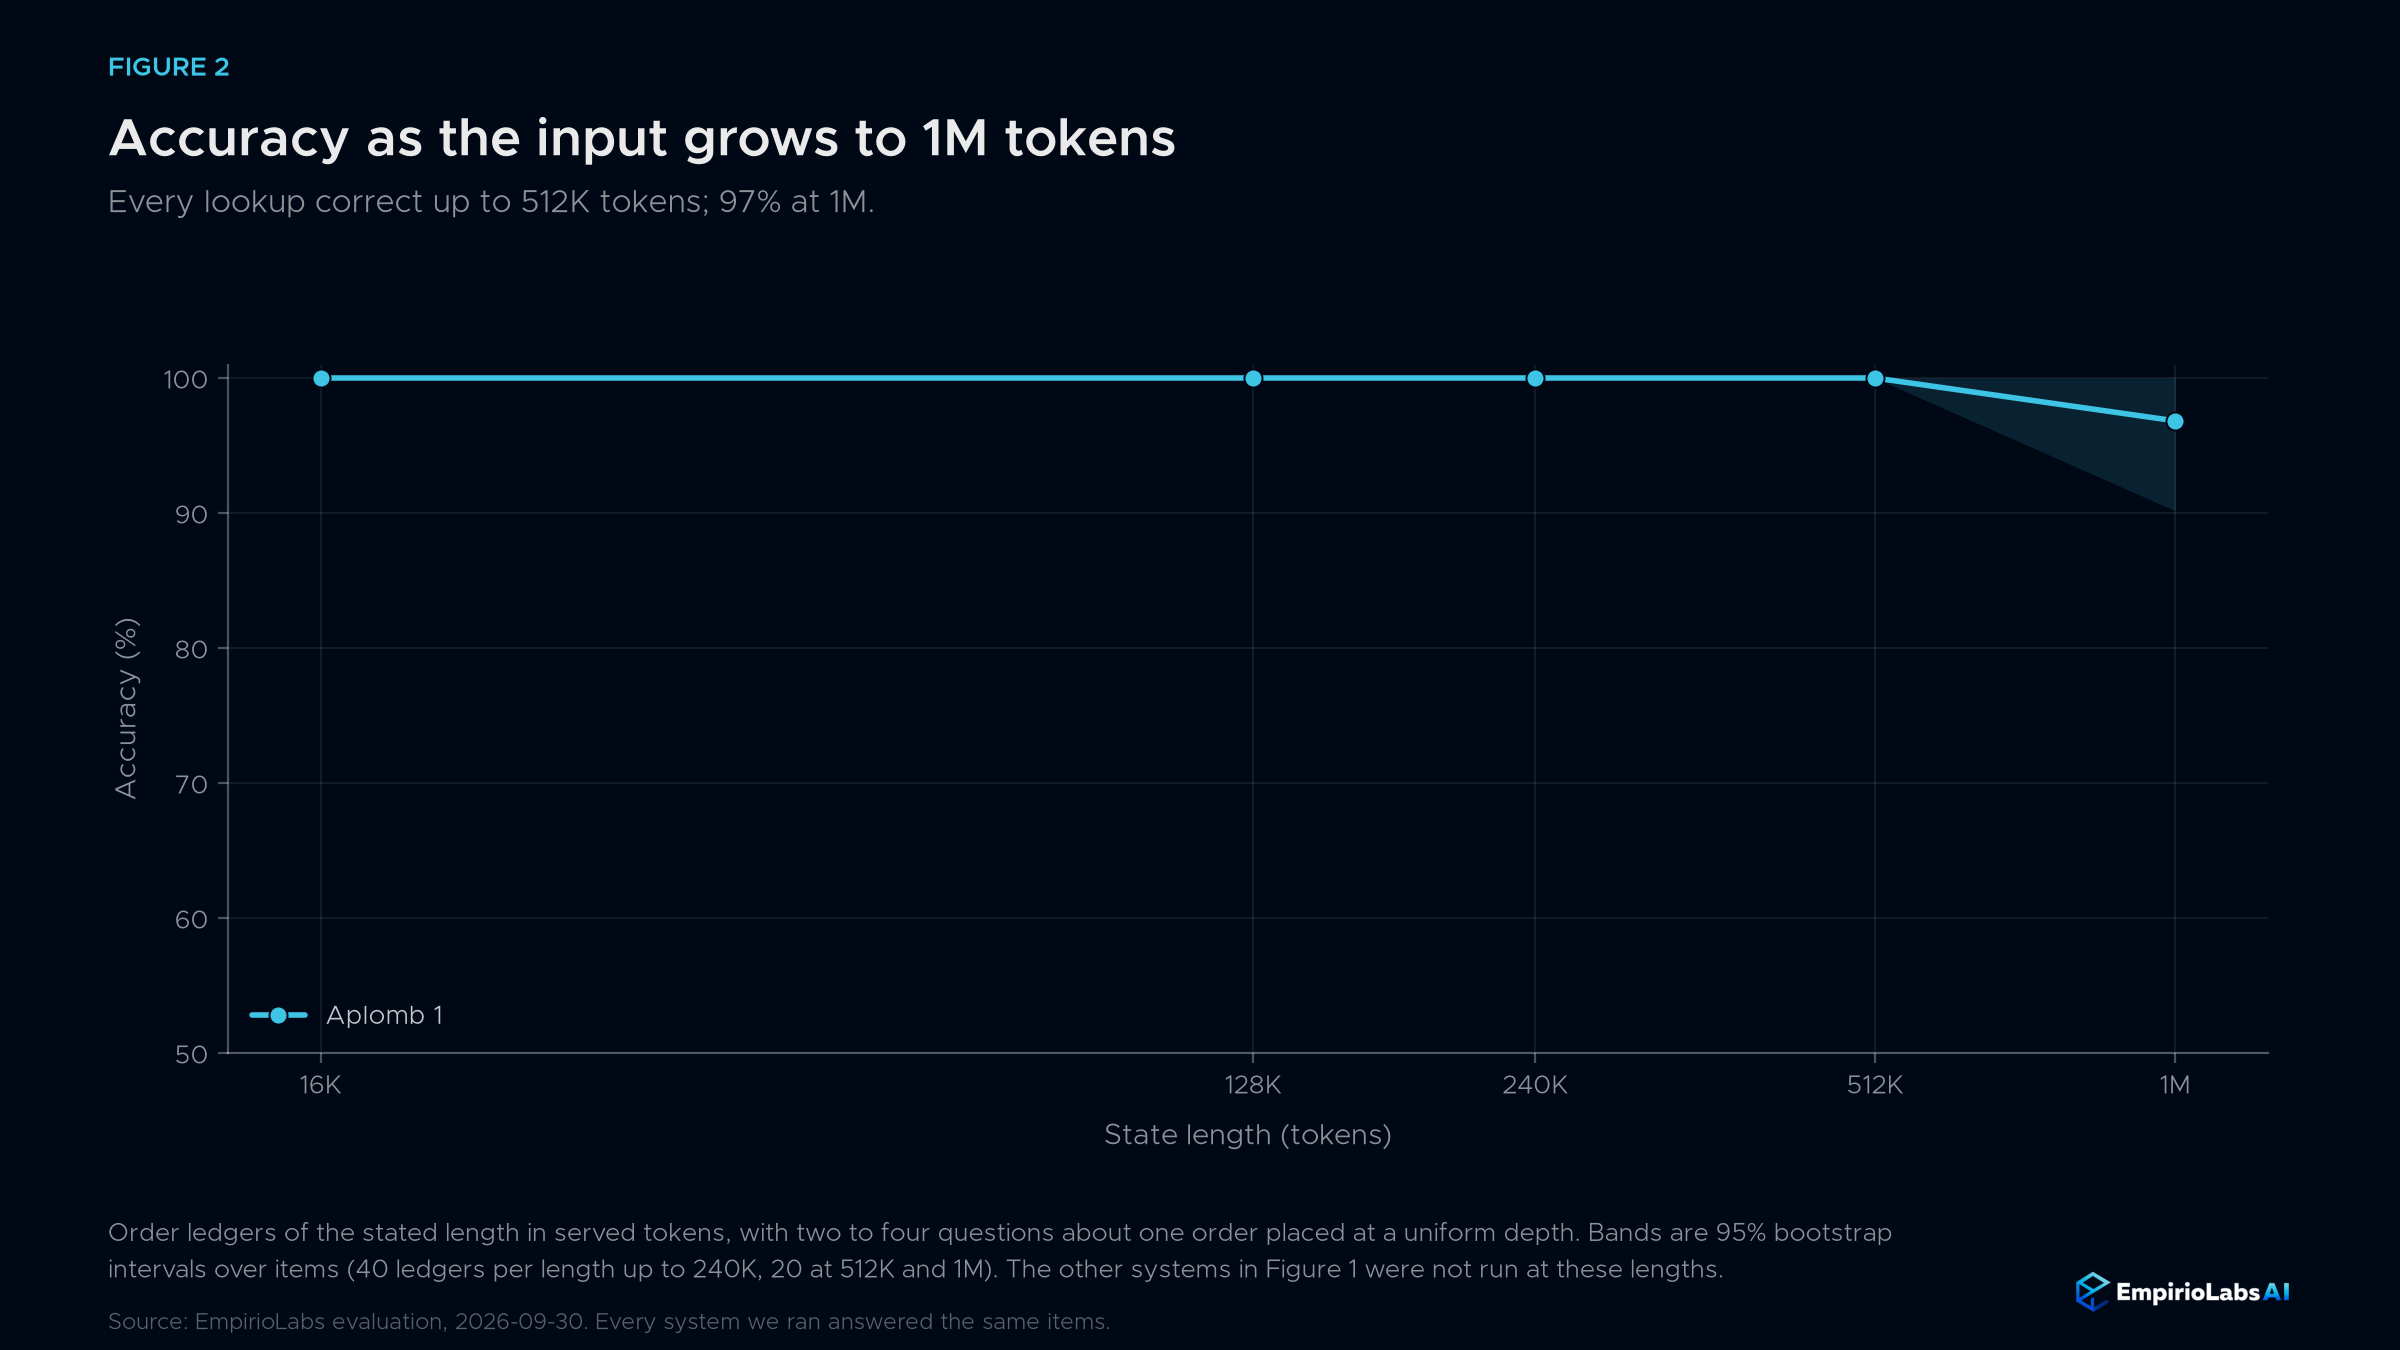
| Longueur d’entrée (jetons) | 16K | 128K | 240K | 512K | 1M |
|---|---|---|---|---|---|
| Aplomb 1 | 100.0 | 100.0 | 100.0 | 100.0 | 96.8 |
Documents longs en quelques secondes
Sur l’API EmpirioLabs et dans le Playground, un état supérieur à 131 072 jetons est lu par défaut en mode rapide à long contexte. Un document à 1 million de jetons prend environ 3 secondes au lieu d’environ 111 secondes en entier, et sur nos ensembles de test à long contexte, le mode rapide a répondu correctement à toutes les 525 décisions, contre 95,2 % pour une lecture complète.
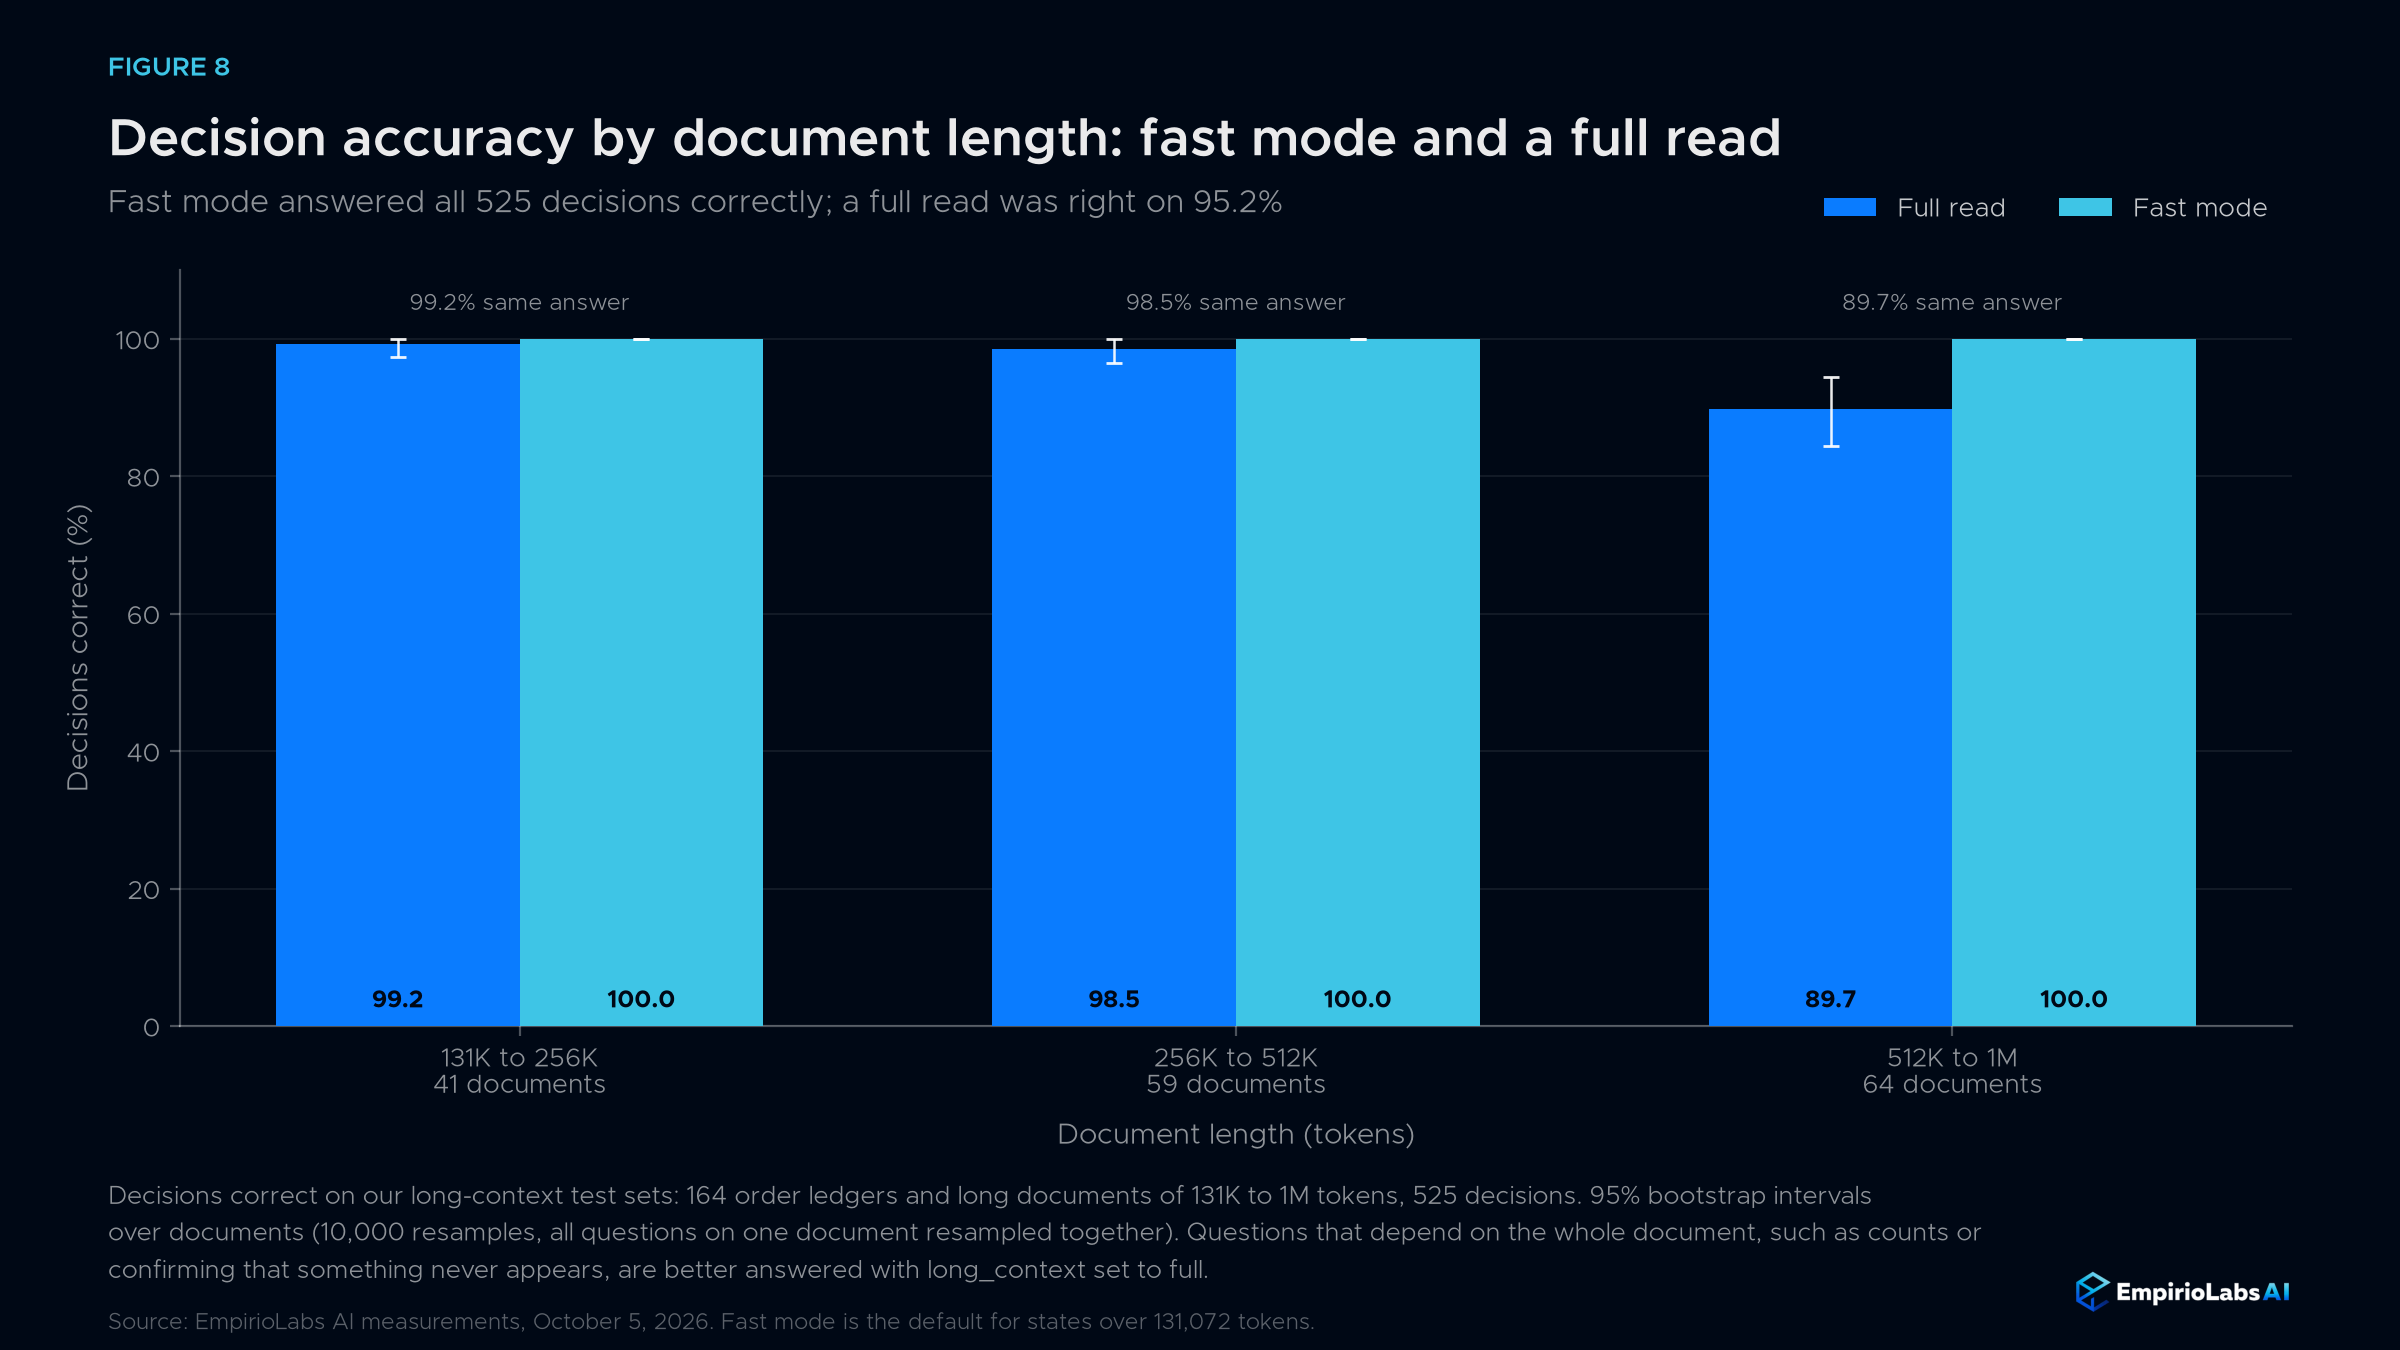
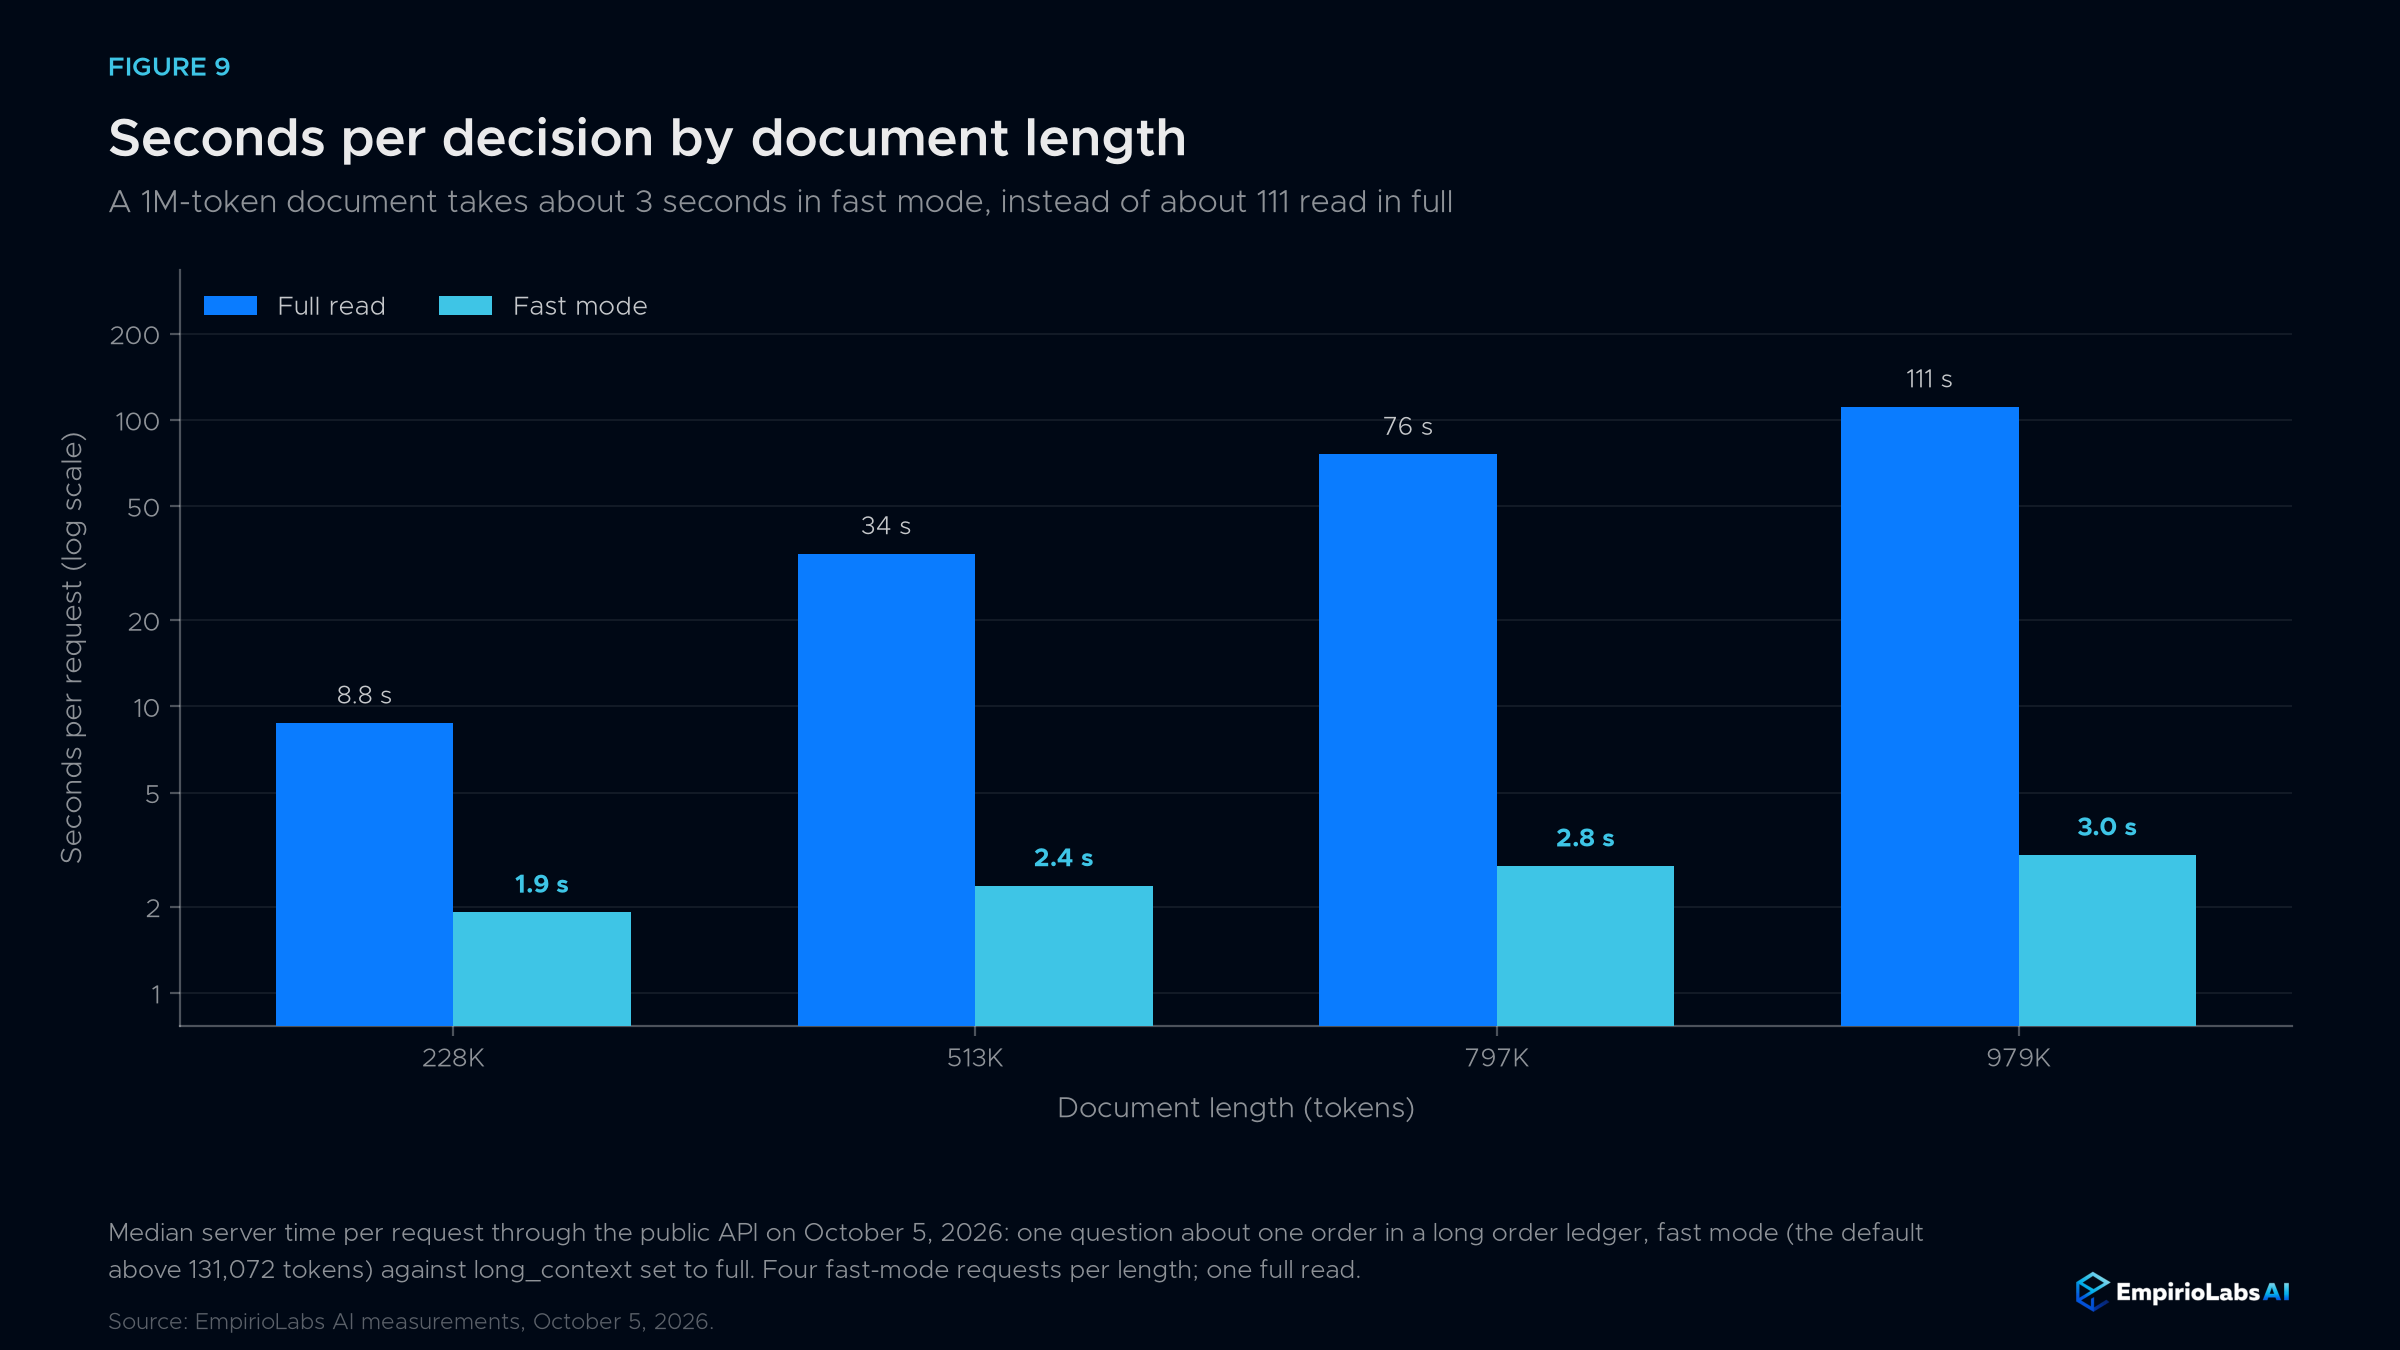
| Longueur du document (jetons) | 228K | 513K | 797K | 979K |
|---|---|---|---|---|
| Mode rapide | 1,9 s | 2,4 s | 2,8 s | 3.0 s |
| Lecture complète | 8,8 s | 34 s | 76 s | 111 s |
Envoyer « long_context »: « plein » pour lire chaque jeton. Une lecture complète est le meilleur choix lorsqu’une réponse dépend de l’ensemble du document, comme un décompte, le ton global, ou la confirmation que quelque chose n’apparaît jamais: sur 24 documents conçus pour tester ces questions, le mode rapide était correct sur 50 % des décisions et une lecture complète sur 61 %. Les réponses long_context le champ indique quel mode a été utilisé, et l’utilisation compte l’état complet dans les deux modes. Le mode rapide à long contexte n’est disponible que sur l’API EmpirioLabs et dans le Playground; les poids ouverts lisent chaque jeton.
Étalonnage
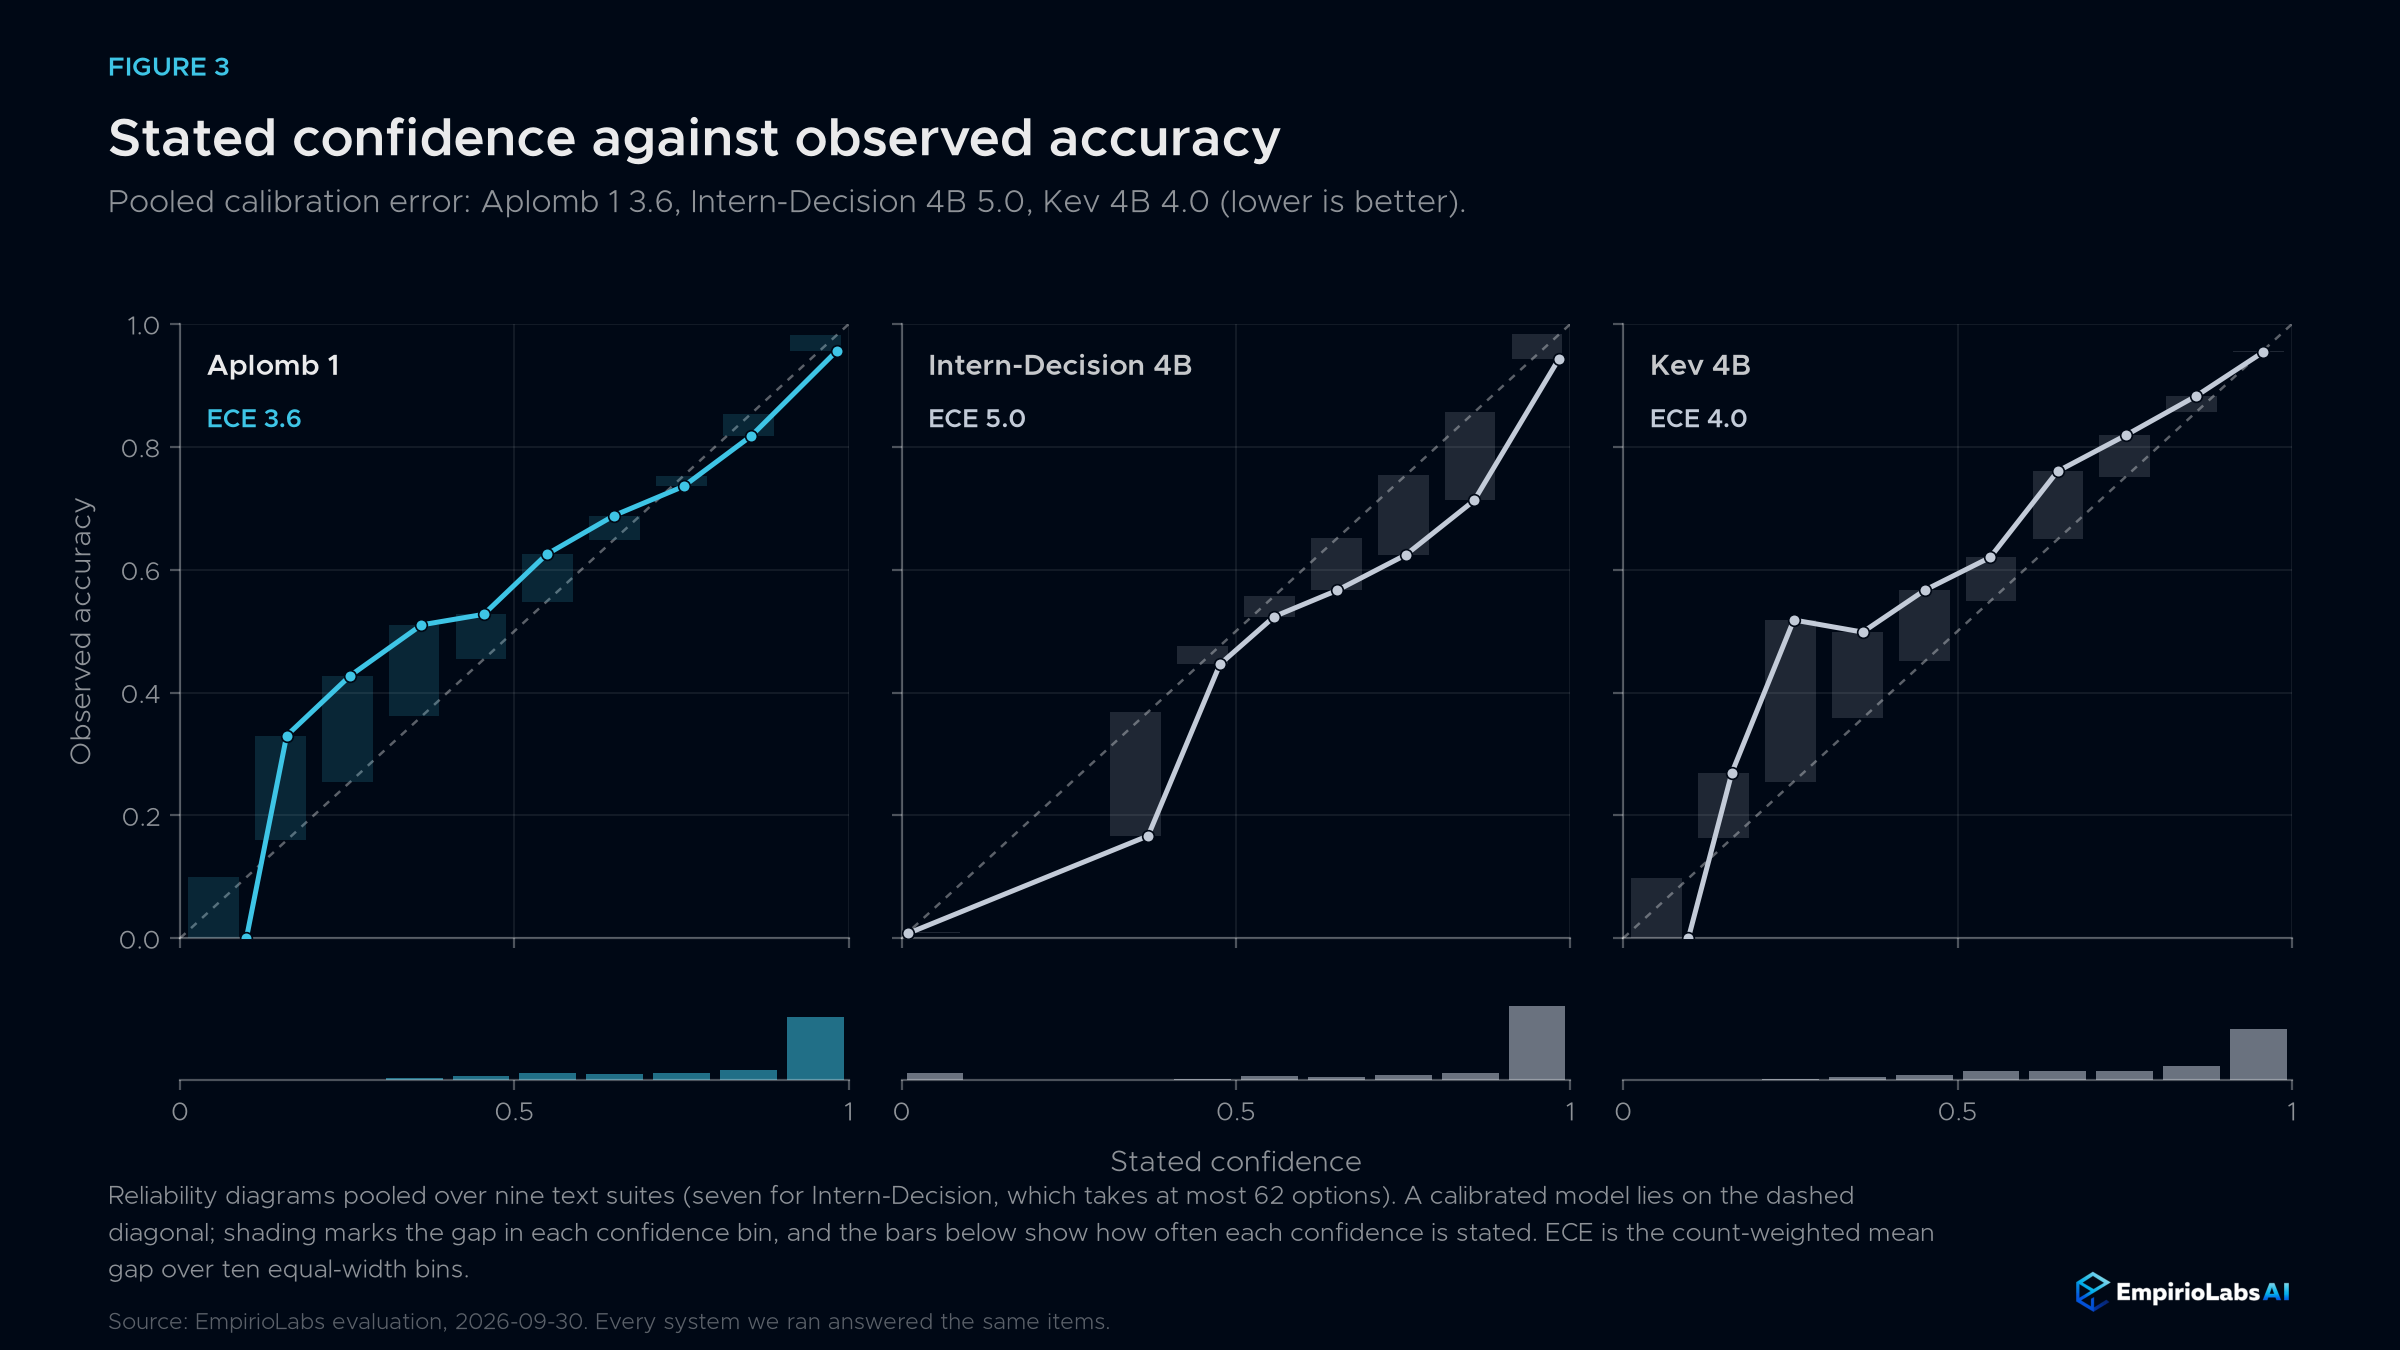
Une probabilité n’est utile que si elle signifie ce qu’elle dit. Sur neuf suites de textes, la confiance déclarée d’Aplomb 1 suit la fréquence à laquelle elle a raison: son erreur d’étalonnage regroupée est de 3,6, contre 5,0 pour Intern-Decision 4B et 4,0 pour Kev 4B (plus c’est faible, mieux c’est).
Images, vidéo et audio
| Benchmark (premiers 500 éléments) | Aplomb 1 | Décision de stage 4B | OmniJev 4B |
|---|---|---|---|
| POPE | 89.0 | 89.2 | 88.4 |
| MMStar | 68.6 | 65.2 | 64.4 |
| AI2D | 87.0 | 81.0 | 83.4 |
| MMMU | 57.2 | 57.0 | 56.0 |
| HallusionBench | 79.8 | 79.4 | 71.2 |
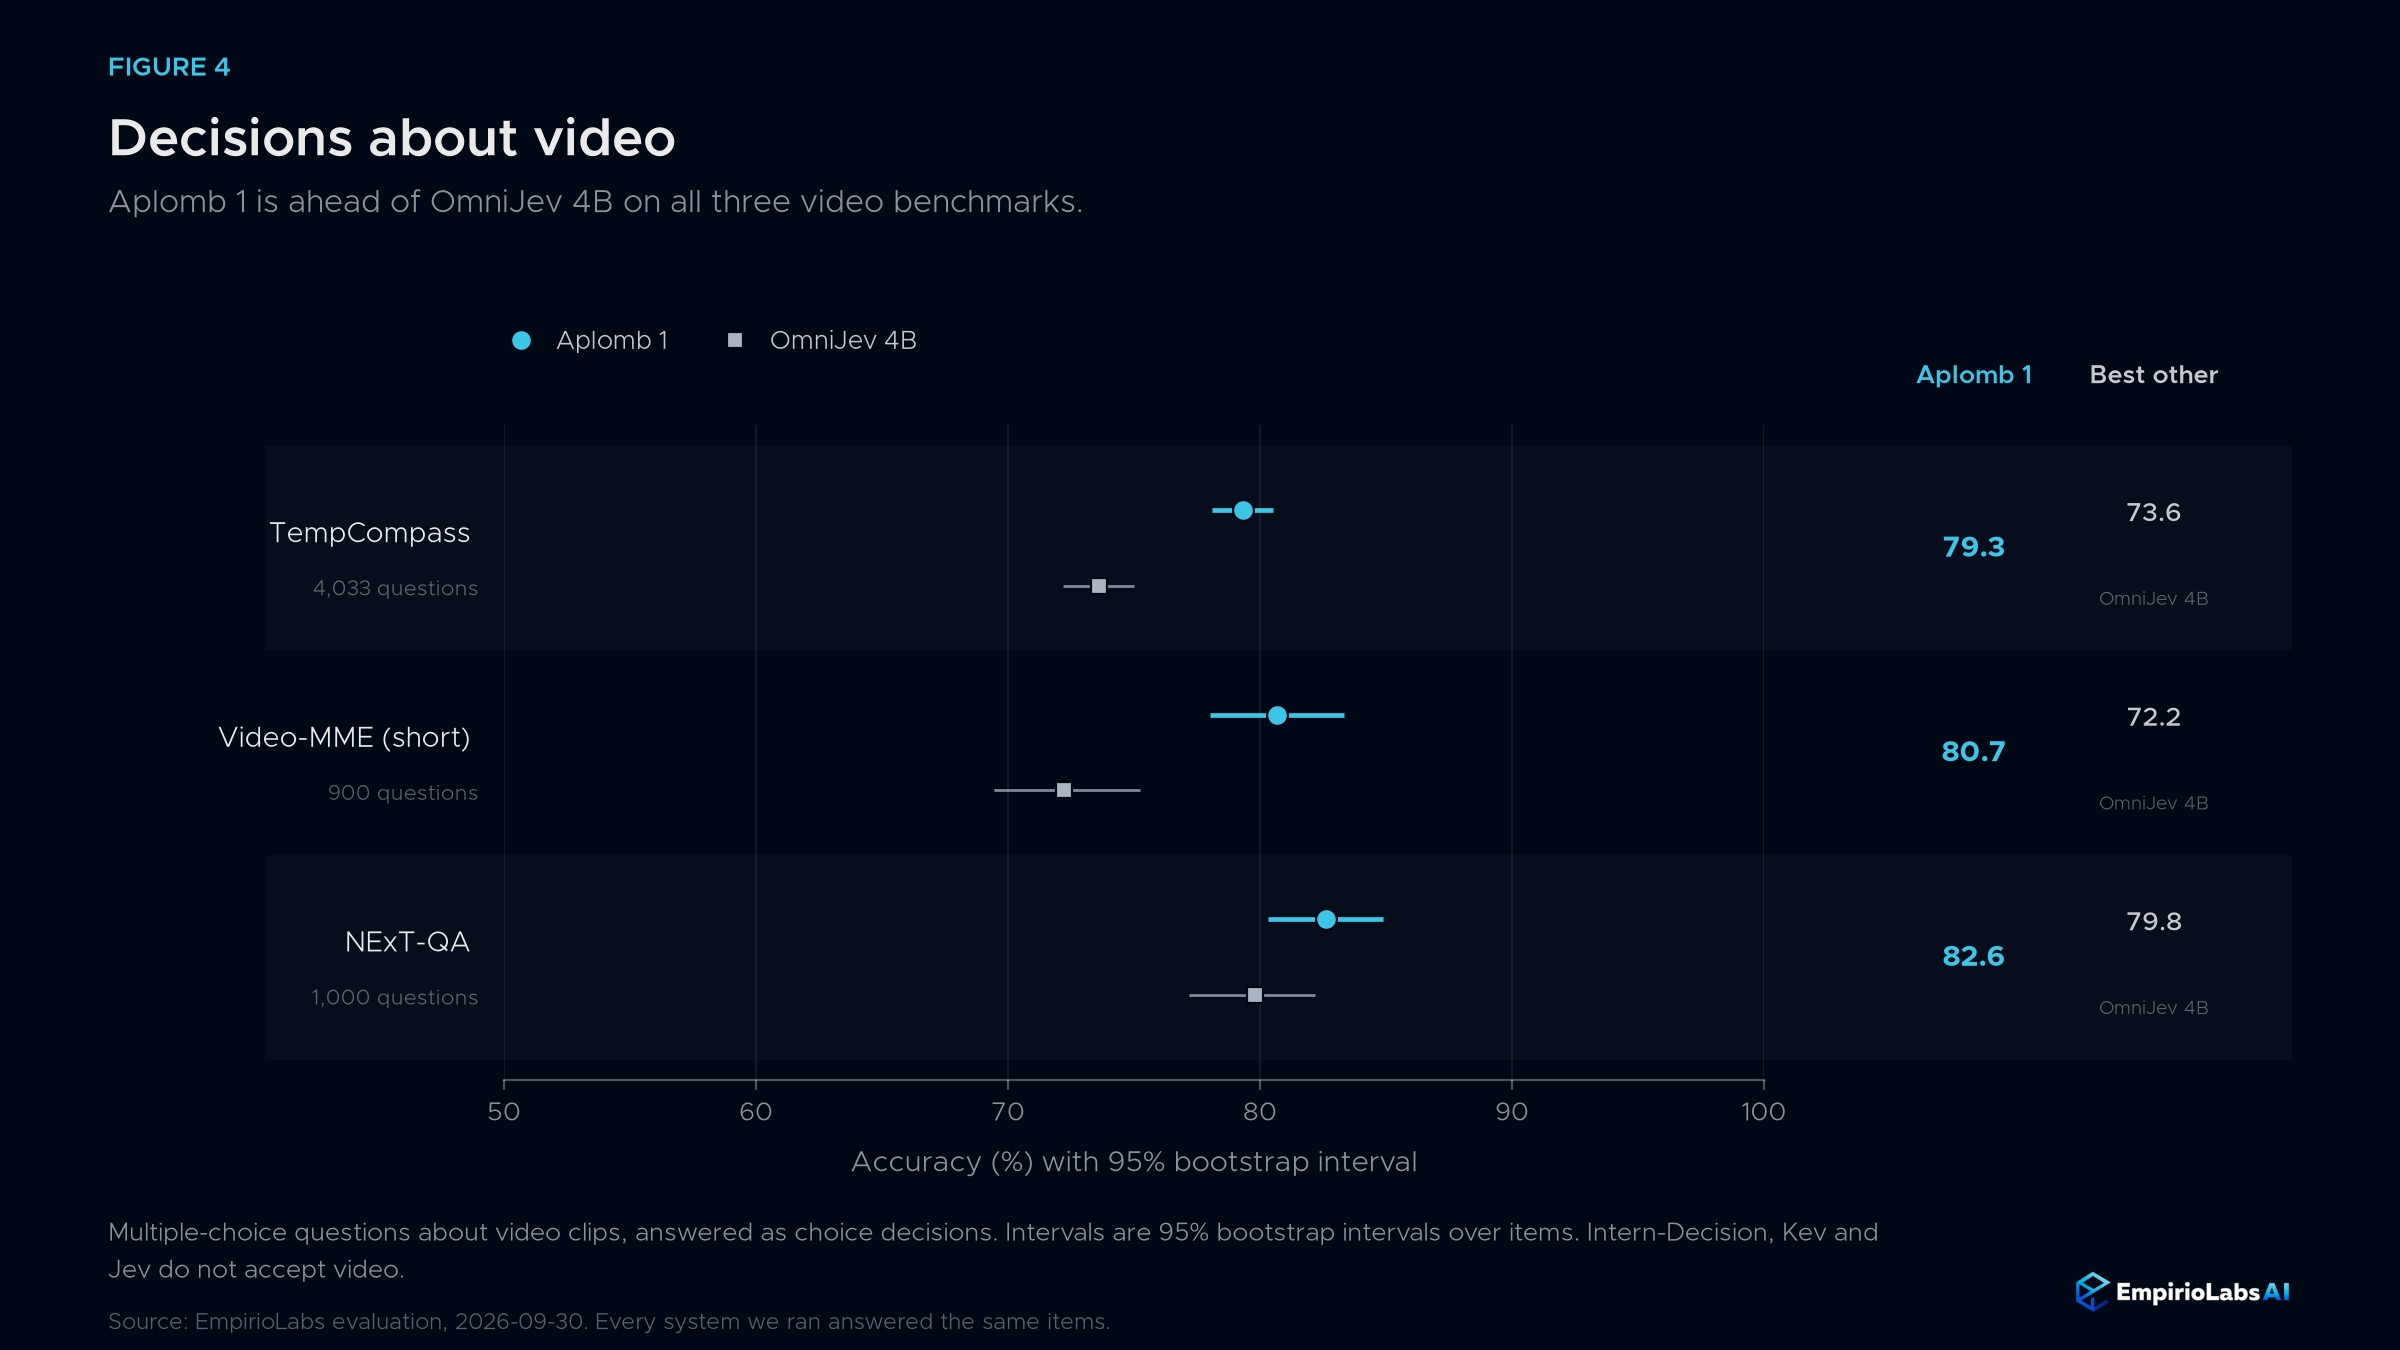
| Référence | Aplomb 1 | OmniJev 4B |
|---|---|---|
| TempCompass | 79.3 | 73.6 |
| Vidéo-MME (court) | 80.7 | 72.2 |
| NExT-QA | 82.6 | 79.8 |
Nous avons nous-mêmes ajouté l’audio à Aplomb 1; aucun des autres modèles de décision ci-dessus ne l’accepte. Il reconnaît les sons vocaux, les émotions dans la parole et les sons du quotidien, et répond aux questions sur ce qui est dit:
| Référence | Aplomb 1 |
|---|---|
| VocalSound (sons vocaux) | 91.9 |
| CREMA-D (émotion dans la parole) | 78.7 |
| ESC-50 (bruits environnementaux) | 77.0 |
| MMAU (questions audio) | 68.3 |
| MMSU (langue parlée) | 63.2 |
Les résultats audio ont été mis à jour le 6 octobre 2026, avec de nouveaux poids audio pour Aplomb 1; les résultats de texte, d’image et de vidéo sont restés inchangés.
51 langues
Aplomb 1 décide du texte dans de nombreuses langues, pas seulement en anglais. Sur MASSIVE, chaque requête à un assistant vocal est écrite dans l’une des 51 langues tandis que la question et les 59 lettres d’intention restent en anglais. Sans aucune formation sur MASSIVE, Aplomb 1 obtient en moyenne 75,0 % dans les 51 langues lorsqu’il choisit parmi les 59 intentions, 91,0 % en anglais, et 70 % ou plus dans 39 d’entre elles.
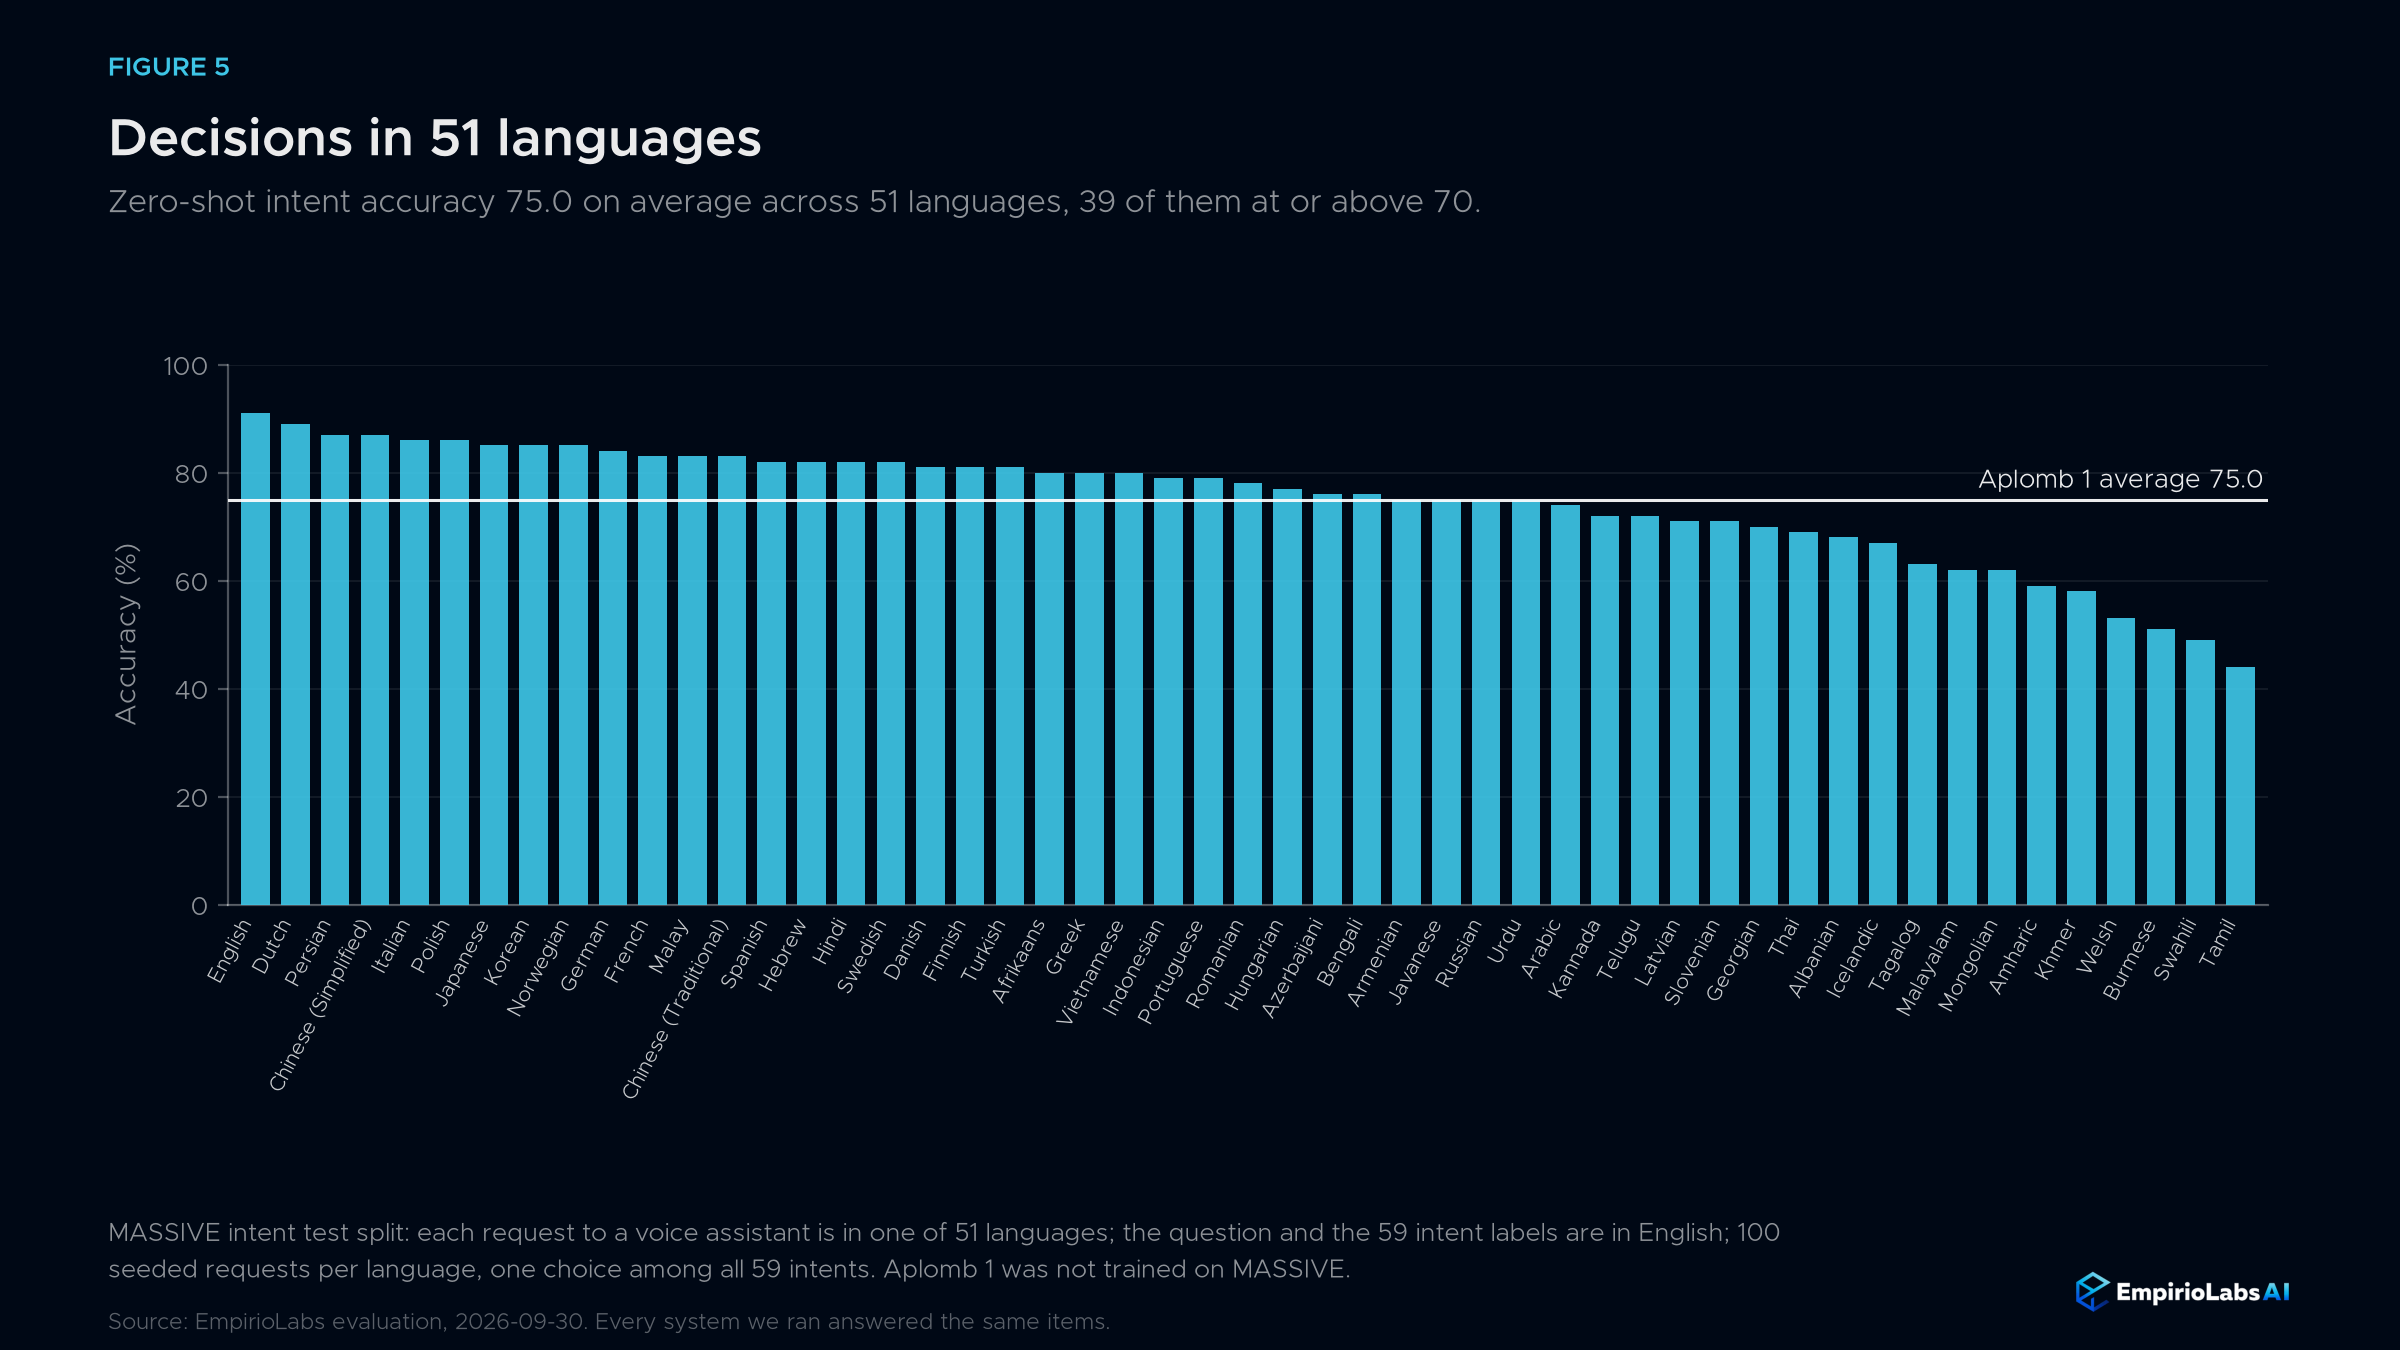
Pour référence, le projet Laya rapporte 40,1 % pour son modèle multilingue dans les mêmes 51 langues lorsqu’il choisit parmi 20 intentions, et le projet JevK5 rapporte 73,8 % en anglais avec les 60 intentions.
Indice de décision
Indice de décision 0.2.1 (5 octobre 2026)
L’indice de décision 0.2.1 comprend en moyenne 38 références publiques dans cinq domaines: connaissances et raisonnement, compréhension du langage, récupération et classification, outils et automatisation, arts et goûts humains. Chaque référence est corrigée par hasard, donc 0 signifie devinettes aléatoires et 100 signifie parfait.
Nous avons lancé le kit officiel sur Aplomb 1 le 5 octobre 2026, et il a répondu à toutes les 150 317 demandes notables. Aplomb 1 marque 44,86. Ceci est notre propre édition du kit, pas une entrée sur le tableau publié.
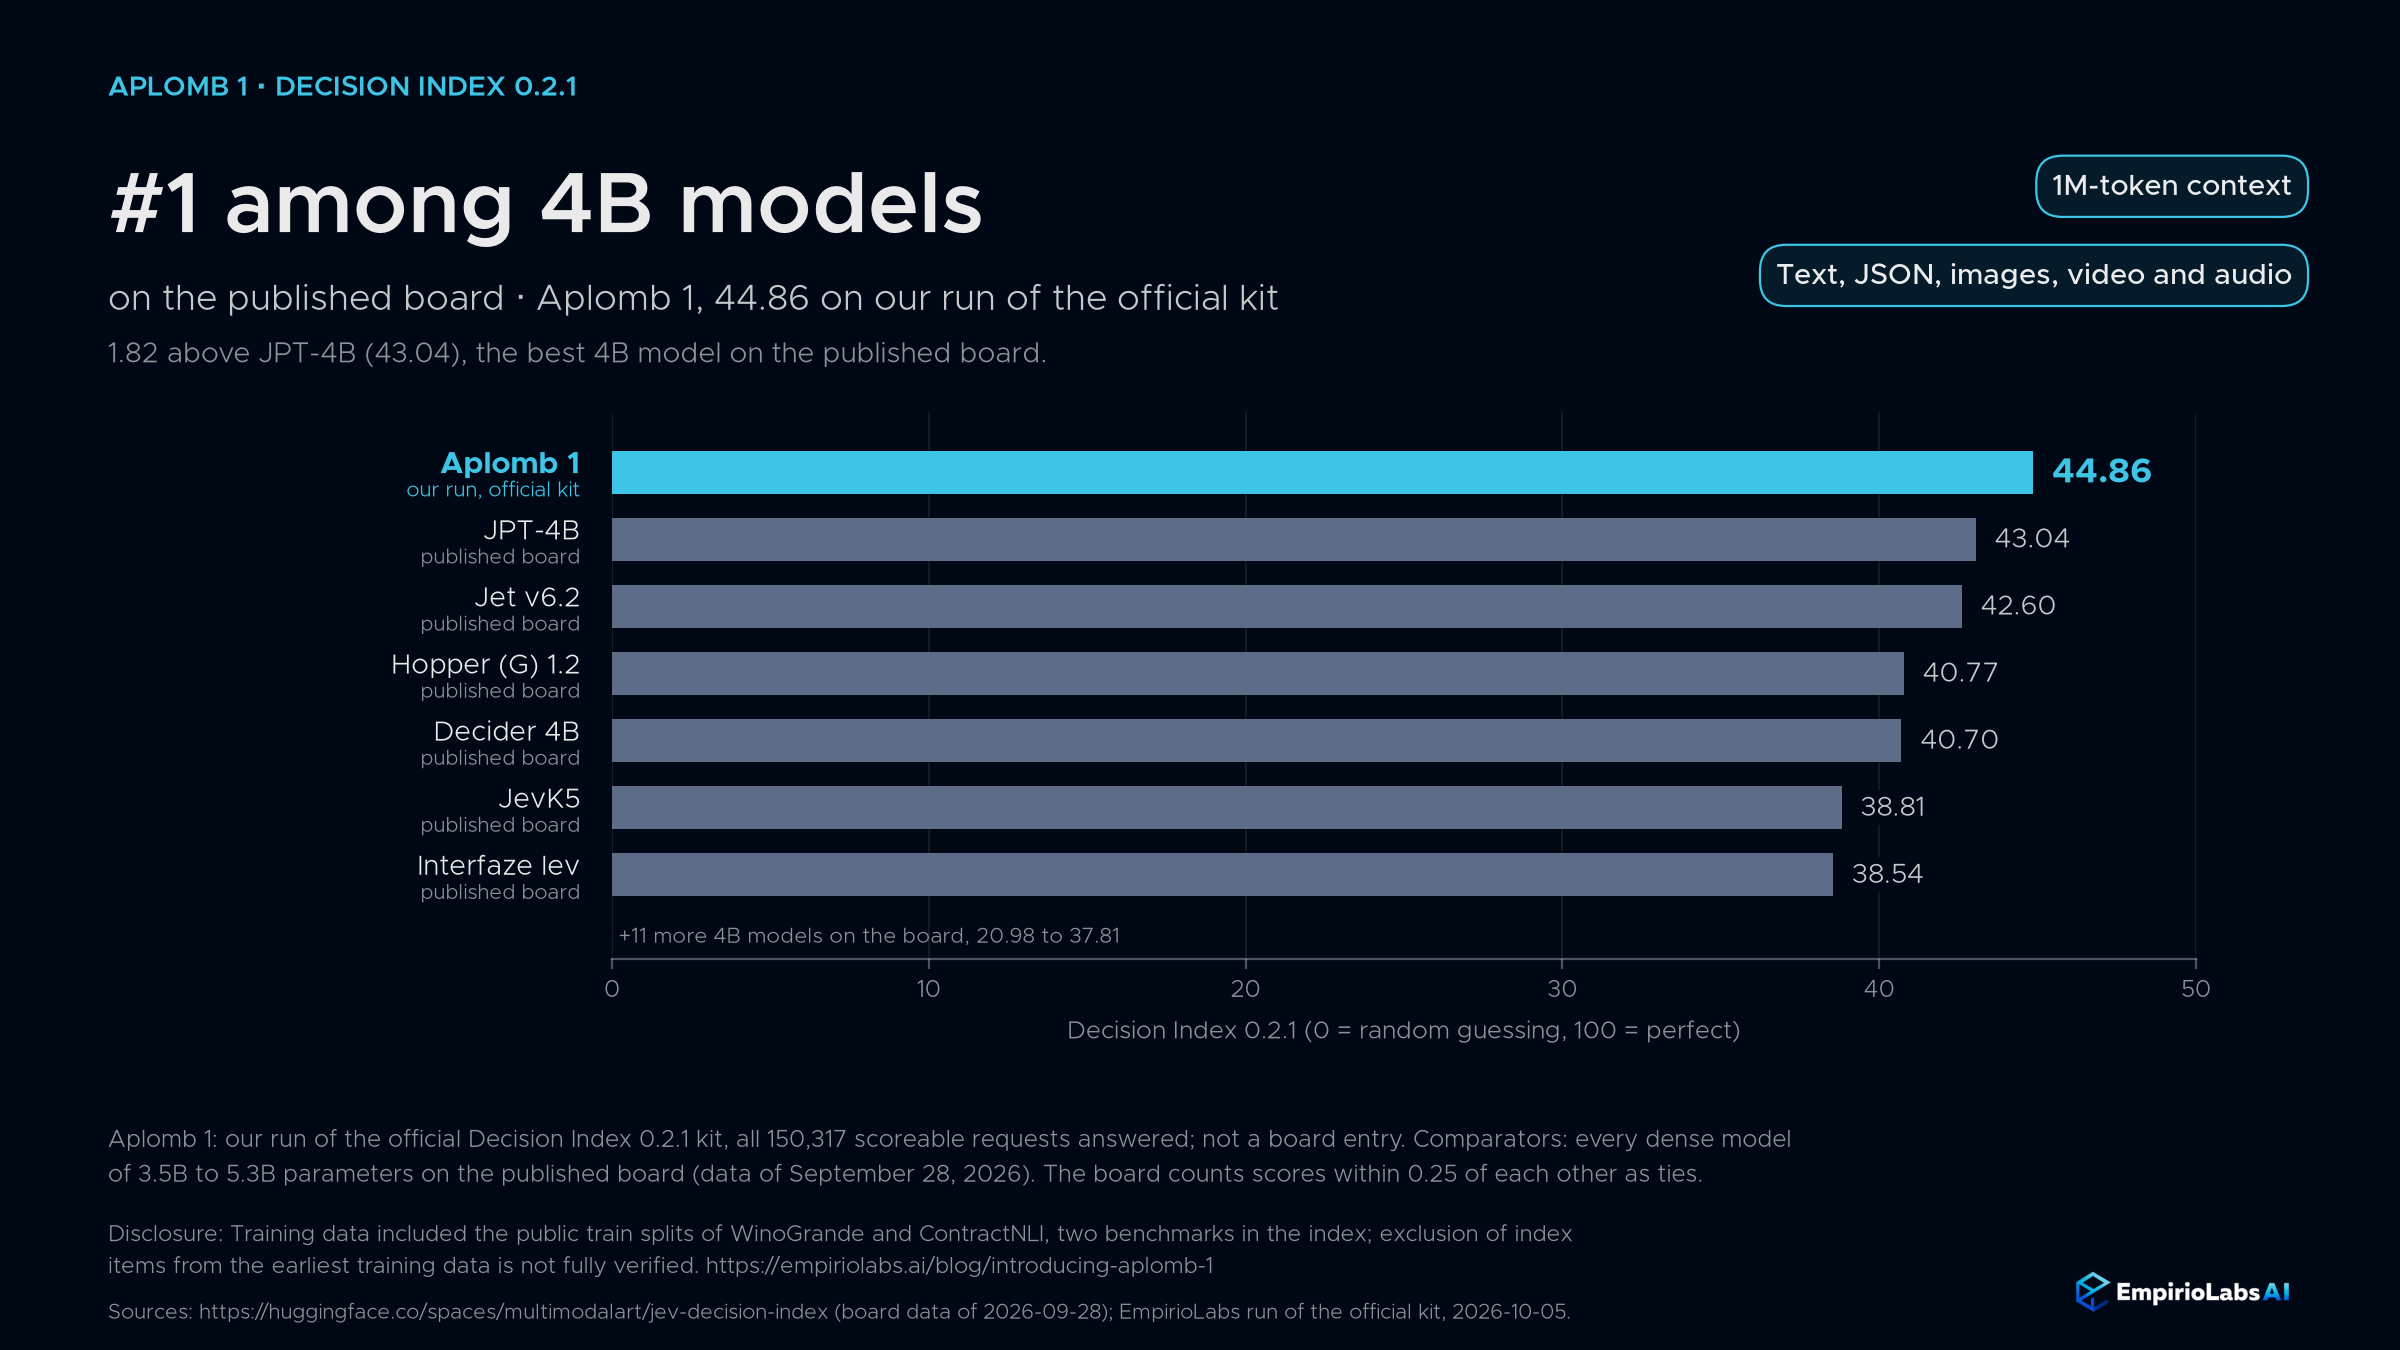
Sur le tableau publié de l’Indice de décision 0.2.1 (données du 28 septembre 2026), Aplomb 1 est #1 parmi les modèles 4B, et #1 parmi les modèles jusqu’à 5,3B sur 8 des 38 benchmarks, dont MMLU-Pro, GPQA Diamond et BBH. Sur ce tableau, le score le plus élevé pour un modèle 4B est JPT-4B de 43,04, soit 1,82 de moins que Aplomb 1.
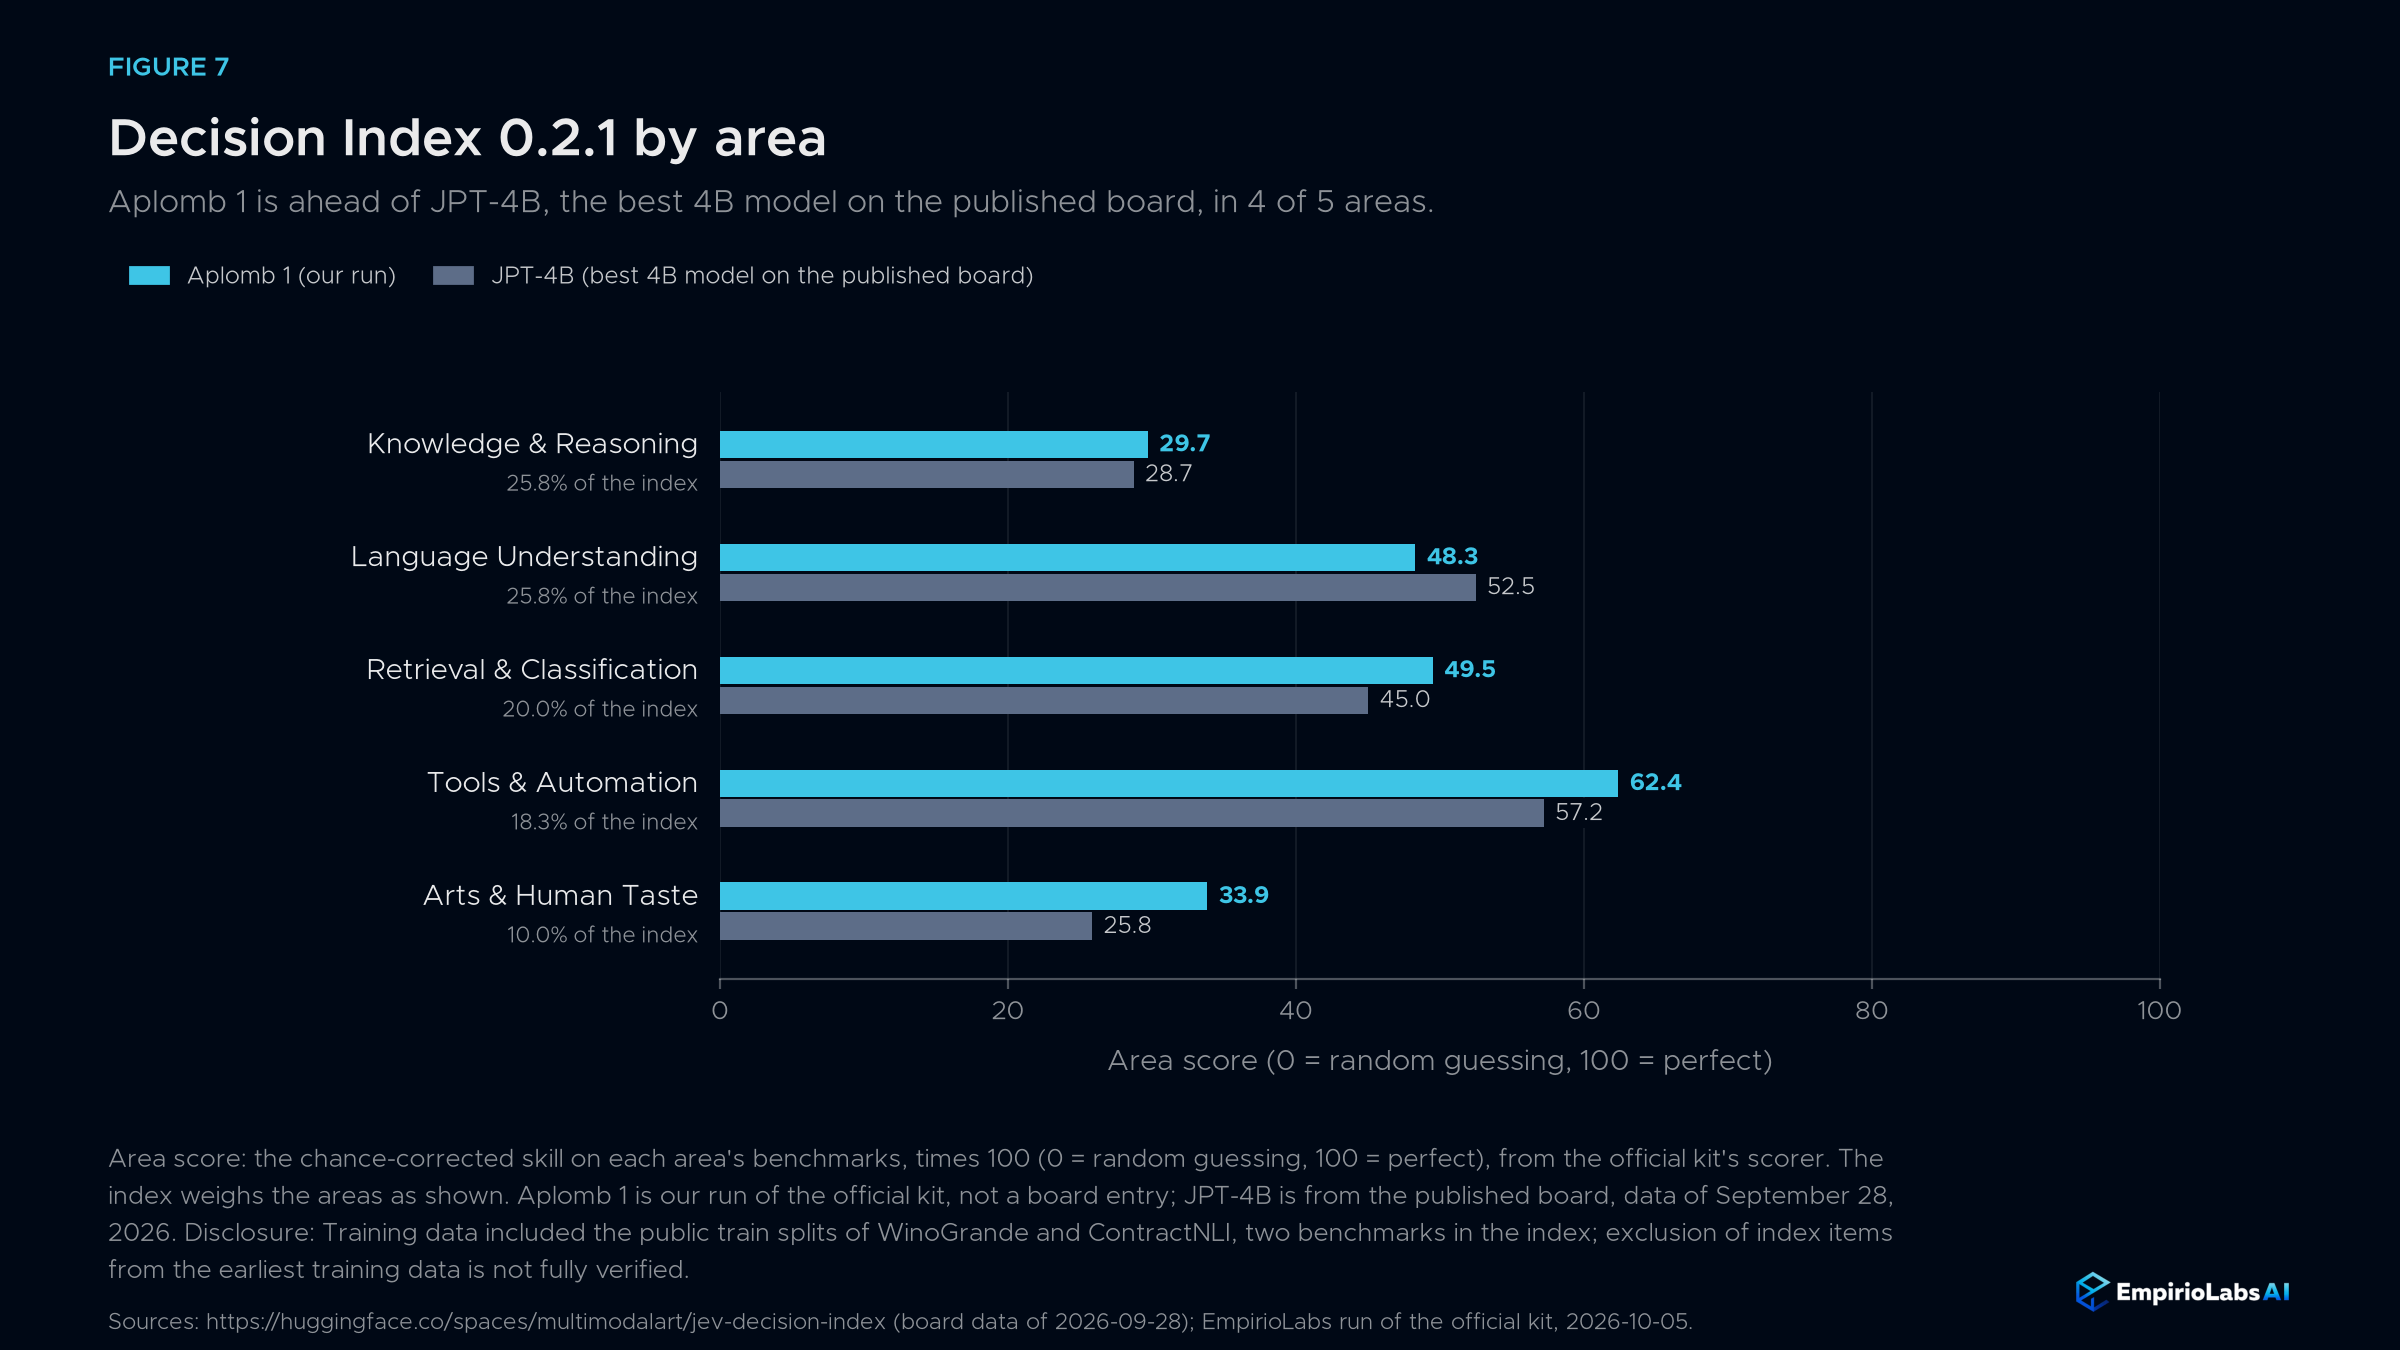
Par domaine, Aplomb 1 obtient les meilleurs scores en outils et automatisation (62,4) ainsi qu’en recherche et classification (49,5). Comparé au JPT-4B, il est en tête dans quatre des cinq domaines et en retard dans la compréhension des langues (48,3 contre 52,5).
Indice de décision 0.3.2 (12 octobre 2026)
Aplomb 1 figure sur le tableau publié de l’Indice de décision 0.3.2 sur Hugging Face, qui classe 149 modèles de décision sur 37 benchmarks de texte public et 33 modèles de vision sur 11 autres. Sur les conseils du 12 octobre 2026, il est #1 dans sa catégorie de taille sur trois tests:
- R-Bench-M, 665 questions d’experts sur une image de science, ingénierie et médecine: 29,6, #1 parmi les modèles jusqu’à 25B sur le tableau Vision. Le modèle suivant jusqu’à 25B, un 12B, note 24,9, et le meilleur modèle 4B 19,5. Seuls les modèles 26B à 36B obtiennent un score supérieur.
- Diamant GPQA, 196 questions scientifiques de niveau doctorat: 48,0 %, #1 parmi les modèles de moins de 8B sur le tableau de texte (44,9 % suivants).
- cfcolor, 5 000 prédictions de préférence palette de couleurs: 65,6 %, #1 parmi les modèles de moins de 8B sur le tableau de texte (64,7 % suivants).
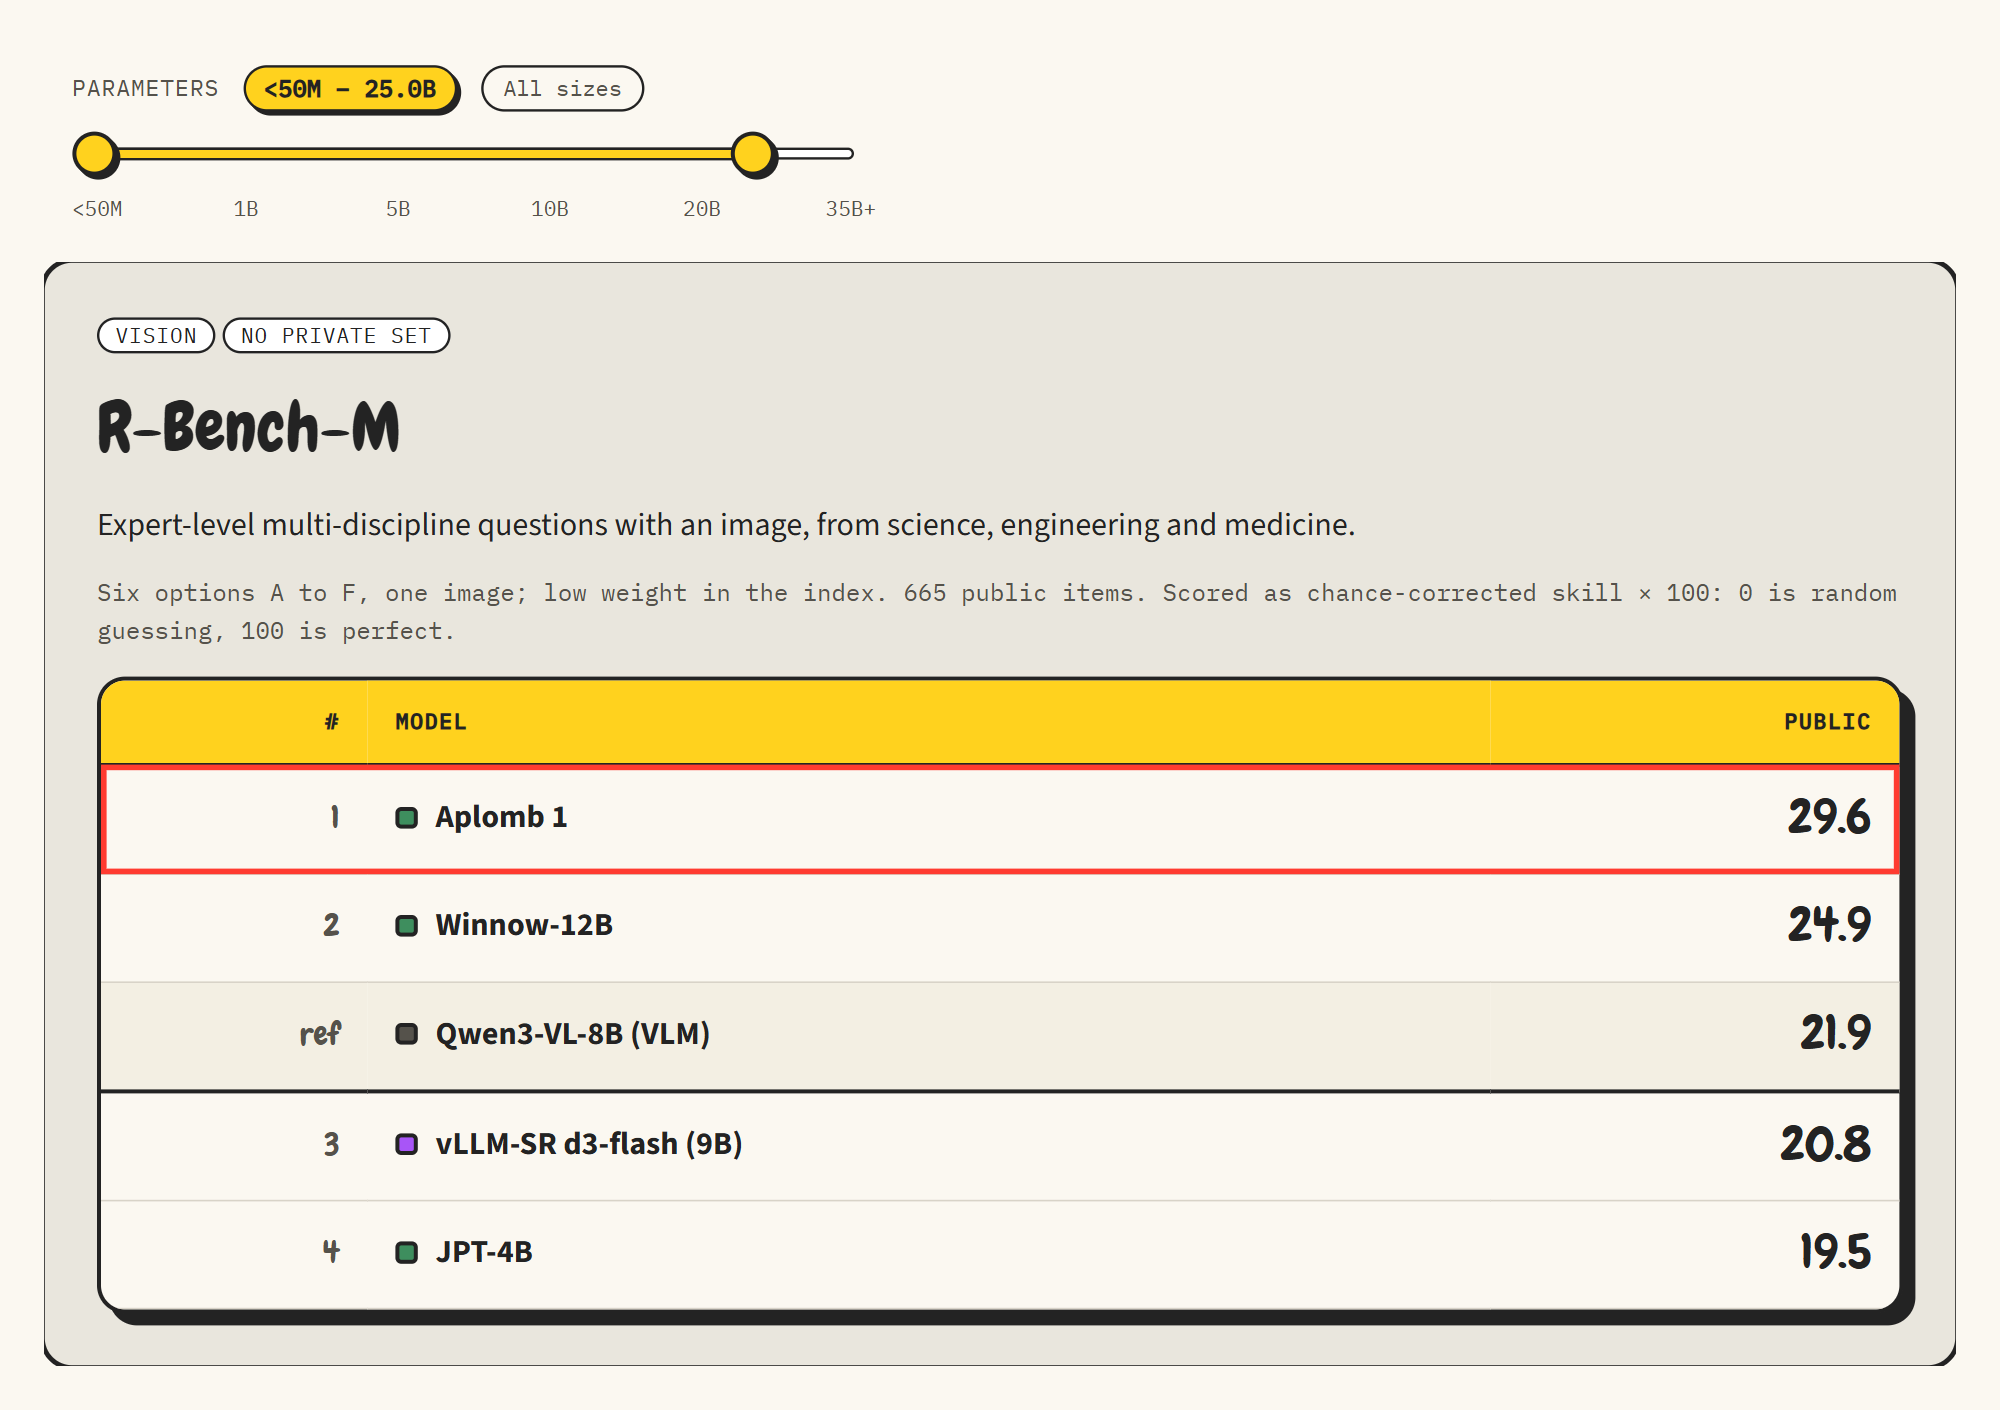
Pour voir cette vue, ouvrez la Tableau de vision, fixe les paramètres à 25B et ouvre le classement complet de R-Bench-M.
Divulgation. Les données d’entraînement d’Aplomb 1 incluaient les divisions publiques de WinoGrande et ContractNLI, deux des références de l’indice de décision 0.2.1 et 0.3.2. Nous n’avons pas pu vérifier entièrement que les éléments de l’indice étaient exclus des premières données d’entraînement.
Décisions dactylographiées
Typed Decisions est un benchmark officiel de Hugging Face (LocalLLaMA/typed-decisions). Sa répartition de tests comprend 400 cas et 2 000 décisions, chaque réponse étant une distribution de probabilité notée par rapport à la réponse or. Le 8 octobre 2026, son classement classait Aplomb au 1er #1 pour la divergence KL par rapport à la distribution or (0,123) et sur le score Brier (0,065) dans sa vision par défaut; moins c’est mieux pour les deux. Avec 5,3 milliards, il devançait un modèle 27B environ cinq fois sa taille, qui a obtenu 0,204 et 0,097.
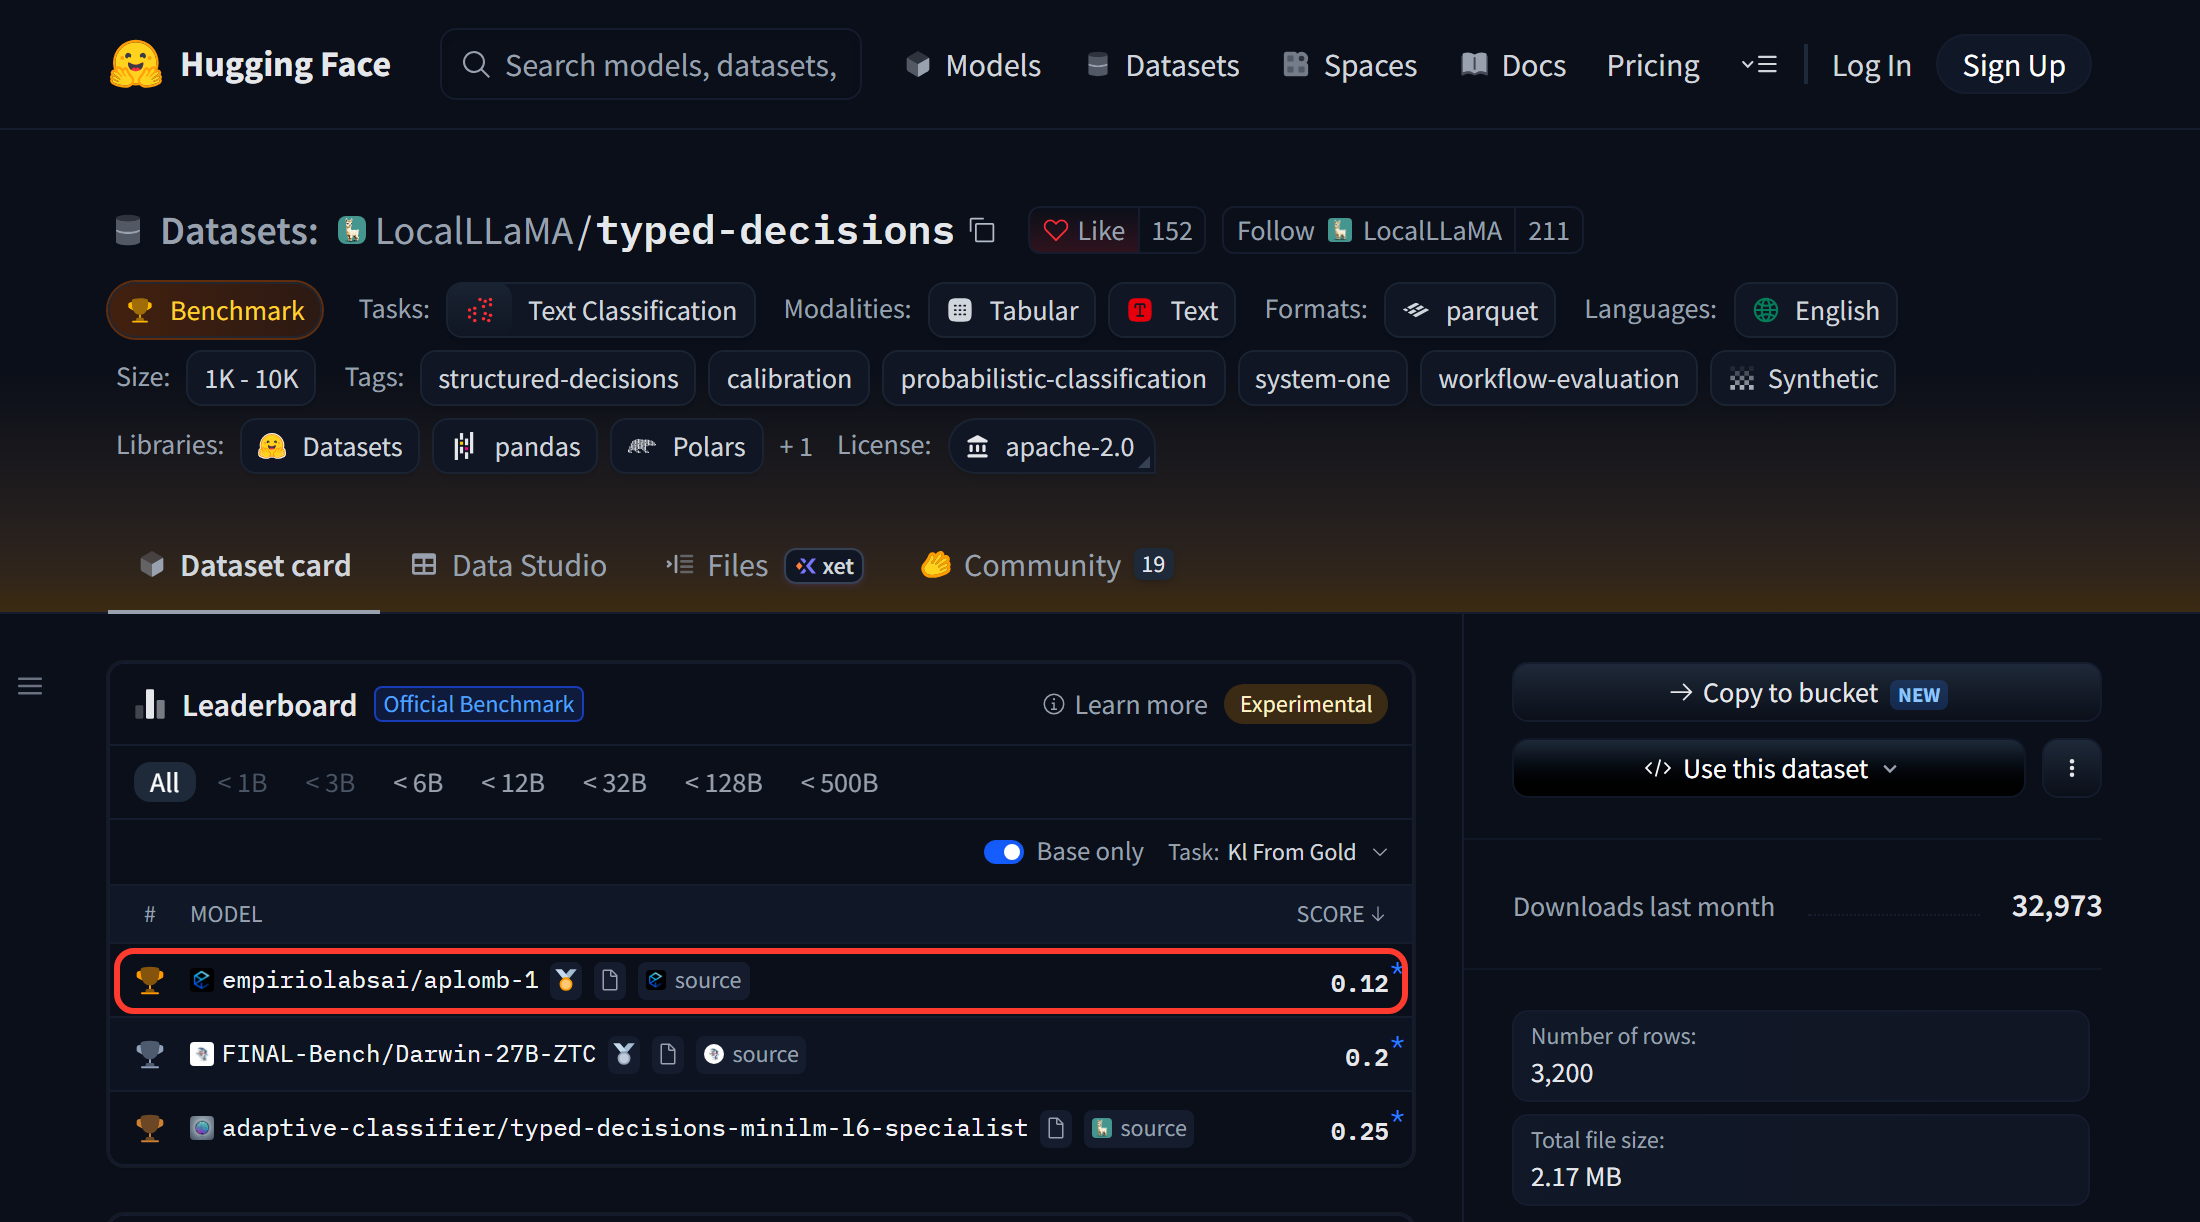
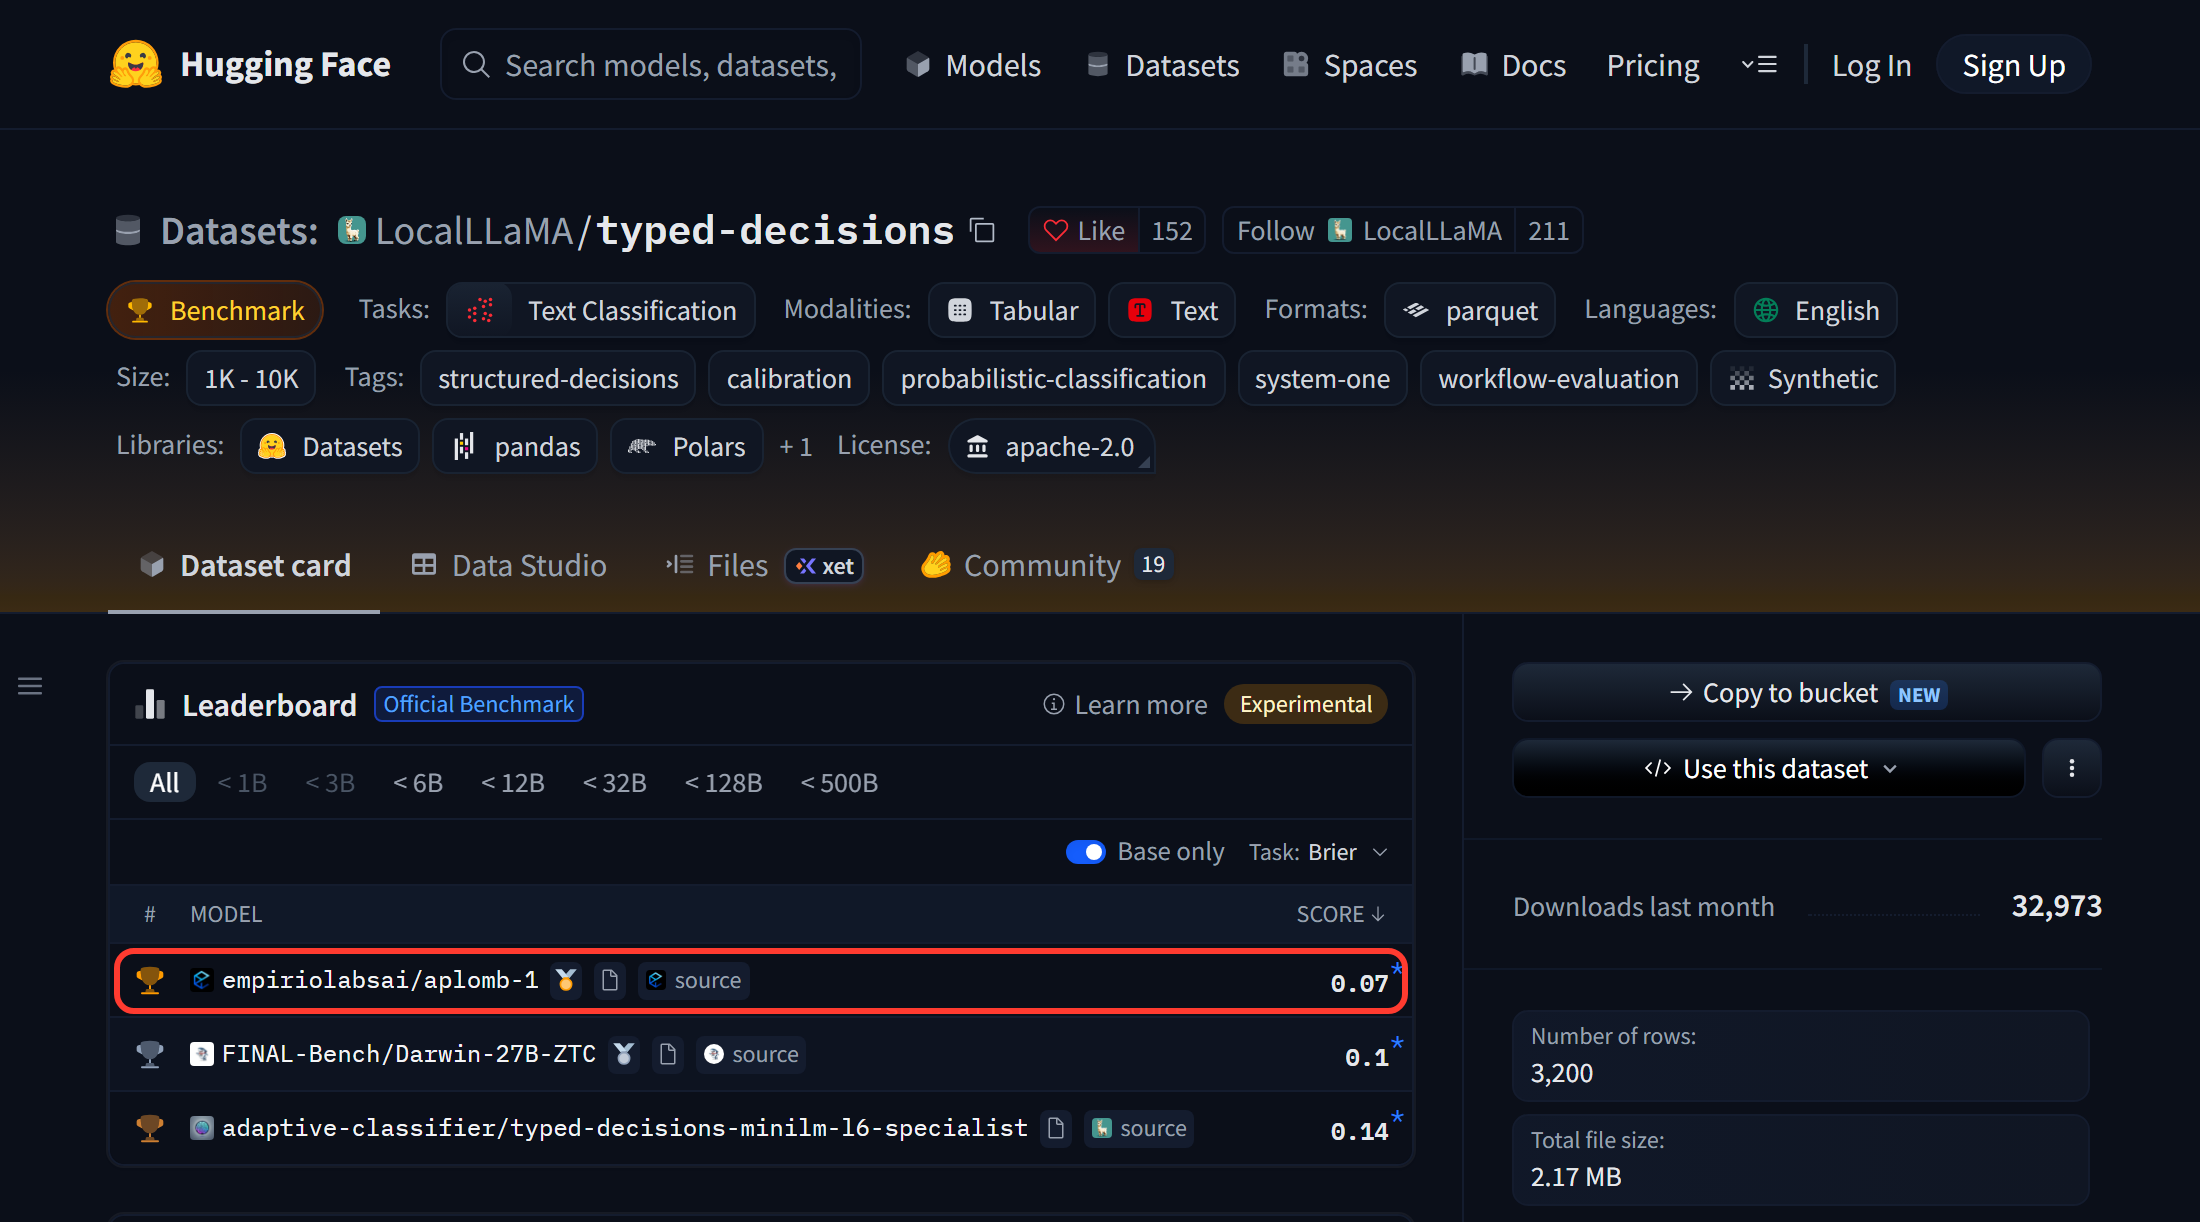
Les résultats du classement sont auto-rapportés par les auteurs de chaque modèle. Les données d’entraînement d’Aplomb 1 incluaient la répartition des trains du benchmark; la répartition du test n’a pas été utilisée pour l’entraînement.
Comment cela se compare
Ce que chaque modèle de décision ou API accepte et répond, à partir de sa propre documentation publiée au 29 septembre 2026, avec les prix au 6 octobre 2026:
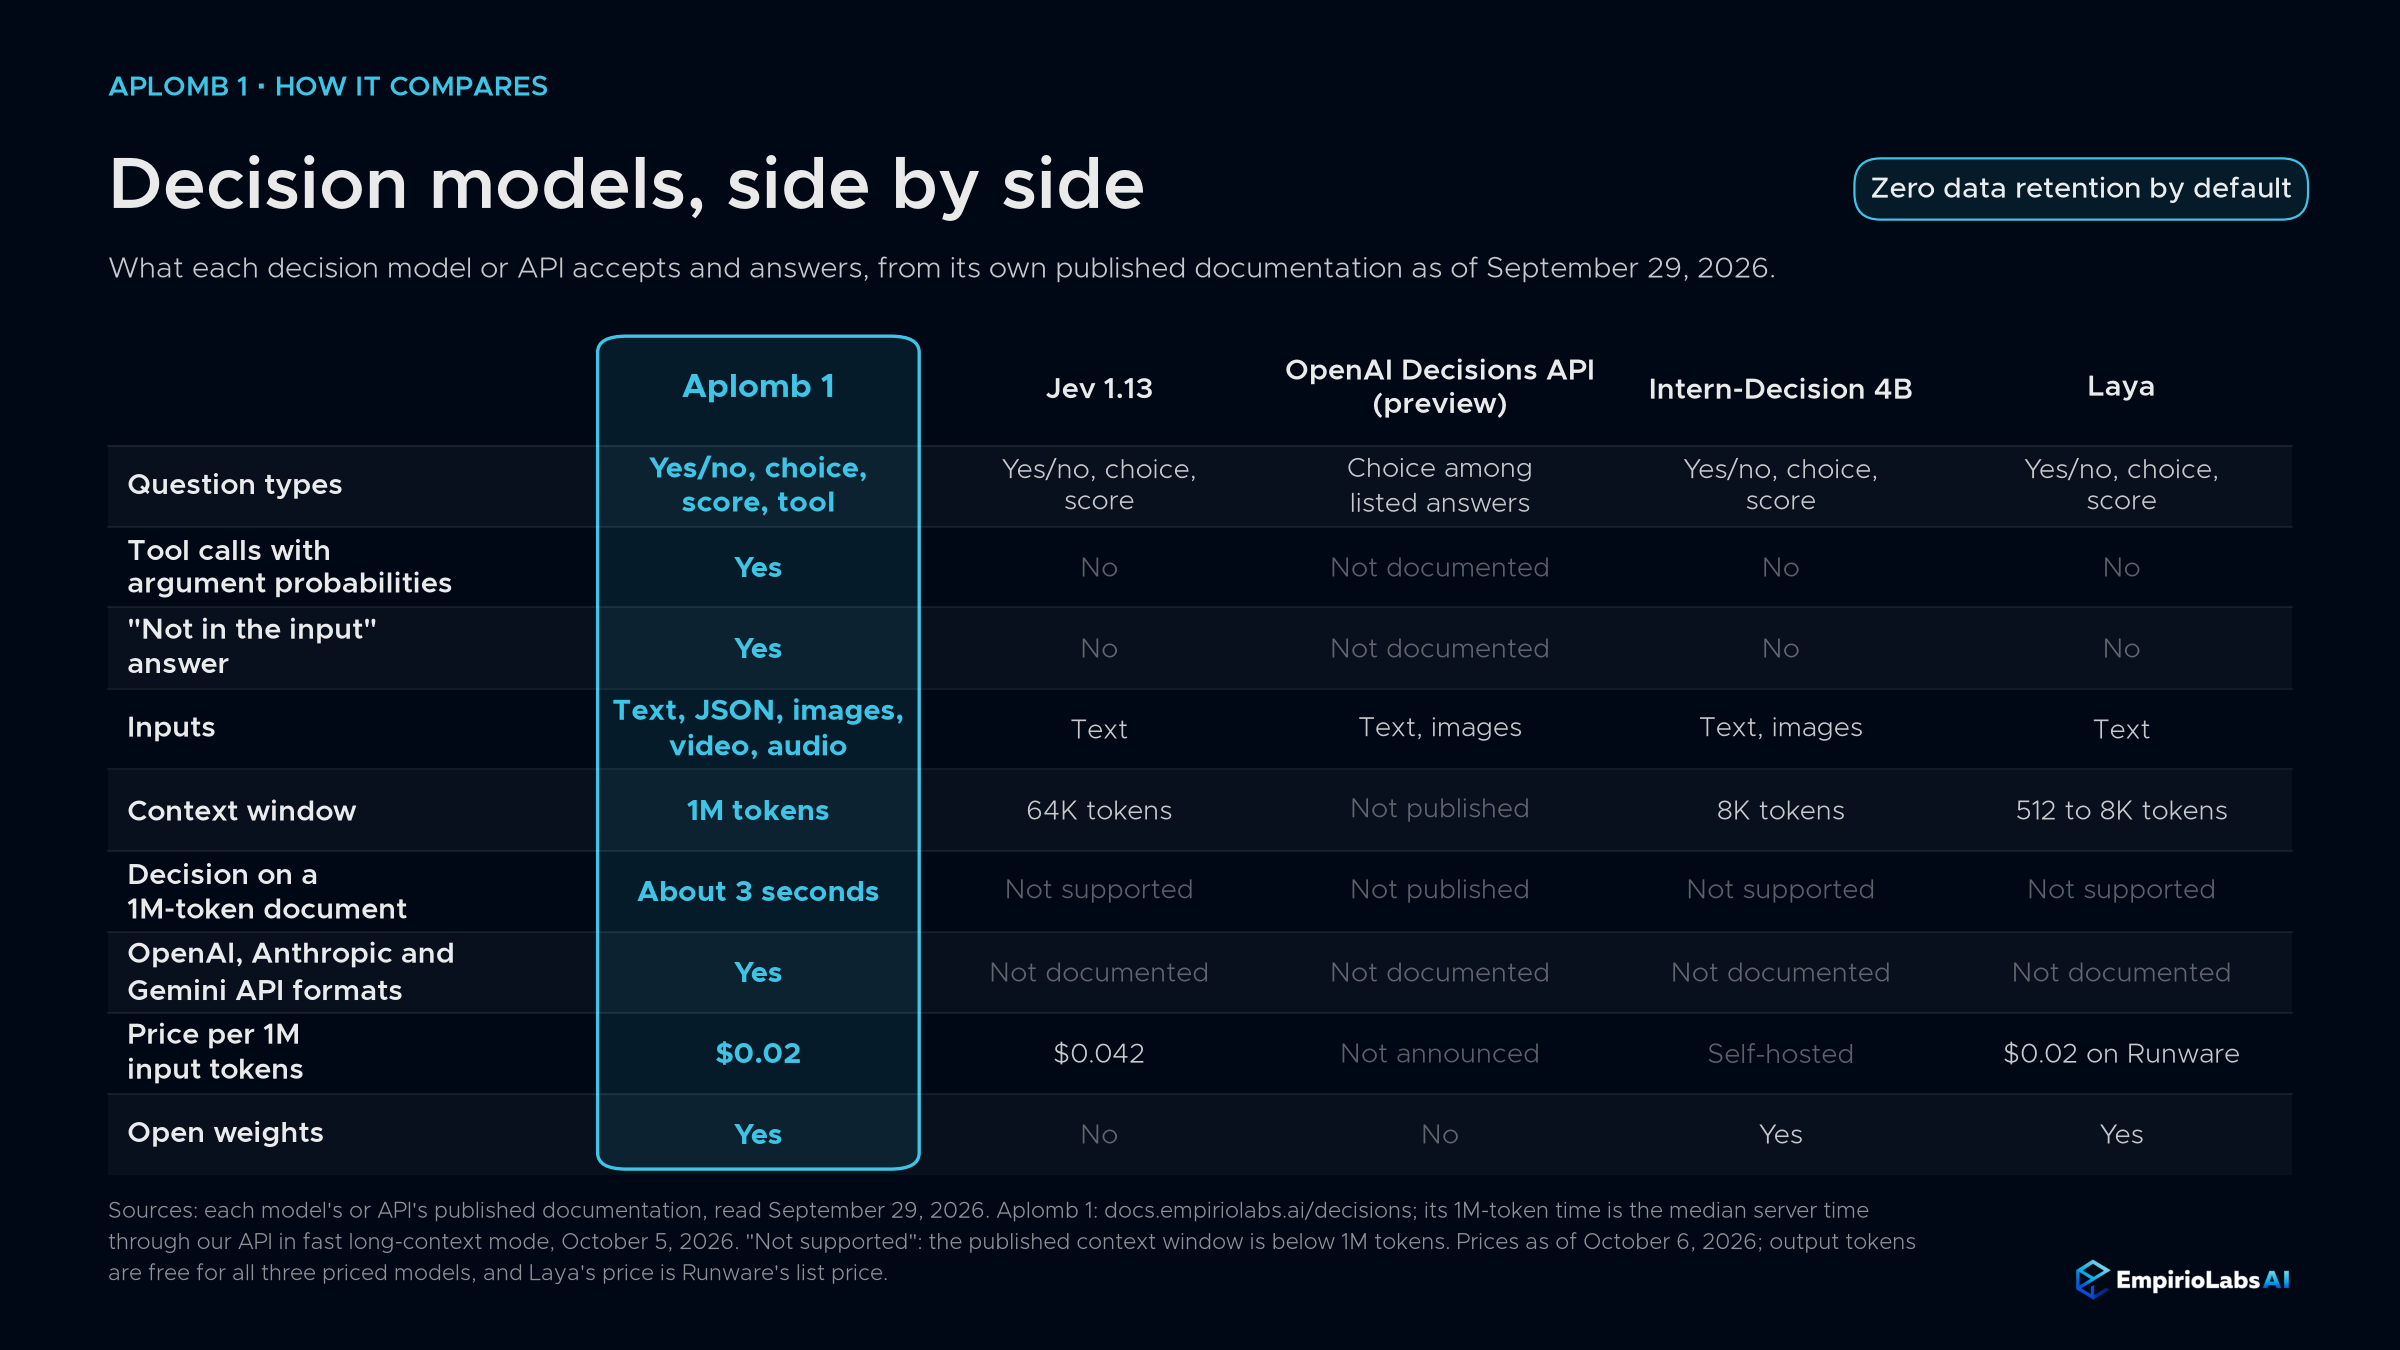
| Aplomb 1 | Jev 1.13 | API OpenAI Decisions (aperçu) | Décision de stage 4B | Laya | |
|---|---|---|---|---|---|
| Types de questions | Oui ou non, choix, score, outil | Oui ou non, choix, score | Choix parmi les réponses listées | Oui ou non, choix, score | Oui ou non, choix, score |
| Sélection d’outils avec probabilités d’argument | Oui | Non | Non documenté | Non | Non |
| Pas dans la réponse de l’État | Oui | Non | Non documenté | Non | Non |
| Entrées | Texte, JSON, images, vidéo, audio | Texte | Texte, images | Texte, images | Texte |
| Fenêtre | 1 000 000 de jetons | 64K jetons | Non publié | 8 192 jetons | 512 à 8 192 jetons |
| Prix par 1M de jetons d’entrée | $0.02 | $0.042 | Non annoncé | Auto-hébergé | $0.02 sur Runware |
| Poids ouverts | Oui | Non | Non | Oui | Oui |
Vitesse et facturation
Aplomb 1 fonctionne sur le propre temps d’exécution d’inférence de EmpirioLabs pour les modèles décisionnels. Une question courte prend environ 15 ms de temps de modèle, une question avec une image d’environ 35 ms, un document de 15 000 jetons environ 0,3 seconde, et un état de 1 million de jetons environ 3 secondes en mode rapide à long contexte, le défaut au-dessus de 131 072 jetons, soit environ 111 secondes lues en entier.
Vous payez uniquement pour les jetons d’entrée: l’état une fois par requête et le texte propre à chaque question, jamais un modèle d’invite. Les jetons de sortie sont toujours zéro. Le taux actuel est sur le page modèle et les page de prix.
Aucune conservation de données est activée par défaut: nous ne conservons pas le contenu de vos demandes ou réponses.
Poids ouverts
Aplomb 1 est construit sur Qwen3.5-4B. Nous avons étendu sa fenêtre de 262K à 1 million de tokens, ajouté une entrée audio avec l’encodeur audio de Qwen3-Omni, ajouté notre propre tête de décision, qui renvoie chaque réponse comme des probabilités calibrées au lieu de texte généré, et entraîné le modèle pour les décisions, y compris la sélection de l’outil et la réponse not-in-the-input. Pour l’API et le Playground, nous avons construit et optimisé notre propre runtime d’inférence.
Les poids et un script de référence pour les faire soi-même sont à huggingface.co/empiriolabsai/aplomb-1. Les réponses du script peuvent différer légèrement de celles de l’API.
La recherche, l’évaluation, l’usage personnel et l’usage interne par des organisations ayant un chiffre d’affaires annuel inférieur à US$1 millions sont gratuites sous la licence modèle EmpirioLabs; héberger Aplomb 1 en tant que service ou le livrer dans un produit vendu à d’autres nécessite une licence commerciale.
Commencez
curl https://api.empiriolabs.ai/v1/decisions \ -H « Autorisation: Porteur $EMPIRIOLABS_API_KEY » \ -H « Type-Contenu: application/json » \ -d '{ « modèle »: « aplomb-1 », « state »: {"commande »: {"id »: « B-44120 », « status »: « expédié », « paiement »: « non payé"}}, « questions »: { « payé »: {"type »: « noul », « instructions »: « L’ordre B-44120 a-t-il été payé ? », « abstenez-vous »: vrai}, « transporteur »: {"type »: « choix », « instructions »: « Quel transporteur livre l’ordre B-44120 ? », « critères »: {"UPS »: null, « FedEx »: null, « dhl »: null}, « abstention »-le-t-il vrai} } }Payé Il me répond par un non assuré. Porte-avions revient avec un effet de haut Abstenez-vous probabilité, car l’enregistrement ne nomme pas de porteuse. Le schéma complet, l’entrée média et les limites se trouvent dans le Guide API des décisions. Aplomb 1 accepte également les requêtes aux formats OpenAI, Anthropic et Gemini, donc vous pouvez l’appeler depuis leurs SDK; les Formats de discussion La section montre comment une demande de chat correspond à une décision. Essayez sans code dans le Playground.
Remerciements
Nous avons développé Aplomb 1 avec l’aide de notre maîtrise d’agents IA à travers les données, la formation, l’évaluation et le déploiement. Merci à l’équipe Qwen pour Qwen3.5 et Qwen3-Omni, sur lesquels Aplomb 1 s’appuie, à Lambda pour les GPU que nous avons entraînés et sur lesquels nous l’avons fourni, ainsi qu’au programme NVIDIA Inception, au programme Z.ai startup et au programme StepFun pour leur soutien.