LightOnOCR-3 4B está disponible en EmpirioLabs. Es el modelo OCR de documentos de LightOn: envía un PDF o una imagen, y devuelve cada página como Markdown, con el texto en orden de lectura, encabezados, listas, tablas, matemáticas en LaTeX y gráficos como tablas de sus puntos de datos. Cada página también aparece con su diseño: el tipo y la posición de cada bloque en la página. Funciona DESPUÉS /v1/ocr, en la API y en la Playground.
Referencia. LightOn informa de una puntuación global olmOCR-Bench de 86,3 para LightOnOCR-3 4B en su Anuncio de lanzamiento del 8 de octubre de 2026.
Lo que dice
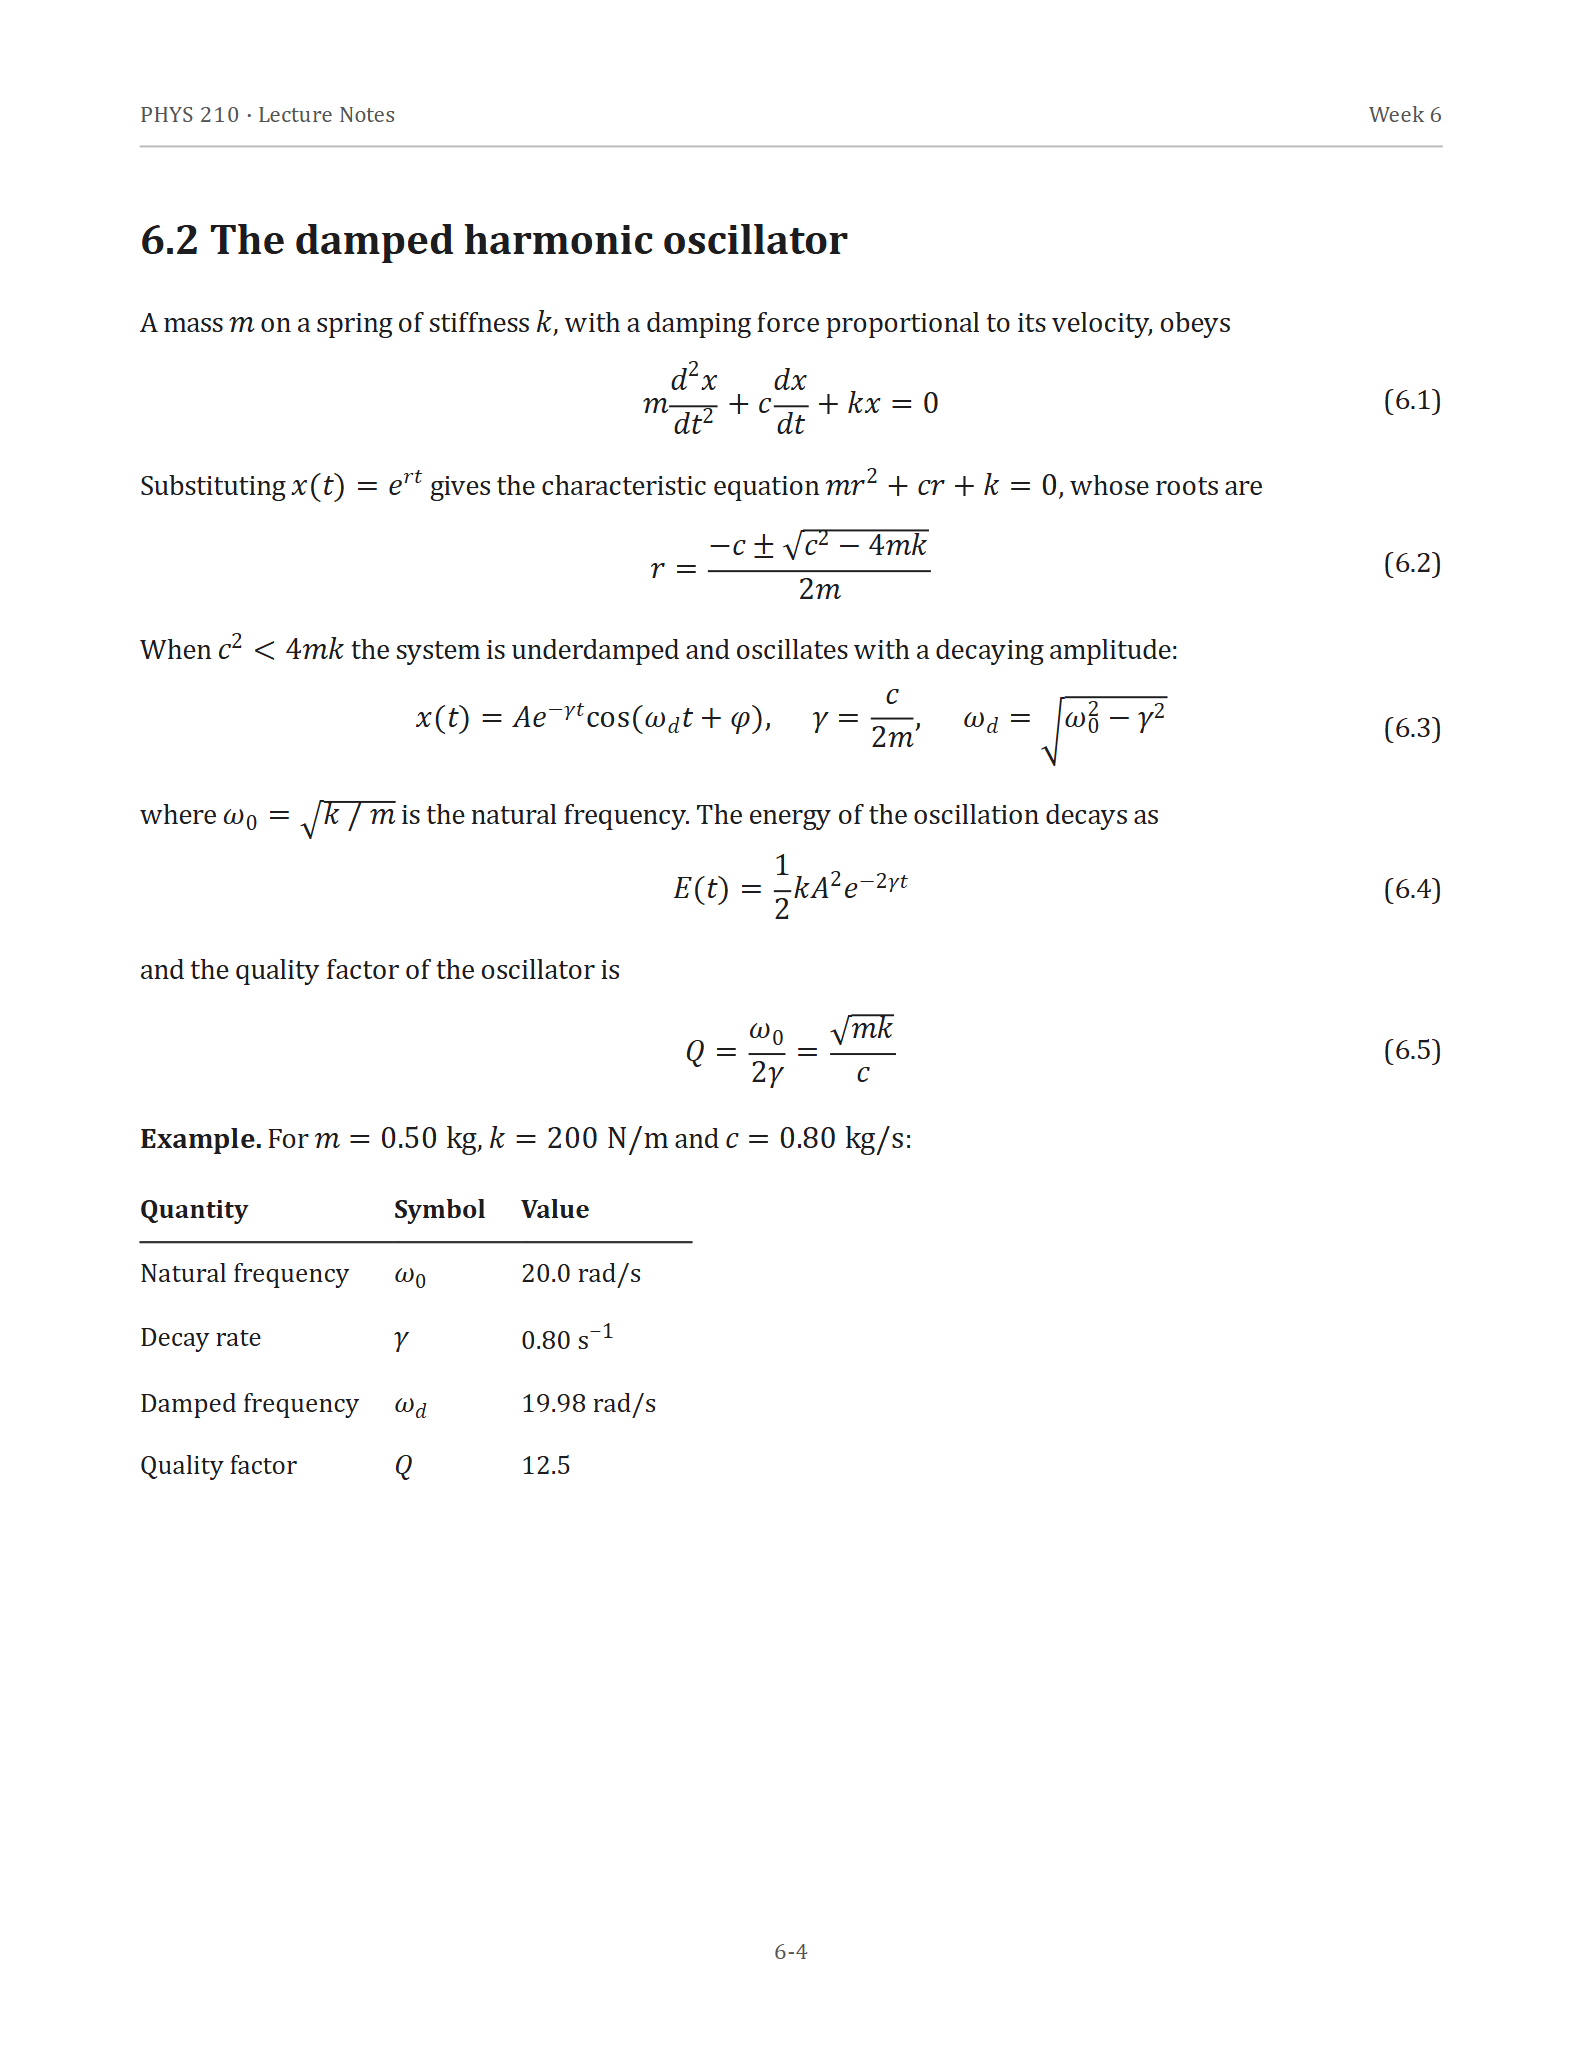
Una página de prueba con apuntes de clase, leído en una petición. Esta página y dos más contra tres modelos de chat de visión están en LightOnOCR-3 4B vs Qwen3.5 4B vs Gemma 4 26B-A4B vs Mistral Small 3.1.
El inicio del Markdown que devolvió para esa página; las otras tres ecuaciones, la tabla y el número de página siguen en la misma respuesta:
PHYS 210 · Notas de clase Semana 6 ## 6.2 El oscilador armónico amortiguado Una masa $m$ sobre un muelle de rigidez $k$, con una fuerza de amortiguamiento proporcional a su velocidad, obedece $$ m \frac{d^2 x}{dt^2} + c \frac{dx}{dt} + kx = 0 \quad \text{(6.1)} $$ Sustituyendo $x(t) = e^{rt}$ da la ecuación característica $mr^2 + cr + k = 0$, cuyas raíces son $$ r = \frac{-c \pm \sqrt{c^2 - 4mk}}{2m} \quad \text{(6.2)} $$Tu primera petición
Envía un documento por URL o como un URI de datos base64. Esta solicitud lee las dos primeras páginas de un PDF de muestra:
curl https://api.empiriolabs.ai/v1/ocr \ -H "Autorización: Portador $EMPIRIOLABS_API_KEY" \ -H "Tipo-Contenido: application/json" \ -d '{ "modelo": "lightonocr-3-4b", "documento": { "tipo": "document_url", "document_url": "https://media.empiriolabs.ai/assets/blog-images/lightonocr-3-4b-test-2026-10-25/sample-document.pdf" }, "páginas": [0, 1] }'Un archivo en tu máquina se introduce como un URI de datos, sin necesidad de alojamiento:
importar Base64 importar solicitudes de importación de sistemas operativos con Open("report.pdf", "RB") como usuario: encoded = base64.b64encode(handle.read()).decode() respuesta = requests.post("https://api.empiriolabs.ai/v1/ocr", headers={"Authorization": f"Bearer {os.environ['EMPIRIOLABS_API_KEY']}"}, json={ "model": "lightonocr-3-4b", "document": {"type": "document_url", "document_url": f"data:application/pdf; base64,{encoded}"}, }, timeout=300,) response.raise_for_status() para página en response.json()["páginas"]: print(f"--- página {page['index']} ---") print(página["markdown"])Una imagen funciona igual, con "tipo": "image_url" y la URL o el URI de datos en image_url. Un documento puede ser un PDF o una imagen PNG, JPEG, WebP, TIFF, BMP, GIF o AVIF de hasta 50 MB, y una solicitud puede leer hasta 1.000 páginas.
¿Qué vuelve a la historia
La respuesta contiene un objeto por página en Páginas. Cada uno tiene la página como Descuento; Bloques, cada región de la página en orden de lectura con su tipo (Título, Texto, Lista, Tabla, Ecuación, Pie de foto, Encabezado, Pie de página, y otros) y su caja en píxeles; Imágenes, las regiones de imagen; y Dimensiones, el tamaño de la imagen de la página a la que se refieren las cajas. usage_info.pages_processed cuenta las páginas leídas. Uno de los 16 bloques devueltos para la página de apuntes de clase:
{ "type": "equation", "top_left_x": 641, "top_left_y": 526, "bottom_right_x": 1447, "bottom_right_y": 610, "content": "$$\nr = \\frac{-c \\pm \\sqrt{c^2 - 4mk}}{2m} \\quad \\text{(6.2)}\n$$" }Una pregunta de respuestas cuando se leen sus páginas. Una sigue funcionando tras unos cuatro minutos y medio de respuestas 202 con un job id: encuesta ¡QUE /v1/jobs/{job_id} hasta que Estado es terminado, y las páginas están en Resultado. Para obtener el ID del trabajo de inmediato, envía el encabezado Preferir: respond-async.
Opciones
- Páginas.
Páginastoma números de página basados en cero como una lista ([0, 2, 3]) o una cuerda ("0,2-4"). Déjalo fuera para leer cada página. - Mesas.
table_formatEstablecido aDescuentooHTMLMueve cada mesa aTablasen ese formato y deja un enlace como[tbl-0.html] (tbl-0.html)en la página Markdown. Sin él, las tablas permanecen en el Markdown como HTML. - Imágenes.
include_image_base64devuelve cada región de imagen como un URI de datos JPEG.image_limitlimita cuántas imágenes aparecen en todo el documento, yimage_min_sizeOmite regiones más estrechas o cortas que ese número de píxeles. - Cabezazos y pies.
extract_headeryextract_footermoverlos fuera del Markdown a sus propios campos. - Distribución.
include_blocksEstablecido afalsohojasBloquesfuera.
Notas operativas
- Los números de página comienzan en 0.
"páginas": [1]lee la segunda página. - Los signos de dólar pueden volver a escapar. En el texto de la página, puede decirse un signo de dólar
\$, y dentro de tablas HTML$. Libera el descuento antes de buscarlo para ver las cantidades. - Se rechazan los campos de anotación.
bbox_annotation_format,document_annotation_format, ydocument_annotation_promptRespuesta400antes de que se lea cualquier página.
Precios
Facturado por página leída. Cada solicitud se factura al menos 5 páginas, así que envía un documento largo en formato PDF en lugar de una solicitud por página. Una solicitud que falla no se factura por páginas que no ha devuelto. Las tarifas actuales están en el página modelo y el página de precios.
Empieza a construir
Prueba con LightOnOCR-3 4B en el Playground con tu propio documento, y lee el Guía OCR de documentos y el Documentación de la API para cada parámetro.
Divulgación: Este artículo fue escrito con asistencia AI y revisado por EmpirioLabs AI.