Aplomb 1 es nuestro primer modelo. Toma texto, JSON, imágenes, audio y vídeo en una sola petición, lee hasta 1 millón de tokens y toma una decisión sobre un documento de 1 millón de tokens en unos 3 segundos. Una pregunta corta lleva unos 15 ms de tiempo de modelo.
Funciona en un runtime de inferencia que construimos para modelos de decisión. En nuestra API y en el Playground, los documentos largos pasan por un modo rápido de contexto largo: un documento con 1M de token tarda unos 3 segundos en lugar de 111, y el modo rápido respondió correctamente a las 525 decisiones en nuestras pruebas de contexto largo.
Para los agentes, Aplomb 1 devuelve una probabilidad para cada herramienta y para cada argumento enum y booleano en una sola petición, así que un agente actúa cuando el modelo está seguro y escala cuando no lo está. Cada respuesta está calibrada, y puede indicar cuándo la entrada no contiene la respuesta en lugar de adivinar. Está diseñado para las decisiones que el software toma miles de veces al día, desde enrutar un ticket hasta elegir la siguiente herramienta de un agente.
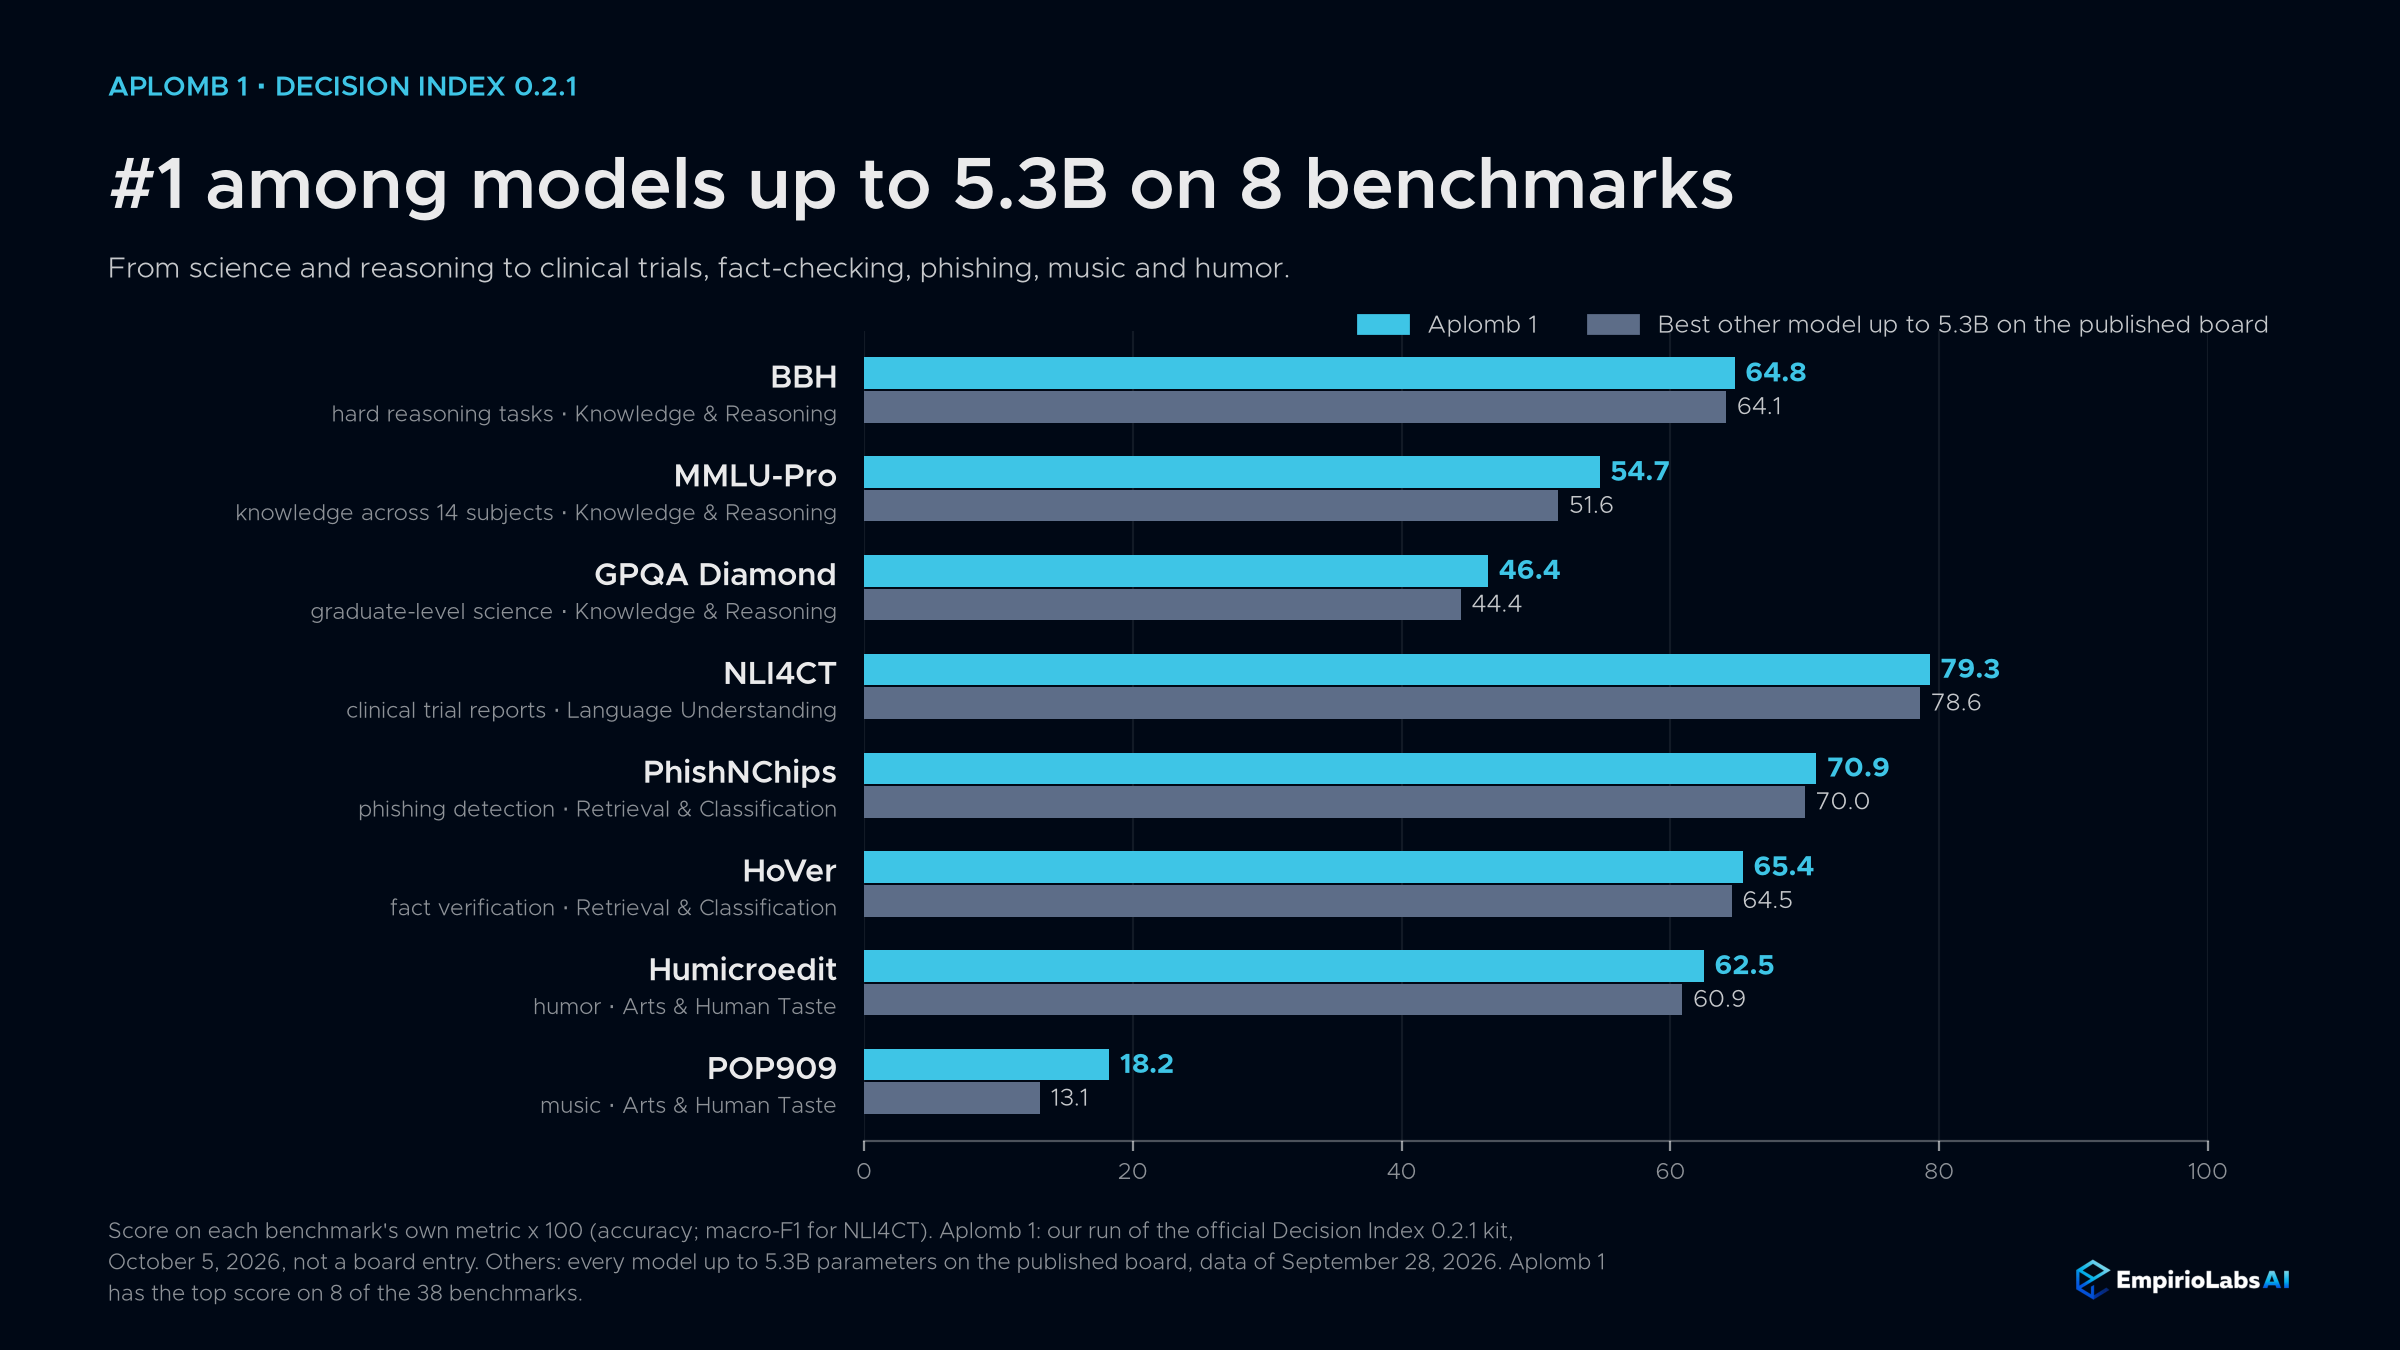
A fecha de 6 de octubre de 2026, es el #1 entre los modelos 4B en el panel publicado del Decision Index, con 44,86 en nuestra edición oficial del equipamiento y #1 entre los modelos de hasta 5,3B en 8 de los 38 benchmarks. Está disponible hoy en día en la API EmpirioLabs y Playground, y sus pesos están en Hugging Face bajo la EmpirioLabs Model License.
| Aplomb 1 de un vistazo | |
|---|---|
| Entradas | Texto, JSON, imágenes, vídeo y audio, en cualquier mezcla |
| Ventana | 1.000.000 de fichas de estado más pregunta |
| Preguntas | Sí o no, elección (2 a 255 opciones), puntuación (2 a 10 niveles), selección de herramientas |
| No en el estado | Una probabilidad de que la entrada no tenga la respuesta |
| Selección de herramientas | La siguiente herramienta a llamar, con probabilidades para sus argumentos de enum y booleano |
| Velocidad | Unos 15 ms de tiempo de modelo para una pregunta corta; unos 3 segundos para un documento de 1M de tokens en modo rápido de largo contexto |
| Formatos API | La API de Decisiones, además de los formatos OpenAI, Anthropic y Gemini |
| Facturación | Solo tokens de entrada; los tokens de salida siempre son cero |
| Retención de datos | Retención cero de datos por defecto |
| Tamaño | 5.300 millones de parámetros, construidos sobre Qwen3.5-4B; pesos abiertos en Hugging Face |
| Índice de Decisión 0.2.1 | 44,86 en nuestra edición del kit oficial, #1 entre los modelos 4B en la tabla publicada a fecha de 6 de octubre de 2026 |
Lo que responde
Cuatro tipos de preguntas. Noul Responde sí o no con la probabilidad de que sí. Elección elige una de entre 2 y 255 opciones y devuelve la distribución completa. Partitura sitúa al estado en una escala ordenada de 2 a 10 niveles. Herramienta Elige cuál de tus herramientas de función llamar y devuelve distribuciones sobre sus argumentos enum y booleano.
No en el estado. Añadir "abstenerse": cierto a una pregunta y la respuesta también conlleva la probabilidad de que el estado no contenga lo que la pregunta necesita. Un registro sin campo portador obtiene una alta probabilidad de abstención en lugar de una suposición segura.
Respuestas independientes. Hasta 128 preguntas comparten un estado, y cada una se responde por sí sola, por lo que añadir una pregunta nunca cambia otra respuesta.
Selección de herramientas para agentes
Da a Aplomb 1 las herramientas de función de tu agente y el estado actual (un ticket, una conversación, un registro), y devuelve la llamada a continuación con una probabilidad para cada herramienta y una distribución para cada argumento enum y booleano, en una sola petición. Un LLM general escribe una llamada de herramienta token por token y no dice cuán seguro está sobre la herramienta o cualquier argumento. El agente actúa cuando la probabilidad es alta y pasa el paso a un modelo mayor cuando no lo es, por lo que los pasos rutinarios saltan una respuesta generada. No encontramos otro modelo de decisión que devuelva probabilidades de argumento.
Un ticket que dice "Pedido B-44120 llegó con la pantalla agrietada. Quiero que me devuelvan el dinero." Con tres herramientas, issue_refund (a Razón enum y a full_refund booleano), track_package y escalate_to_human, responde como (abreviado, redondeado):
{"herramienta": "issue_refund", "probabilidades": {"issue_refund": 0,969, "ninguna": 0,025, "escalate_to_human": 0,005, "track_package": 0,002}, "argumentos": {"issue_refund": { "razón": {"valor": "dañado", "probabilidades": {"dañado": 0,993, "not_as_described": 0,007, "tarde": 0,001}, "full_refund": {"valor": verdadero, "probability_true": 0,761}}}, "open_arguments": {"track_package": ["order_id"]}}
Los argumentos en texto libre, como un id de orden, se listan bajo open_arguments para que el agente lo cubra.
Entradas mixtas, hasta 1 millón de tokens
El texto, los objetos JSON y los arrays, imágenes, vídeo y audio entran en el mismo estado, en cualquier combinación: una llamada de soporte grabando junto al registro de la cuenta, un clip de dashcam junto al formulario de reclamación, una foto de producto junto al anuncio. El estado más la pregunta más larga pueden llegar a 1.000.000 de tokens, suficiente para un paquete de contrato largo, un año de tickets o horas de transcripciones en una sola solicitud.
Cómo pone la puntuación
Ejecutamos Aplomb 1 y tres modelos de decisión 4B abiertos en los mismos ítems, y fijamos los números que Intern-Decision publicó para Jev, JevK5 y Semif junto a ellos. En los siete informes de Intern-Decision del paquete de siete suites, Aplomb 1 promedia un 88,7%. Frente a la línea publicada por Jev, está por delante en JevBench Hard y decisiones tipadas, empatado en JevBench Easy, y por detrás en JevBench Original, ToolACE, AG News y WildJailbreak. Su mayor ventaja es en JevBench Hard, +5,4 puntos.
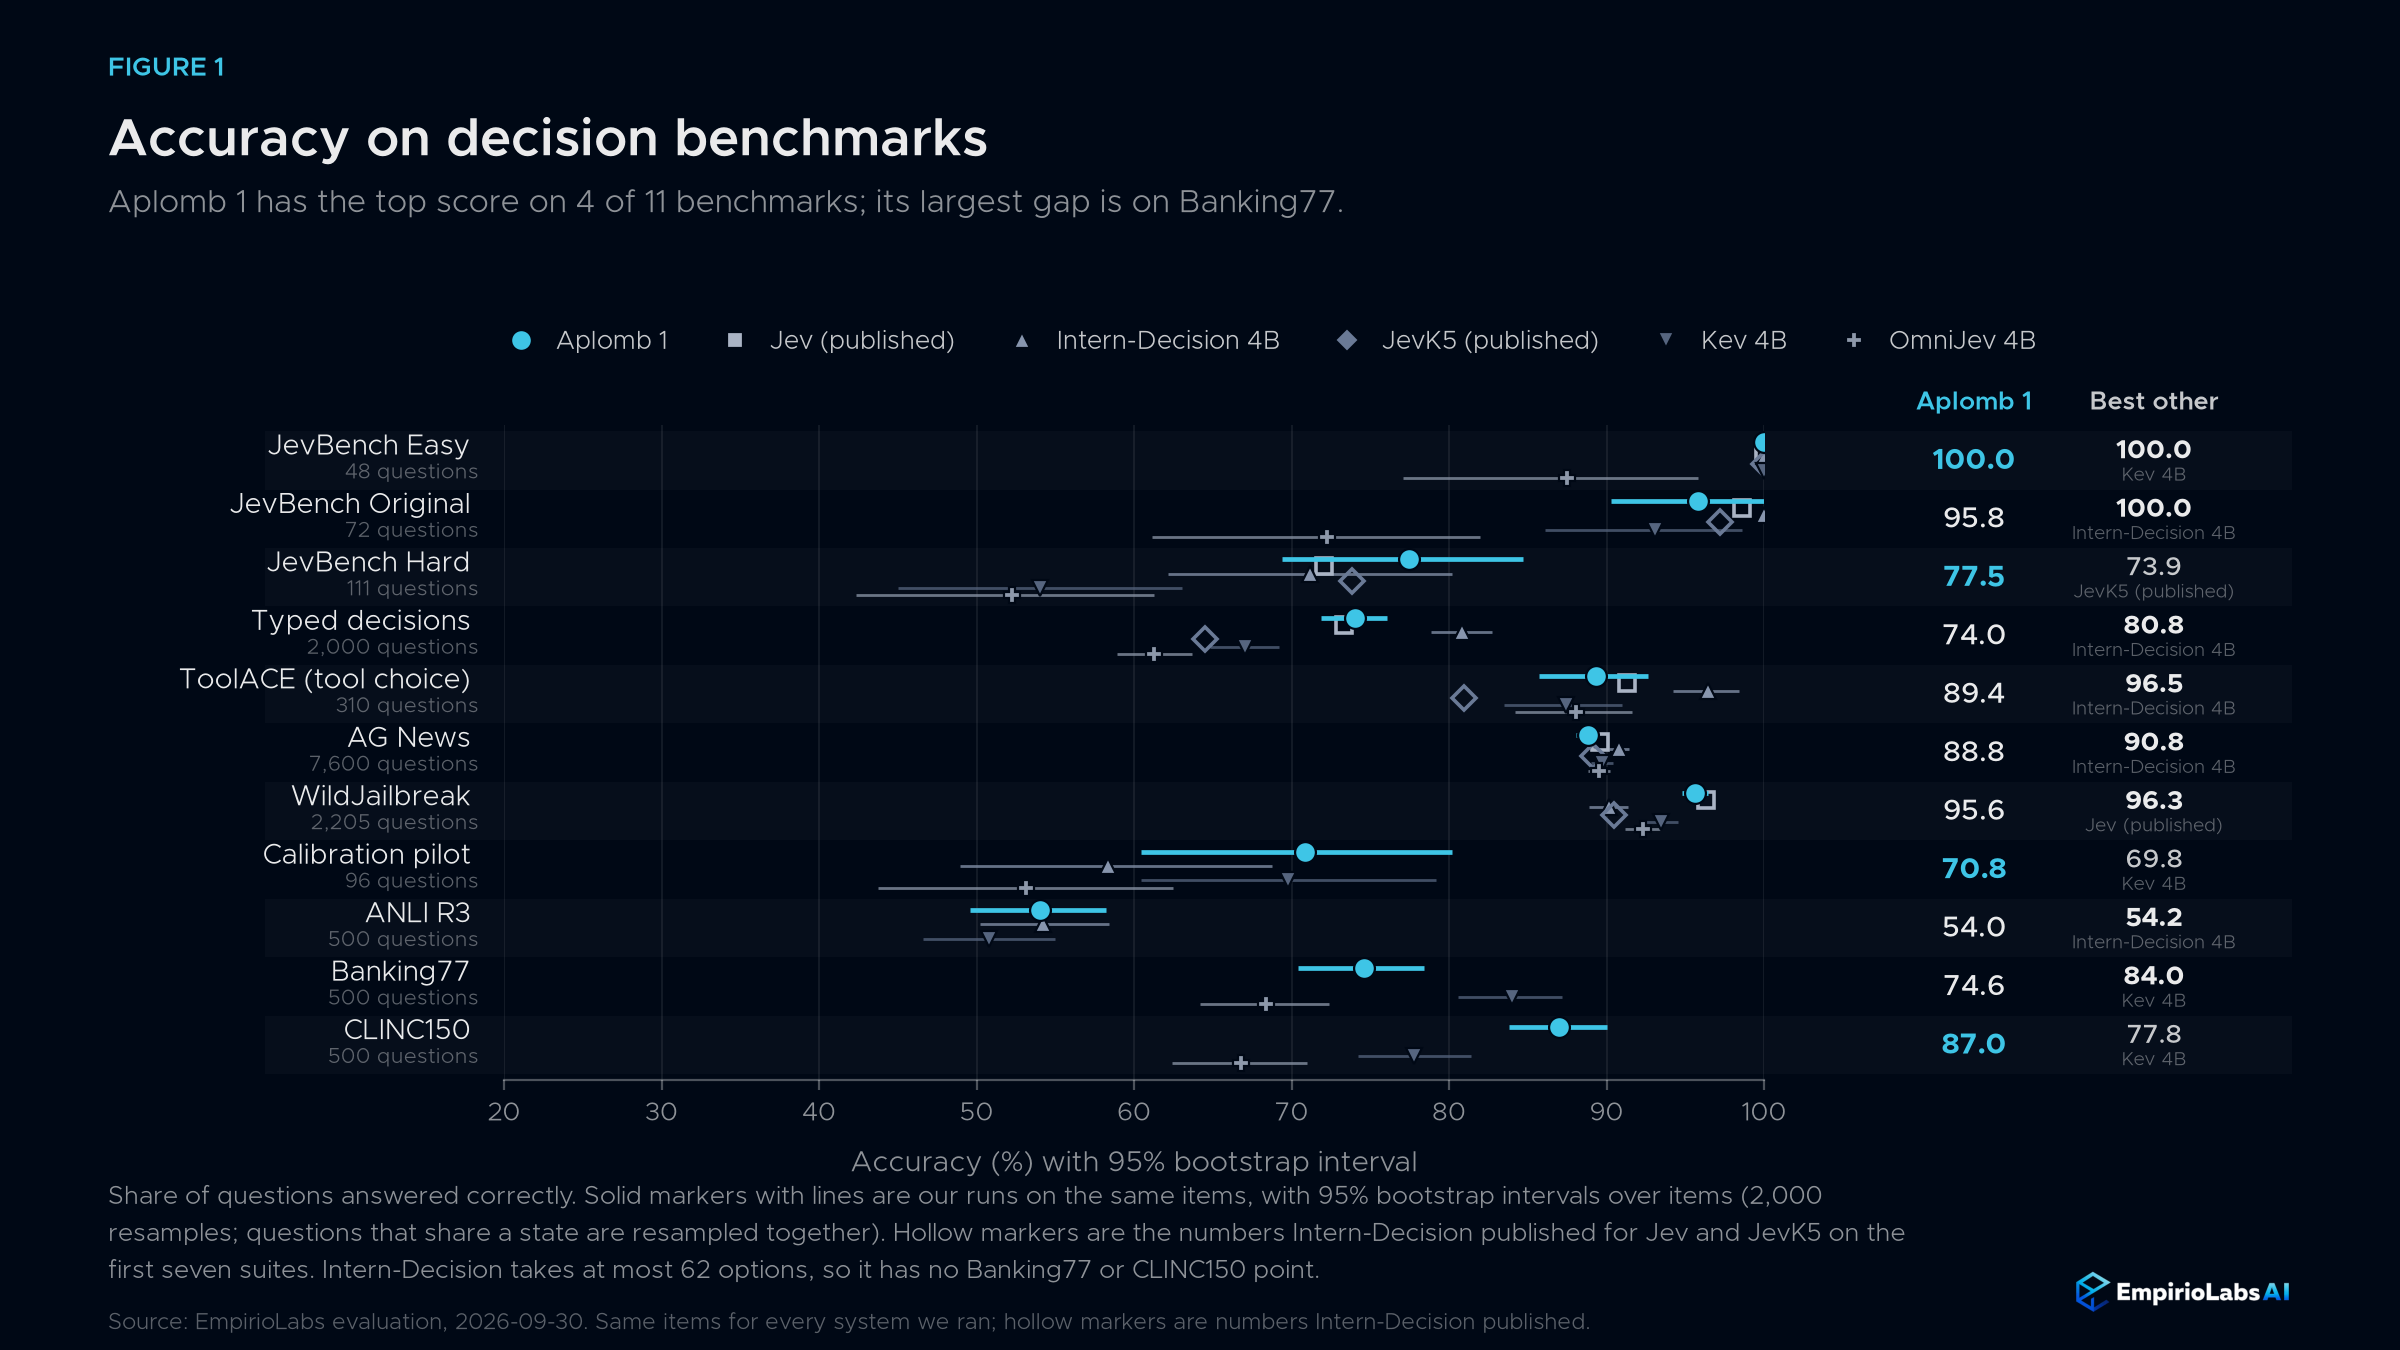
| Índice de referencia | Aplomb 1 | Jev (p) | JevK5 (p) | SemIf (p) | Decisión de Becarios 4B | Kev 4B | OmniJev 4B |
|---|---|---|---|---|---|---|---|
| JevBench Easy | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 87.5 |
| JevBench Original | 95.8 | 98.6 | 97.2 | 98.6 | 100.0 | 93.1 | 72.2 |
| JevBench Difícil | 77.5 | 72.1 | 73.9 | 61.3 | 71.2 | 54.1 | 52.3 |
| Decisiones tipificadas | 74.0 | 73.3 | 64.5 | 62.8 | 80.8 | 67.0 | 61.3 |
| ToolACE | 89.4 | 91.3 | 81.0 | 85.2 | 96.5 | 87.4 | 88.1 |
| AG News | 88.8 | 89.6 | 89.1 | 89.2 | 90.8 | 89.7 | 89.6 |
| Fuga de la cárcel salvaje | 95.6 | 96.3 | 90.5 | 92.5 | 90.2 | 93.5 | 92.3 |
| Promedio | 88.7 | 88.7 | 85.2 | 84.2 | 89.9 | 83.5 | 77.6 |
(p) Según lo publicado por Intern-Decision para los mismos elementos. Intern-Decision reporta 90,02 para su modelo 4B en este paquete; la columna muestra nuestra ejecución.
| Índice de referencia | Aplomb 1 | Decisión de Becarios 4B | Kev 4B | OmniJev 4B |
|---|---|---|---|---|
| Piloto de calibración | 70.8 | 58.3 | 69.8 | 53.1 |
| ANLI R3 | 54.0 | 54.2 | 50.8 | n/a |
| Banking77 (77 opciones) | 74.6 | n/a | 84.0 | 68.4 |
| CLINC150 (150 opciones) | 87.0 | n/a | 77.8 | 66.8 |
Entradas largas
Medimos las búsquedas en registros de orden desde 16K hasta 1M tokens, con las preguntas sobre un orden colocadas a una profundidad aleatoria.
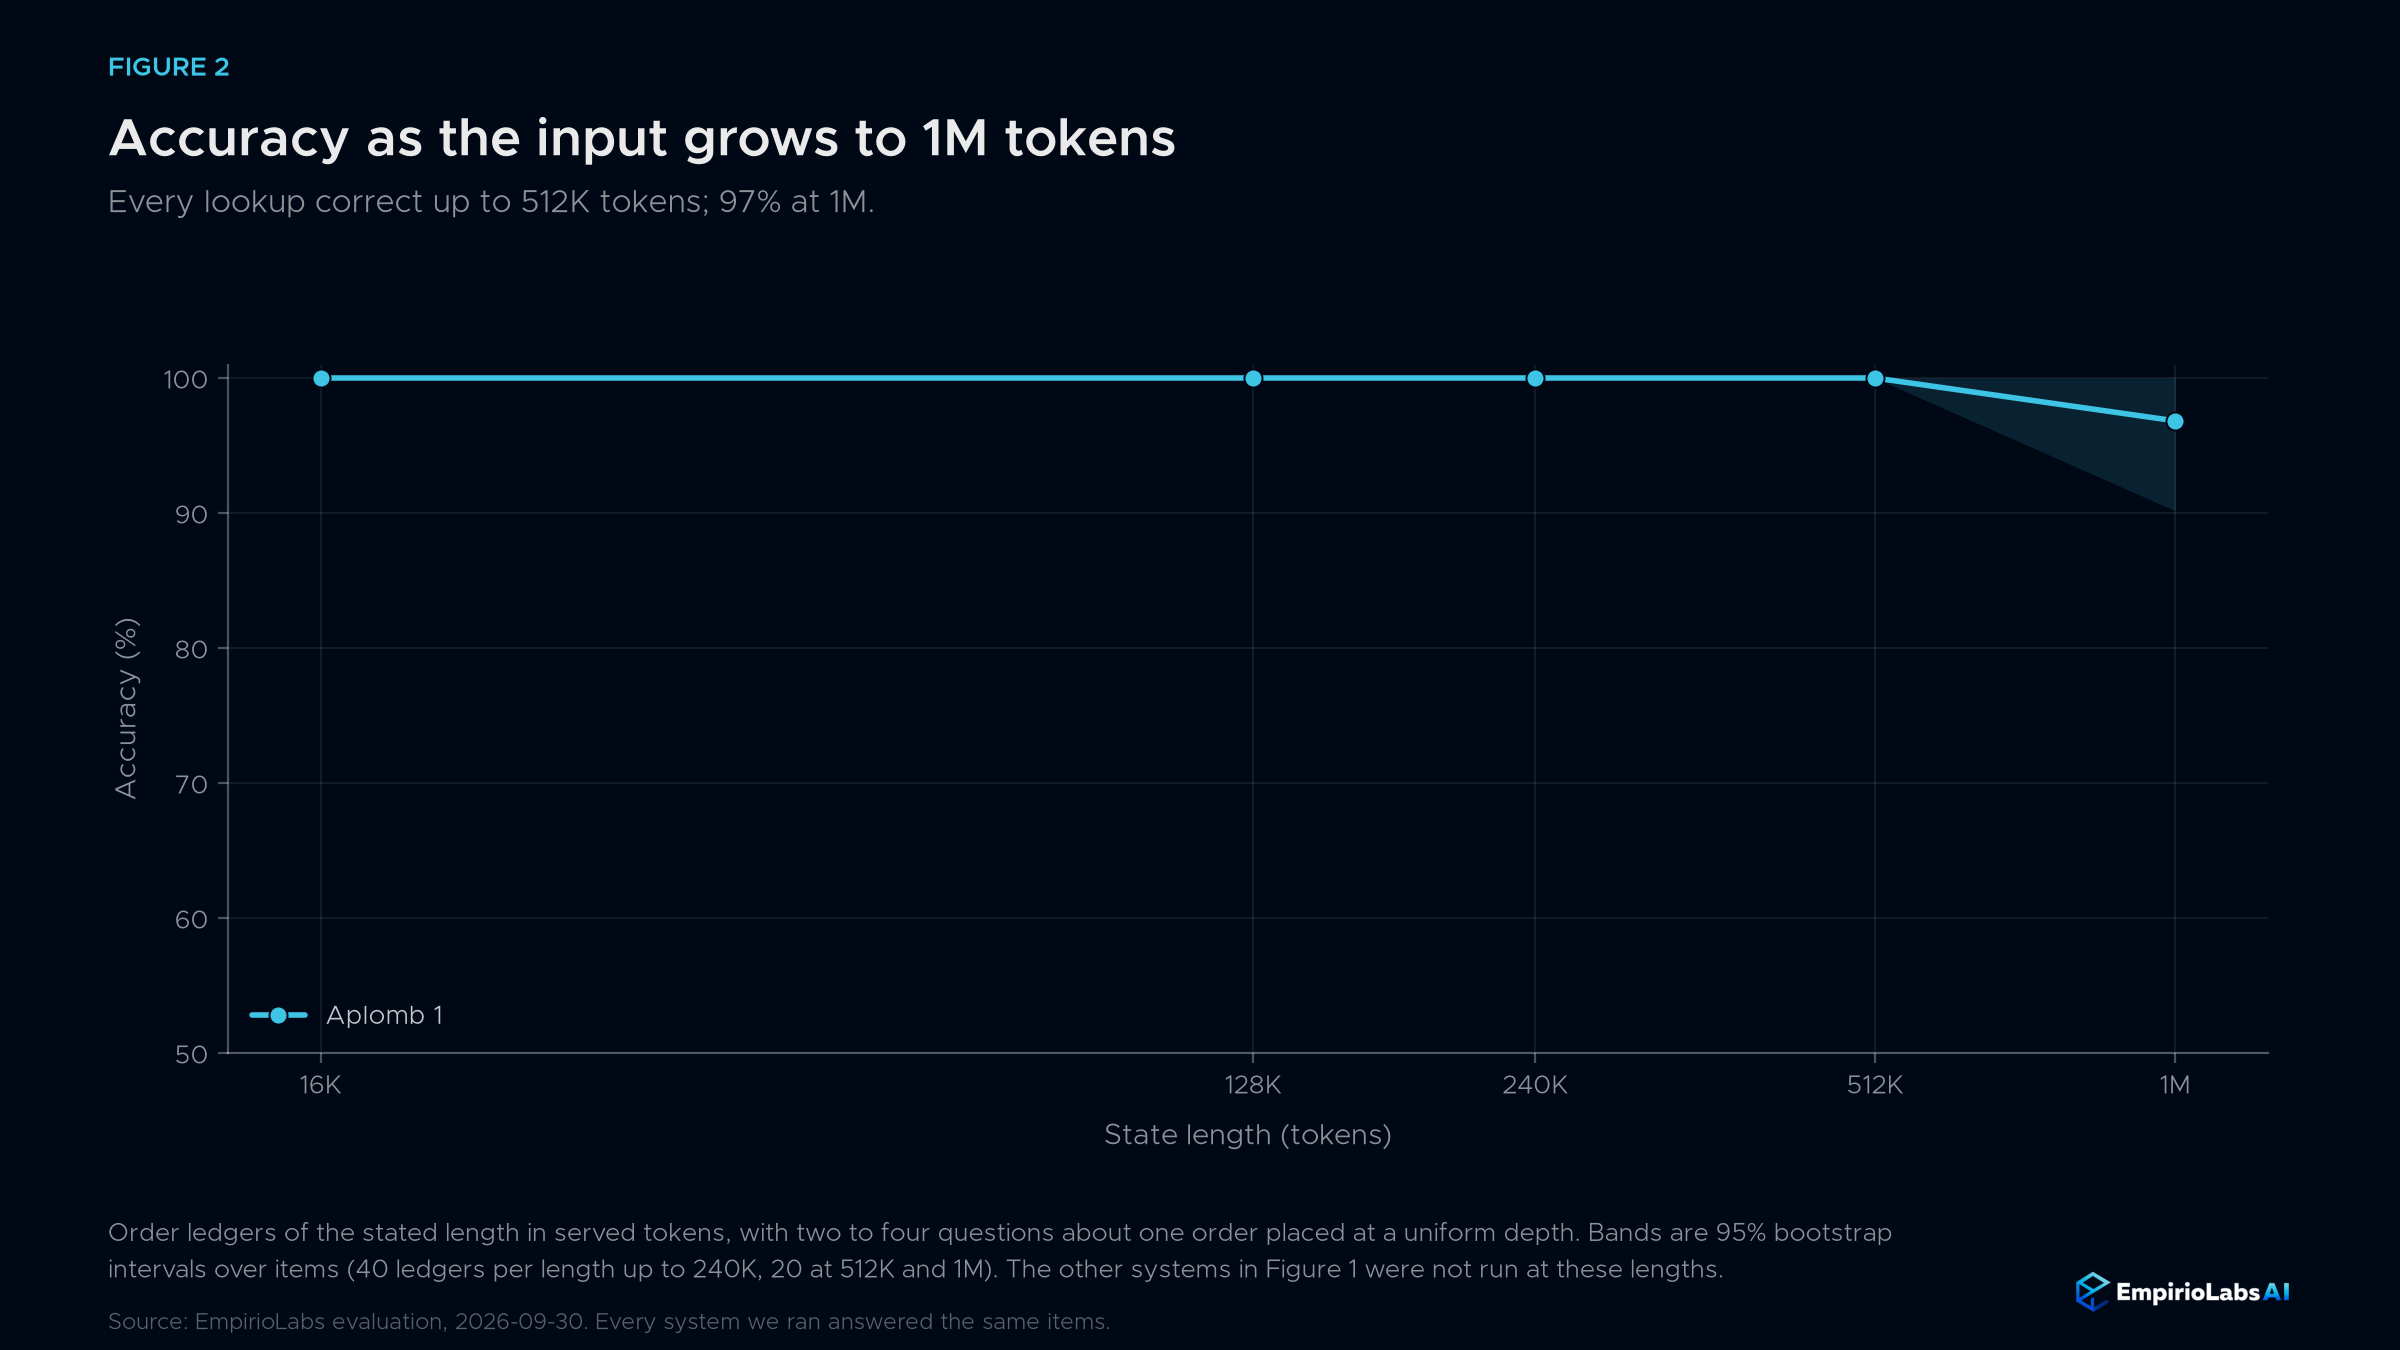
| Longitud de entrada (tokens) | 16K | 128K | 240K | 512K | 1M |
|---|---|---|---|---|---|
| Aplomb 1 | 100.0 | 100.0 | 100.0 | 100.0 | 96.8 |
Documentos largos en segundos
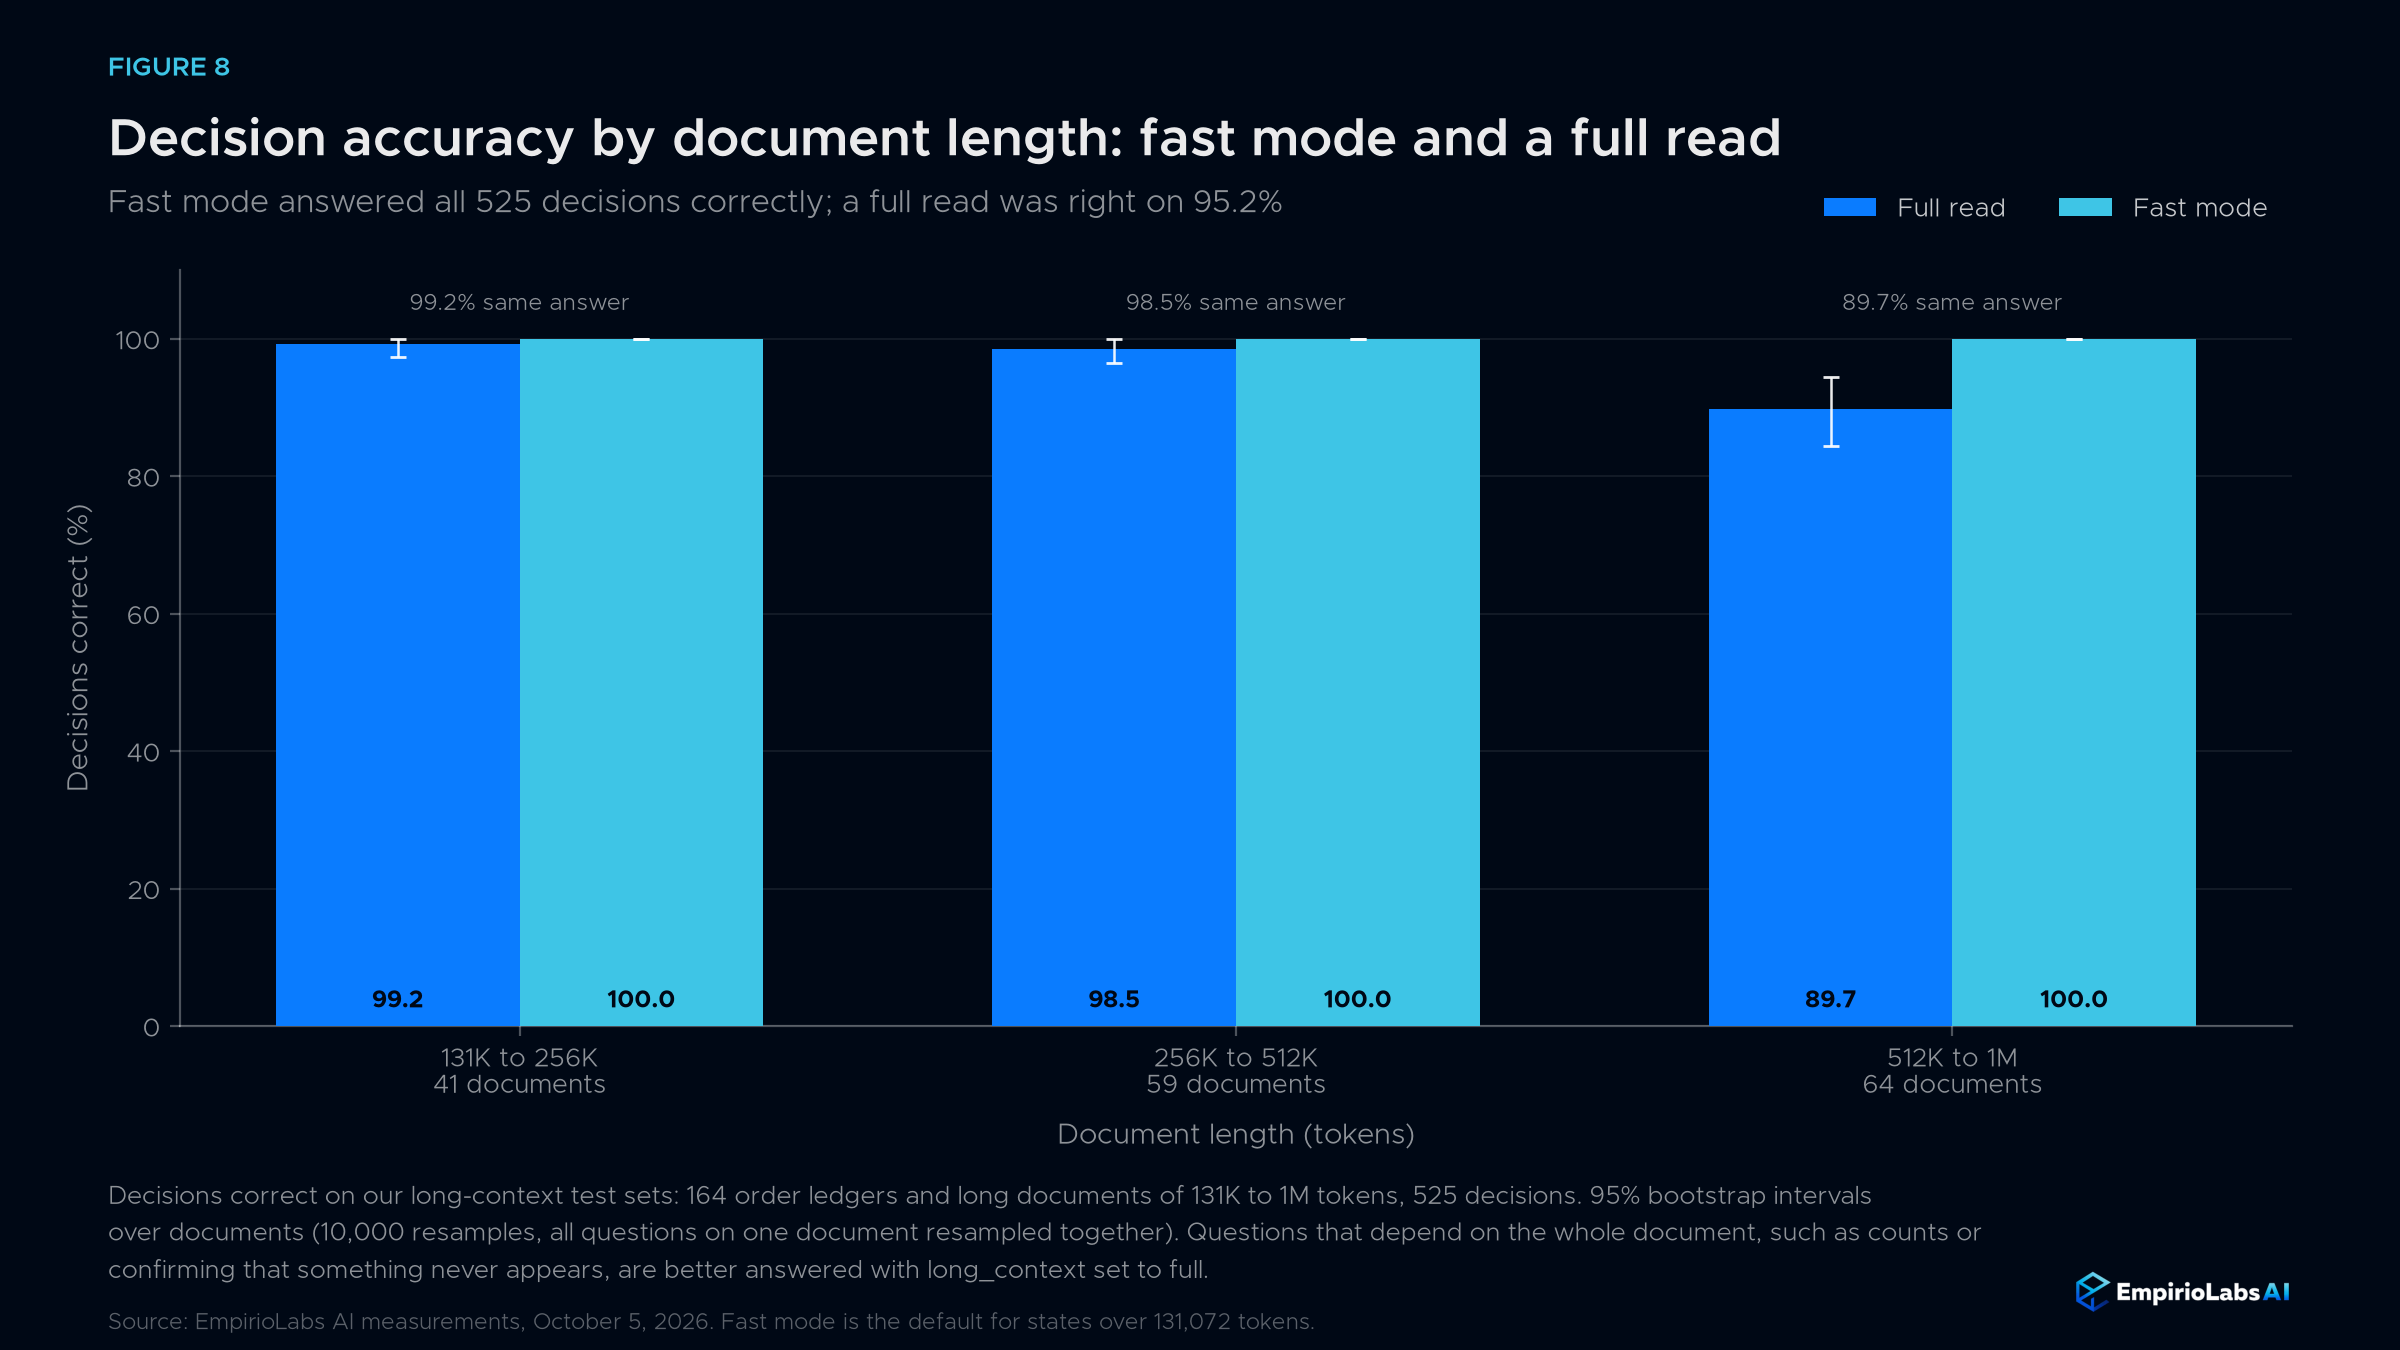
En la API EmpirioLabs y en la Playground, un estado superior a 131.072 tokens se lee por defecto en modo rápido de contexto largo. Un documento de 1M de tokens tarda unos 3 segundos en lugar de unos 111 segundos en su totalidad, y en nuestros conjuntos de test de contexto largo el modo rápido respondió correctamente a las 525 decisiones, frente al 95,2% para una lectura completa.
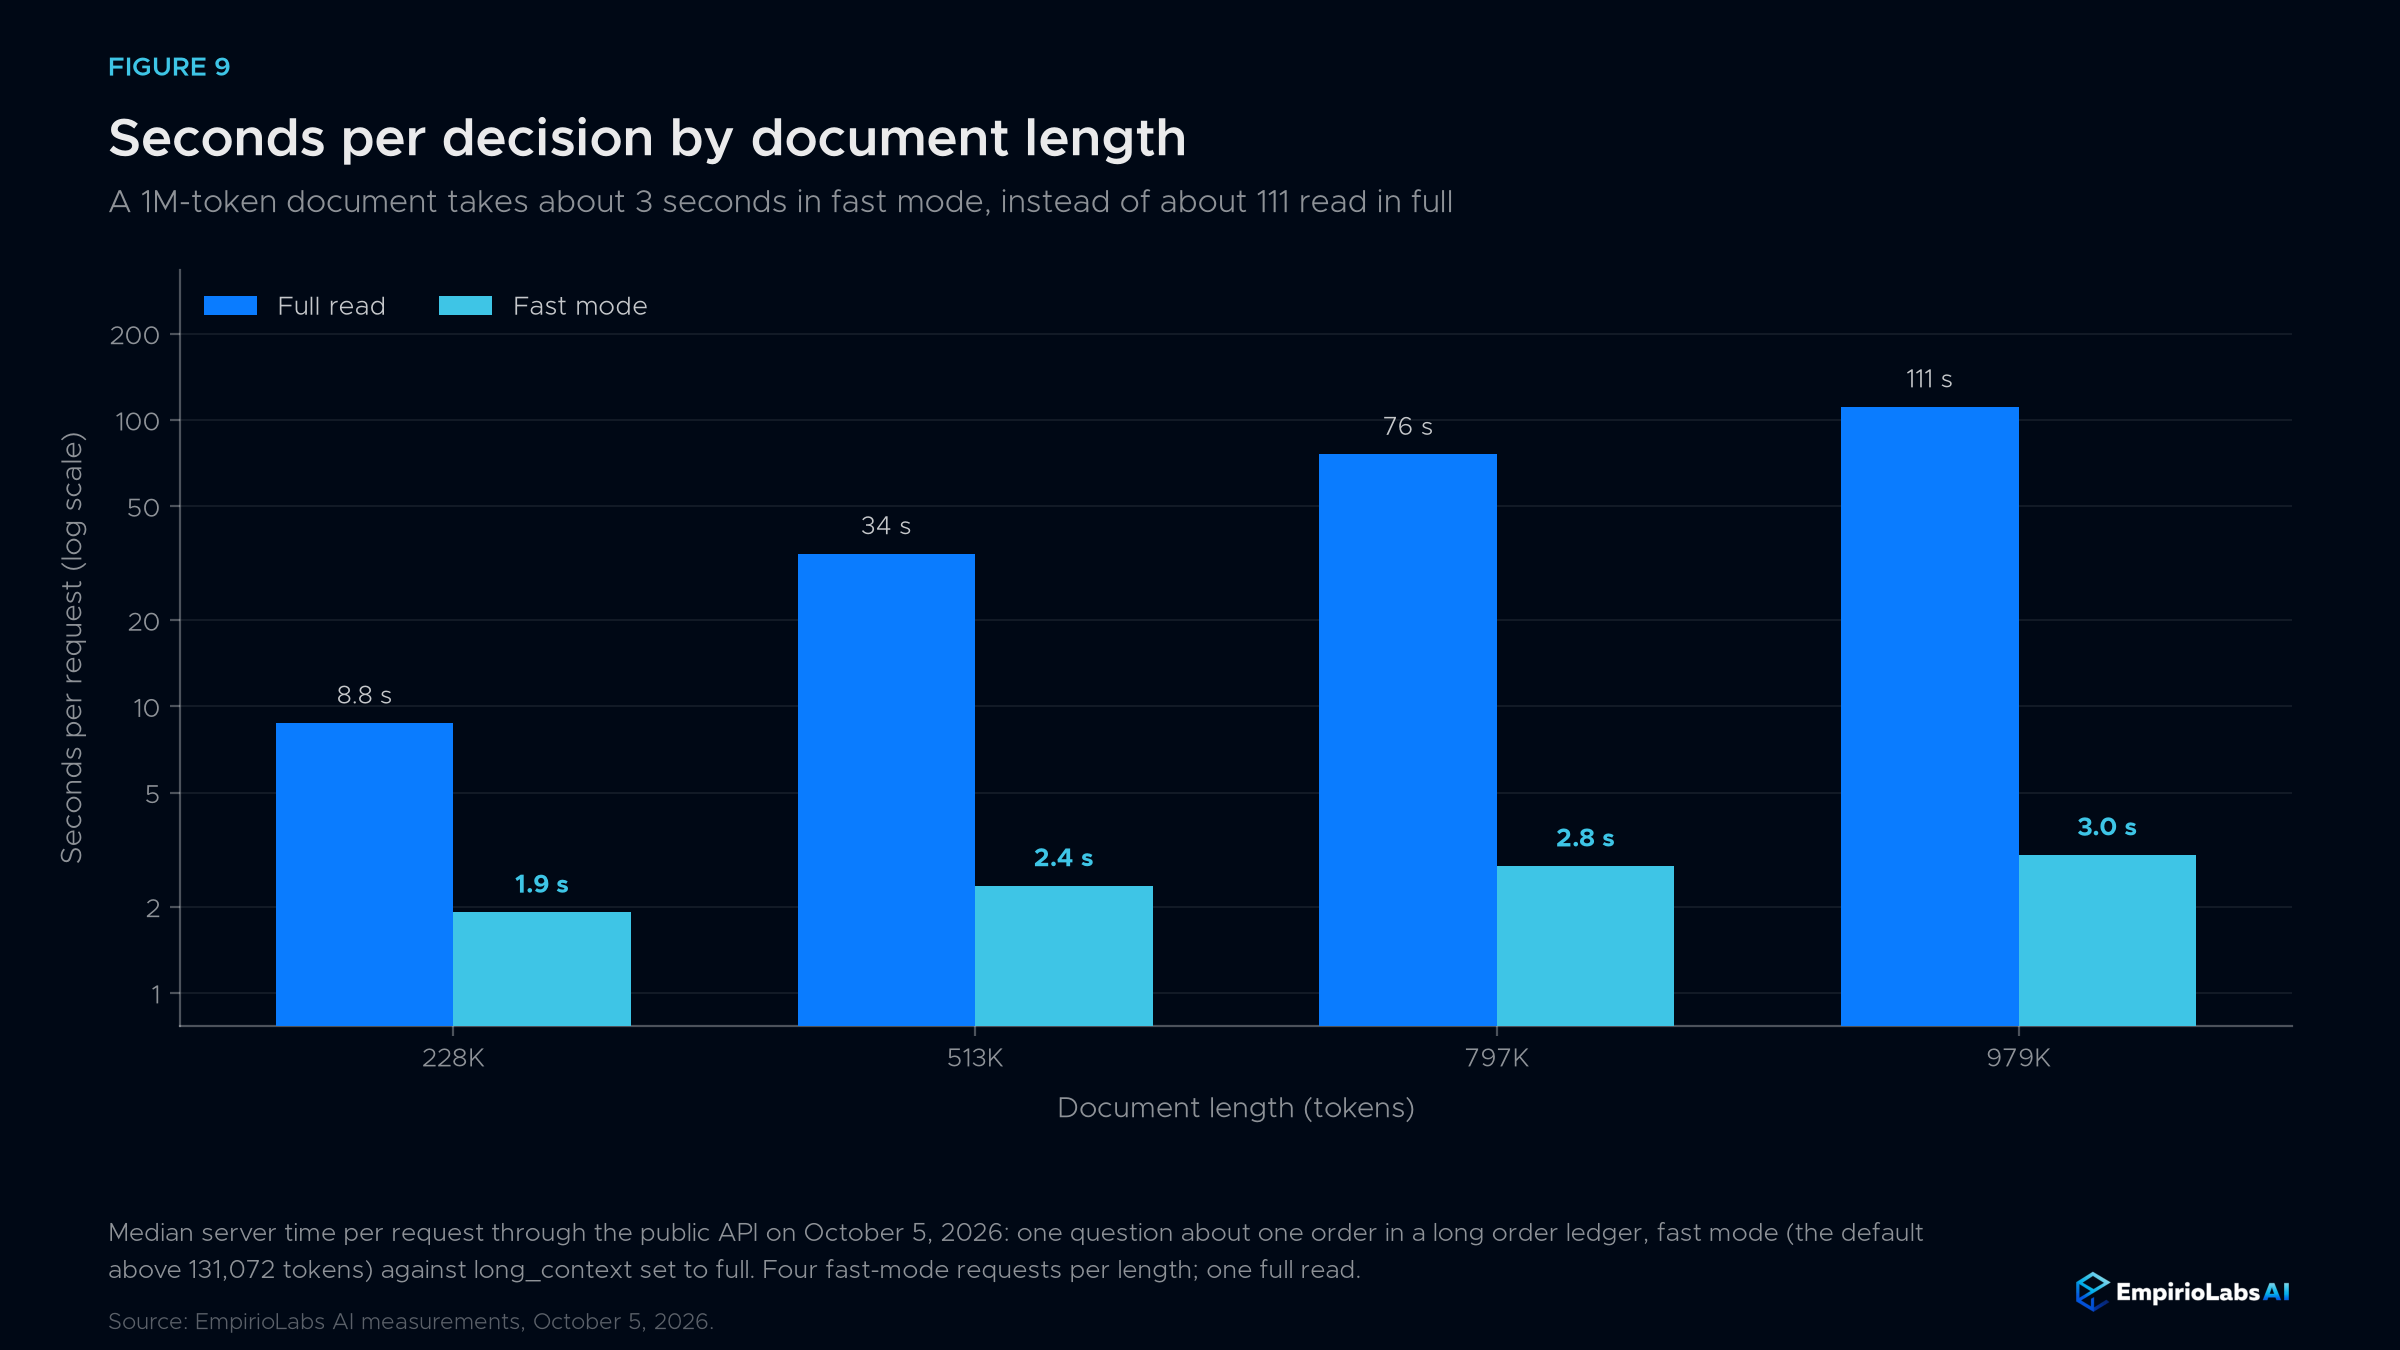
| Longitud del documento (tokens) | 228K | 513K | 797K | 979K |
|---|---|---|---|---|
| Modo rápido | 1,9 s | 2.4 s | 2,8 s | 3.0 s |
| Lectura completa | 8,8 s | 34 s | 76 s | 111 s |
Enviar "long_context": "lleno" leer cada token. Una lectura completa es la mejor opción cuando una respuesta depende de todo el documento, como un recuento, el tono general o confirmar que algo nunca aparece: en 24 documentos construidos para probar esas preguntas, el modo rápido acertó en el 50% de las decisiones y en una lectura completa en el 61%. Las respuestas long_context el campo indica qué modo se utilizó y el uso cuenta el estado completo en ambos modos. El modo rápido de contexto largo solo está disponible en la API EmpirioLabs y en la Playground; los pesos abiertos leen cada token.
Calibración
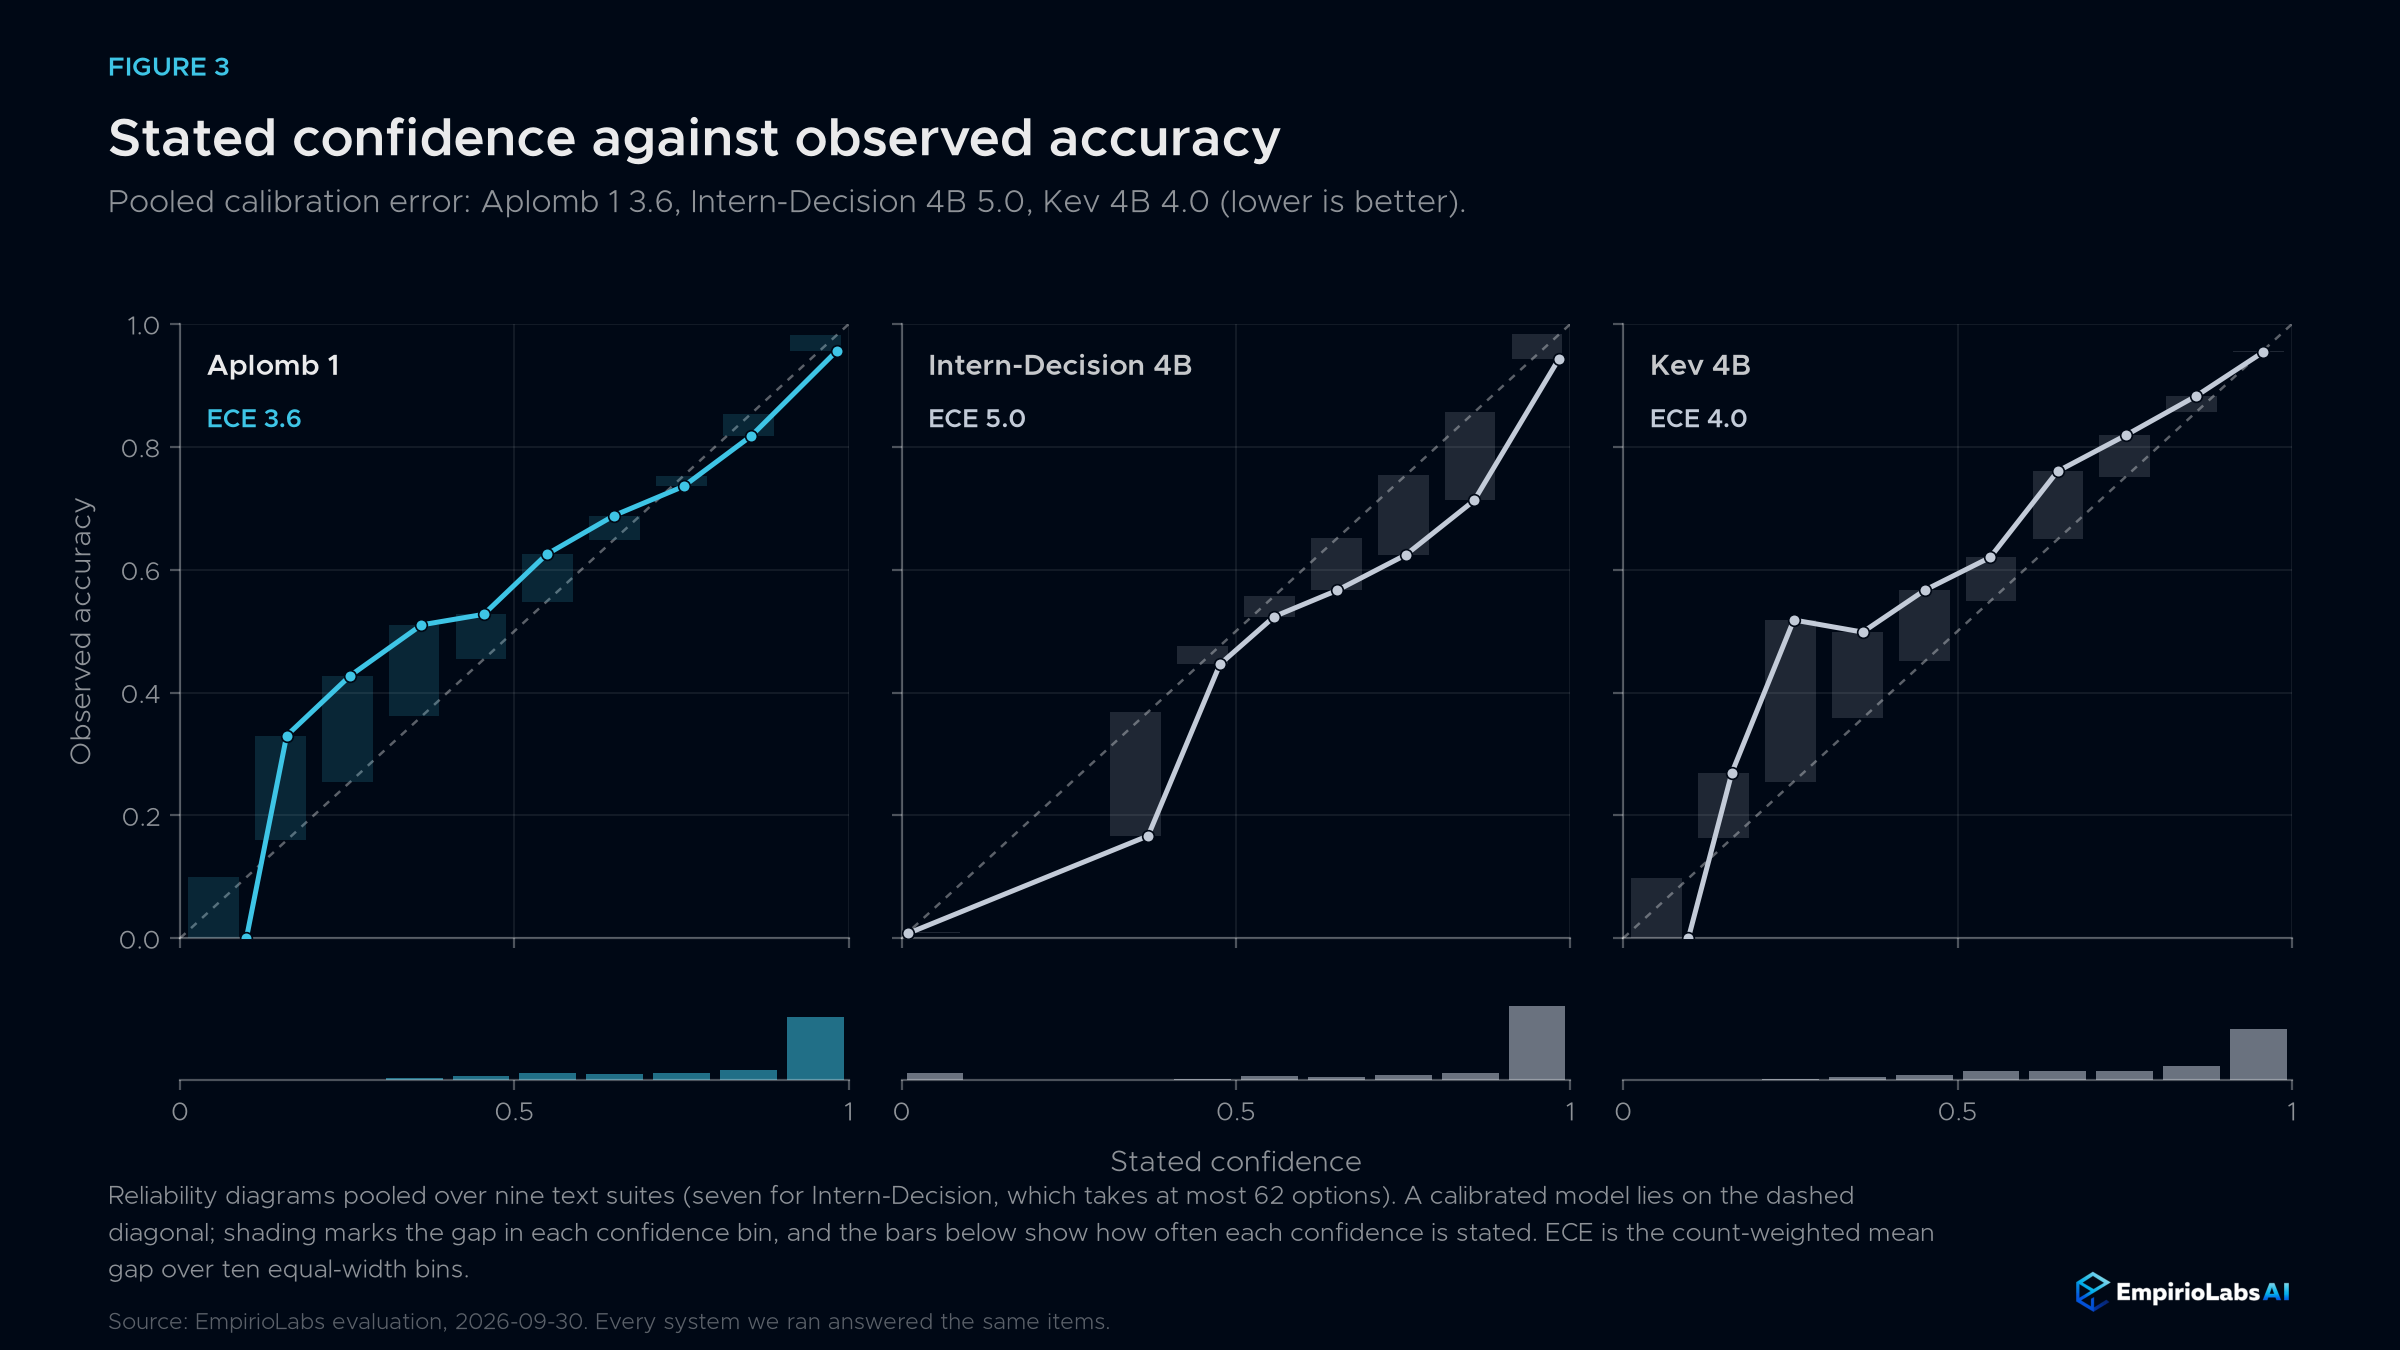
Una probabilidad solo es útil si significa lo que dice. En nueve suites de texto, la confianza declarada de Aplomb 1 rastrea cuántas veces acierta: su error de calibración agrupado es 3,6, frente a 5,0 para Intern-Decision 4B y 4,0 para Kev 4B (más bajo, mejor).
Imágenes, vídeo y audio
| Benchmark (primeros 500 artículos) | Aplomb 1 | Decisión de Becarios 4B | OmniJev 4B |
|---|---|---|---|
| PAPA | 89.0 | 89.2 | 88.4 |
| MMStar | 68.6 | 65.2 | 64.4 |
| AI2D | 87.0 | 81.0 | 83.4 |
| MMMU | 57.2 | 57.0 | 56.0 |
| HallusionBench | 79.8 | 79.4 | 71.2 |
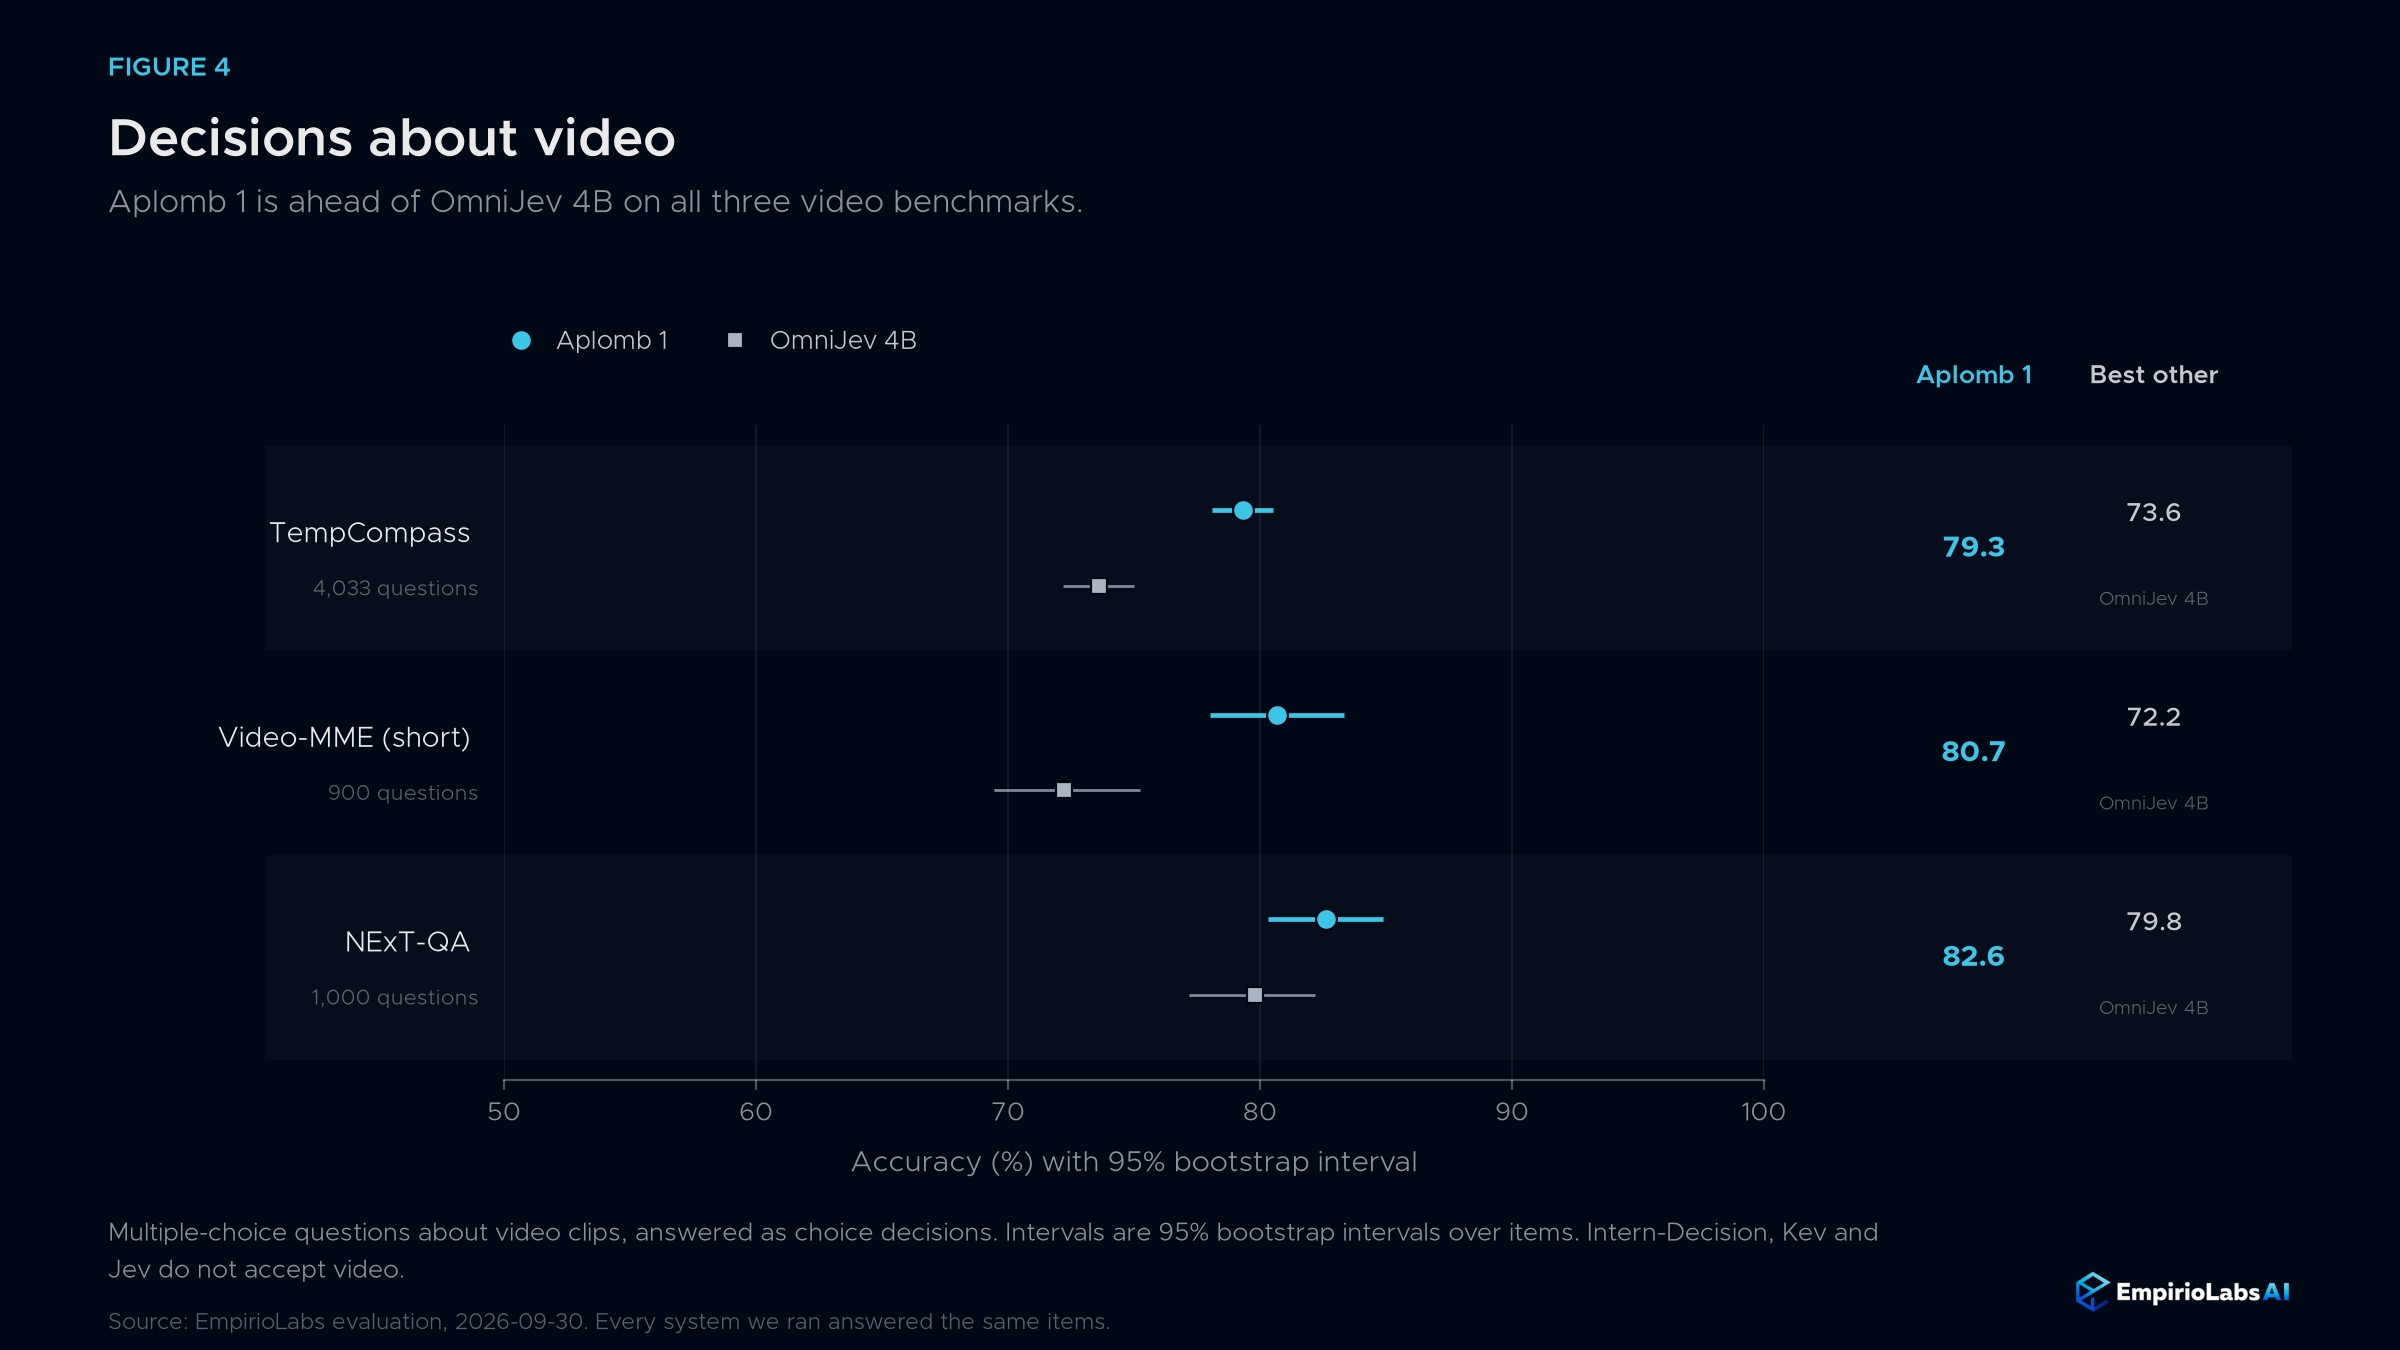
| Índice de referencia | Aplomb 1 | OmniJev 4B |
|---|---|---|
| TempCompass | 79.3 | 73.6 |
| Video-MME (corto) | 80.7 | 72.2 |
| NExT-QA | 82.6 | 79.8 |
Nosotros mismos añadimos audio a Aplomb 1; ninguno de los otros modelos de decisión anteriores lo acepta. Es más fuerte en sonidos de voz y voz; los sonidos ambientales y las preguntas abiertas sobre audio son más difíciles para él:
| Índice de referencia | Aplomb 1 |
|---|---|
| VocalSound (sonidos vocales) | 90.0 |
| CREMA-D (emoción en el habla) | 65.0 |
| ESC-50 (sonidos ambientales) | 8.4 |
| MMAU (preguntas de audio) | 49.1 |
| MMSU (lengua hablada) | 43.3 |
51 idiomas
Aplomb 1 decide sobre el texto en muchos idiomas, no solo en inglés. En MASSIVE, cada petición a un asistente de voz está escrita en uno de los 51 idiomas mientras que la pregunta y las 59 etiquetas de intención permanecen en inglés. Sin formación en MASSIVE, Aplomb 1 promedia un 75,0% en los 51 idiomas al elegir entre las 59 intenciones, un 91,0% en inglés y un 70% o más en 39 de ellos.
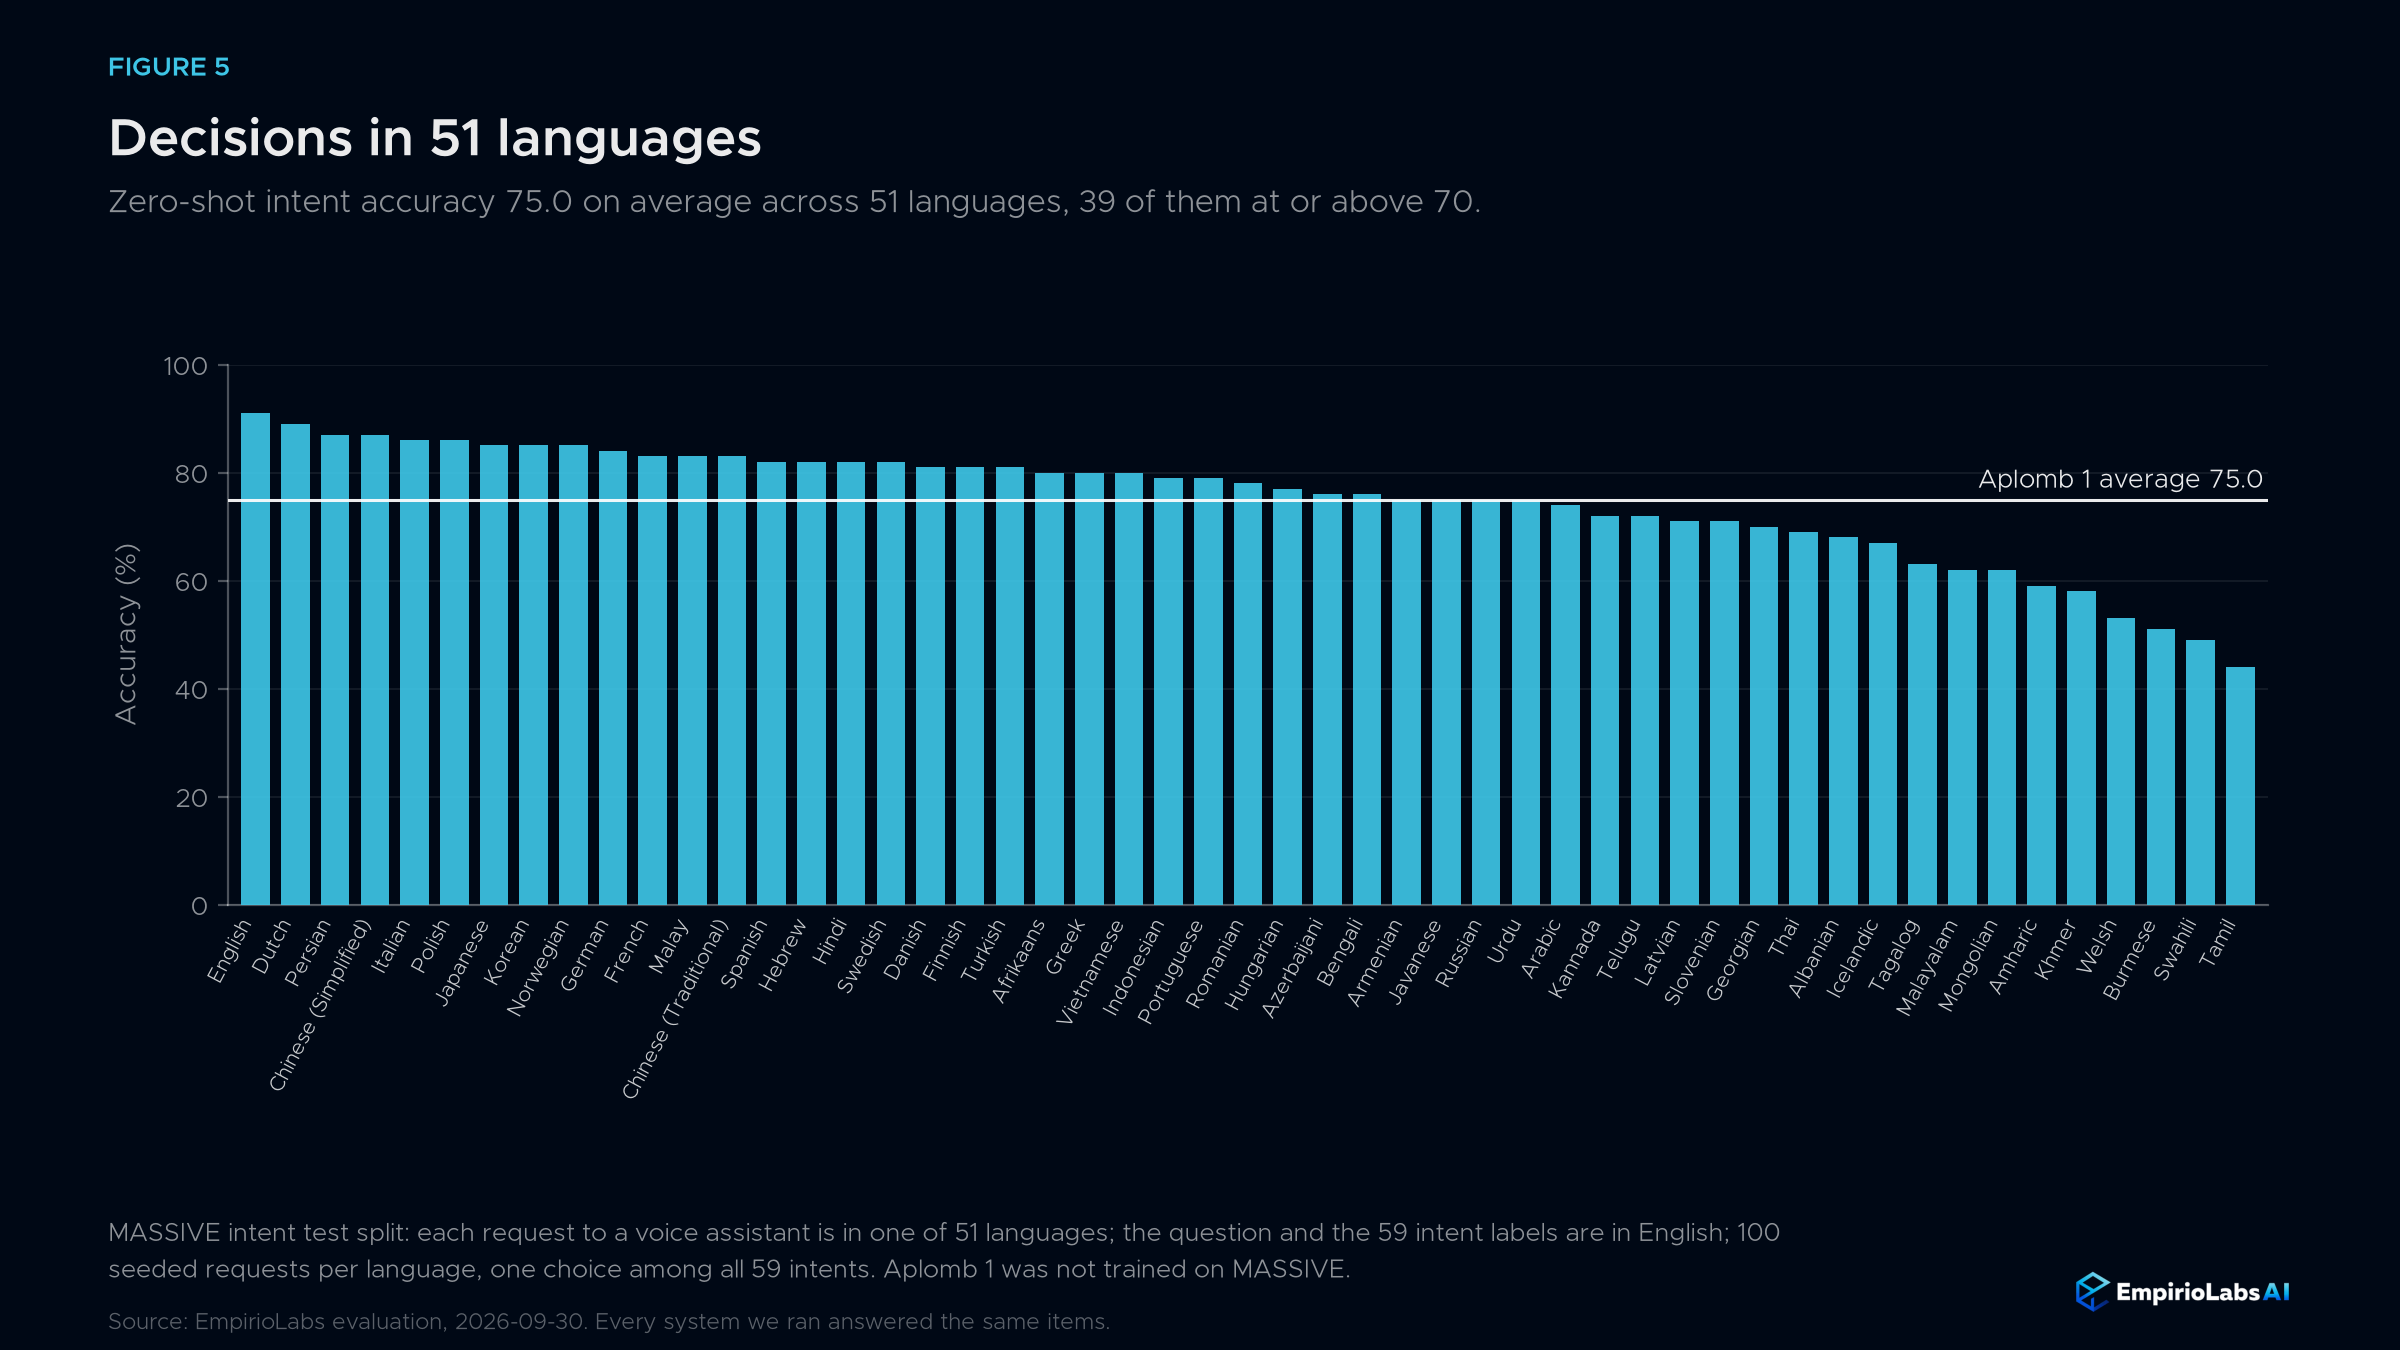
Para referencia, el proyecto Laya informa del 40,1% para su modelo multilingüe en los mismos 51 idiomas al elegir entre 20 intenciones, y el proyecto JevK5 reporta un 73,8% en inglés con las 60 intenciones.
Índice de Decisión
El Índice de Decisión 0.2.1 promedia 38 referencias públicas en cinco áreas: conocimiento y razonamiento, comprensión, recuperación y clasificación del lenguaje, herramientas y automatización, y artes y gusto humano. Cada punto de referencia se corrige por azar, por lo que 0 significa adivinar al azar y 100 significa perfecto.
Ejecutamos el kit oficial en Aplomb 1 el 5 de octubre de 2026 y respondió a las 150.317 solicitudes puntuables. Aplomb 1 obtiene una puntuación de 44,86. Esta es nuestra propia edición del kit, no una entrada en el tablero publicado.
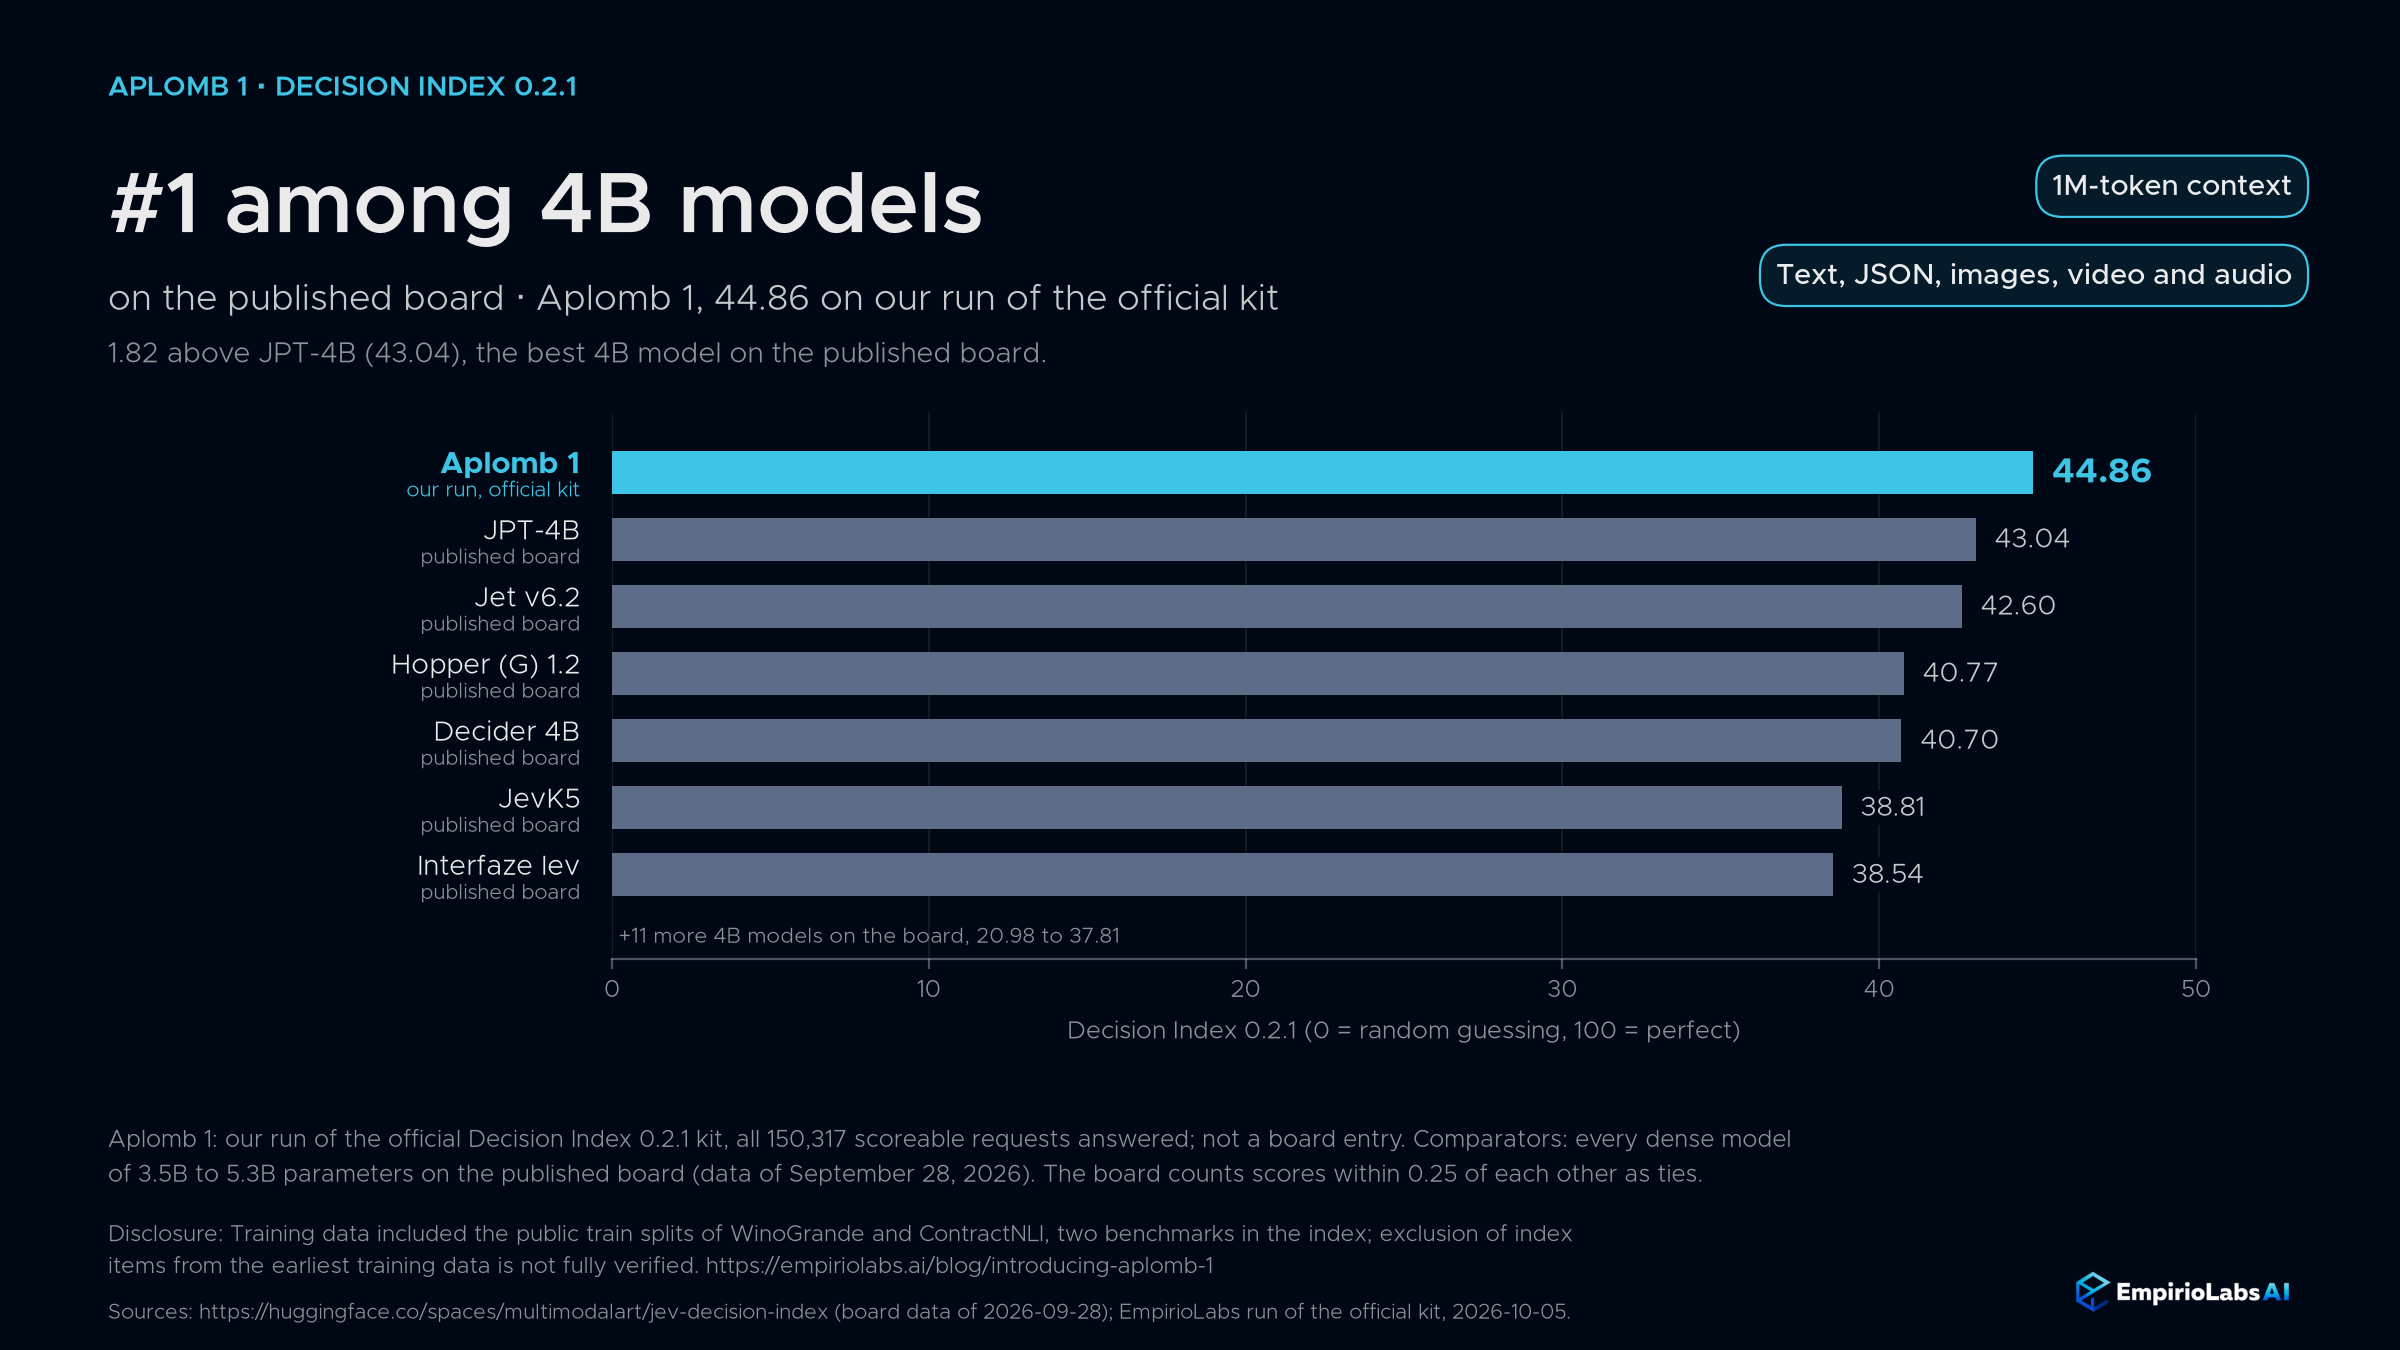
A fecha de 6 de octubre de 2026, Aplomb 1 es el #1 entre los modelos 4B en la tabla publicada, y #1 entre los modelos hasta 5,3B parámetros en 8 de los 38 benchmarks, incluyendo MMLU-Pro, GPQA Diamond y BBH. En la tabla publicada (datos del 28 de septiembre de 2026), la puntuación más alta para un modelo 4B es la JPT-4B con 43,04, 1,82 por debajo de Aplomb 1.
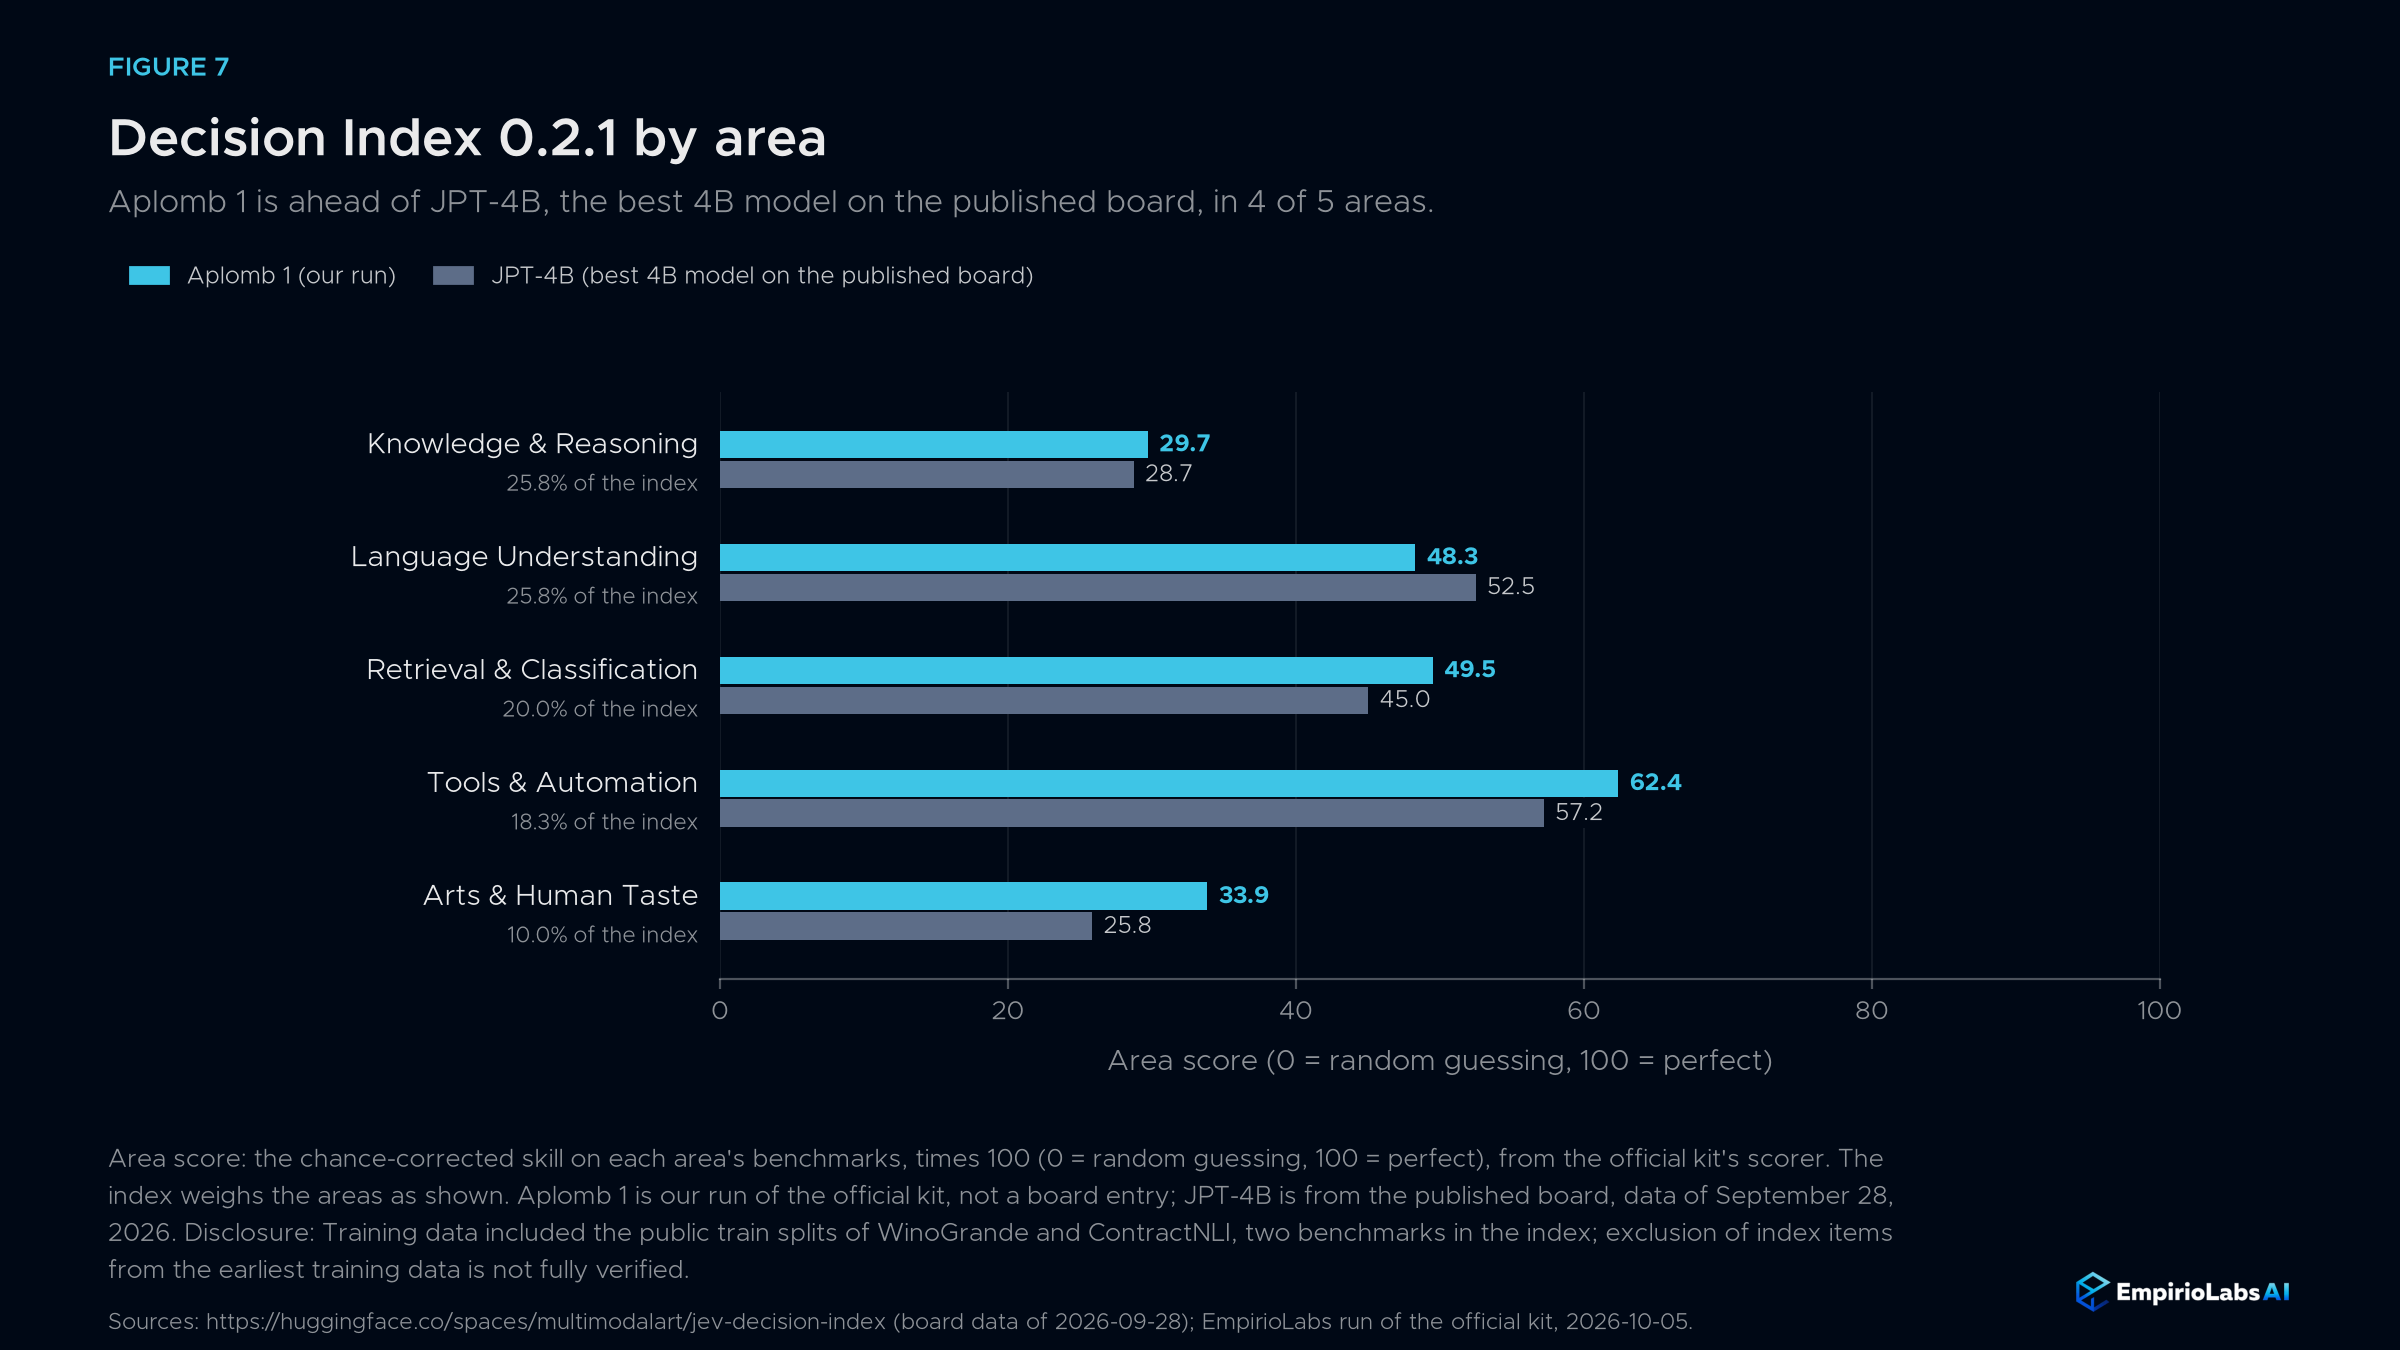
Por área, Aplomb 1 obtiene la puntuación más alta en herramientas y automatización (62,4) y recuperación y clasificación (49,5). En comparación con JPT-4B, está por delante en cuatro de las cinco áreas y por detrás en comprensión del lenguaje (48,3 frente a 52,5).
Divulgación. Los datos de entrenamiento de Aplomb 1 incluían las divisiones públicas de WinoGrande y ContractNLI, dos de los 38 puntos de referencia del índice. No pudimos verificar completamente que los ítems del índice fueran excluidos de los primeros datos de entrenamiento.
Cómo se compara
Lo que cada modelo de decisión o API acepta y responde, a partir de su propia documentación publicada a fecha de 29 de septiembre de 2026, con precios a fecha de 6 de octubre de 2026:
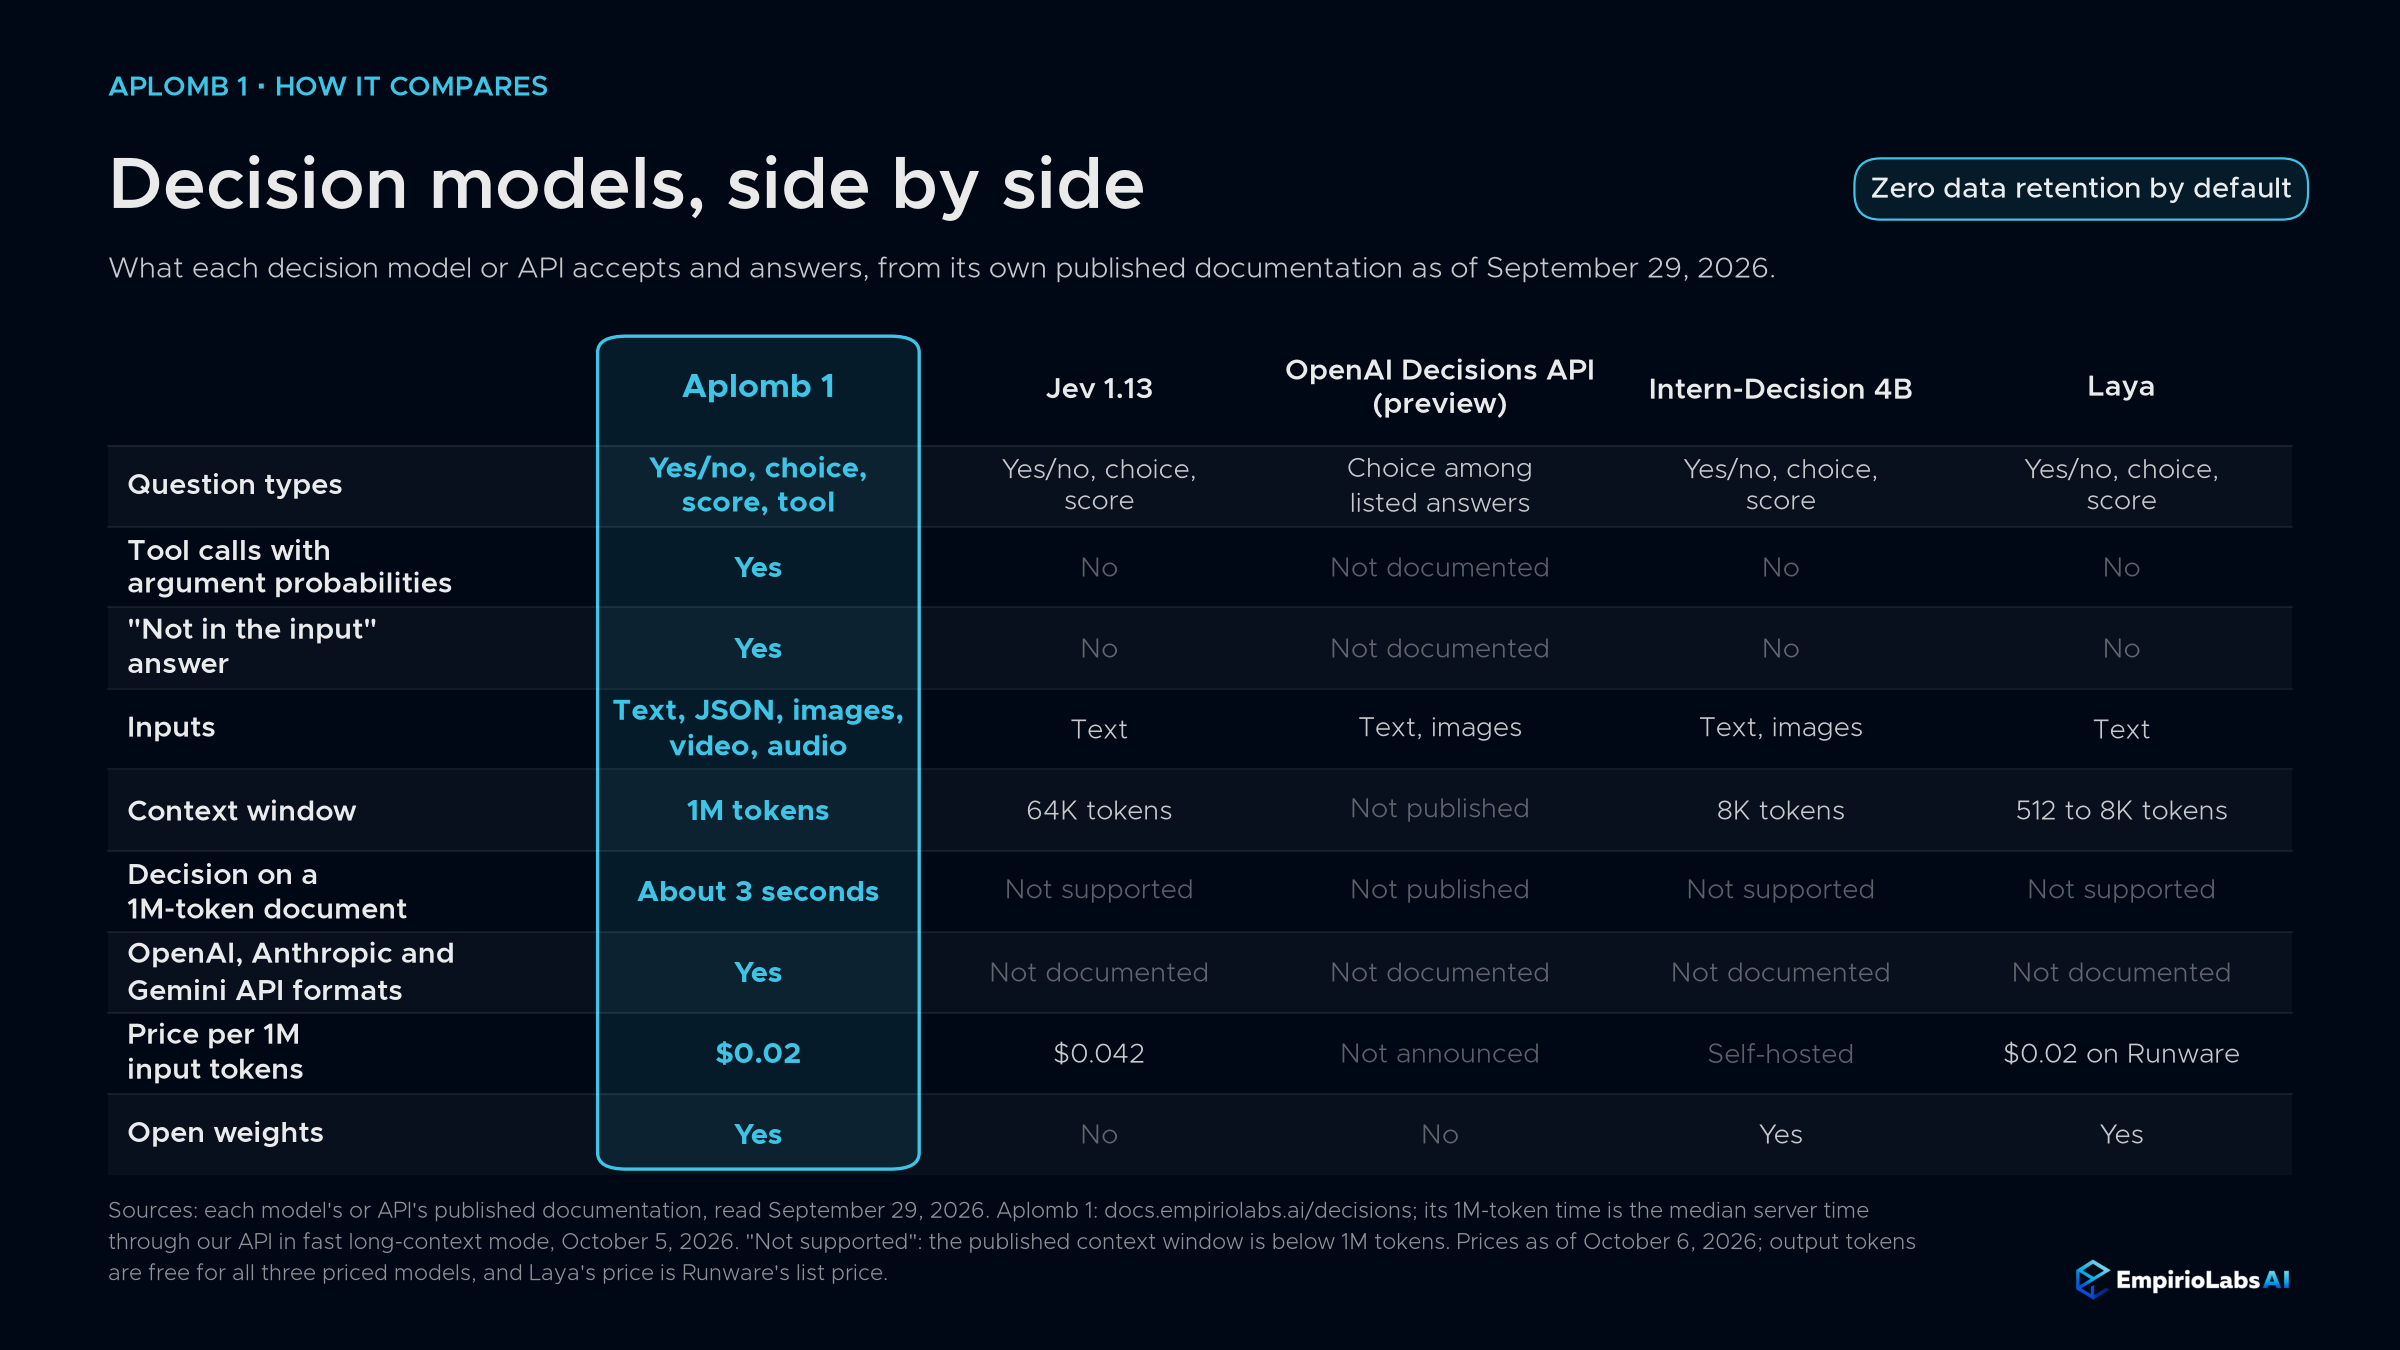
| Aplomb 1 | Jev 1.13 | API de OpenAI Decisions (vista previa) | Decisión de Becarios 4B | Laya | |
|---|---|---|---|---|---|
| Tipos de preguntas | Sí o no, elección, puntuación, herramienta | Sí o no, elección, puntuación | Elección entre las respuestas listadas | Sí o no, elección, puntuación | Sí o no, elección, puntuación |
| Selección de herramientas con probabilidades argumentales | Sí | No | No documentado | No | No |
| No en la respuesta estatal | Sí | No | No documentado | No | No |
| Entradas | Texto, JSON, imágenes, vídeo, audio | Texto | Texto, imágenes | Texto, imágenes | Texto |
| Ventana | 1.000.000 de fichas | 64K fichas | No publicado | 8.192 fichas | 512 a 8.192 fichas |
| Precio por cada 1M de fichas de entrada | $0.02 | $0.042 | No anunciado | Autoalojado | $0.02 en Runware |
| Peso abierto | Sí | No | No | Sí | Sí |
Velocidad y facturación
Aplomb 1 se ejecuta con el propio tiempo de ejecución de inferencia de EmpirioLabs para modelos de decisión. Una pregunta corta toma unos 15 ms de tiempo de modelo, una pregunta con una imagen de unos 35 ms, un documento de 15.000 tokens unos 0,3 segundos, y un estado de 1M de tokens unos 3 segundos en modo rápido de contexto largo, con el valor por defecto por encima de 131.072 tokens, o unos 111 segundos leídos completos.
Pagas solo por los tokens de entrada: el estado una vez por solicitud y el texto propio de cada pregunta, nunca una plantilla de prompt. Los tokens de salida siempre son cero. La tasa actual está en el página modelo y el página de precios.
Por defecto, la retención de datos no está activada: no retenemos el contenido de tus solicitudes o respuestas.
Peso abierto
Aplomb 1 está construido sobre Qwen3.5-4B. Ampliamos su ventana de 262K a 1M de tokens, añadimos entrada de audio con el codificador de audio de Qwen3-Omni, añadimos nuestra propia cabeza de decisión, que devuelve cada respuesta como probabilidades calibradas en lugar de texto generado, y entrenamos el modelo para decisiones, incluyendo la selección de herramientas y la respuesta not-in-the-input. Para la API y la Playground, construimos y optimizamos nuestro propio tiempo de ejecución de inferencia.
Los pesos y un guion de referencia para ejecutarlos tú mismo están en huggingface.co/empiriolabsai/aplomb-1. Las respuestas del script pueden diferir ligeramente de las de la API.
La investigación, evaluación, uso personal y uso interno por organizaciones con ingresos anuales inferiores a US$1 millones son gratuitas bajo la Licencia Modelo EmpirioLabs; alojar Aplomb 1 como servicio o enviarlo en un producto vendido a otros requiere una licencia comercial.
Empieza
curl https://api.empiriolabs.ai/v1/decisions \ -H "Autorización: Portador $EMPIRIOLABS_API_KEY" \ -H "Tipo-Contenido: application/json" \ -d '{ "modelo": "aplomb-1", "estado": {"pedido": {"id": "B-44120", "estado": "enviado", "pago": "no pagado"}}, "preguntas": { "pagado": {"tipo": "noul", "instrucciones": "¿Se ha pagado la orden B-44120?", "abstención": verdadero}, "transportista": {"tipo": "elección", "instrucciones": "¿Qué transportista entrega la orden B-44120?", "criterios": {"UPS": nulo, "FedEx": nulo, "DHL": nulo}, "abstención": verdadero} } }'pagado Me responde como un no rotundo. Portador vuelve con un subidón abstenerse probabilidad, porque el registro no nombra una portadora. El esquema completo, la entrada de medios y los límites están en el Guía de la API de decisiones. Aplomb 1 también acepta solicitudes en los formatos OpenAI, Anthropic y Gemini, así que puedes llamarlo desde sus SDK; los de la guía Formatos de chat La sección muestra cómo una solicitud de chat se relaciona con una decisión. Pruébalo sin código en el Playground.
Agradecimientos
Construimos Aplomb 1 con la ayuda de nuestro aprovechamiento de agentes de IA en datos, entrenamiento, evaluación y despliegue. Gracias al equipo de Qwen por Qwen3.5 y Qwen3-Omni, sobre los que se basa Aplomb 1, a Lambda por las GPUs que entrenamos y en las que lo servimos, y al programa NVIDIA Inception, al programa de startups Z.ai y al programa de startups StepFun por su apoyo.