LightOnOCR-3 4B ist auf EmpirioLabs verfügbar. Es ist das Dokument-OCR-Modell von LightOn: Senden Sie ein PDF oder ein Bild, und jede Seite wird als Markdown zurückgegeben, mit dem Text in Lesereihenfolge, Überschriften, Listen, Tabellen, Mathematik in LaTeX und Diagrammen als Tabellen ihrer Datenpunkte. Jede Seite wird auch mit ihrem Layout zurückgegeben: dem Typ und der Position jedes Blocks auf der Seite. Es läuft auf POST /v1/ocr, in der API und im Playground.
Benchmark. LightOn meldet einen Gesamtwert von olmOCR-Bench von 86,3 für LightOnOCR-3 4B in seiner Veröffentlichungsankündigung vom 8. Oktober 2026.
Was dort steht
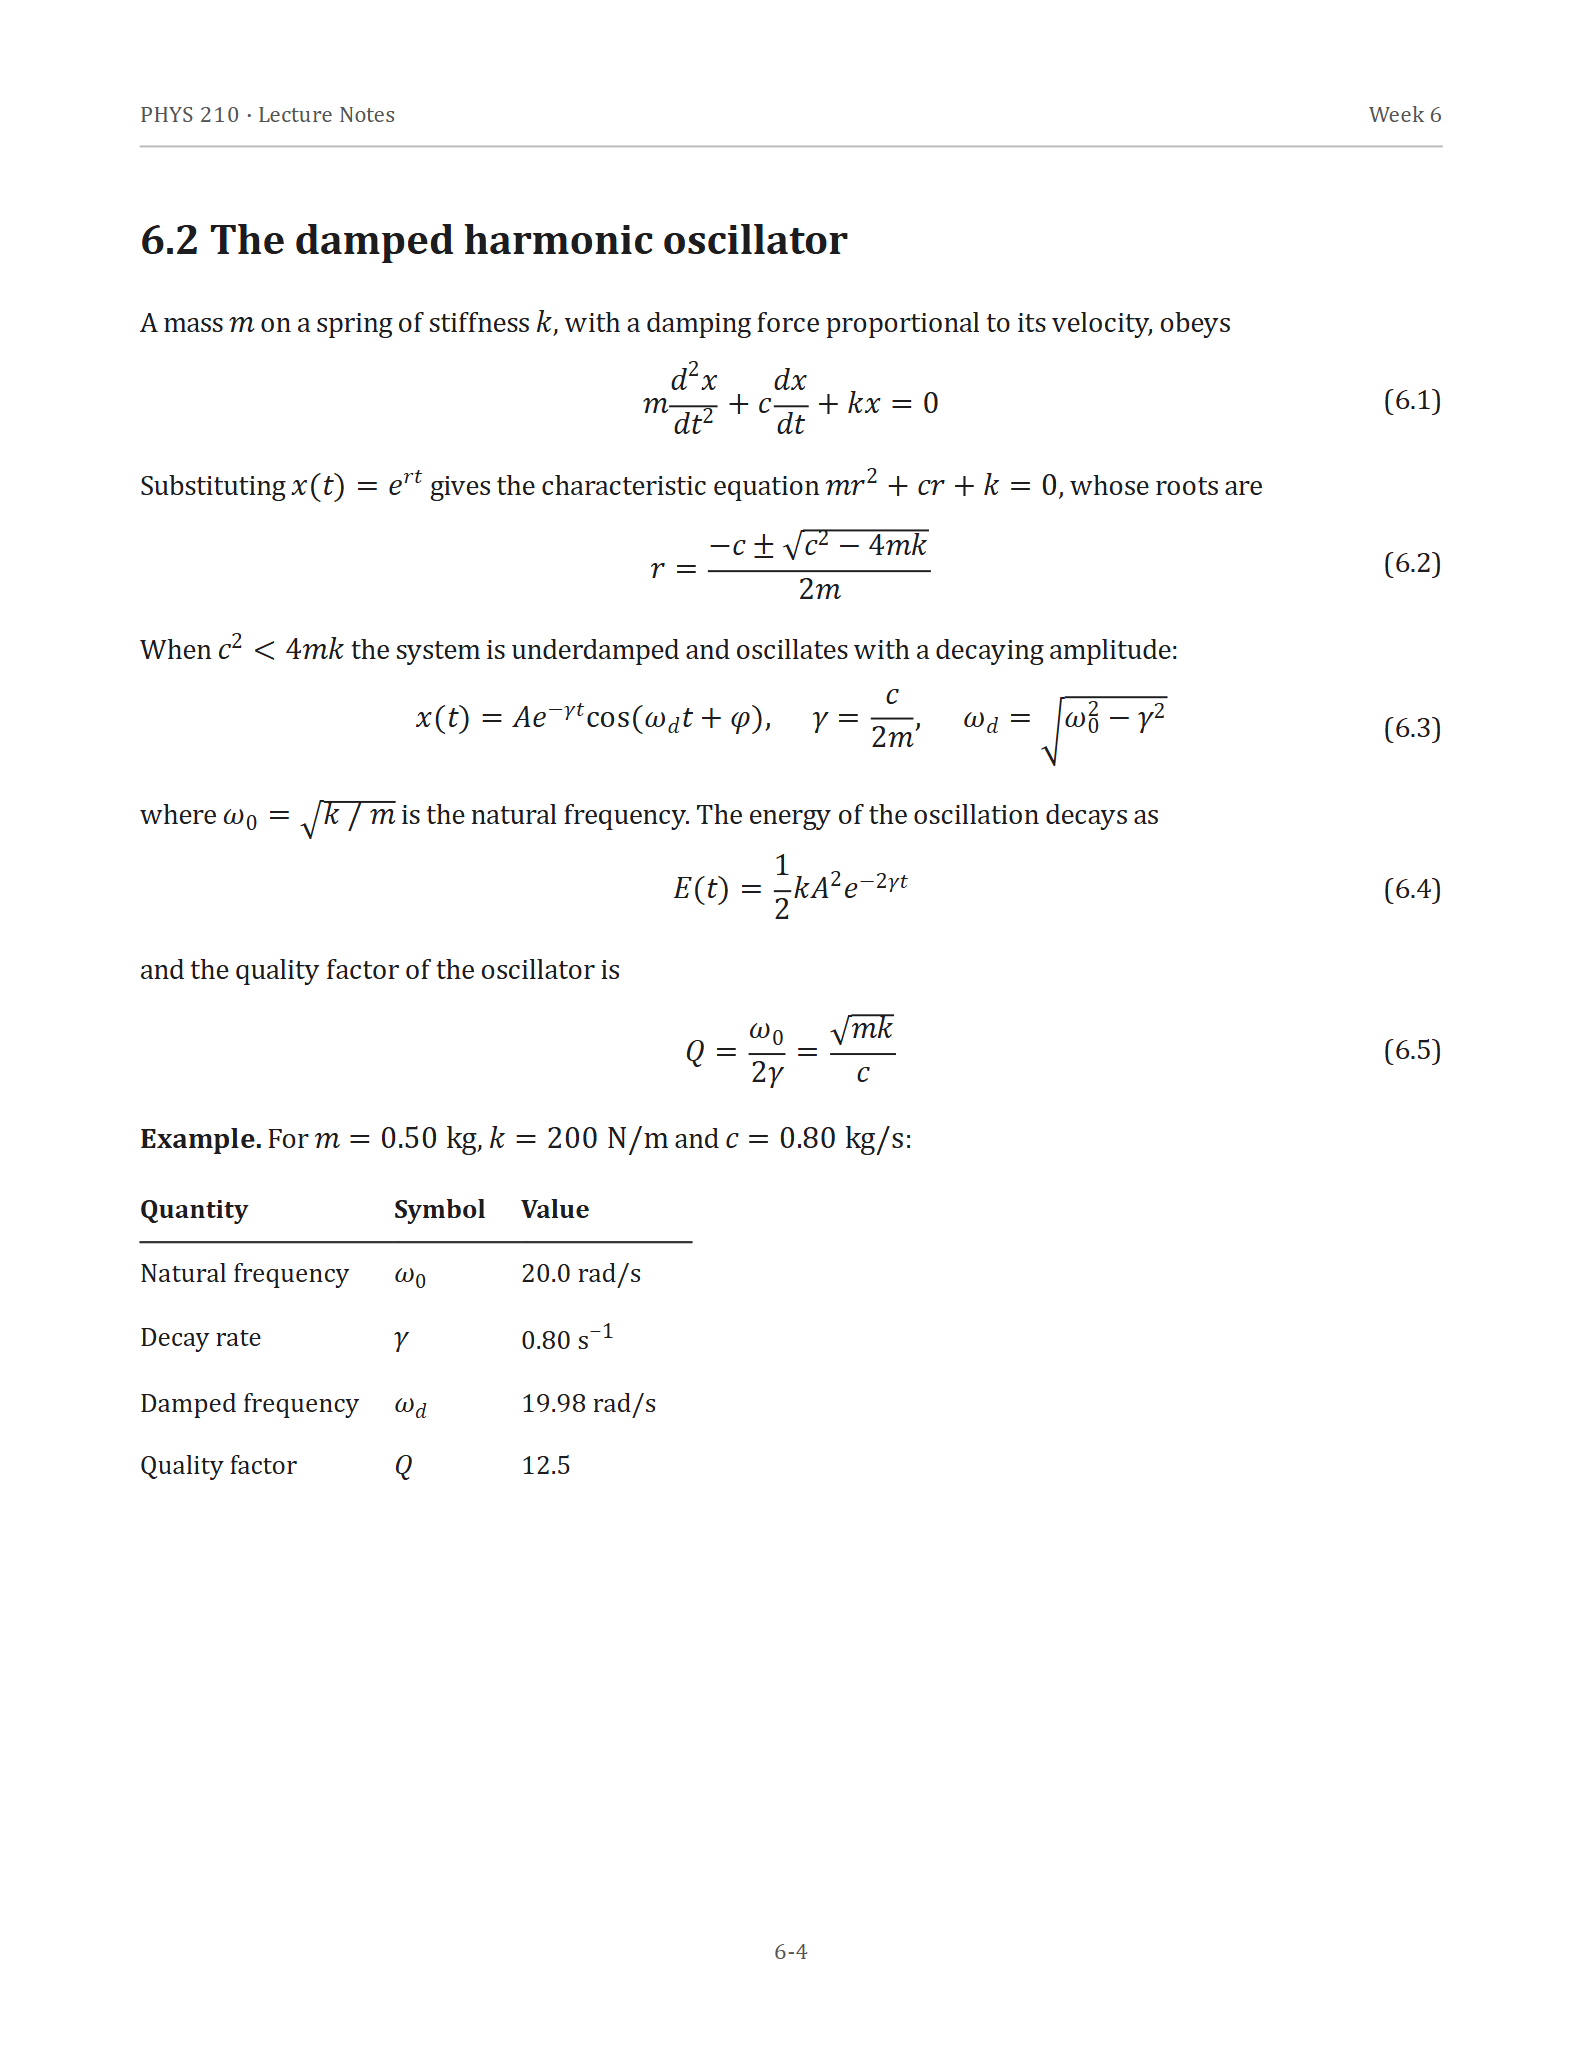
Eine Testseite mit Vorlesungsnotizen, in einer Anfrage gelesen. Diese Seite und zwei weitere Modelle mit drei Seh-Chat-Modellen sind in LightOnOCR-3 4B vs Qwen3.5 4B vs Gemma 4 26B-A4B vs Mistral Small 3.1.
Der Anfang des Markdowns wurde für diese Seite zurückgegeben; die anderen drei Gleichungen, die Tabelle und die Seitenzahl folgen in derselben Antwort:
PHYS 210 · Vorlesungsnotizen Woche 6 ## 6.2 Der gedämpfte harmonische Oszillator Eine Masse $m$ auf einer Feder mit Steifigkeit $k$, mit einer Dämpfungskraft, die proportional zu ihrer Geschwindigkeit ist, gehorcht $$ m \frac{d^2 x}{dt^2} + c \frac{dx}{dt} + kx = 0 \quad \text{(6.1)} $$ Setzt man $x(t) = e^{rt}$ ein, ergibt sich die charakteristische Gleichung $mr^2 + cr + k = 0$, deren Wurzeln $$ r = \frac{-c \pm \sqrt{c^2 - 4mk}}{2m} \quad \text{(6.2)} $$Deine erste Bitte
Senden Sie ein Dokument per URL oder als base64-Daten-URI. Diese Anfrage liest die ersten beiden Seiten eines Beispiel-PDFs:
curl https://api.empiriolabs.ai/v1/ocr \ -H "Autorisierung: Träger $EMPIRIOLABS_API_KEY" \ -H "Inhaltstyp: application/json" \ -d '{ "model": "lightonocr-3-4b", "document": { "type": "document_url", "document_url": "https://media.empiriolabs.ai/assets/blog-images/lightonocr-3-4b-test-2026-10-25/sample-document.pdf" }, "pages": [0, 1] }'Eine Datei auf deinem Rechner wird als Daten-URI eingetragen, ohne dass Hosting nötig ist:
Importanfragen von Import-OS-Importanfragen mit Open("report.pdf", "rb") als Handle: encoded = base64.b64encode(handle.read()).decode() response = requests.post("https://api.empiriolabs.ai/v1/ocr", headers={"Authorization": f"Bearer {os.environ['EMPIRIOLABS_API_KEY']}"}, json={ "model": "lightonocr-3-4b", "document": {"type": "document_url", "document_url": f"data:application/pdf; base64,{encoded}"}, }, timeout=300,) response.raise_for_status() für Seite in response.json()["pages"]: print(f"--- page {page['index']} ---") print(page["markdown"])Ein Bild funktioniert auf die gleiche Weise, mit "typ": "image_url" und die URL oder Daten-URI in image_url. Ein Dokument kann ein PDF oder ein PNG-, JPEG-, WebP-, TIFF-, BMP-, GIF- oder AVIF-Bild mit bis zu 50 MB sein, und eine Anfrage liest bis zu 1.000 Seiten.
Was kommt zurück
Die Antwort hält pro Seite ein Objekt in Seiten. Jede hat die Seite als Markdown; Blöcke, jeder Bereich der Seite in Lesereihenfolge mit ihrem Typ (Titel, Text, Liste, Tabelle, Gleichung, Bildunterschrift, Überschrift, Footer, und andere) und seine Box in Pixeln; Bilder, die Bildregionen; und Abmessungen, die Größe des Seitenbildes, auf das sich die Boxen beziehen. usage_info.pages_processed zählt die gelesenen Seiten. Einer der 16 Blöcke kehrte für die Vorlesungsnotiz-Seite zurück:
{ "type": "equation", "top_left_x": 641, "top_left_y": 526, "bottom_right_x": 1447, "bottom_right_y": 610, "content": "$$\nr = \\frac{-c \\pm \\sqrt{c^2 - 4mk}}{2m} \\quad \\text{(6.2)}\n$$" }Eine Bitte antwortet, wenn die Seiten gelesen sind. Einer, der nach etwa viereinhalb Minuten noch läuft, antwortet 202 mit einem job id: Umfrage KOMM /v1/jobs/{job_id} Bis Status ist abgeschlossen, und die Seiten sind in Ergebnis. Um die Job-ID sofort zu bekommen, senden Sie den Header Bevorzugen: Response-asynchron.
Optionen
- Seiten.
Seitennimmt nullbasierte Seitenzahlen als Liste ([0, 2, 3]) oder eine Zeichenkette ("0,2-4"). Lass es liegen, um jede Seite zu lesen. - Tische.
table_formatSetzen Sie aufMarkdownoderhtmlVerschiebt jede Tabelle inTabellenin diesem Format und hinterlässt einen Link wie[tbl-0.html] (tbl-0.html)auf der Seite Markdown. Ohne sie bleiben Tabellen als HTML im Markdown. - Bilder.
include_image_base64gibt jede Bildregion als JPEG-Daten-URI zurück.image_limitCaps, wie viele Bilder für das gesamte Dokument zurückkommen, undimage_min_sizelässt Bereiche aus, die schmaler oder kürzer sind als so viele Pixel. - Kopf- und Fußläufer.
extract_headerundextract_footersie aus dem Markdown auf ihre eigenen Felder zu bringen. - Layout.
include_blocksSetzen Sie auffalschBlätterBlöckeraus.
Betriebshinweise
- Seitenzahlen beginnen bei 0.
"Seiten": [1]steht auf der zweiten Seite. - Dollarzeichen können entkommen zurückkommen. Im Seitentext kann ein Dollarzeichen lauten
\$, und innerhalb von HTML-Tabellen$. Entfliehen Sie den Rabatt, bevor Sie nach Betragen suchen. - Annotationsfelder werden abgelehnt.
bbox_annotation_format,document_annotation_format, unddocument_annotation_promptAntwort400bevor eine Seite gelesen wird.
Preisgestaltung
Berechnet pro gelesene Seite. Jede Anfrage wird mit mindestens 5 Seiten abgerechnet, daher senden Sie ein langes Dokument als ein PDF und nicht als eine Anfrage pro Seite. Eine Anfrage, die scheitert, wird nicht für Seiten abgerechnet, die nicht zurückgesendet wurden. Die aktuellen Tarife sind auf dem modellblatt und die preisseite.
Beginnen Sie mit dem Bau
Versuche LightOnOCR-3 4B in der Playground mit deinem eigenen Dokument, und lies das Dokument-OCR-Leitfaden und die API-Dokumentation für jeden Parameter.
Offenlegung: Dieser Artikel wurde mit KI-Unterstützung geschrieben und von EmpirioLabs AI überprüft.