Aplomb 1 ist unser erstes Modell. Es nimmt Text, JSON, Bilder, Audio und Video in einer einzigen Anfrage, liest bis zu 1 Millionen Tokens und trifft in etwa 3 Sekunden eine Entscheidung über ein 1M-Token-Dokument. Eine kurze Frage benötigt etwa 15 ms Modellzeit.
Es läuft auf einer Inferenzlaufzeit, die wir für Entscheidungsmodelle entwickelt haben. Auf unserer API und im Playground durchlaufen lange Dokumente den schnellen Langkontextmodus: Ein 1M-Token-Dokument benötigt etwa 3 Sekunden statt 111, und im Schnellmodus wurden alle 525 Entscheidungen in unseren Langkontexttests korrekt beantwortet.
Für Agenten liefert Aplomb 1 eine Wahrscheinlichkeit für jedes Werkzeug sowie für jedes Enum- und Boolean-Argument in einer Anfrage, sodass ein Agent handelt, wenn das Modell sicher ist, und eskaliert, wenn es es nicht ist. Jede Antwort ist kalibriert, und es kann anzeigen, wann die Eingabe die Antwort nicht enthält, anstatt zu raten. Es ist für die Entscheidungen entwickelt, die Software tausende Male täglich trifft, vom Routing eines Tickets bis zur Auswahl des nächsten Tools eines Agenten.
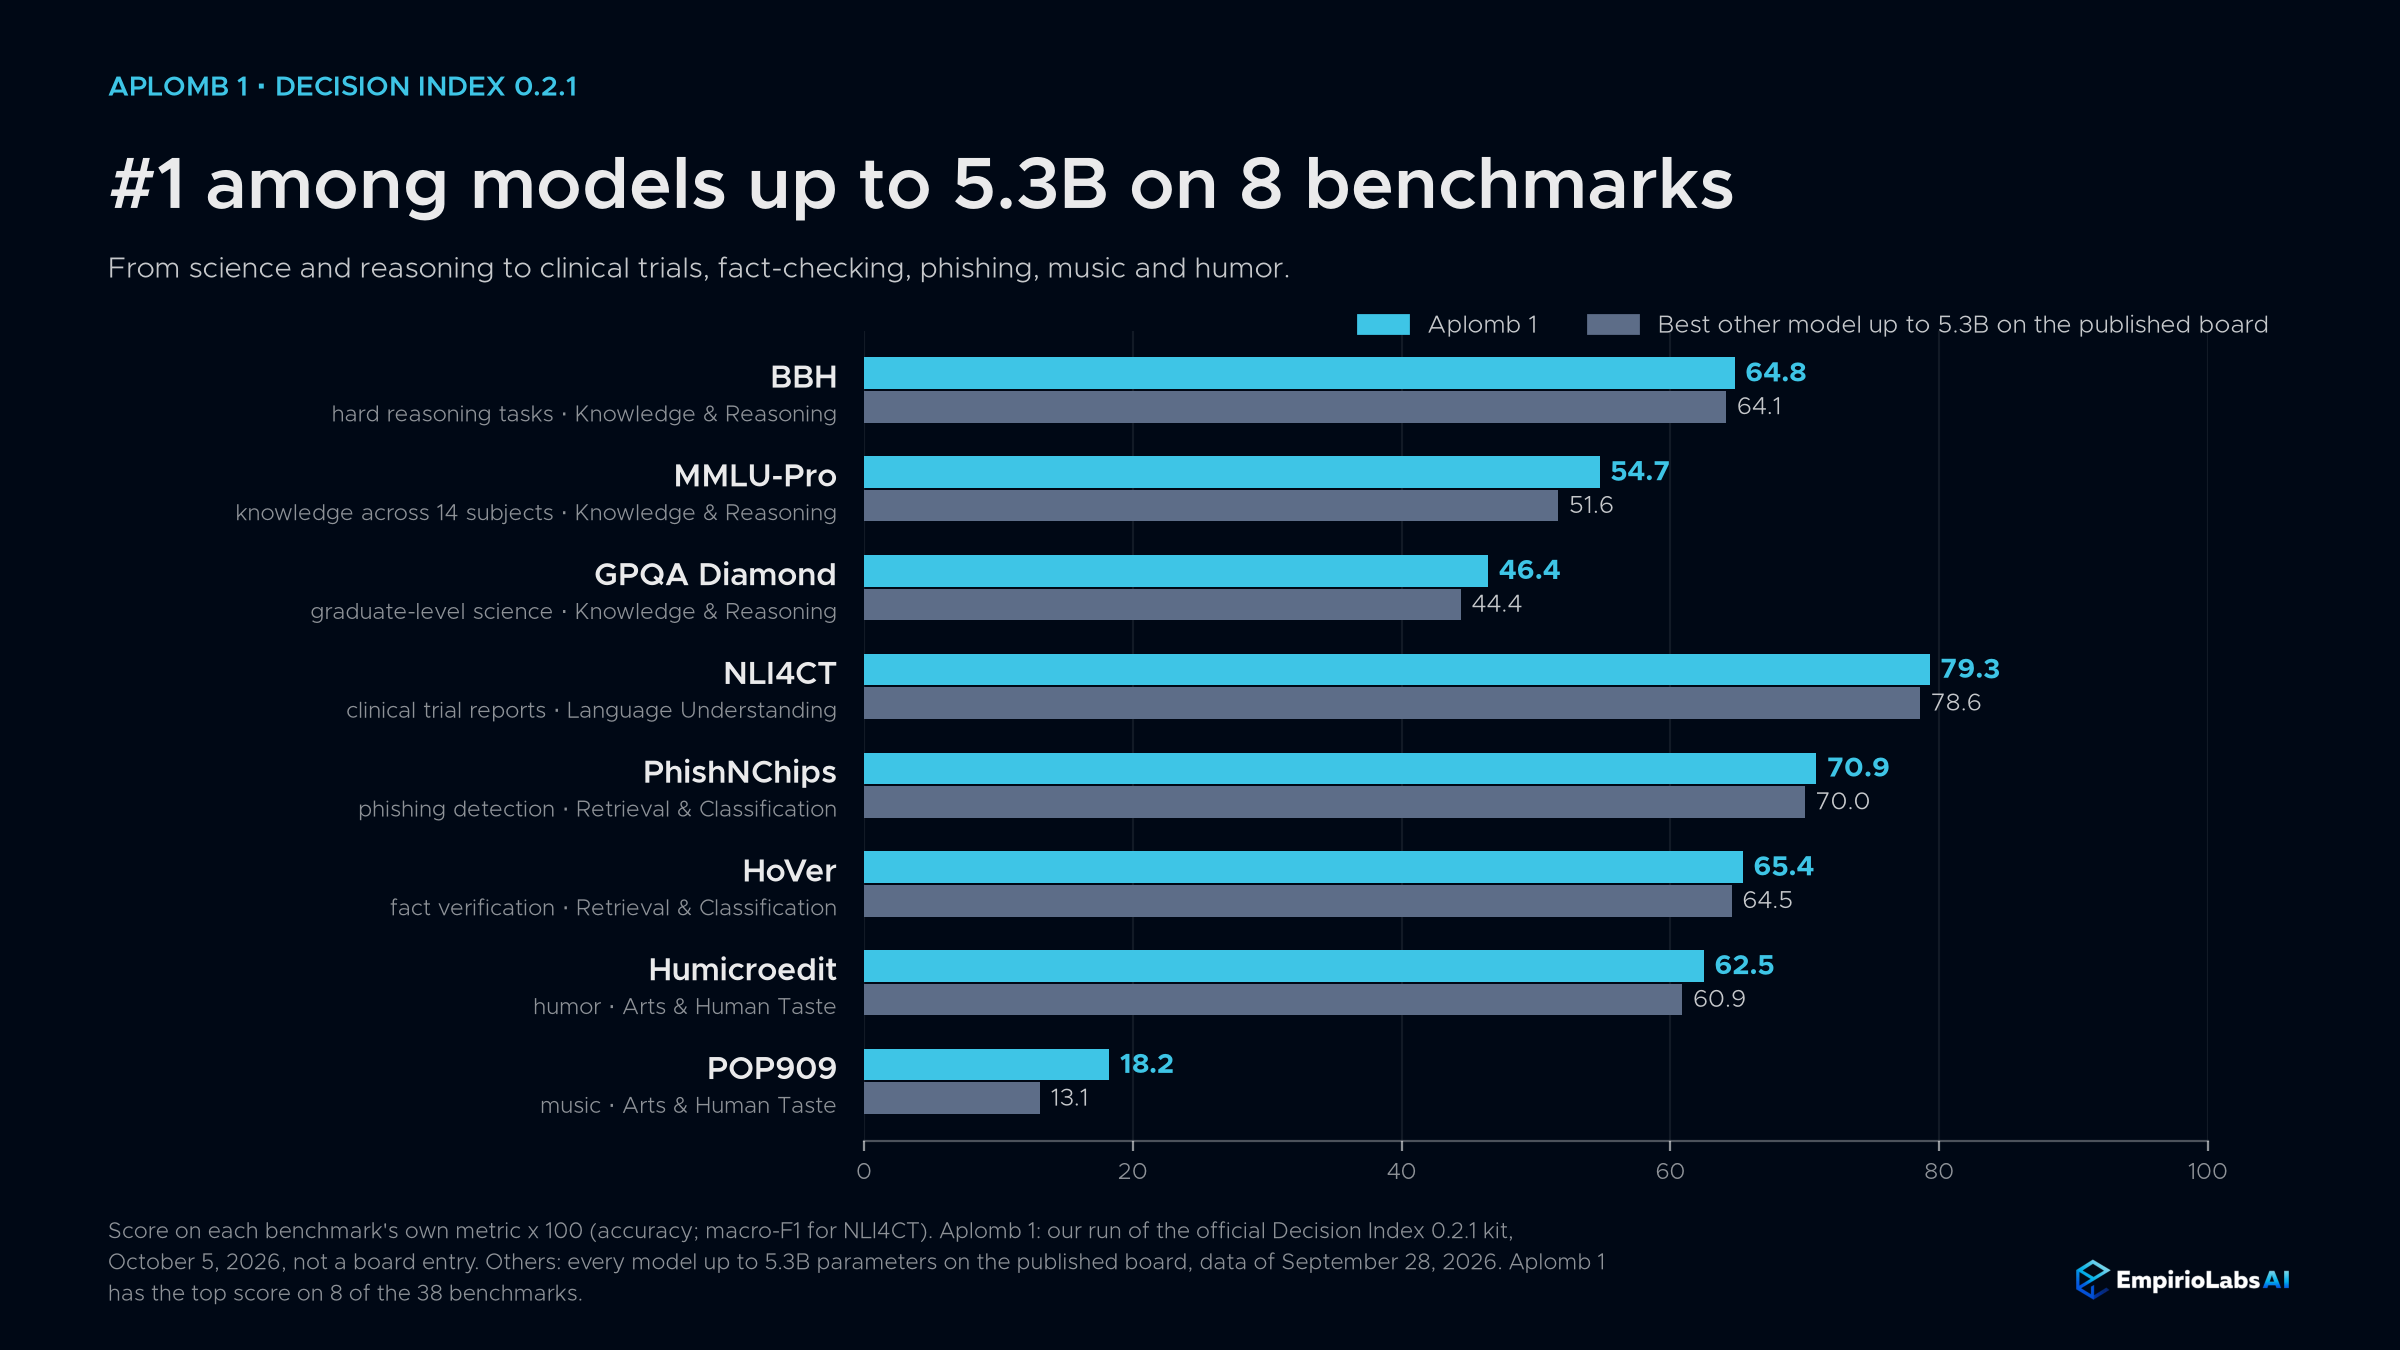
Stand 6. Oktober 2026 ist es #1 unter 4B-Modellen auf dem veröffentlichten Decision Index-Board, mit 44,86 auf unserem offiziellen Kit und #1 unter Modellen bis zu 5,3B-Parametern in 8 der 38 Benchmarks. Es ist heute im EmpirioLabs API und Playground verfügbar, und seine Gewichtungen sind auf Hugging Face unter der EmpirioLabs Model License verfügbar.
| Aplomb 1 auf den ersten Blick | |
|---|---|
| Eingänge | Text, JSON, Bilder, Video und Audio – in jedem Mix |
| Fenster | 1.000.000 Staatszeichen plus Frage |
| Fragen | Ja oder nein, Wahl (2 bis 255 Optionen), Punktzahl (2 bis 10 Stufen), Werkzeugauswahl |
| Nicht im Bundesstaat | Eine Wahrscheinlichkeit, dass die Eingabe die Antwort nicht enthält |
| Werkzeugauswahl | Das nächste Werkzeug, das aufgerufen werden soll, mit Wahrscheinlichkeiten für sein Enum und boolesche Argumente |
| Geschwindigkeit | Etwa 15 ms Modellzeit für eine kurze Frage; etwa 3 Sekunden für ein 1M-Token-Dokument im schnellen Langkontextmodus |
| API-Formate | Die Decisions-API sowie die Formate OpenAI, Anthropic und Gemini |
| Abrechnung | Nur Eingabetoken; Ausgabetoken sind immer null |
| Datenspeicherung | Null Datenspeicherung standardmäßig |
| Größe | 5,3 Milliarden Parameter, aufgebaut auf Qwen3.5-4B; offene Gewichte auf Hugging Face |
| Entscheidungsindex 0.2.1 | 44,86 in unserem Lauf des offiziellen Kits, #1 unter den 4B-Modellen auf dem veröffentlichten Board am 6. Oktober 2026 |
Was es beantwortet
Vier Fragetypen. Noul Antworten mit Ja oder Nein mit der Wahrscheinlichkeit Ja. Wahl Wählt eine von 2 bis 255 Optionen und gibt die volle Verteilung zurück. Punktestand ordnet den Staat auf eine geordnete Skala von 2 bis 10 Stufen. Werkzeug Wählt aus, welche Ihrer Funktionswerkzeuge aufgerufen werden sollen, und gibt Verteilungen über seine Enum- und Booleschen Argumente zurück.
Nicht im Bundesstaat. Hinzufügen "Enthaltung": Wahr zu einer Frage und die Antwort tragen auch die Wahrscheinlichkeit, dass der Bundesstaat nicht das enthält, was die Frage braucht. Ein Datensatz ohne Trägerfeld erhält eine hohe Abstinenzwahrscheinlichkeit anstelle einer sicheren Schätzung.
Unabhängige Antworten. Bis zu 128 Fragen teilen sich einen Zustand, und jede wird einzeln beantwortet, sodass das Hinzufügen einer Frage keine andere Antwort ändert.
Werkzeugauswahl für Agenten
Gib Aplomb 1 die Funktionen deines Agenten und den aktuellen Zustand (ein Ticket, eine Konversation, ein Datensatz), und es gibt das Tool mit einer Wahrscheinlichkeit für jedes Tool und einer Verteilung für jedes Enum und jedes boolesche Argument in einer Anfrage zurück, um als nächstes aufzurufen. Ein allgemeines LLM schreibt ein Tool Token für Token und sagt nicht, wie sicher es über das Tool oder irgendein Argument ist. Der Agent handelt, wenn die Wahrscheinlichkeit hoch ist, und übergibt den Schritt an ein größeres Modell, wenn sie es nicht ist, sodass Routineschritte eine generierte Antwort überspringen. Wir haben kein anderes Entscheidungsmodell gefunden, das Argumentwahrscheinlichkeiten zurückgibt.
Ein Ticket, auf dem steht: "Bestellung B-44120 ist mit einem rissigen Bildschirm angekommen. Ich will mein Geld zurück." mit drei Werkzeugen, issue_refund (a Grund Enum und a full_refund Boolesch), track_package und escalate_to_human, kommt zurück als (gekürzt, gerundet):
{"tool": "issue_refund", "probabilities": {"issue_refund": 0.969, "none": 0.025, "escalate_to_human": 0.005, "track_package": 0.002}, "arguments": {"issue_refund": { "reason": {"value": "damaged", "probabilities": {"damaged": 0.993, "not_as_described": 0.007, "late": 0.001}}, "full_refund": {"value": true, "probability_true": 0.761}}}, "open_arguments": {"track_package": ["order_id"}}}
Freitextargumente, wie eine Order-ID, sind unter open_arguments für den Agenten zu füllen.
Gemischte Eingaben, bis zu 1 Million Token
Text, JSON-Objekte und -Arrays, Bilder, Video und Audio gelangen in denselben Zustand, in beliebiger Kombination: eine Support-Anrufaufnahme neben dem Kontoeintrag, ein Dashcam-Clip neben dem Anspruchsformular, ein Produktfoto neben der Anzeige. Der Bundesstaat plus die längste Frage kann 1.000.000 Token umfassen, genug für ein Langvertragspaket, ein Jahr Tickets oder Stunden Transkripte in einer Anfrage.
Wie er bewertet
Wir haben Aplomb 1 und drei offene 4B-Entscheidungsmodelle auf denselben Punkten durchgeführt und die Zahlen, die Intern-Decision für Jev, JevK5 und SemIf veröffentlicht hat, daneben gesetzt. In den sieben Suiten umfassenden Intern-Decision-Berichten liegt Aplomb 1 im Schnitt bei 88,7 %. Gegenüber Jevs veröffentlichter Argumentation liegt es bei JevBench Hard und getippten Entscheidungen vorne, gleich bei JevBench Easy, und liegt bei JevBench Original, ToolACE, AG News und WildJailbreak zurück. Der größte Vorsprung liegt bei JevBench Hard, +5,4 Punkte.
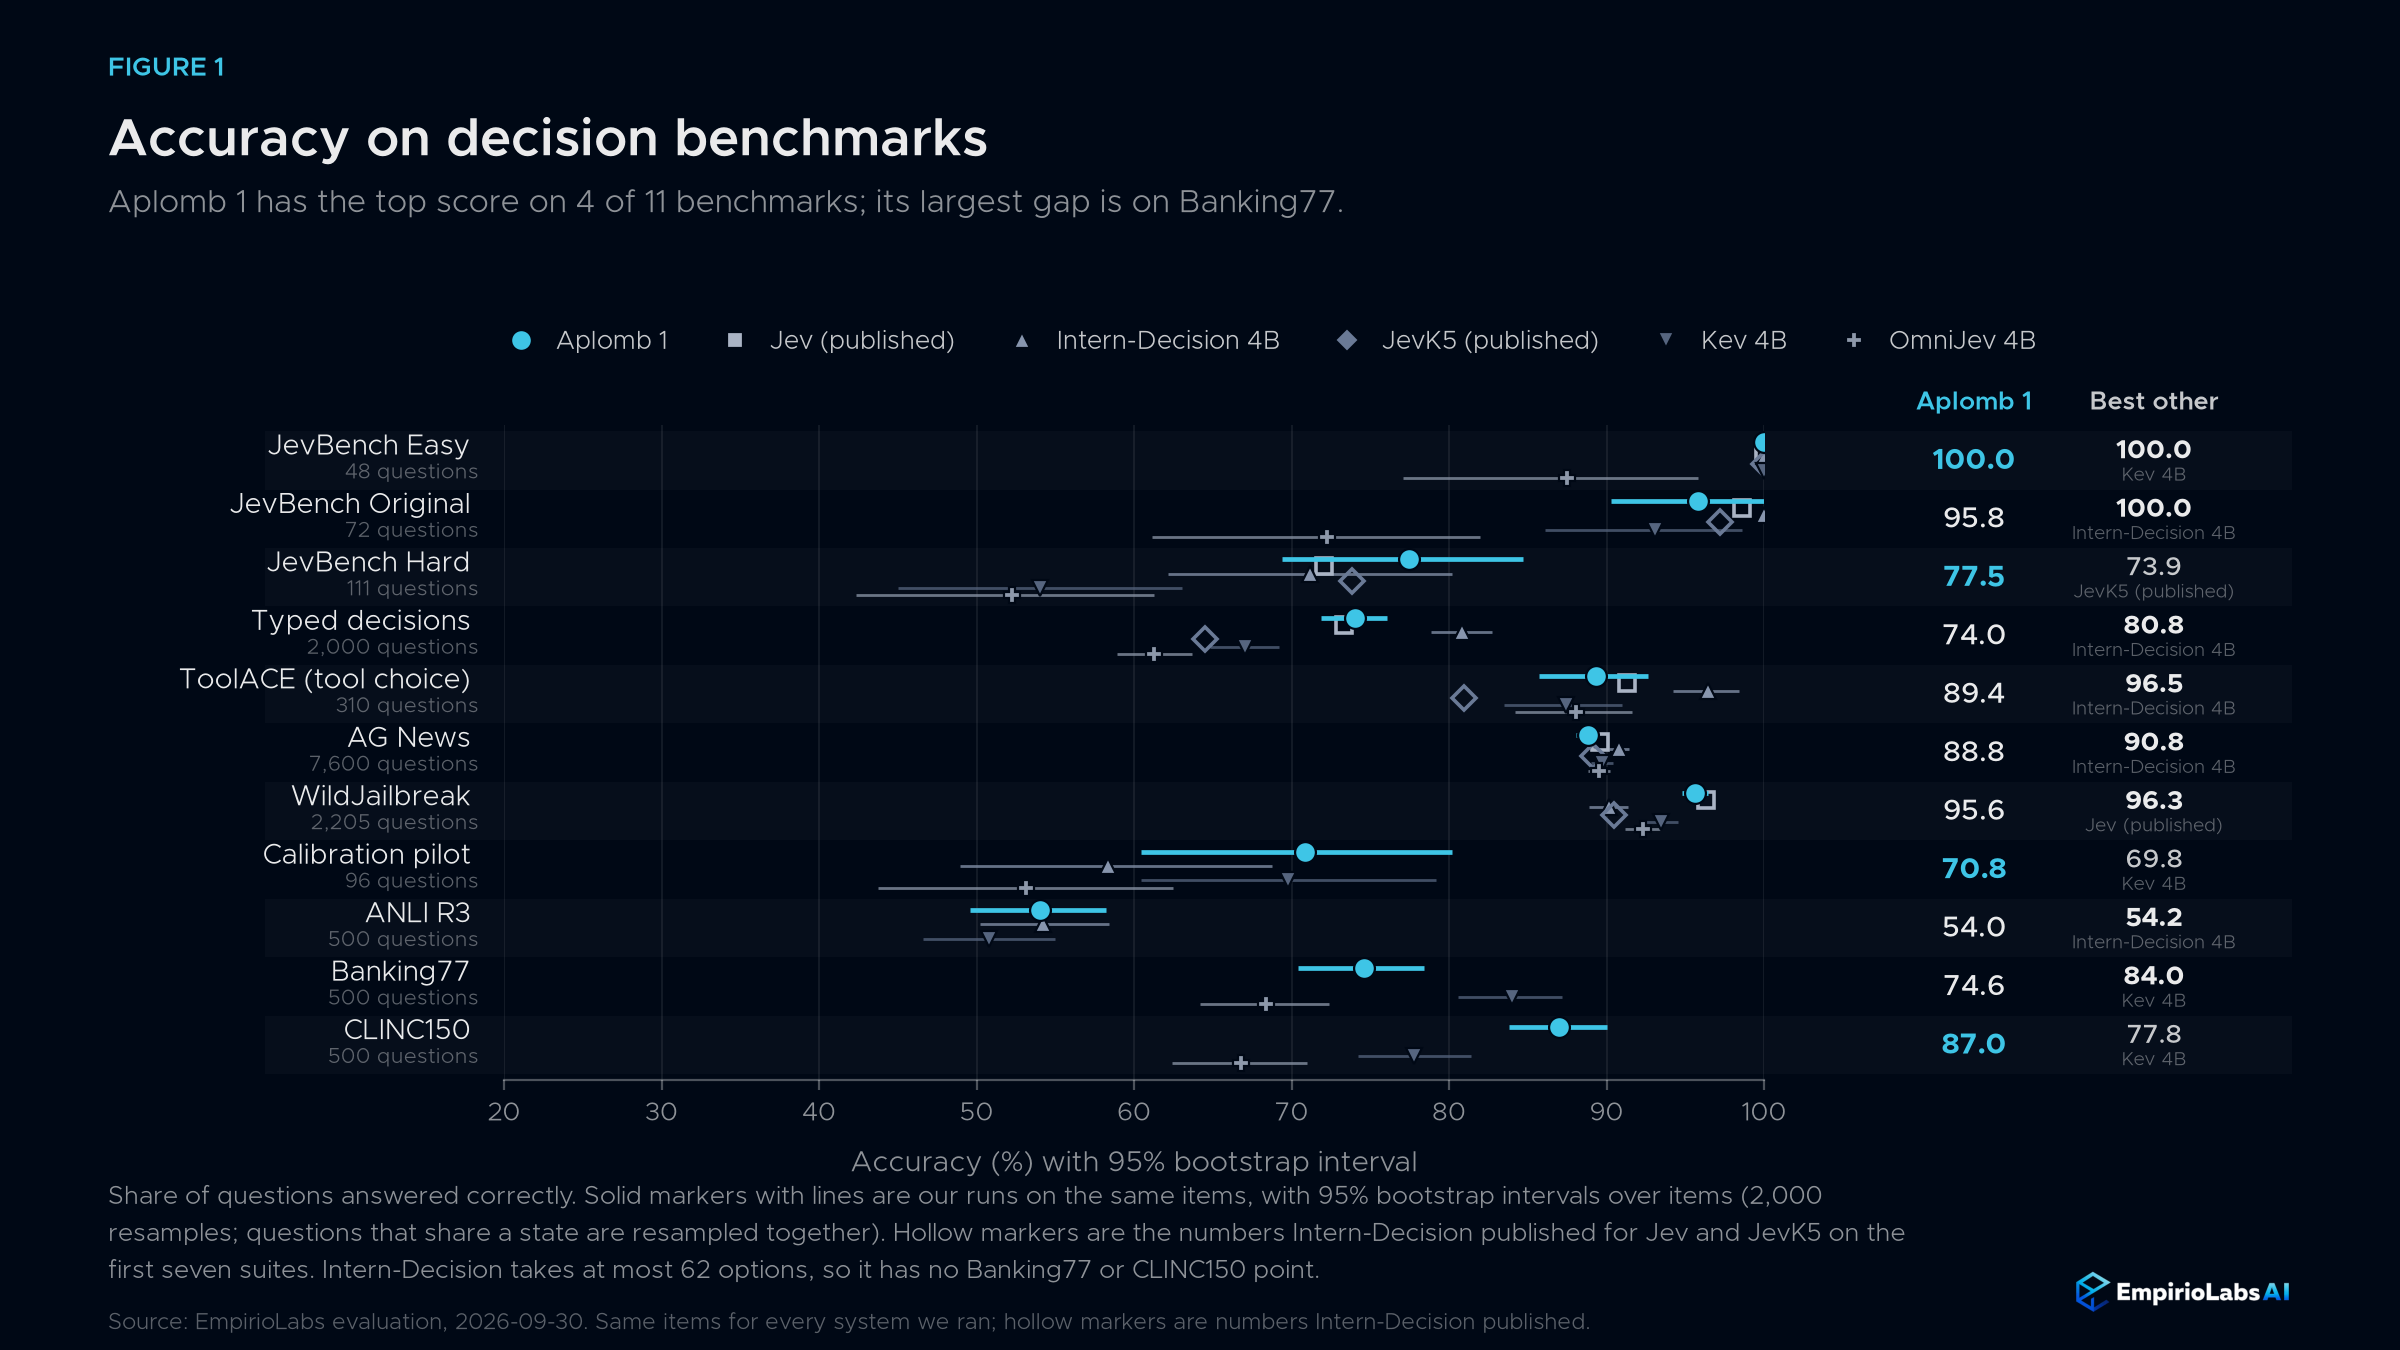
| Benchmark | Aplomb 1 | Jev (p) | JevK5 (p) | SemIf (p) | Intern-Entscheidung 4B | Kev 4B | OmniJev 4B |
|---|---|---|---|---|---|---|---|
| JevBench Easy | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 87.5 |
| JevBench Original | 95.8 | 98.6 | 97.2 | 98.6 | 100.0 | 93.1 | 72.2 |
| JevBench Hard | 77.5 | 72.1 | 73.9 | 61.3 | 71.2 | 54.1 | 52.3 |
| Typisierte Entscheidungen | 74.0 | 73.3 | 64.5 | 62.8 | 80.8 | 67.0 | 61.3 |
| ToolACE | 89.4 | 91.3 | 81.0 | 85.2 | 96.5 | 87.4 | 88.1 |
| AG News | 88.8 | 89.6 | 89.1 | 89.2 | 90.8 | 89.7 | 89.6 |
| WildJailbreak | 95.6 | 96.3 | 90.5 | 92.5 | 90.2 | 93.5 | 92.3 |
| Durchschnitt | 88.7 | 88.7 | 85.2 | 84.2 | 89.9 | 83.5 | 77.6 |
(p) Wie veröffentlicht von Intern-Decision für dieselben Items. Intern-Decision berichtet 90,02 für sein 4B-Modell in diesem Bündel; die Spalte zeigt unseren Durchlauf.
| Benchmark | Aplomb 1 | Intern-Entscheidung 4B | Kev 4B | OmniJev 4B |
|---|---|---|---|---|
| Kalibrierungspilot | 70.8 | 58.3 | 69.8 | 53.1 |
| ANLI R3 | 54.0 | 54.2 | 50.8 | n/a |
| Banking77 (77 Optionen) | 74.6 | n/a | 84.0 | 68.4 |
| CLINC150 (150 Optionen) | 87.0 | n/a | 77.8 | 66.8 |
Lange Eingänge
Wir haben Nachschlage in Auftragsbüchern von 16K bis 1M Token gemessen, wobei die Fragen zu einer Bestellung in einer zufälligen Tiefe gestellt wurden.
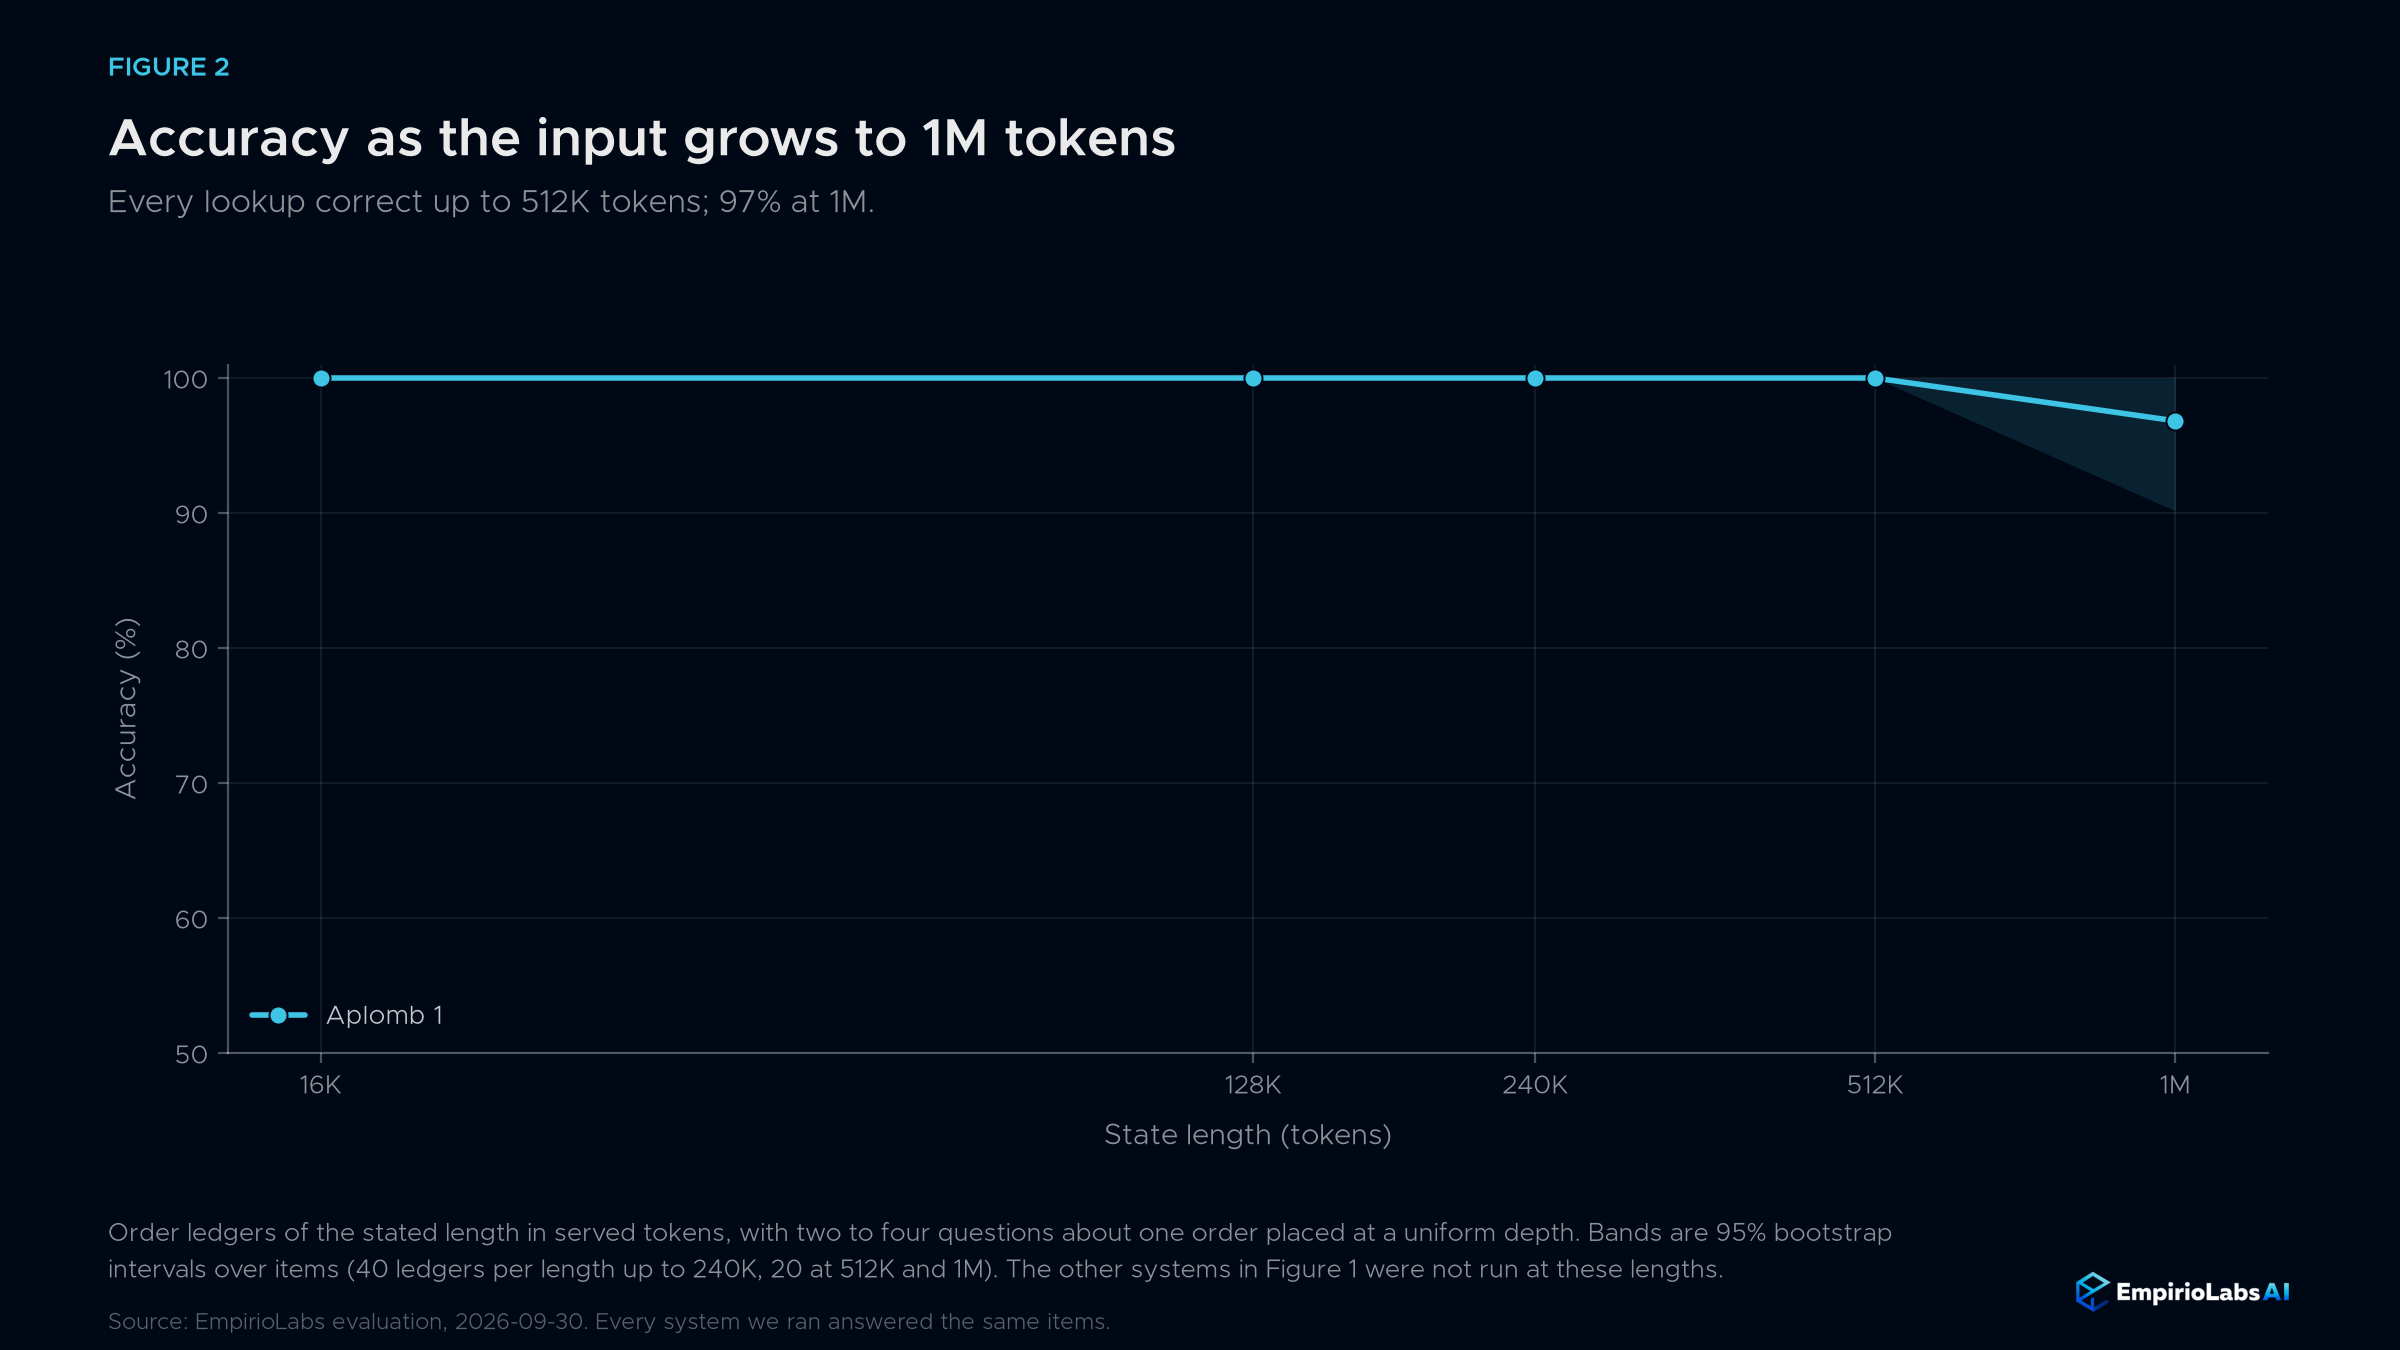
| Eingabelänge (Tokens) | 16K | 128.000 | 240K | 512K | 1M |
|---|---|---|---|---|---|
| Aplomb 1 | 100.0 | 100.0 | 100.0 | 100.0 | 96.8 |
Lange Dokumente in Sekunden
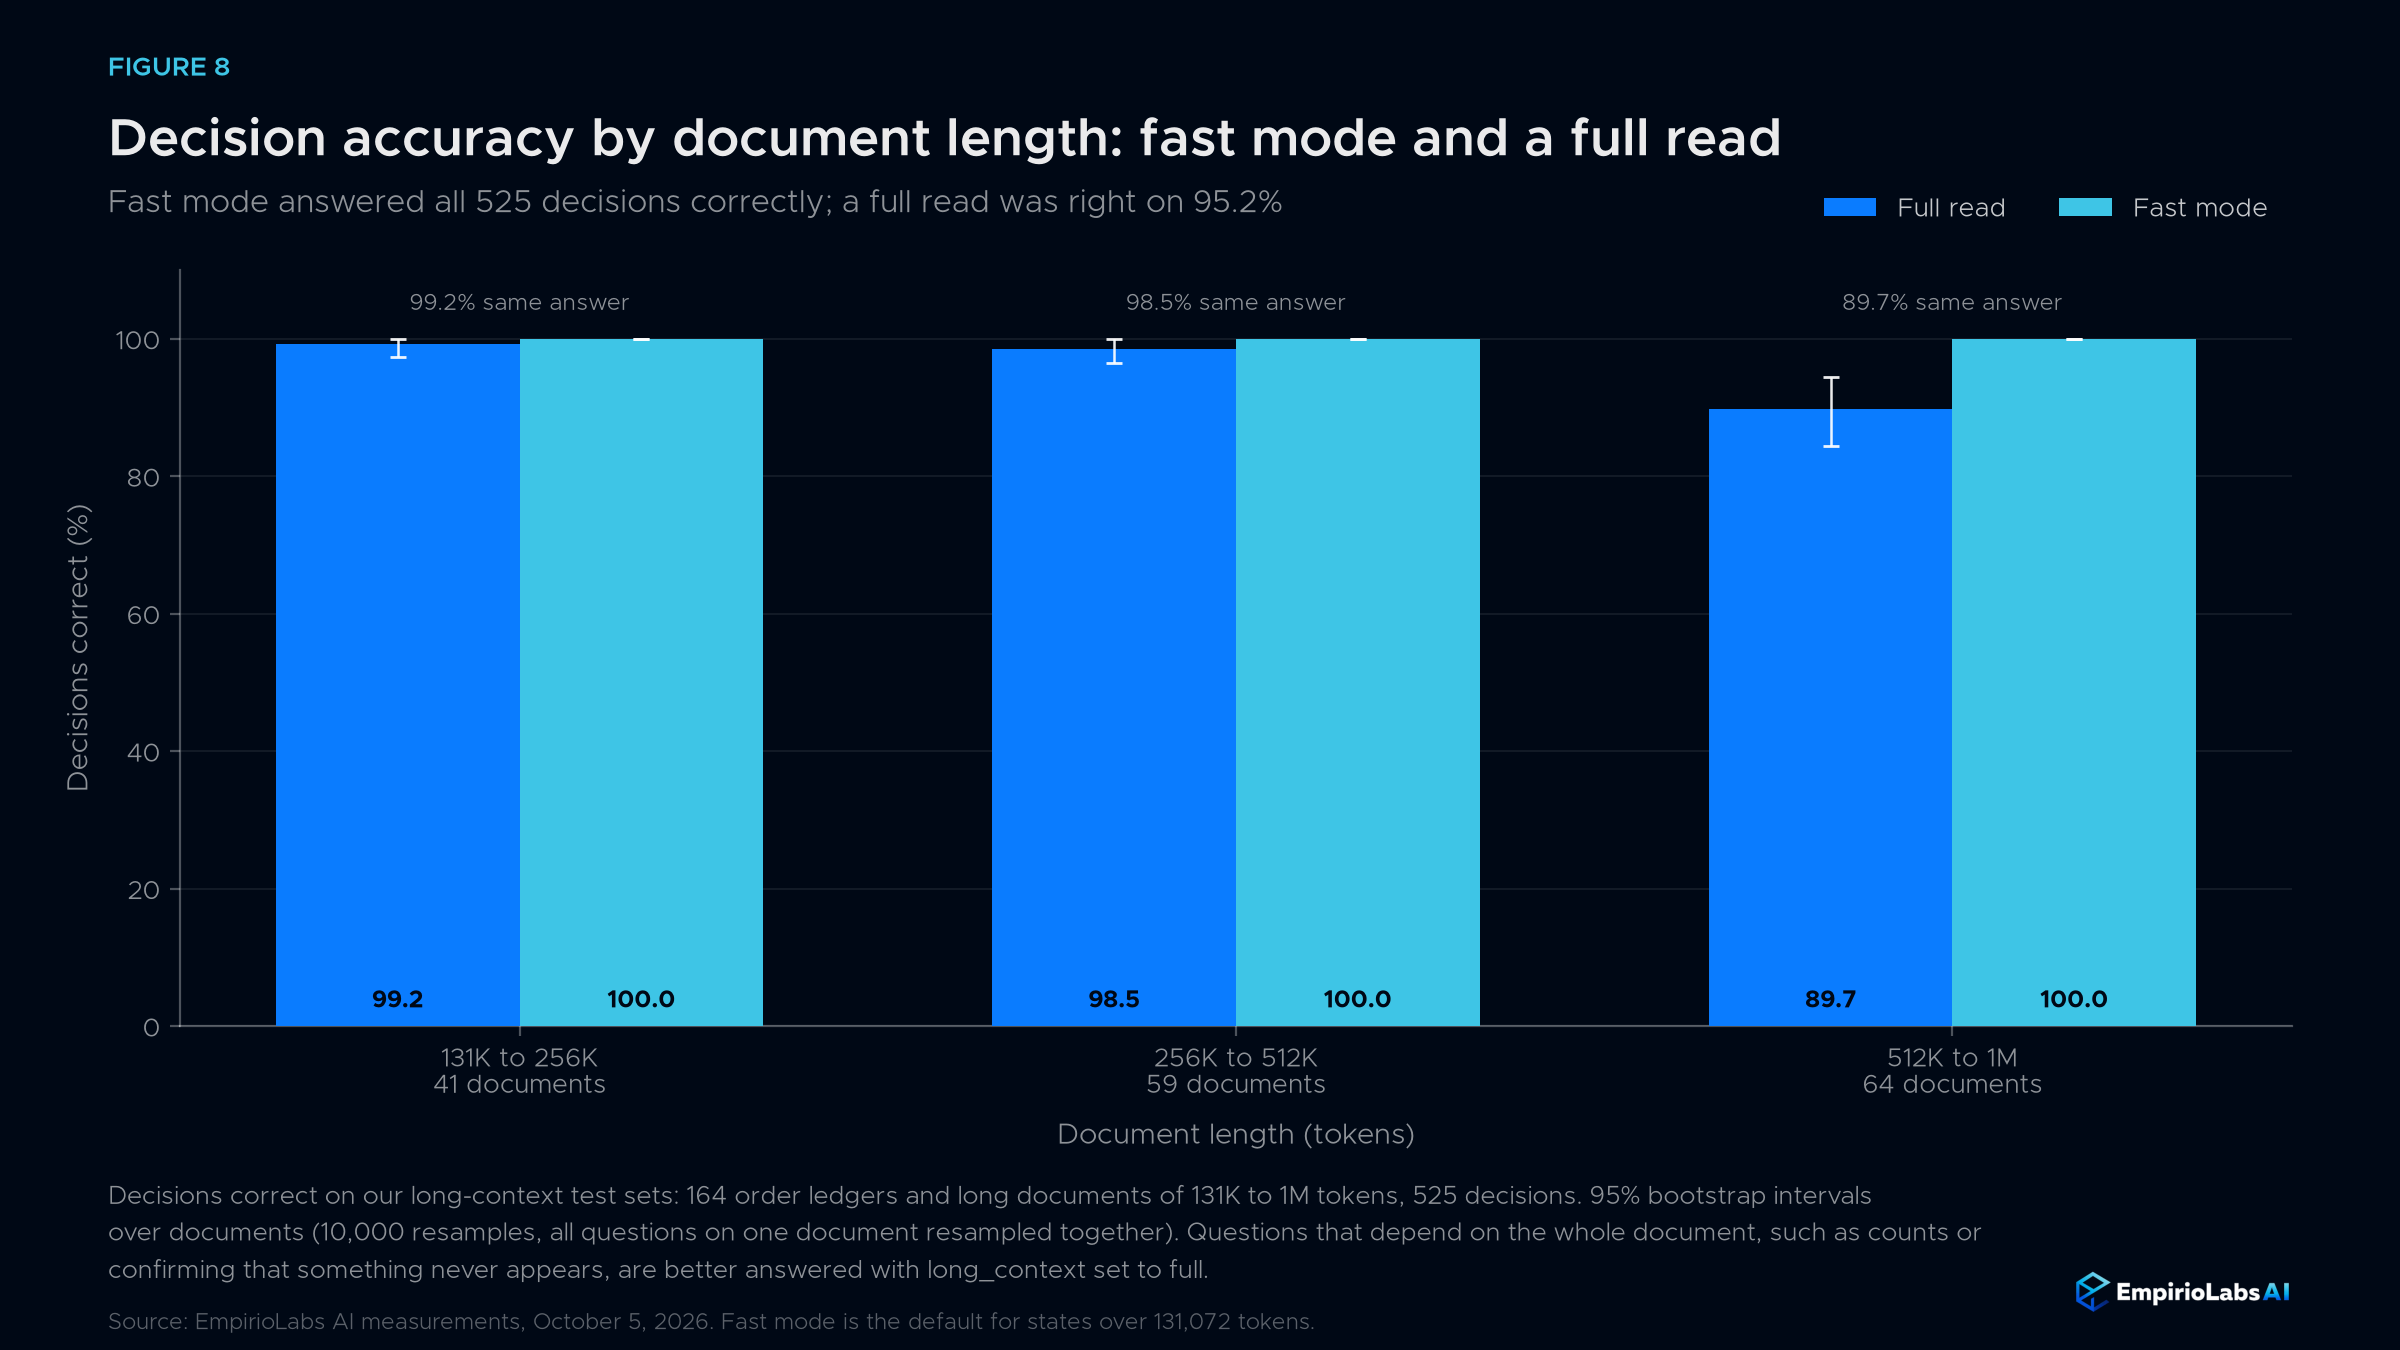
Auf der EmpirioLabs API und im Playground wird standardmäßig ein Zustand, der länger als 131.072 Token ist, im schnellen Langkontextmodus gelesen. Ein 1M-Token-Dokument benötigt etwa 3 Sekunden statt etwa 111 Sekunden zum vollständigen Lesen, und bei unseren Langkontext-Testsätzen beantwortete der Schnellmodus alle 525 Entscheidungen korrekt, gegenüber 95,2 % bei einer vollständigen Lesung.
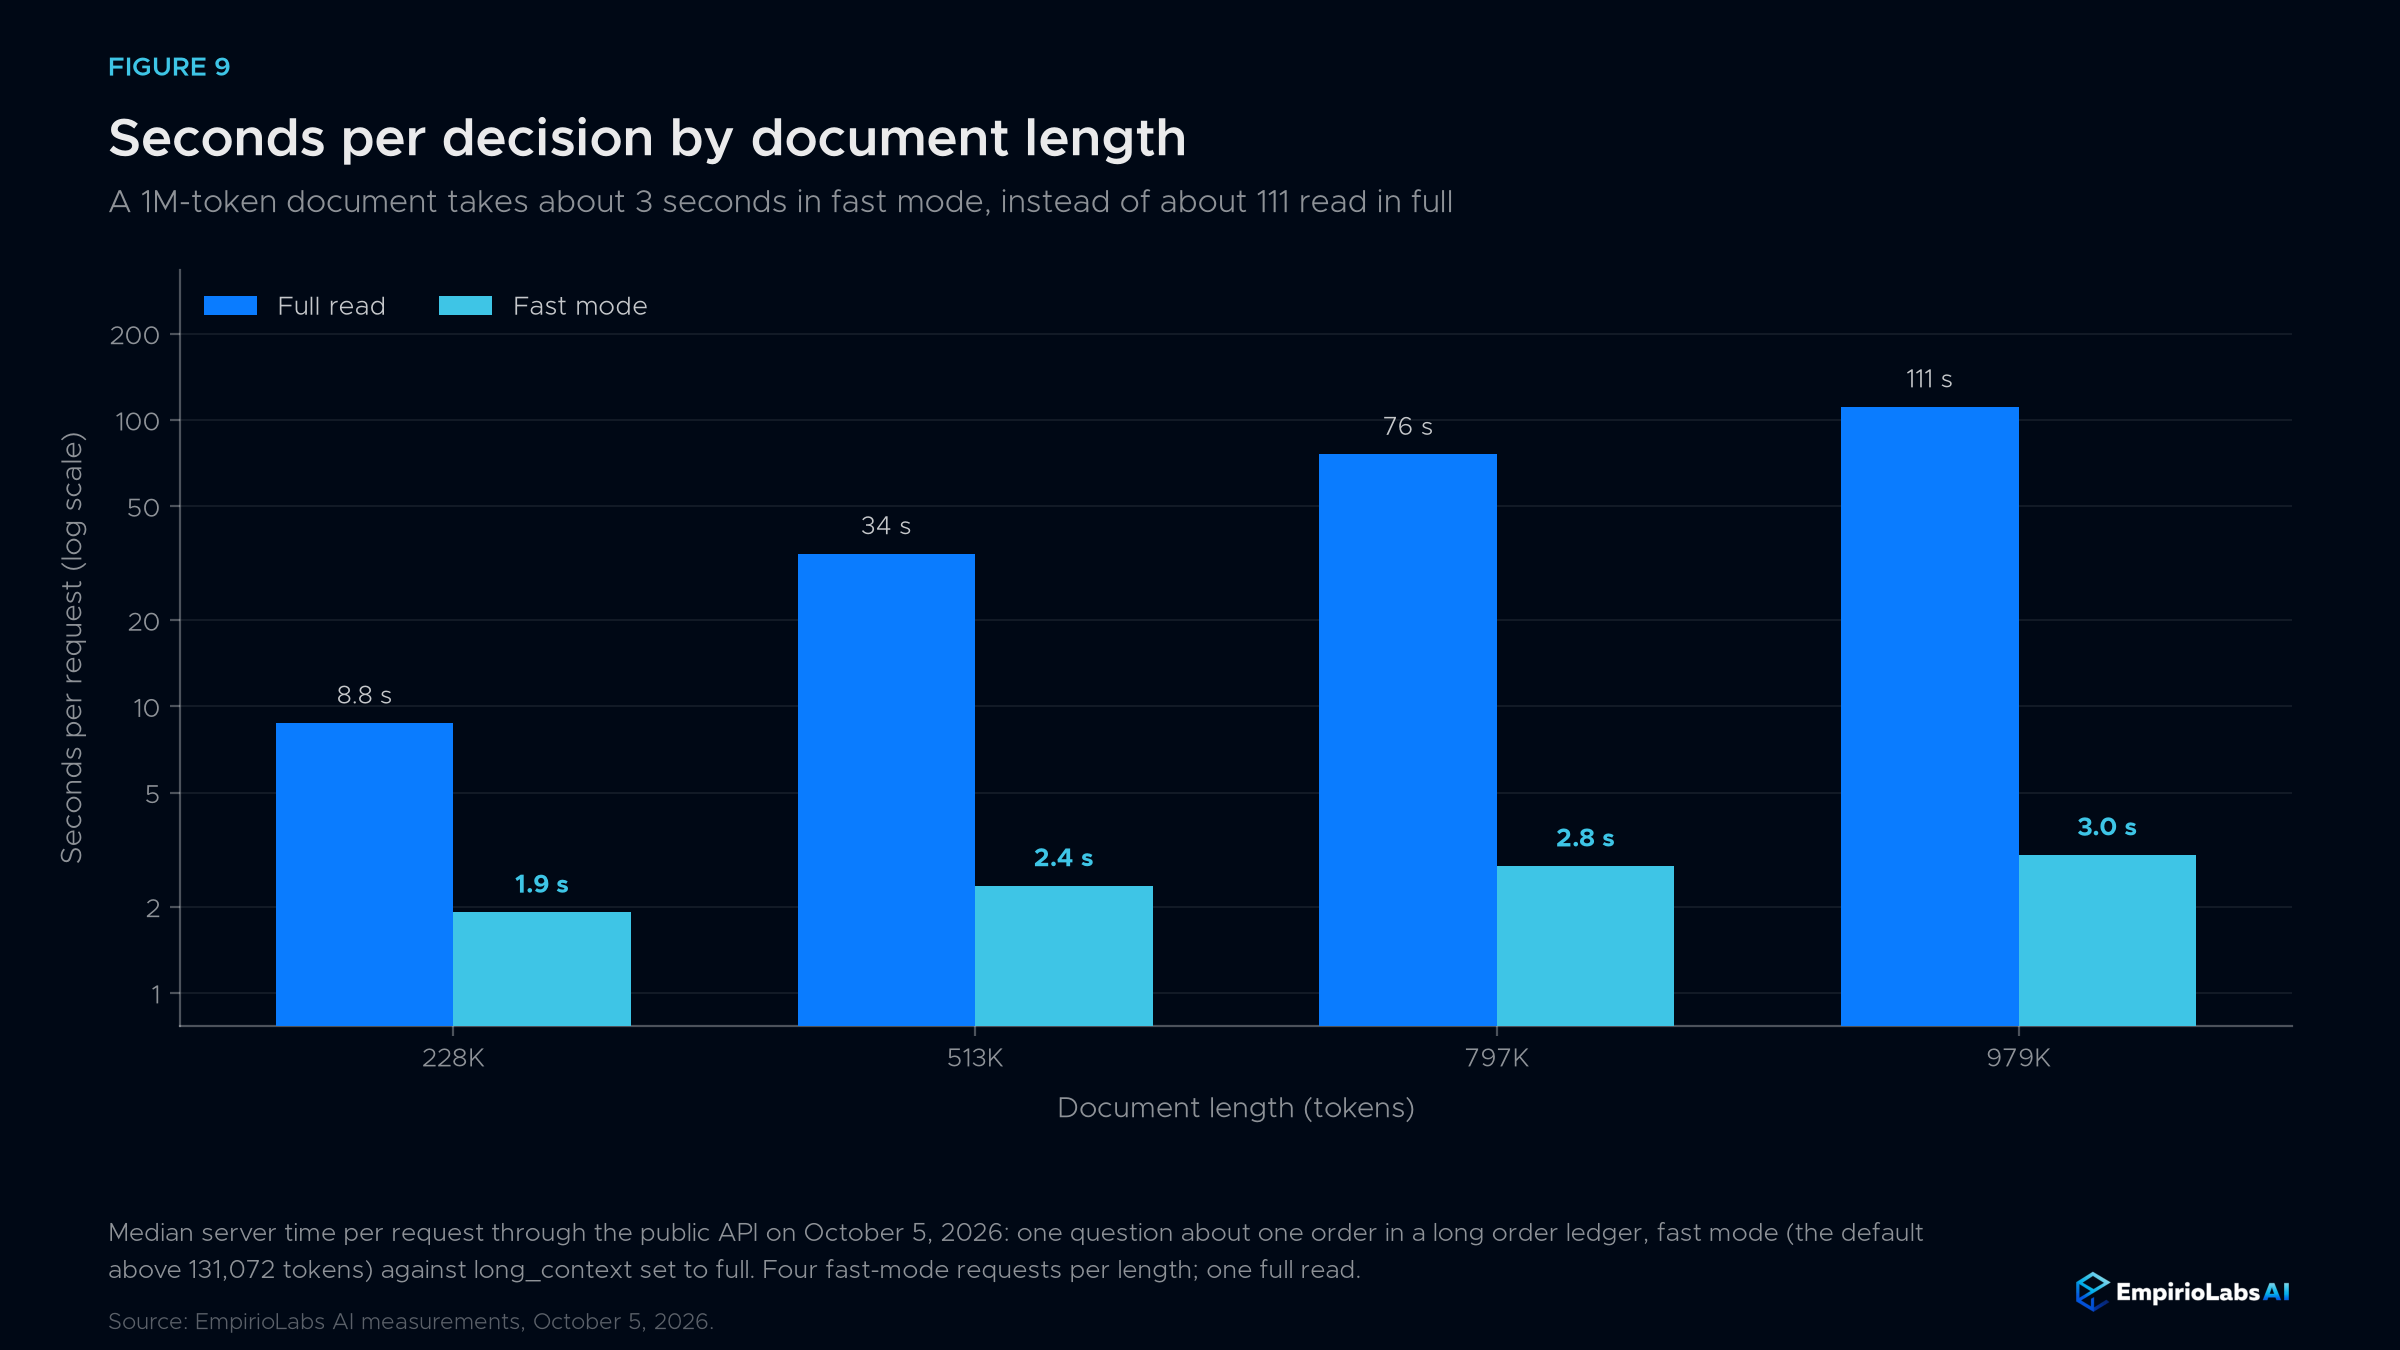
| Dokumentlänge (Tokens) | 228K | 513K | 797.000 | 979K |
|---|---|---|---|---|
| Schnellmodus | 1,9 s | 2,4 s | 2,8 s | 3.0 s |
| Vollständige Lektüre | 8,8 s | 34 s | 76 s | 111 s |
Senden "long_context": "Voll" um jedes Token zu lesen. Eine vollständige Lektüre ist die bessere Wahl, wenn eine Antwort vom gesamten Dokument abhängt, wie einer Zählung, dem Gesamtton oder der Bestätigung, dass etwas nie erscheint: Bei 24 Dokumenten, die diese Fragen testen sollen, lag der Schnellmodus bei 50 % der Entscheidungen richtig und bei 61 % eine vollständige Lesung. Die Antworten long_context Feld gibt an, welcher Modus verwendet wurde, und die Nutzung zählt den gesamten Zustand in beiden Modi. Der schnelle Langkontextmodus ist nur auf der EmpirioLabs API und im Playground verfügbar; die offenen Gewichte lesen jedes Token.
Kalibrierung
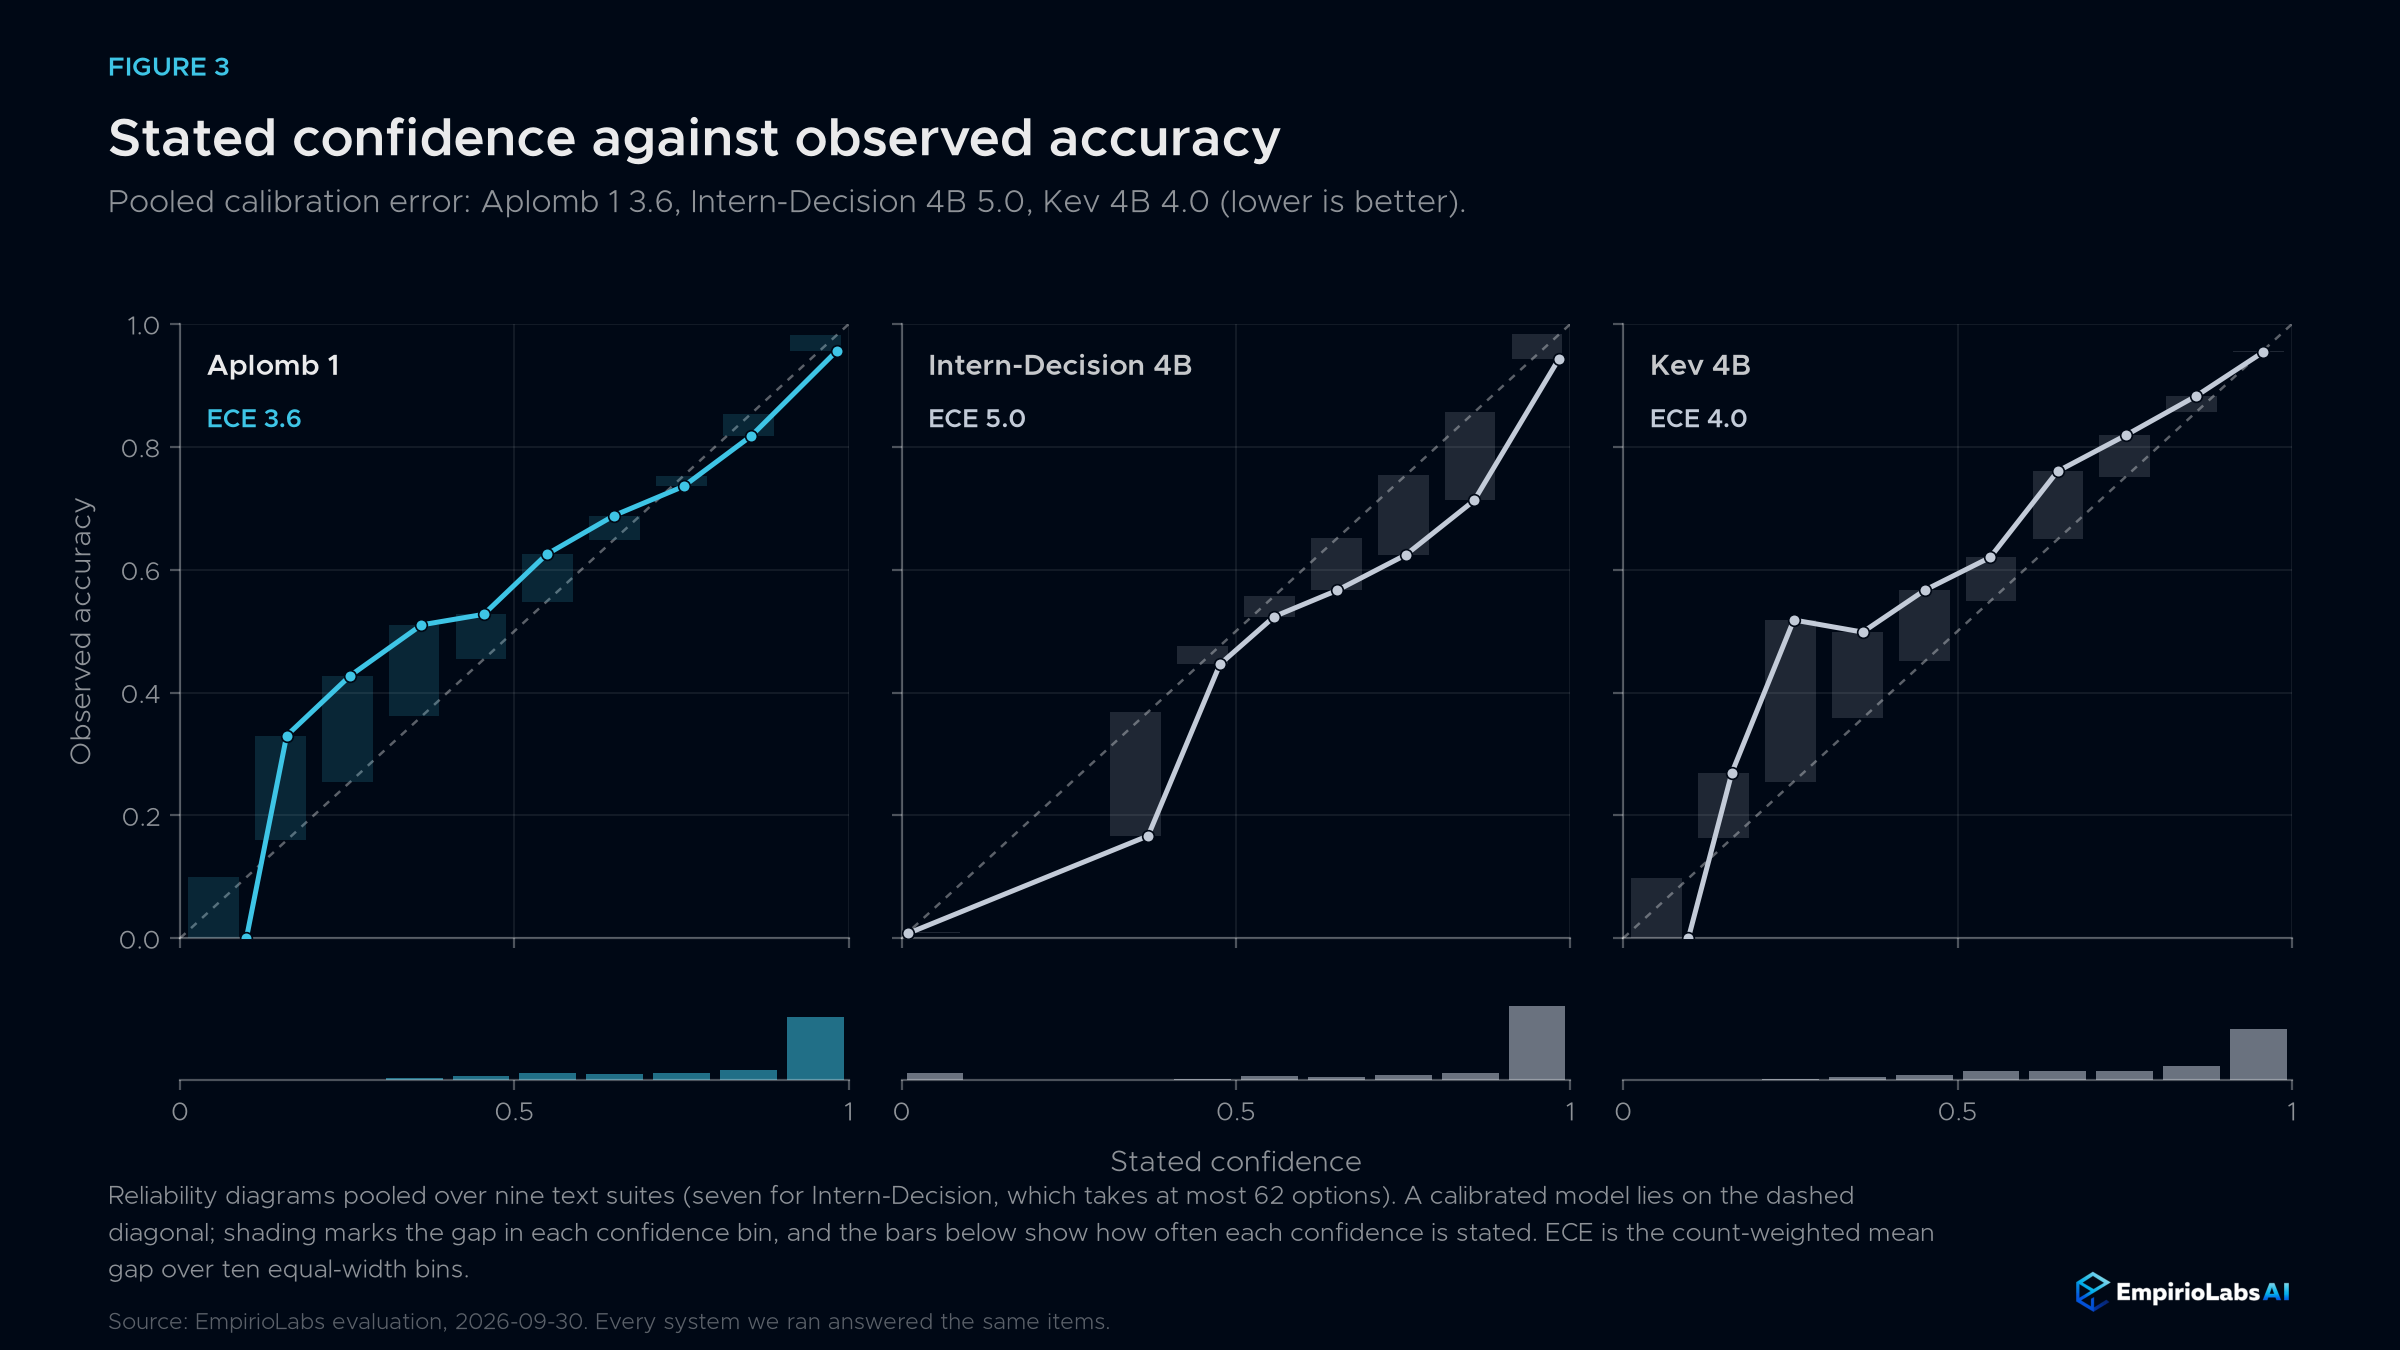
Eine Wahrscheinlichkeit ist nur dann nützlich, wenn sie das meint, was sie sagt. Über neun Textsuiten hinweg verfolgt die angegebene Konfidenz von Aplomb 1, wie oft sie richtig ist: Der gepoolte Kalibrierungsfehler beträgt 3,6, gegenüber 5,0 für Intern-Decision 4B und 4,0 für Kev 4B (niedriger ist besser).
Bilder, Video und Audio
| Benchmark (erste 500 Artikel) | Aplomb 1 | Intern-Entscheidung 4B | OmniJev 4B |
|---|---|---|---|
| POPE | 89.0 | 89.2 | 88.4 |
| MMStar | 68.6 | 65.2 | 64.4 |
| AI2D | 87.0 | 81.0 | 83.4 |
| MMMU | 57.2 | 57.0 | 56.0 |
| HallusionsBank | 79.8 | 79.4 | 71.2 |
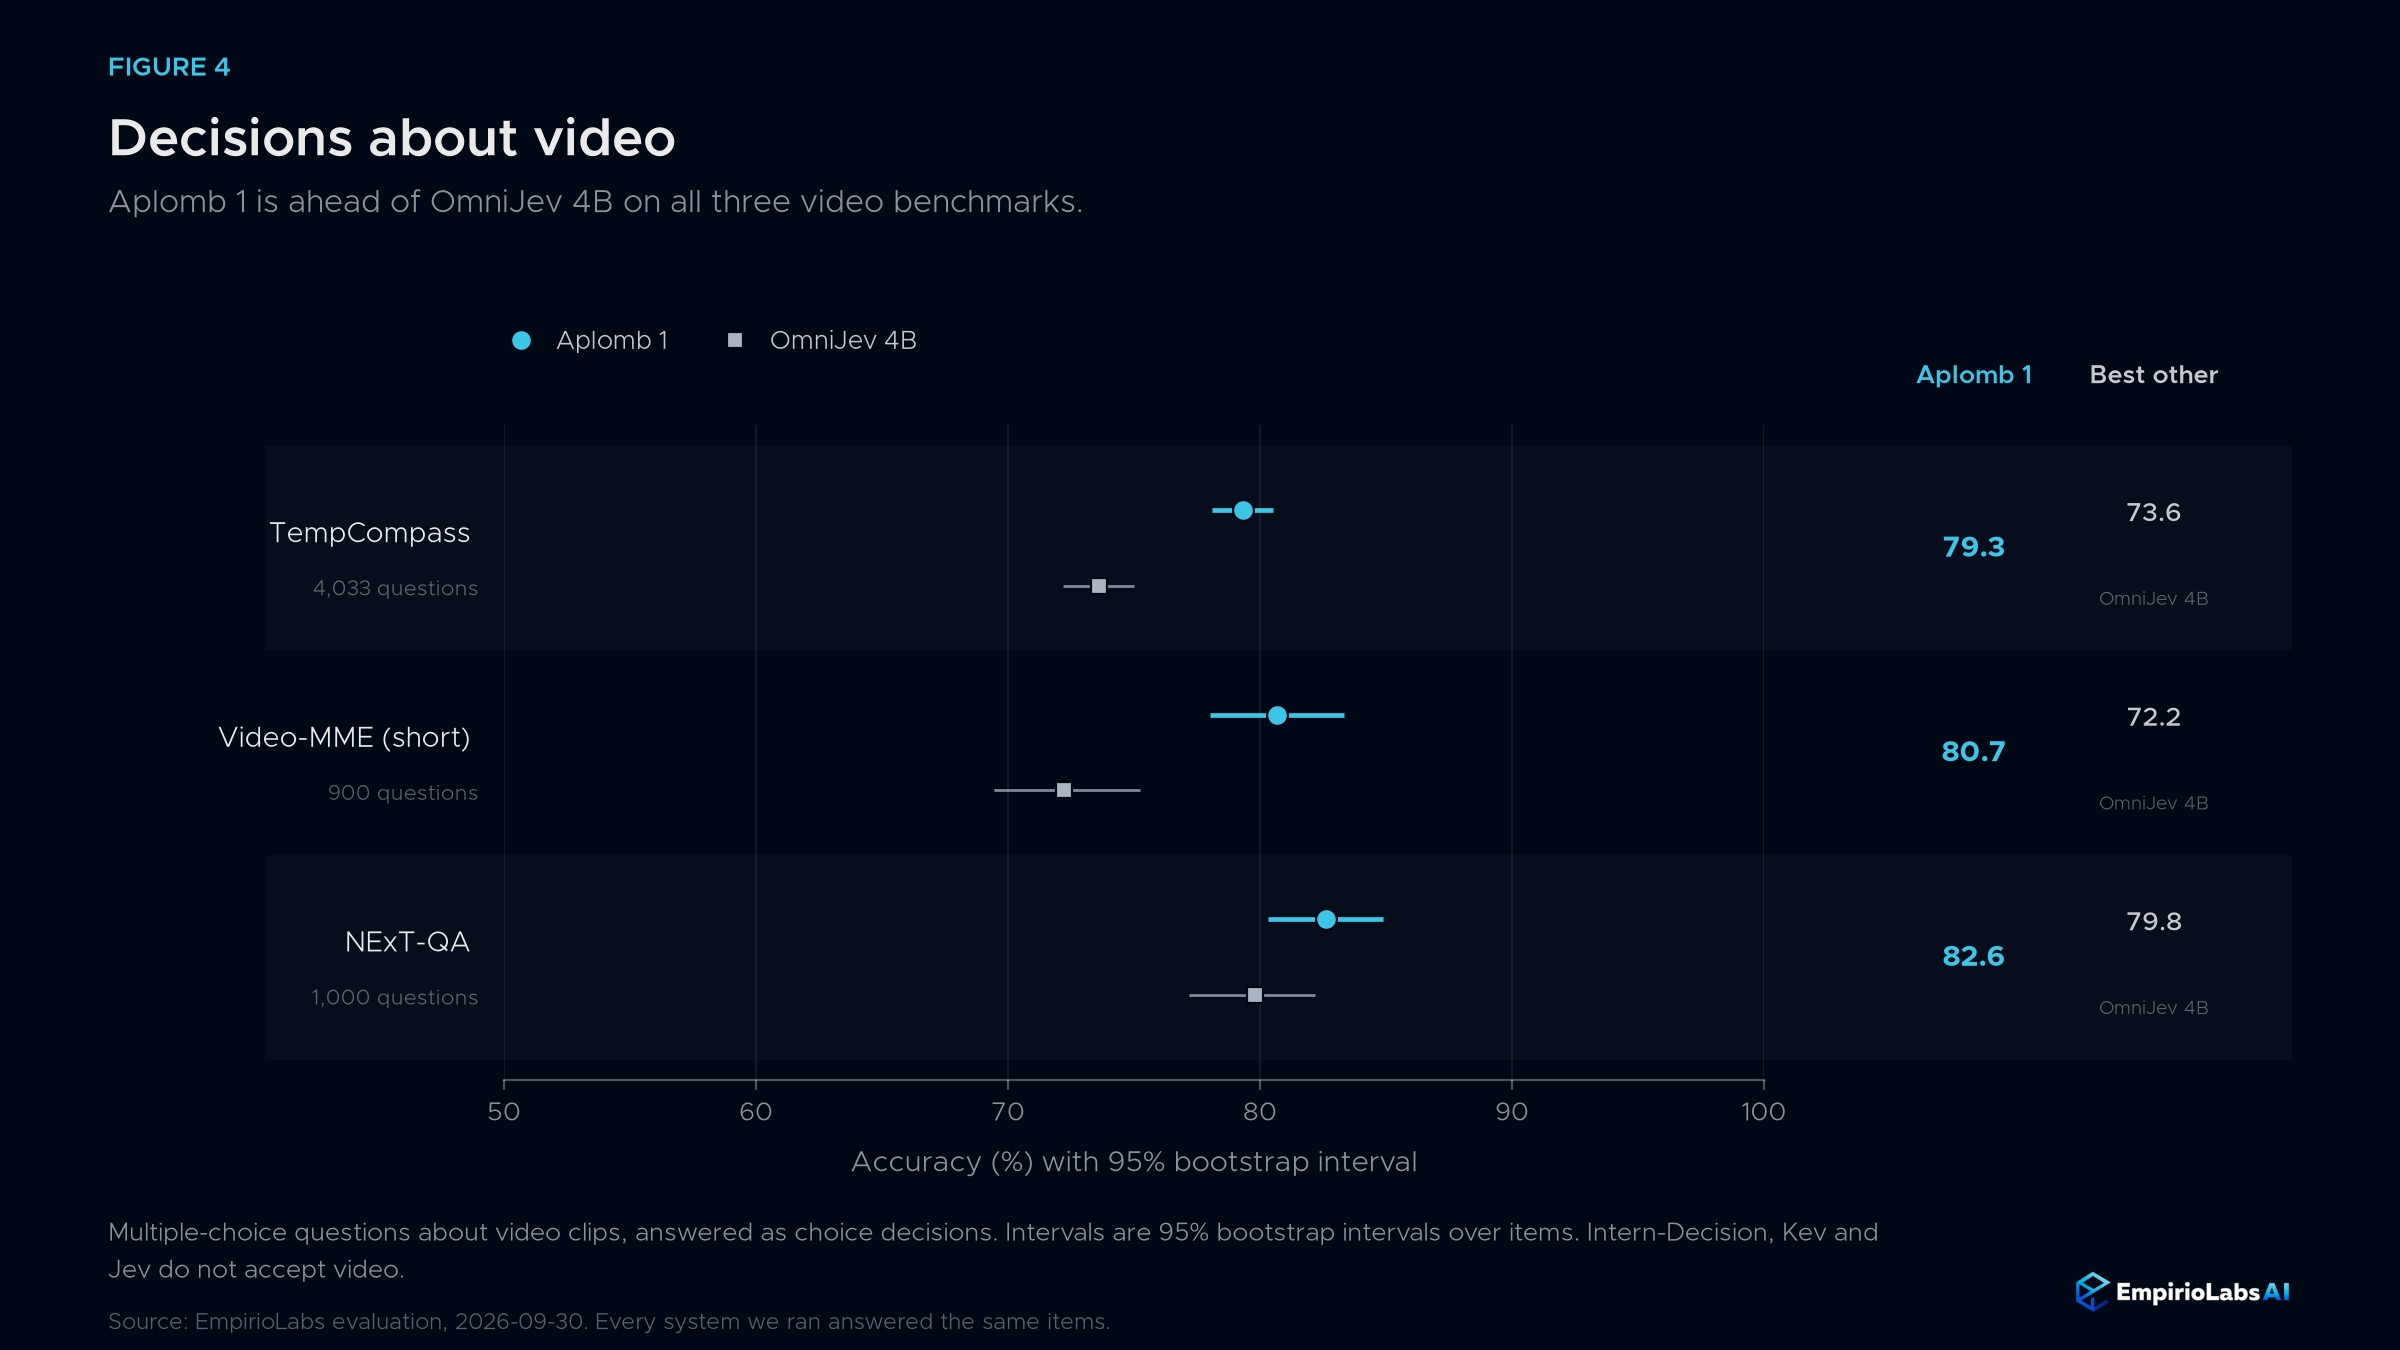
| Benchmark | Aplomb 1 | OmniJev 4B |
|---|---|---|
| TempCompass | 79.3 | 73.6 |
| Video-MME (Kurzzeit) | 80.7 | 72.2 |
| NExT-QA | 82.6 | 79.8 |
Wir haben selbst Audio zu Aplomb 1 hinzugefügt; keines der anderen Entscheidungsmodelle oben akzeptiert es. Am stärksten ist es bei Sprach- und Stimmklängen; Umgebungsgeräusche und offene Fragen zum Audio sind dadurch schwieriger:
| Benchmark | Aplomb 1 |
|---|---|
| VocalSound (Gesangsklänge) | 90.0 |
| CREMA-D (Emotion in der Sprache) | 65.0 |
| ESC-50 (Umgebungsgeräusche) | 8.4 |
| MMAU (Audiofragen) | 49.1 |
| MMSU (gesprochene Sprache) | 43.3 |
51 Sprachen
Aplomb 1 entscheidet über Text in vielen Sprachen, nicht nur im Englischen. Bei MASSIVE wird jede Anfrage an einen Sprachassistenten in einer von 51 Sprachen verfasst, während die Frage- und die 59 Absichtslabels auf Englisch bleiben. Ohne jegliches Training auf MASSIVE liegt Aplomb 1 im Durchschnitt bei 75,0 % in den 51 Sprachen bei der Auswahl aller 59 Sprachen, 91,0 % auf Englisch und 70 % oder mehr in 39 Sprachen.
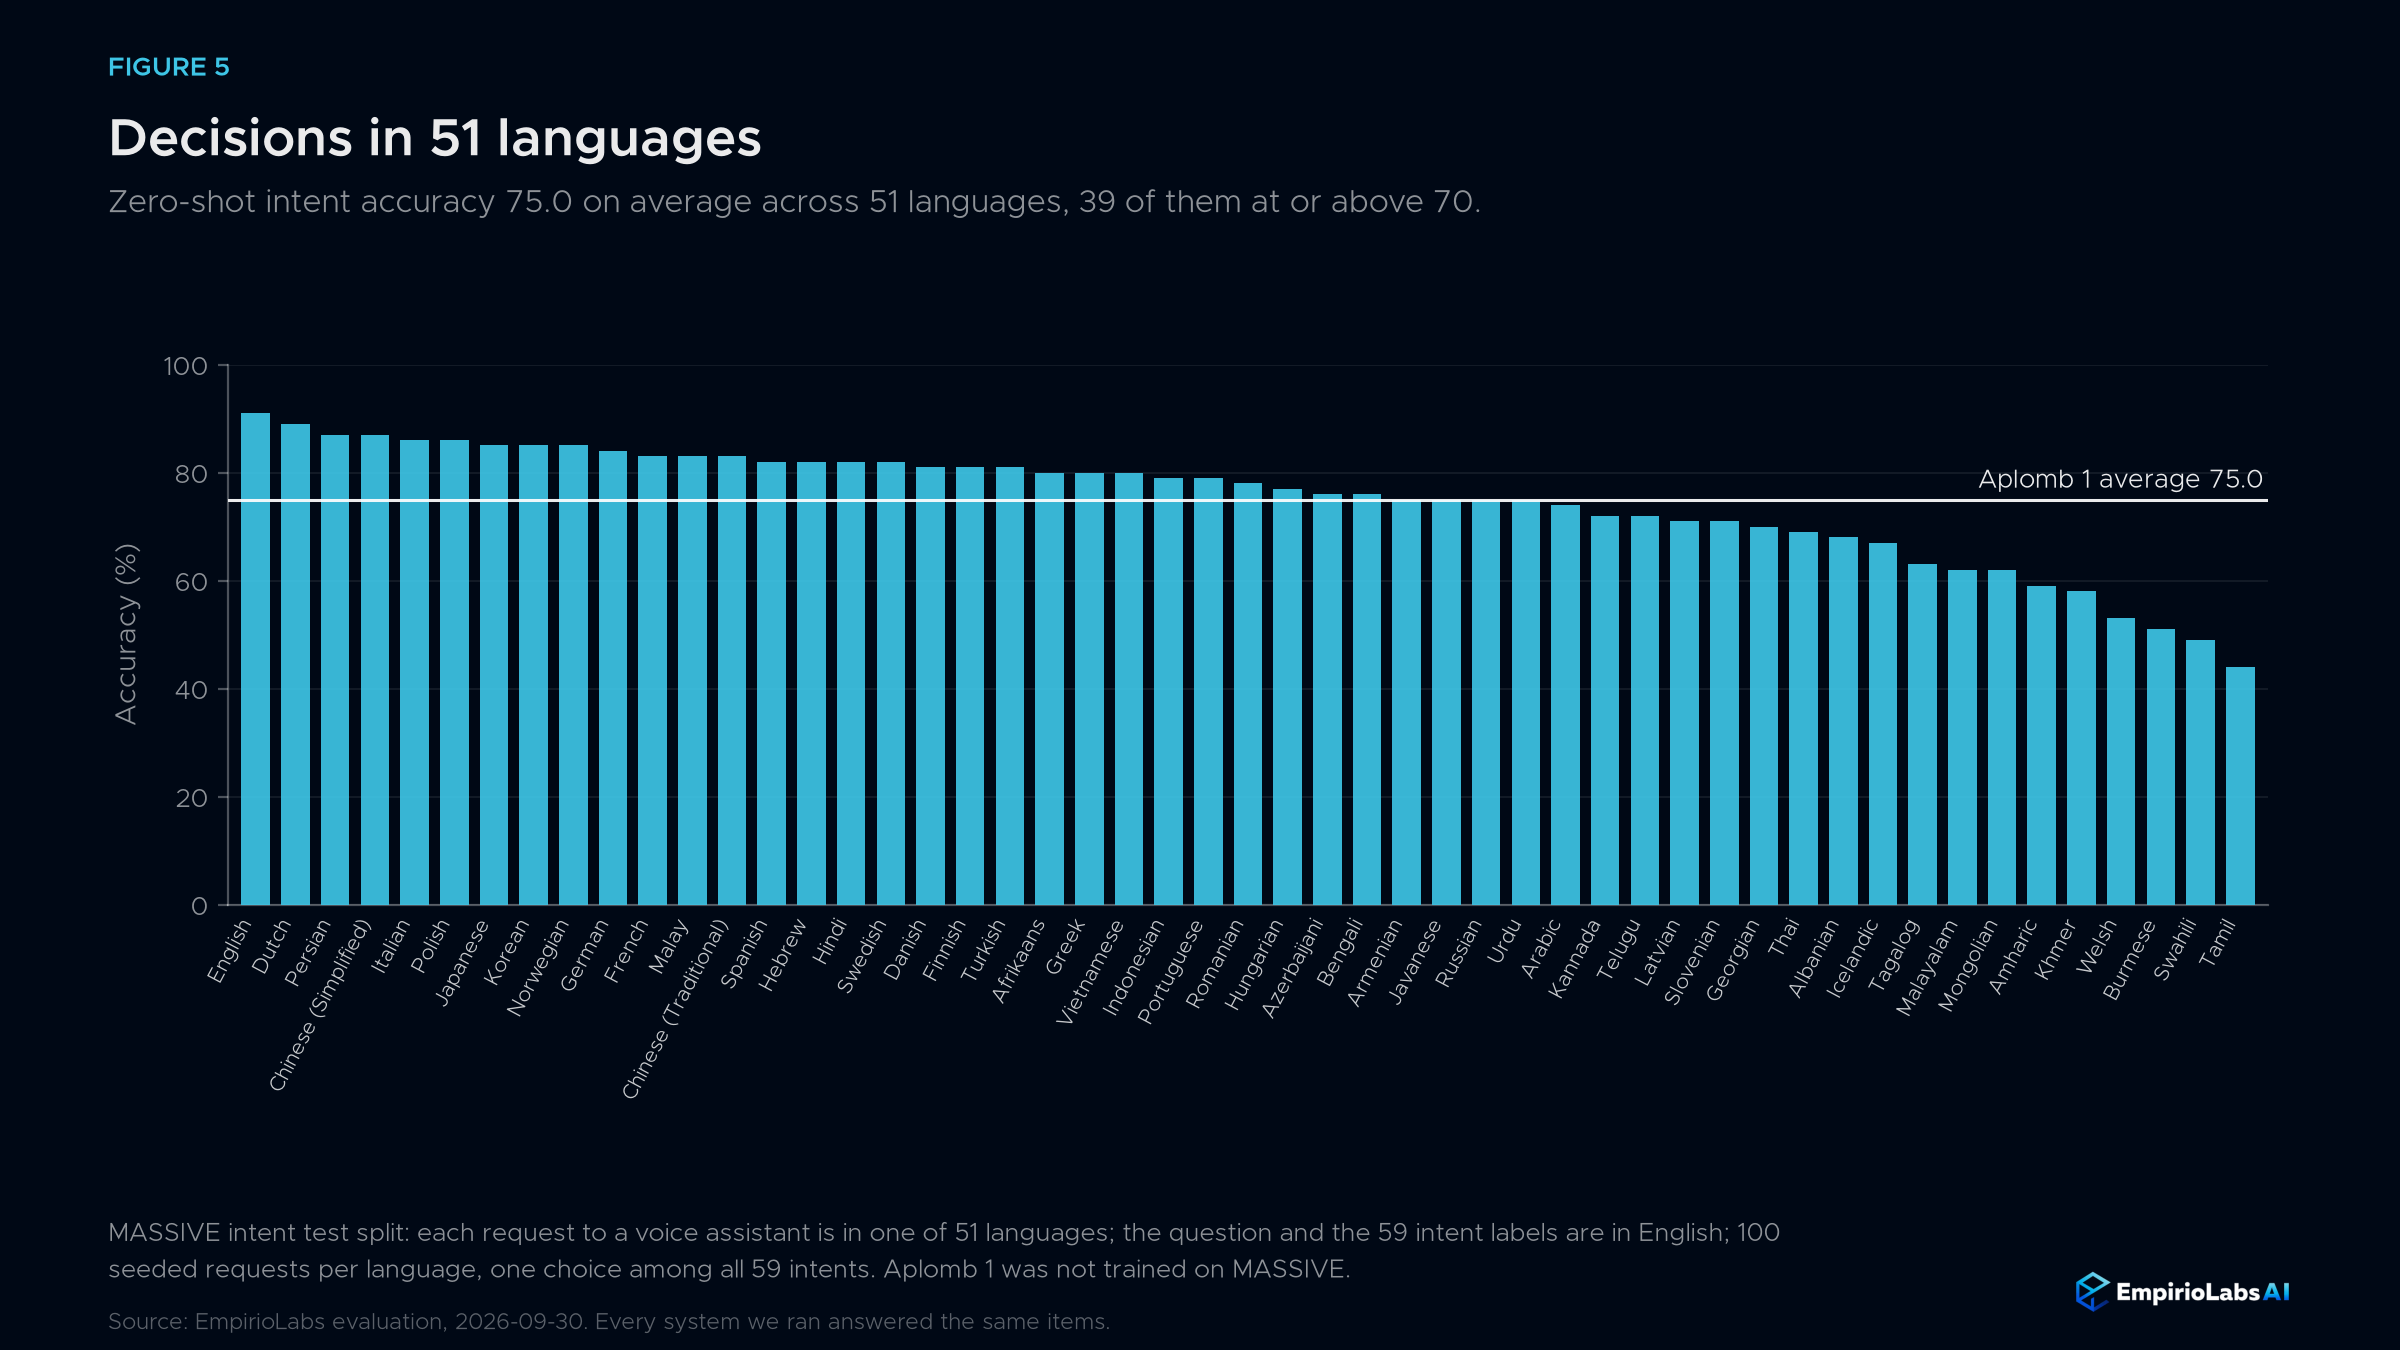
Zum Vergleich: Das Laya-Projekt nennt 40,1 % für sein mehrsprachiges Modell in denselben 51 Sprachen bei der Auswahl aus 20 Absichten, und das JevK5-Projekt 73,8 % auf Englisch mit allen 60 Absichten.
Entscheidungsindex
Decision Index 0.2.1 umfasst im Durchschnitt 38 öffentliche Benchmarks in fünf Bereichen: Wissen und Denken, Sprachverständnis, Abruf und Klassifikation, Werkzeuge und Automatisierung sowie Kunst und menschlichen Geschmack. Jeder Benchmark ist zufallskorrigiert, also steht 0 für zufälliges Raten und 100 für perfekt.
Wir haben das offizielle Kit am 5. Oktober 2026 auf Aplomb 1 laufen lassen, und es hat alle 150.317 wertbaren Anfragen beantwortet. Aplomb 1 erreicht 44,86 Punkte. Dies ist unser eigener Durchlauf des Kits, kein Eintrag auf dem veröffentlichten Board.
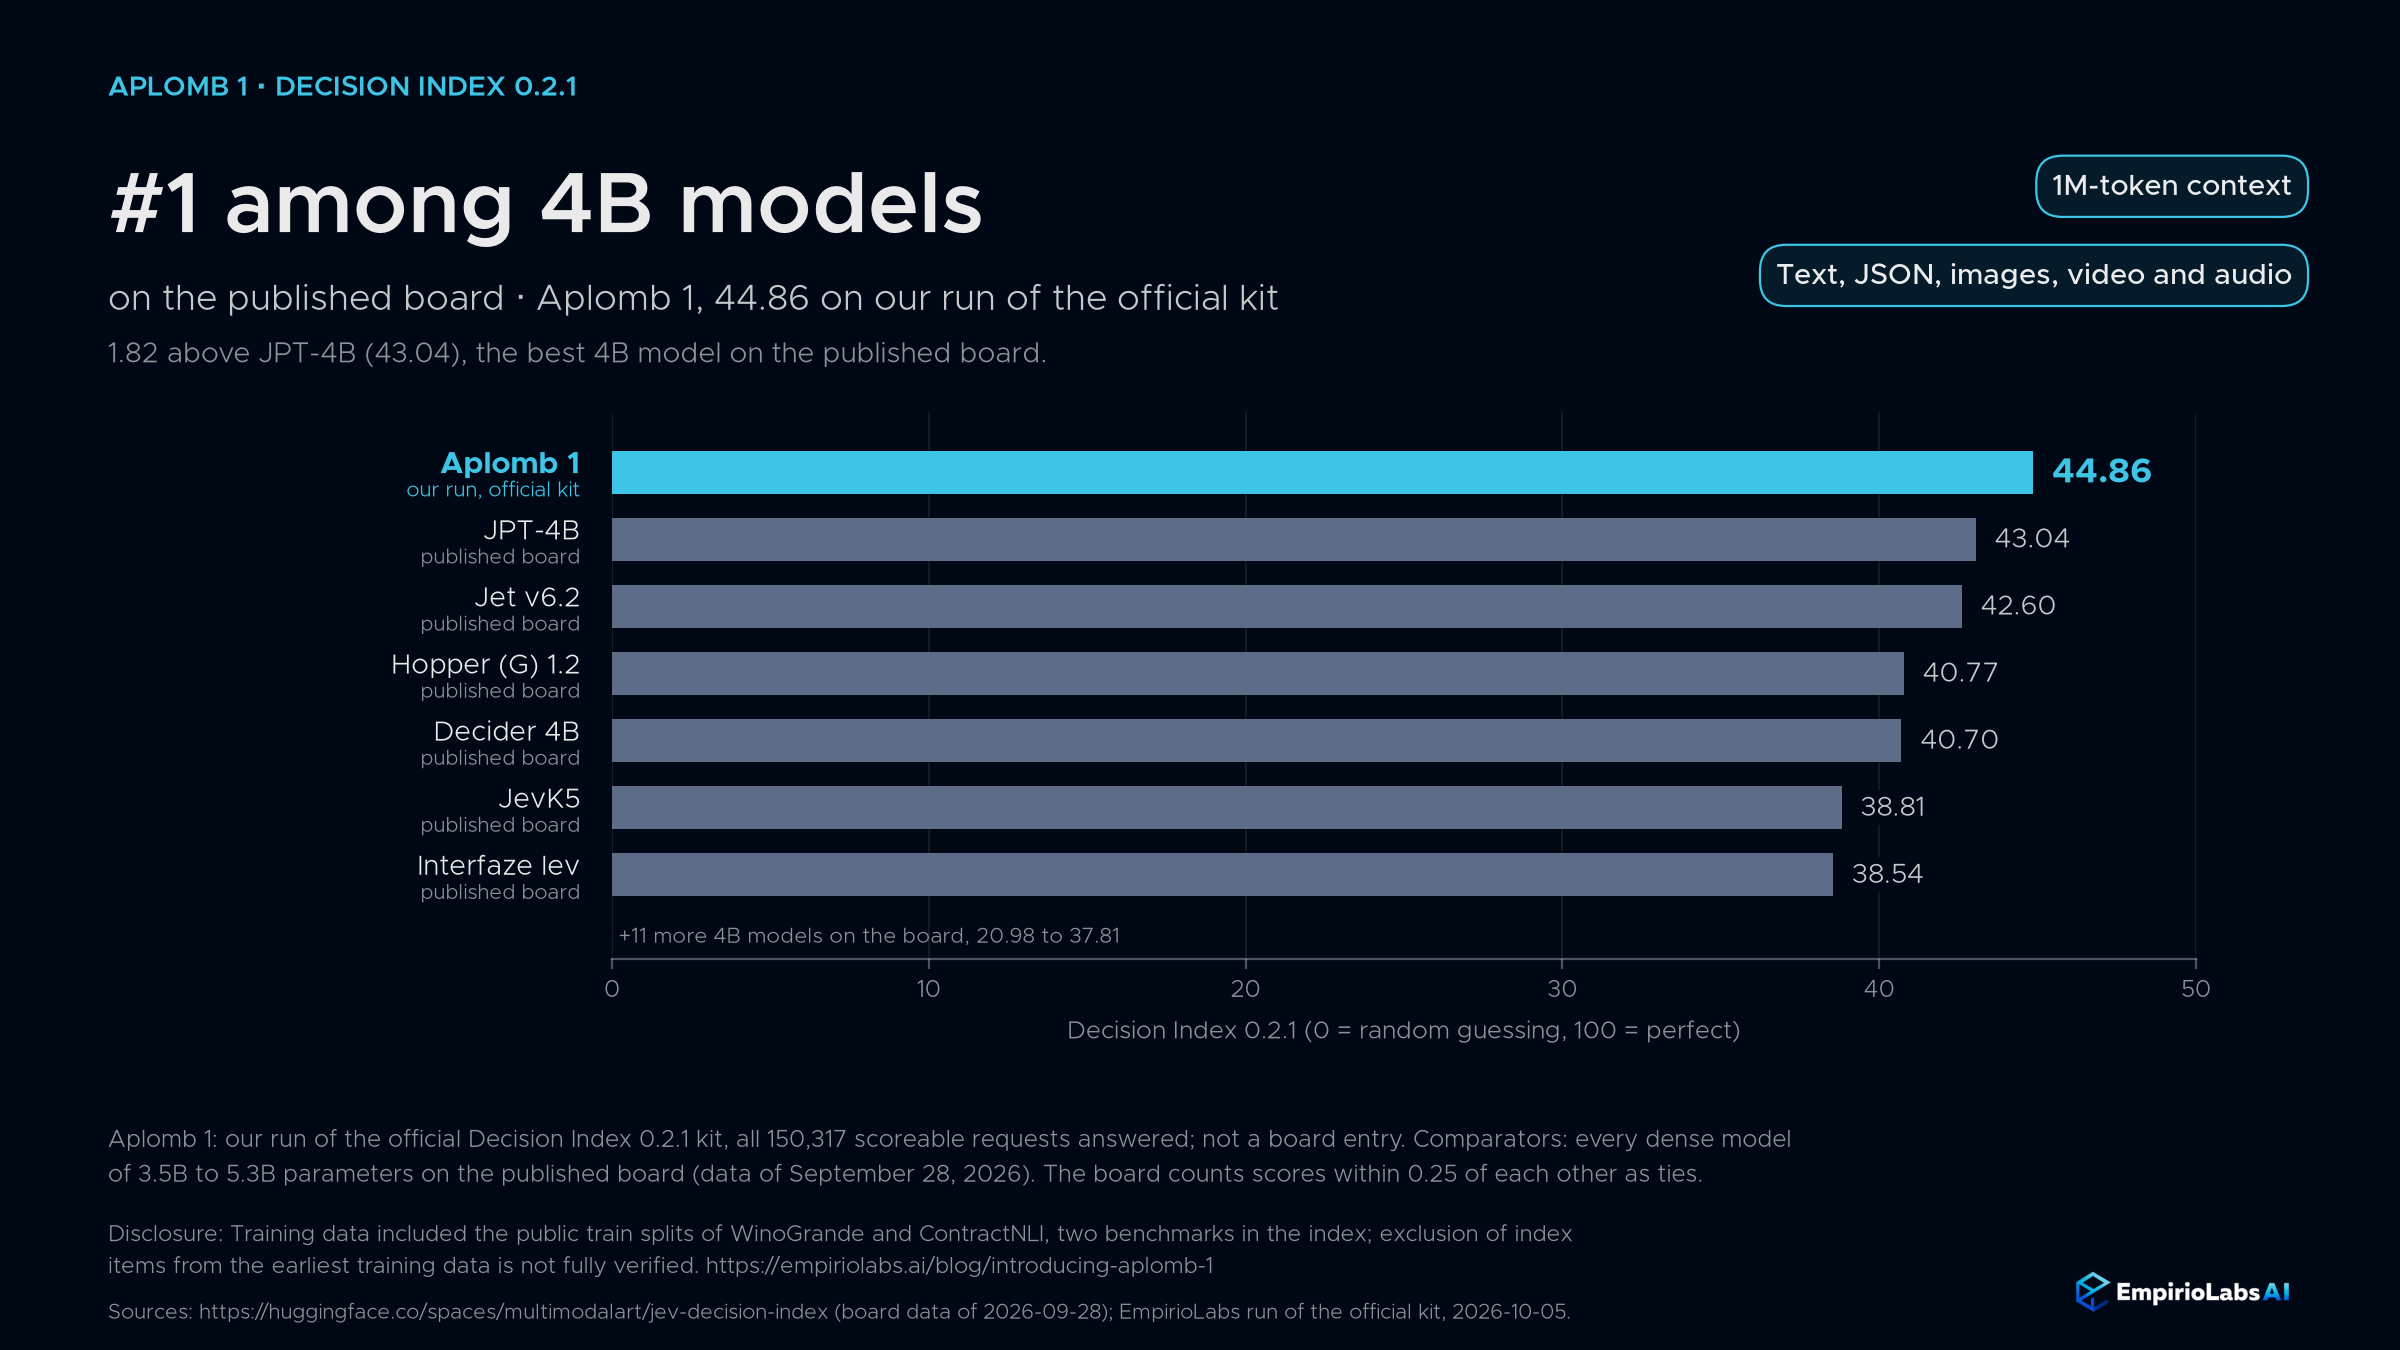
Stand 6. Oktober 2026 ist Aplomb 1 #1 unter den 4B-Modellen auf dem veröffentlichten Board und #1 unter Modellen bis zu 5,3B-Parametern bei 8 der 38 Benchmarks, darunter MMLU-Pro, GPQA Diamond und BBH. Auf dem veröffentlichten Board (Daten vom 28. September 2026) liegt der höchste Wert für ein 4B-Modell bei JPT-4B bei 43,04, 1,82 unter Aplomb 1.
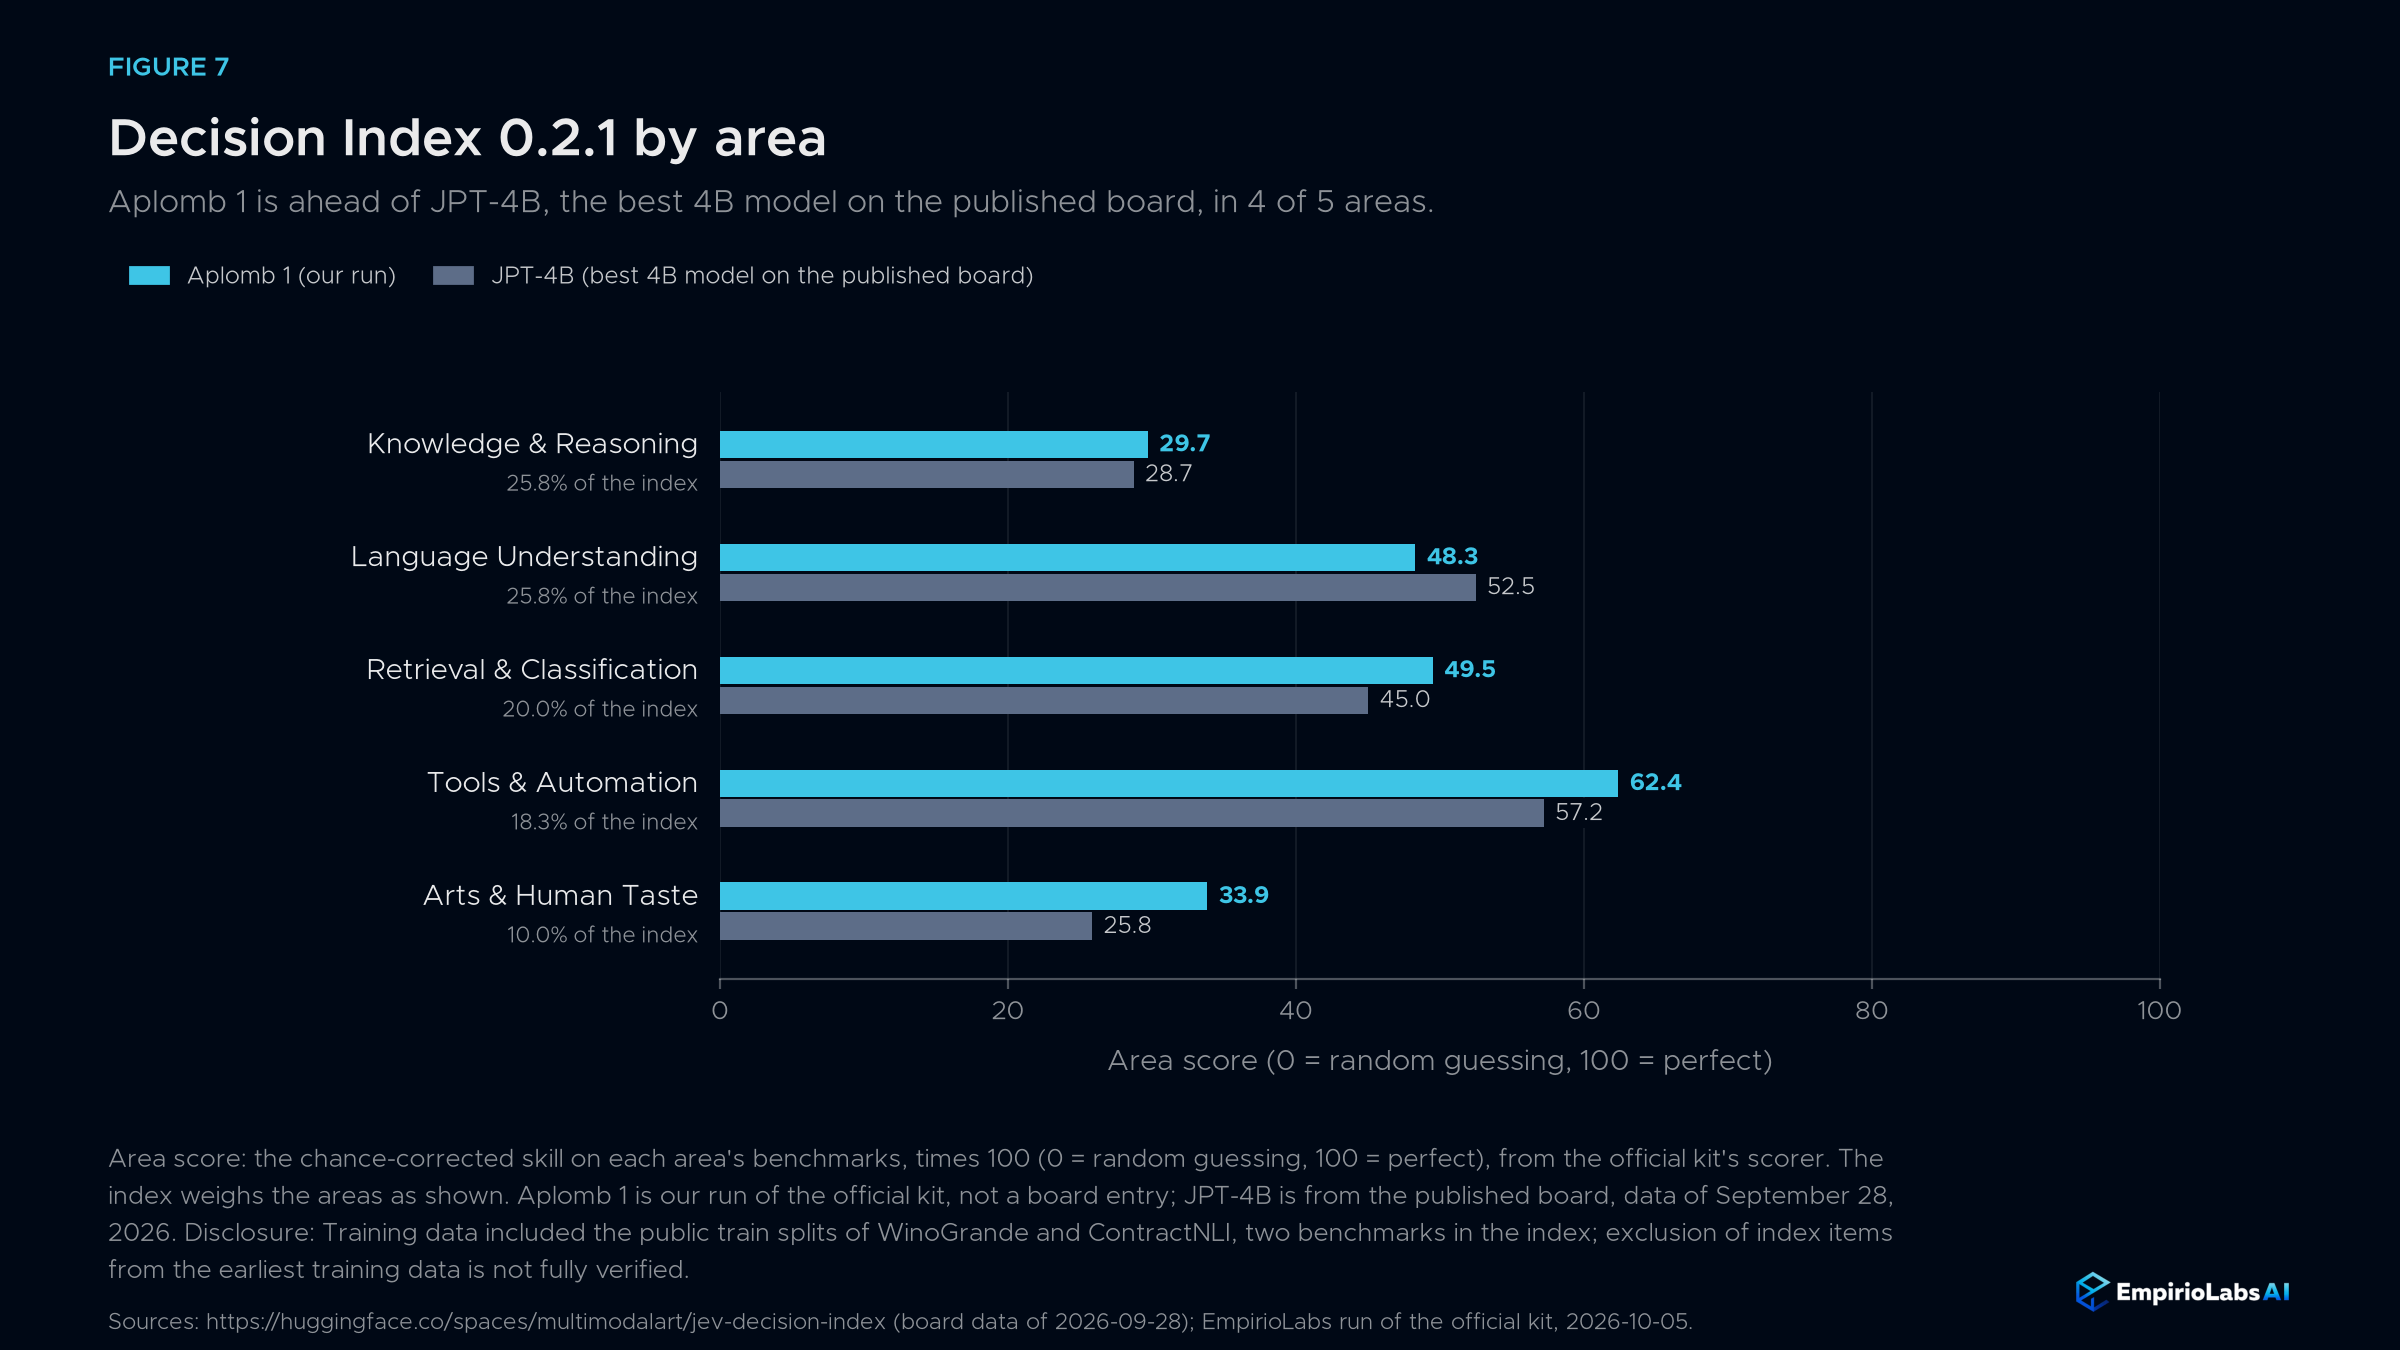
Nach Gebiet erzielt Aplomb 1 die höchsten Werte in Tools und Automatisierung (62,4) sowie bei Abruf und Klassifikation (49,5). Im Vergleich zu JPT-4B liegt es in vier der fünf Bereiche voraus und im Sprachverständnis hinter (48,3 gegenüber 52,5).
Offenlegung. Die Trainingsdaten von Aplomb 1 enthielten die öffentlichen Zugaufteilungen von WinoGrande und ContractNLI, zwei der 38 Benchmarks im Index. Wir konnten nicht vollständig verifizieren, dass Indexelemente aus den frühesten Trainingsdaten ausgeschlossen wurden.
Wie es im Vergleich steht
Was jedes Entscheidungsmodell oder jede API akzeptiert und beantwortet, basierend auf seiner eigenen veröffentlichten Dokumentation vom 29. September 2026, mit Preisen vom 6. Oktober 2026:
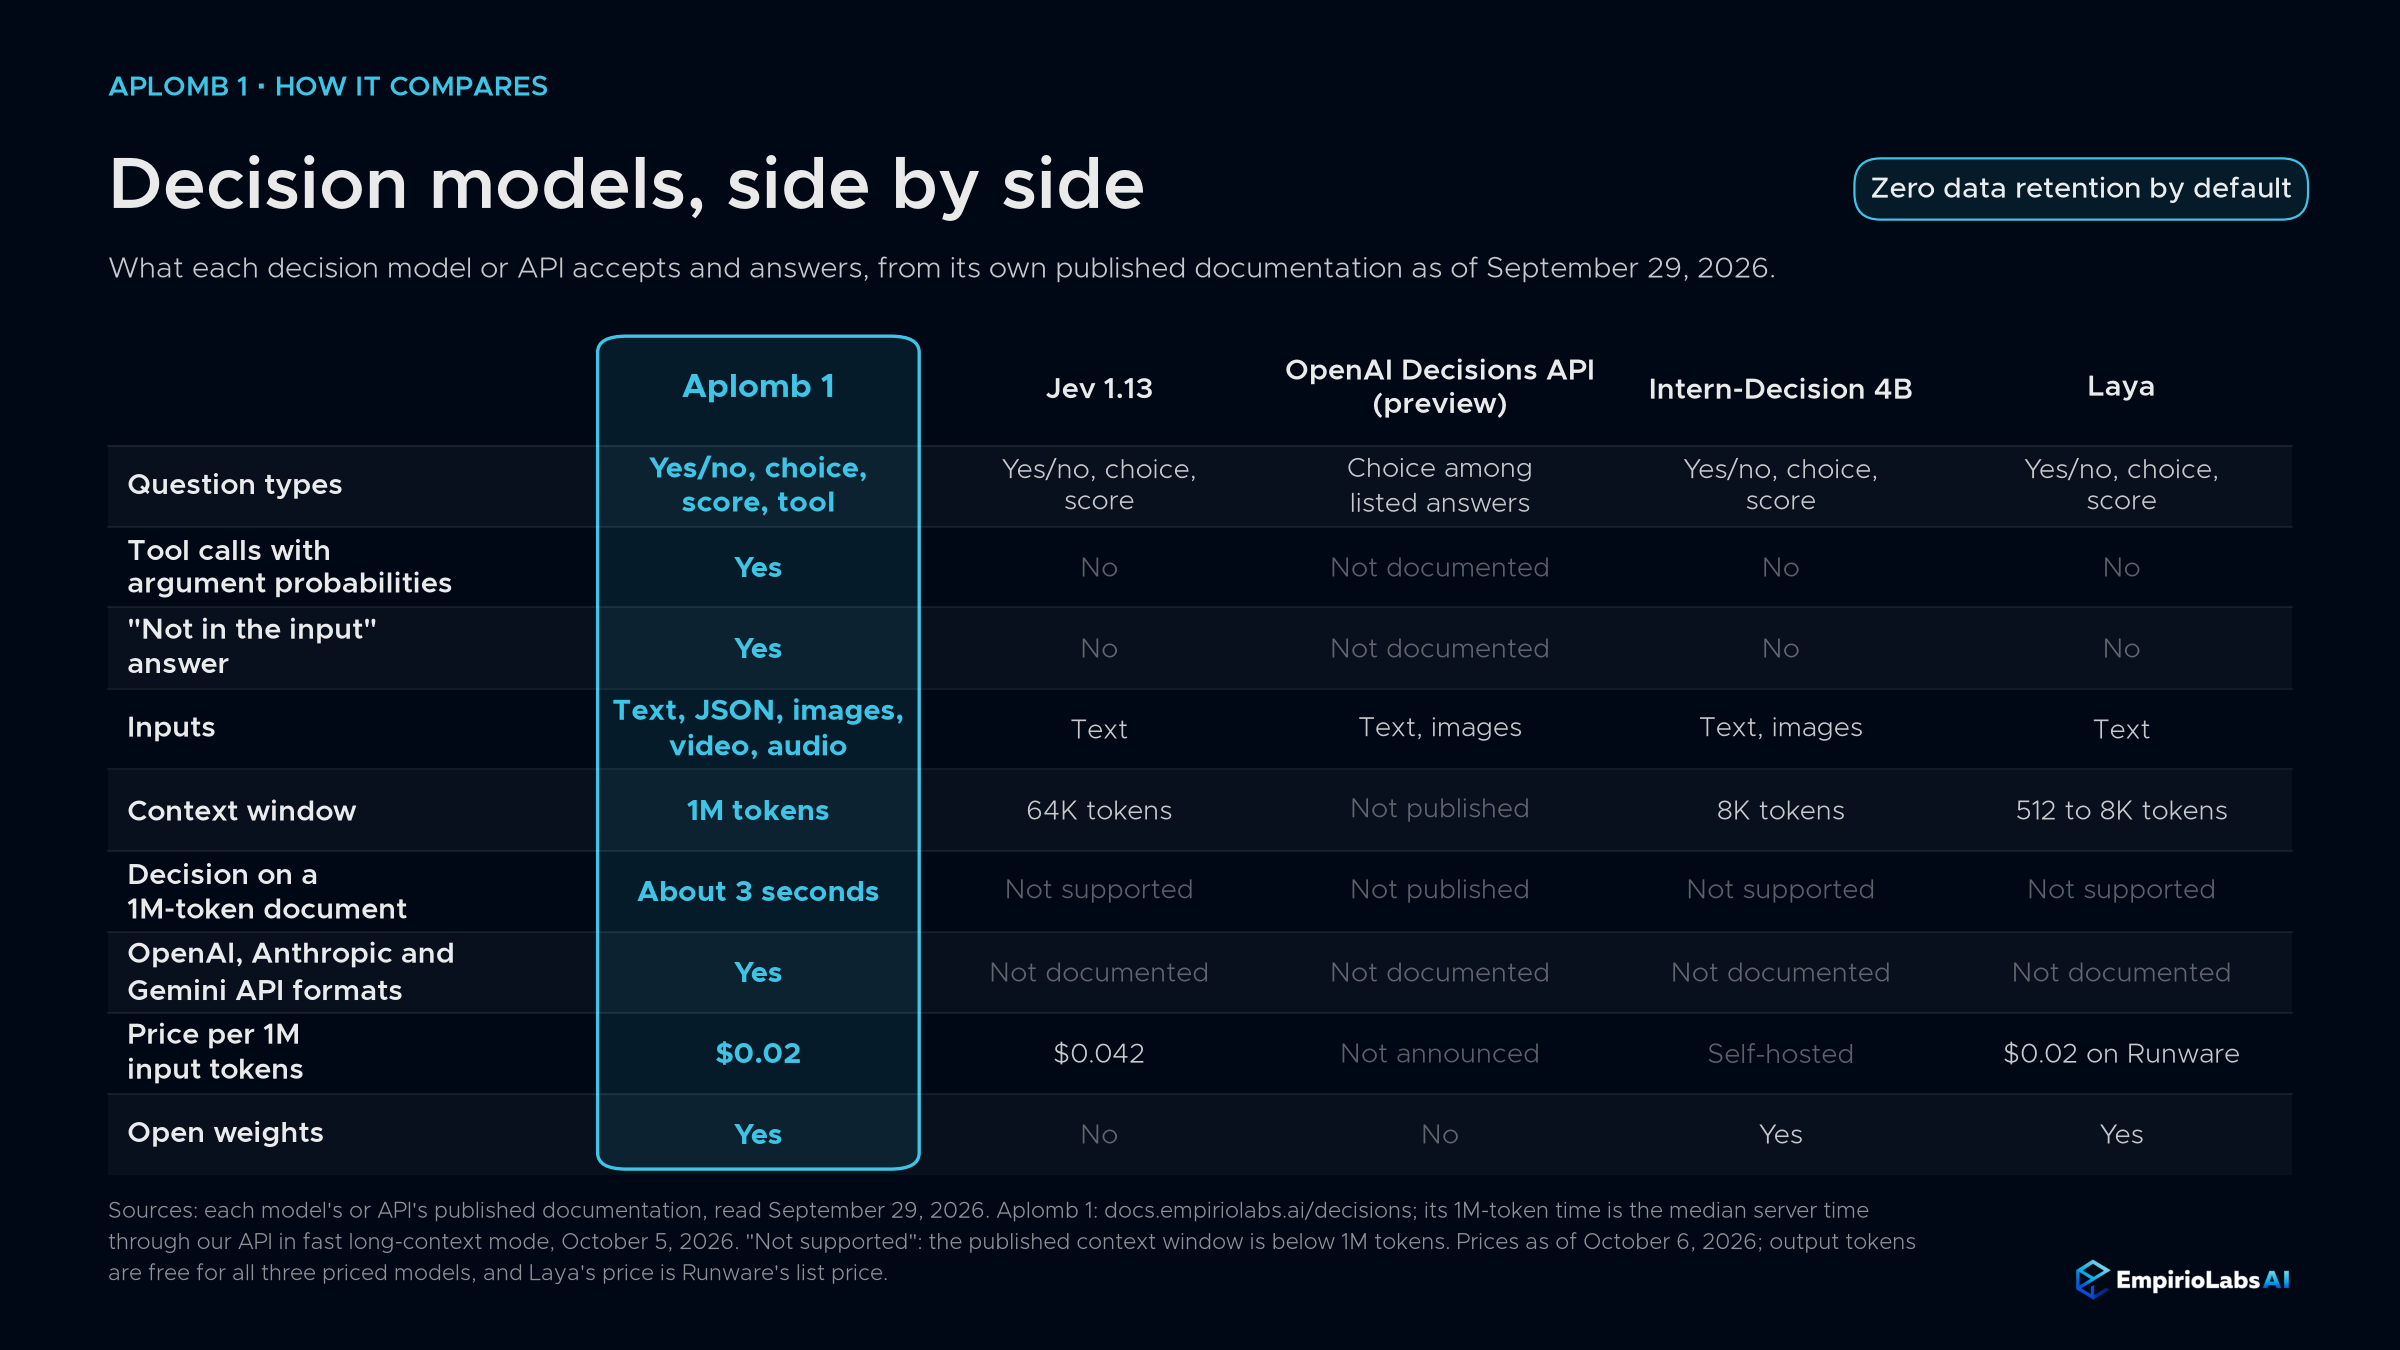
| Aplomb 1 | Jev 1.13 | OpenAI Decisions API (Vorschau) | Intern-Entscheidung 4B | Laya | |
|---|---|---|---|---|---|
| Fragetypen | Ja oder nein, Wahl, Partitur, Werkzeug | Ja oder nein, Wahl, Punktzahl | Auswahl unter den aufgeführten Antworten | Ja oder nein, Wahl, Punktzahl | Ja oder nein, Wahl, Punktzahl |
| Werkzeugauswahl mit Argumentwahrscheinlichkeiten | Ja | Nein | Nicht dokumentiert | Nein | Nein |
| Nicht in der staatlichen Antwort | Ja | Nein | Nicht dokumentiert | Nein | Nein |
| Eingänge | Text, JSON, Bilder, Video, Audio | Text | Text, Bilder | Text, Bilder | Text |
| Fenster | 1.000.000 Token | 64.000 Token | Nicht veröffentlicht | 8.192 Token | 512 zu 8.192 Marken |
| Preis pro 1 Million Eingabetoken | $0.02 | $0.042 | Nicht angekündigt | Selbstgehostet | $0.02 auf Runware |
| Offene Gewichte | Ja | Nein | Nein | Ja | Ja |
Geschwindigkeit und Abrechnung
Aplomb 1 läuft auf EmpirioLabs eigener Inferenzlaufzeit für Entscheidungsmodelle. Eine kurze Frage benötigt etwa 15 ms Modellzeit, eine Frage mit einem Bild von etwa 35 ms, ein 15.000-Token-Dokument etwa 0,3 Sekunden und einen 1M-Token-Zustand etwa 3 Sekunden im schnellen Long-Context-Modus, der Standard liegt über 131.072 Tokens, also etwa 111 Sekunden vollständig gelesen.
Du zahlst nur für Eingabetoken: den Zustand einmal pro Anfrage und den eigenen Text jeder Frage, niemals eine Eingabevorlage. Ausgabetoken sind immer null. Der aktuelle Satz ist auf dem modellblatt und die preisseite.
Standardmäßig ist keine Datenaufbewahrung aktiviert: Wir speichern den Inhalt Ihrer Anfragen oder Antworten nicht.
Offene Gewichte
Aplomb 1 basiert auf Qwen3.5-4B. Wir haben das Fenster von 262K auf 1M Token erweitert, Audio-Eingänge mit dem Audio-Encoder von Qwen3-Omni hinzugefügt, unseren eigenen Entscheidungskopf hinzugefügt, der jede Antwort als kalibrierte Wahrscheinlichkeiten statt generierten Text zurückgibt, und das Modell für Entscheidungen trainiert, einschließlich Werkzeugauswahl und der not-in-the-input Antwort. Für die API und die Playground haben wir unsere eigene Inferenzlaufzeit gebaut und optimiert.
Die Gewichte und ein Referenzskript, um sie selbst zu laufen, sind bei huggingface.co/empiriolabsai/aplomb-1. Die Antworten des Skripts können sich leicht von denen der API unterscheiden.
Forschung, Bewertung, persönliche Nutzung und interne Nutzung durch Organisationen mit einem Jahresumsatz unter US$1 Millionen sind unter der EmpirioLabs Model License kostenlos; das Hosting von Aplomb 1 als Dienstleistung oder der Versand in einem Produkt, das an andere verkauft wird, erfordert eine kommerzielle Lizenz.
Beginn
curl https://api.empiriolabs.ai/v1/decisions \ -H "Autorisierung: Träger $EMPIRIOLABS_API_KEY" \ -H "Inhalt-Typ: application/json" \ -d '{ "model": "aplomb-1", "state": {"order": {"id": "B-44120", "status": "shipped", "payment": "unpaid"}}, "questions": { "paid": {"type": "noul", "instructions": "Wurde Befehl B-44120 bezahlt?", "abstain": true}, "carrier": {"type": "choice", "instructions": "welcher Carrier liefert Befehl B-44120?", "criteria": {"ups": null, "fedex": null, "dhl": null}, "abstain": true} } }Bezahlt Es kommt als ein selbstbewusstes Nein zurück. Träger kommt mit einem High zurück Enthaltung Wahrscheinlichkeit, weil der Datensatz keinen Träger nennt. Das vollständige Schema, der Medieneingang und die Grenzwerte sind in der Decisions-API-Leitfaden. Aplomb 1 akzeptiert außerdem Anfragen in den Formaten OpenAI, Anthropic und Gemini, sodass man es aus deren SDKs aufrufen kann; die des Leitfadens Chat-Formate Abschnitt zeigt, wie eine Chat-Anfrage auf eine Entscheidung zugeordnet wird. Versuche es ohne Code in der Spielplatz.
Danksagungen
Wir haben Aplomb 1 mit Hilfe unseres KI-Agenten-Harnesss über Daten, Training, Evaluation und Bereitstellung entwickelt. Danke an das Qwen-Team für Qwen3.5 und Qwen3-Omni, auf denen Aplomb 1 aufbaut, an Lambda für die GPUs, die wir trainiert und auf denen wir es einsetzen, sowie an das NVIDIA Inception-Programm, das Z.ai-Startup-Programm und das StepFun-Startup-Programm für ihre Unterstützung.