Aplomb 1 هو أول نموذج لدينا. يأخذ النصوص، وJSON، والصور، والصوت، والفيديو في طلب واحد، ويقرأ حتى 1M رمز، ويتخذ قرارا بشأن مستند بقيمة 1M في حوالي 3 ثوان. يستغرق السؤال القصير حوالي 15 مللي ثانية من وقت النموذج.
يعمل على وقت تشغيل استنتاجي أنشأناه لنماذج القرار. في واجهة برمجة التطبيقات لدينا وفي Playground، تمر المستندات الطويلة بوضع السياق الطويل السريع: مستند برمز 1M يستغرق حوالي 3 ثوان بدلا من 111 ثوان، والوضع السريع يجيب على جميع القرارات ال525 في اختبارات السياق الطويل بشكل صحيح.
بالنسبة للوكلاء، يعيد Aplomb 1 احتمالا لكل أداة ولكل عدد ووسيطة بولينية في طلب واحد، لذا يتصرف الوكيل عندما يكون النموذج متأكدا ويتصاعد عندما لا يكون كذلك. كل إجابة معايرة، ويمكنها أن تقول متى لا يحمل المدخل الإجابة بدلا من التخمين. تم تصميمه للقرارات التي يتخذها البرمجيات آلاف المرات يوميا، من توجيه تذكرة إلى اختيار أداة الوكيل التالية.
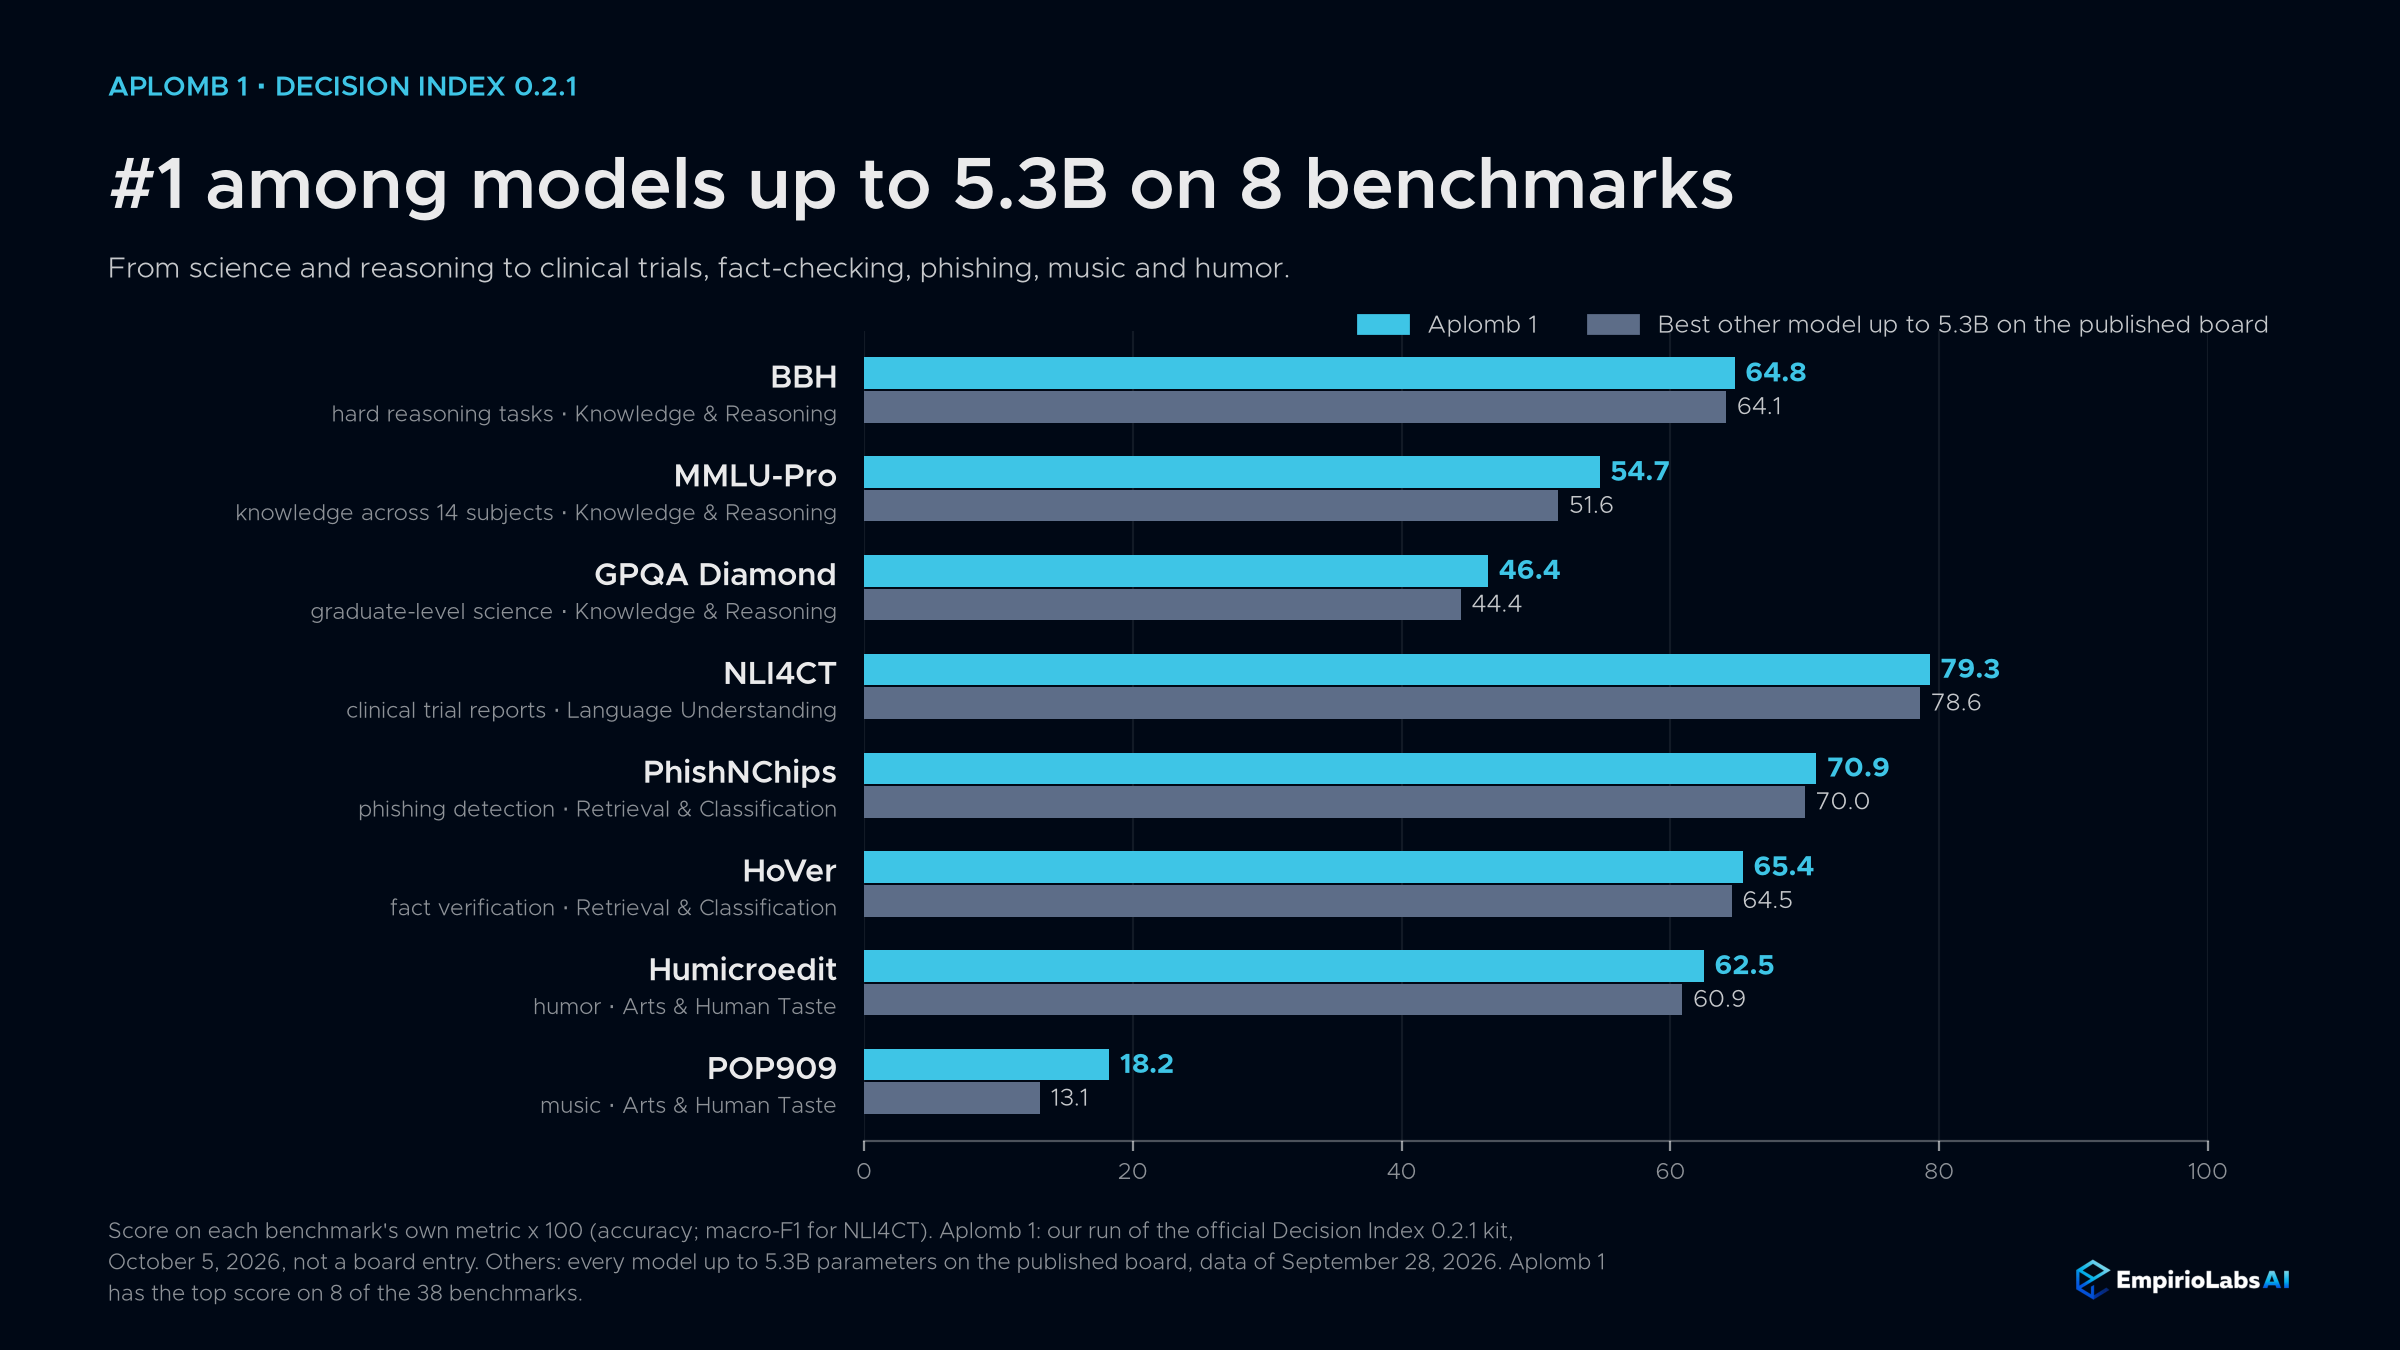
اعتبارا من 6 أكتوبر 2026، هو #1 بين 4B نموذج في لوحة مؤشر القرار المنشور، مع 44.86 في مجموعتنا الرسمية، و#1 بين النماذج التي تصل إلى 5.3 مليار معلمة في 8 من أصل 38 معيار. يتوفر اليوم في واجهة برمجة التطبيقات EmpirioLabs وPlayground، وأوزنه موجود على Hugging Face بموجب ترخيص نموذج EmpirioLabs.
| الثقة 1 من نظرة سريعة | |
|---|---|
| المدخلات | النص، JSON، الصور، الفيديو والصوت، بأي مزيج |
| النافذة | مليون رمز حالة بالإضافة إلى سؤال |
| أسئلة | نعم أو لا، اختيار (من 2 إلى 255 خيار)، الدرجة (من 2 إلى 10 مستويات)، اختيار الأدوات |
| ليس في الولاية | احتمال أن المدخل لا يحمل الإجابة |
| اختيار الأدوات | الأداة التالية التي يجب استدعاؤها، مع احتمالات لحججها الenum والبوليان |
| السرعة | حوالي 15 مللي ثانية من وقت النموذج لسؤال قصير؛ حوالي 3 ثوان لمستند برمز 1M في وضع السياق الطويل السريع |
| تنسيقات واجهات برمجة التطبيقات (API) | واجهة برمجة التطبيقات للقرارات، بالإضافة إلى صيغ OpenAI وAnthropic وGemini |
| التصنيف | رموز الإدخال فقط؛ رموز الإخراج دائما صفرية |
| الاحتفاظ بالبيانات | عدم وجود أي احتفاظ بالبيانات بشكل افتراضي |
| الحجم | 5.3 مليار معلمة، مبنية على Qwen3.5-4B؛ الأوزان المفتوحة على Hugging Face |
| مؤشر القرار 0.2.1 | 44.86 في مجموعتنا الرسمية، #1 بين نماذج 4B في اللوحة المنشورة حتى 6 أكتوبر 2026 |
ما الذي يجيب عليه
أربعة أنواع أسئلة. نول الإجابة بنعم أو لا باحتمال نعم. الاختيار يختار أحد الخيارات من 2 إلى 255 ويعيد التوزيع الكامل. الموسيقى التصويرية تضع الولاية على مقياس منظم من 2 إلى 10 مستويات. الأداة يختار أي من أدوات الدوال التي يجب استدعاؤها ويعيد التوزيعات عبر حججها الenum ومنطقه.
ليس في الولاية. إضافة "الامتناع": صحيح بالنسبة للسؤال، والإجابة تحمل أيضا احتمال أن الدولة لا تحتوي على ما يحتاجه السؤال. السجل الذي لا يحتوي على حقل حامل يحصل على احتمال امتناع عالي بدلا من تخمين واثق.
إجابات مستقلة. ما يصل إلى 128 سؤالا يشترك في حالة واحدة، وكل سؤال يجاب عليه بمفرده، لذا إضافة سؤال لا يغير إجابة أخرى.
اختيار الأدوات للوكلاء
أعط Aplomb 1 أدوات وظيفة الوكيل والحالة الحالية (تذكرة، محادثة، سجل)، وستعيد الأداة التي تتصل بها بعد ذلك مع احتمال لكل أداة وتوزيع لكل وسيط عدد ومنطق، في طلب واحد. نموذج اللغة الكبير العام يكتب أداة تستدعي رمزا برمز ولا تذكر مدى تأكدها من الأداة أو أي وسيط. الوكيل يتصرف عندما يكون الاحتمالية مرتفعا ويمنح الخطوة لنموذج أكبر عندما لا يكون كذلك، لذا الخطوات الروتينية تتجاوز الإجابة المولدة. لم نجد أي نموذج قرار آخر يعيد احتمالات الحجة.
تذكرة مكتوب عليها "وصل الطلب B-44120 مع شاشة متشققة. أريد استرداد أموالي." مع ثلاث أدوات، issue_refund (أ السبب enum و a full_refund بوليان)، track_package و escalate_to_human، يعود كما يلي (مختصر، مستدير):
{"tool": "issue_refund", "احتمالات": {"issue_refund": 0.969, "لا شيء": 0.025, "escalate_to_human": 0.005, "track_package": 0.002}, "حجج": {"issue_refund": { "سبب": {"قيمة": "تالفة", "احتمالات": {"تالفة": 0.993, "not_as_described": 0.007، "متأخرة": 0.001}}, "full_refund": {"قيمة": صحيح، "probability_true": 0.761}}}, "open_arguments": {"track_package": ["order_id"]}}
الحجج الحرة، مثل معرف الترتيب، مدرجة تحت open_arguments ليملأها الوكيل.
مدخلات مختلطة، حتى 1 مليون رمز
النص، كائنات JSON، والمصفوفات والصور، والفيديو، والصوت تدخل في نفس الحالة بأي تركيبة: تسجيل مكالمة دعم بجانب سجل الحساب، مقطع كاميرا بجانب نموذج المطالبة، صورة المنتج بجانب القائمة. الحالة بالإضافة إلى أطول سؤال يمكن أن يصل إلى 1,000,000 رمز، وهو ما يكفي لحزمة عقد طويلة، أو سنة من التذاكر أو ساعات من النصوص في طلب واحد.
كيف يسجل النتيجة
أجرينا Aplomb 1 وثلاثة نماذج قرار مفتوحة من 4B على نفس العناصر، وضبطنا الأرقام التي نشرها Intern-Decision ل Jev وJevK5 وSemIf بجانبها. في تقارير قرار المتدربين المكونة من سبع أجنحة، يبلغ متوسط Aplomb 1 88.7٪. مقارنة بخلاف Jev المنشور، يتصدر JevBench Hard وTyped Decisions، ويتفوق على JevBench Easy، ومتأخرا عن JevBench Original، ToolACE، AG News وWildJailbreak. أكبر تقدم له هو على JevBench Hard، +5.4 نقطة.
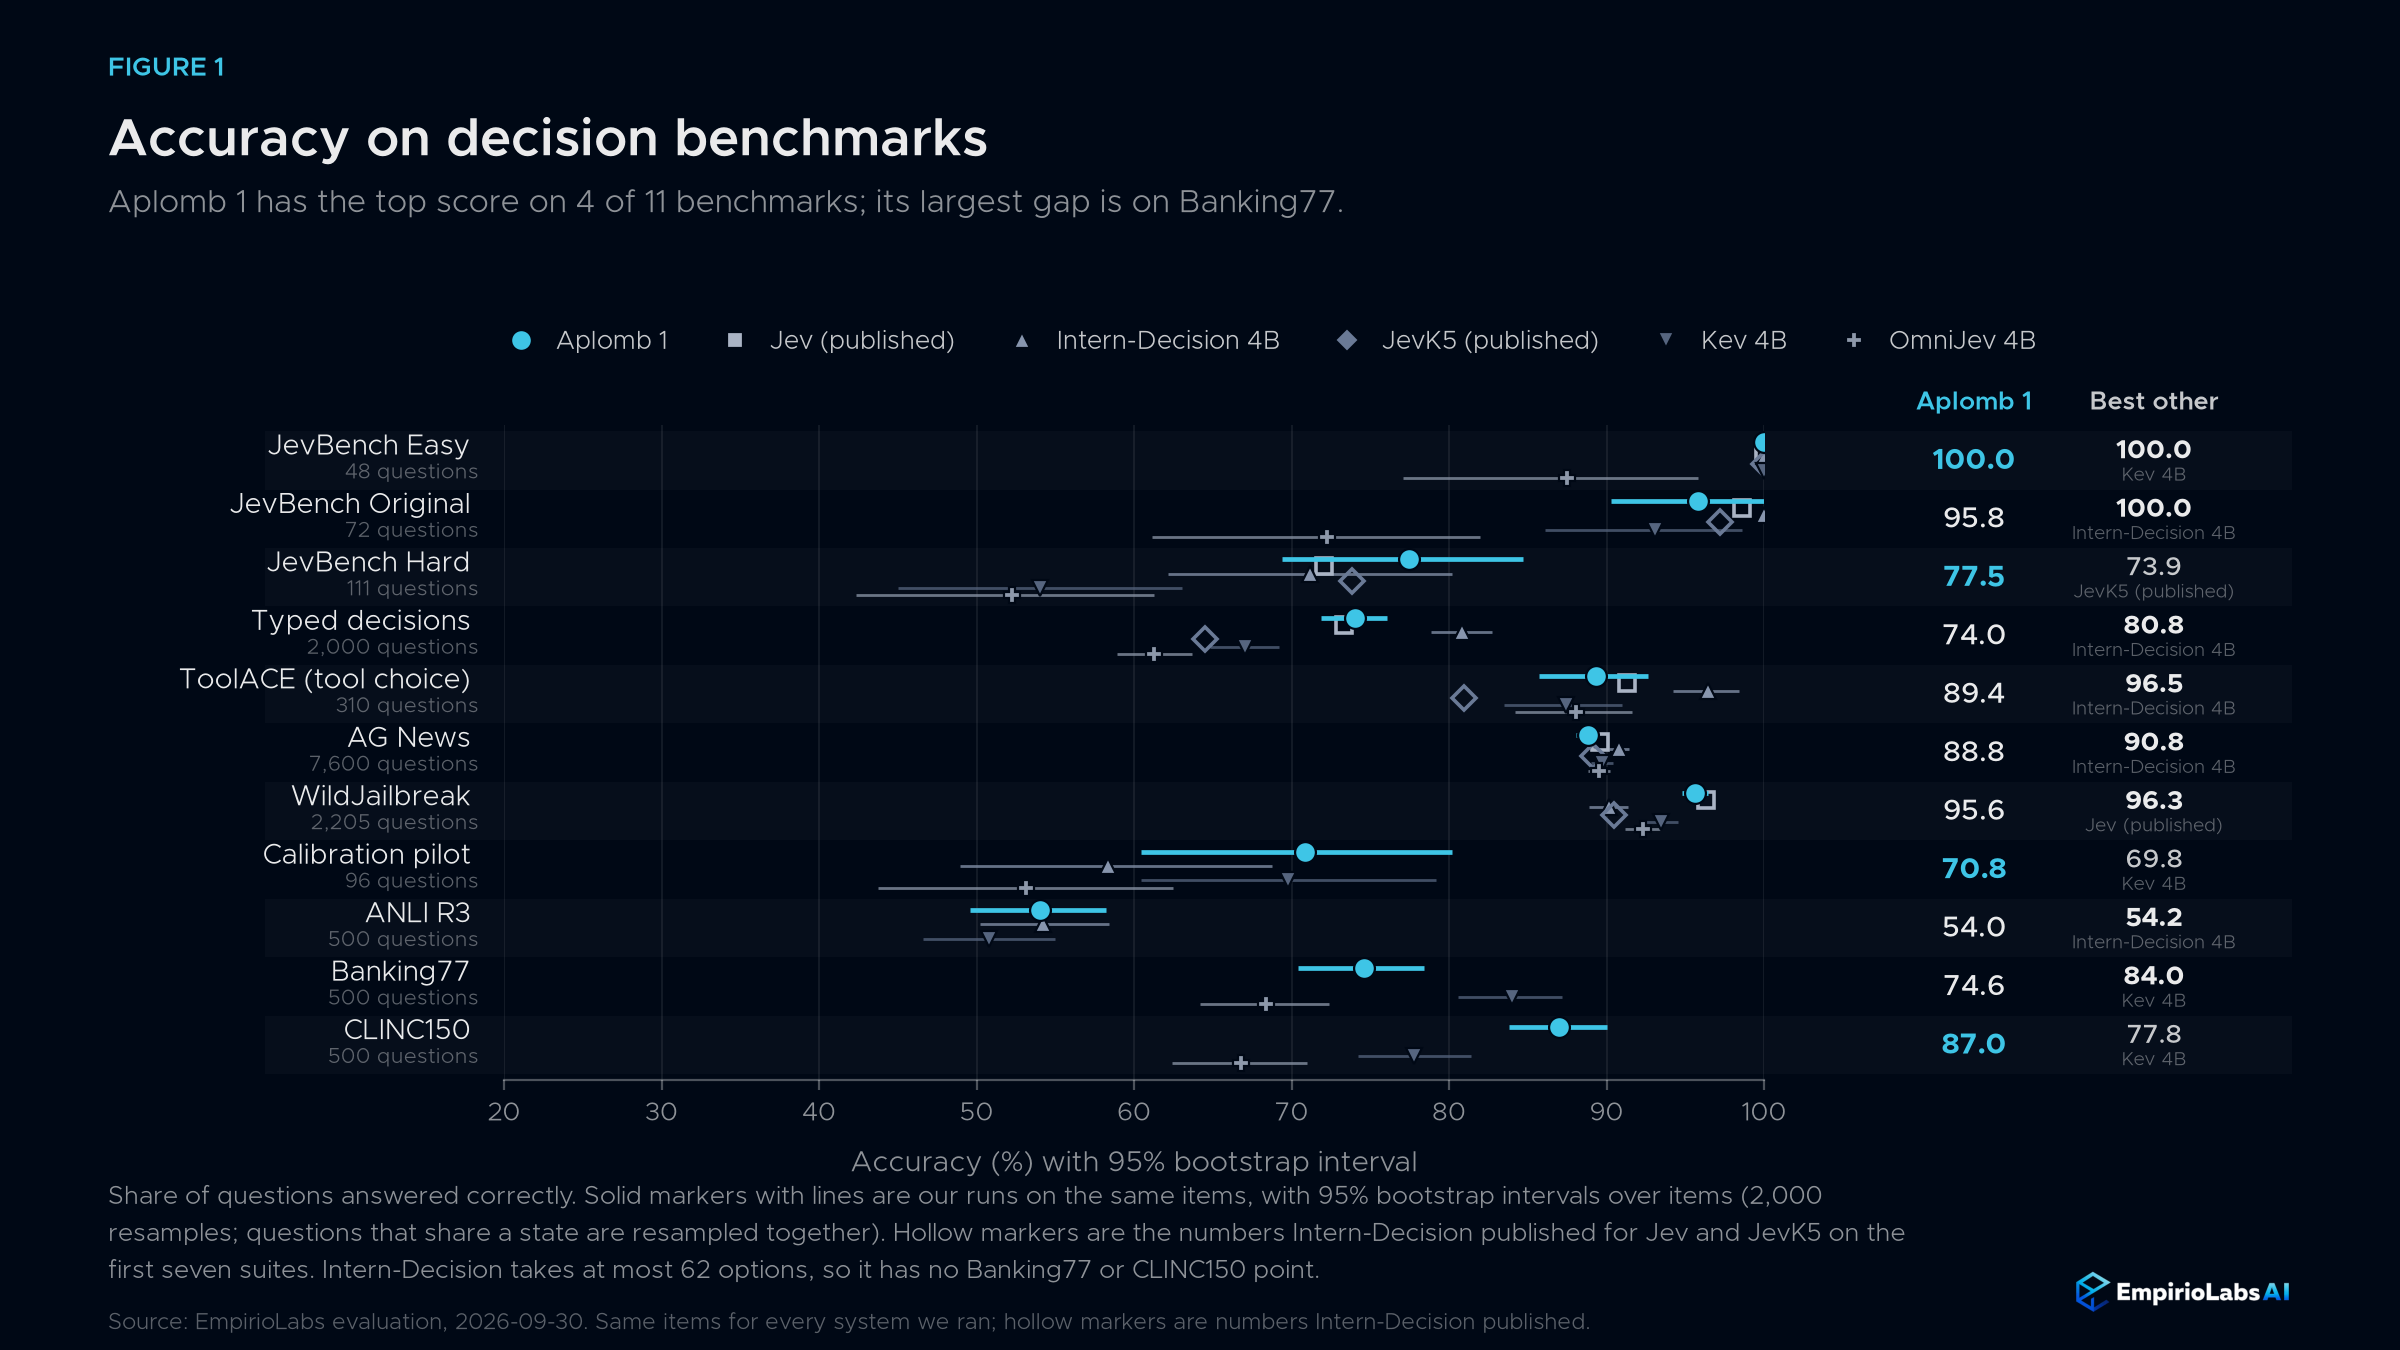
| المعيار | ثقة 1 | جيف (ب) | JevK5 (p) | سيميف (p) | المتدرب - قرار 4B | كيف 4B | أومني جيف 4B |
|---|---|---|---|---|---|---|---|
| جيبنش إيزي | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 100.0 | 87.5 |
| جيفبنش الأصلي | 95.8 | 98.6 | 97.2 | 98.6 | 100.0 | 93.1 | 72.2 |
| جيفبنش هارد | 77.5 | 72.1 | 73.9 | 61.3 | 71.2 | 54.1 | 52.3 |
| قرارات مكتوبة | 74.0 | 73.3 | 64.5 | 62.8 | 80.8 | 67.0 | 61.3 |
| تول إيس | 89.4 | 91.3 | 81.0 | 85.2 | 96.5 | 87.4 | 88.1 |
| أخبار AG | 88.8 | 89.6 | 89.1 | 89.2 | 90.8 | 89.7 | 89.6 |
| وايلد جيلبريك | 95.6 | 96.3 | 90.5 | 92.5 | 90.2 | 93.5 | 92.3 |
| المتوسط | 88.7 | 88.7 | 85.2 | 84.2 | 89.9 | 83.5 | 77.6 |
(p) كما نشرته Intern-Decision لنفس العناصر. تقرير Intern-Decision يبلغ 90.02 لنموذج 4B على هذه الحزمة؛ العمود يوضح فترة الجري.
| المعيار | ثقة 1 | المتدرب - قرار 4B | كيف 4B | أومني جيف 4B |
|---|---|---|---|---|
| طيار المعايرة | 70.8 | 58.3 | 69.8 | 53.1 |
| ANLI R3 | 54.0 | 54.2 | 50.8 | n/a |
| Banking77 (77 خيارا) | 74.6 | n/a | 84.0 | 68.4 |
| CLINC150 (150 خيارا) | 87.0 | n/a | 77.8 | 66.8 |
المدخلات الطويلة
قمنا بقياس عمليات البحث في دفاتر الأوامر من 16 ألف إلى 1 مليون رمز، مع وضع الأسئلة حول أمر واحد على عمق عشوائي.
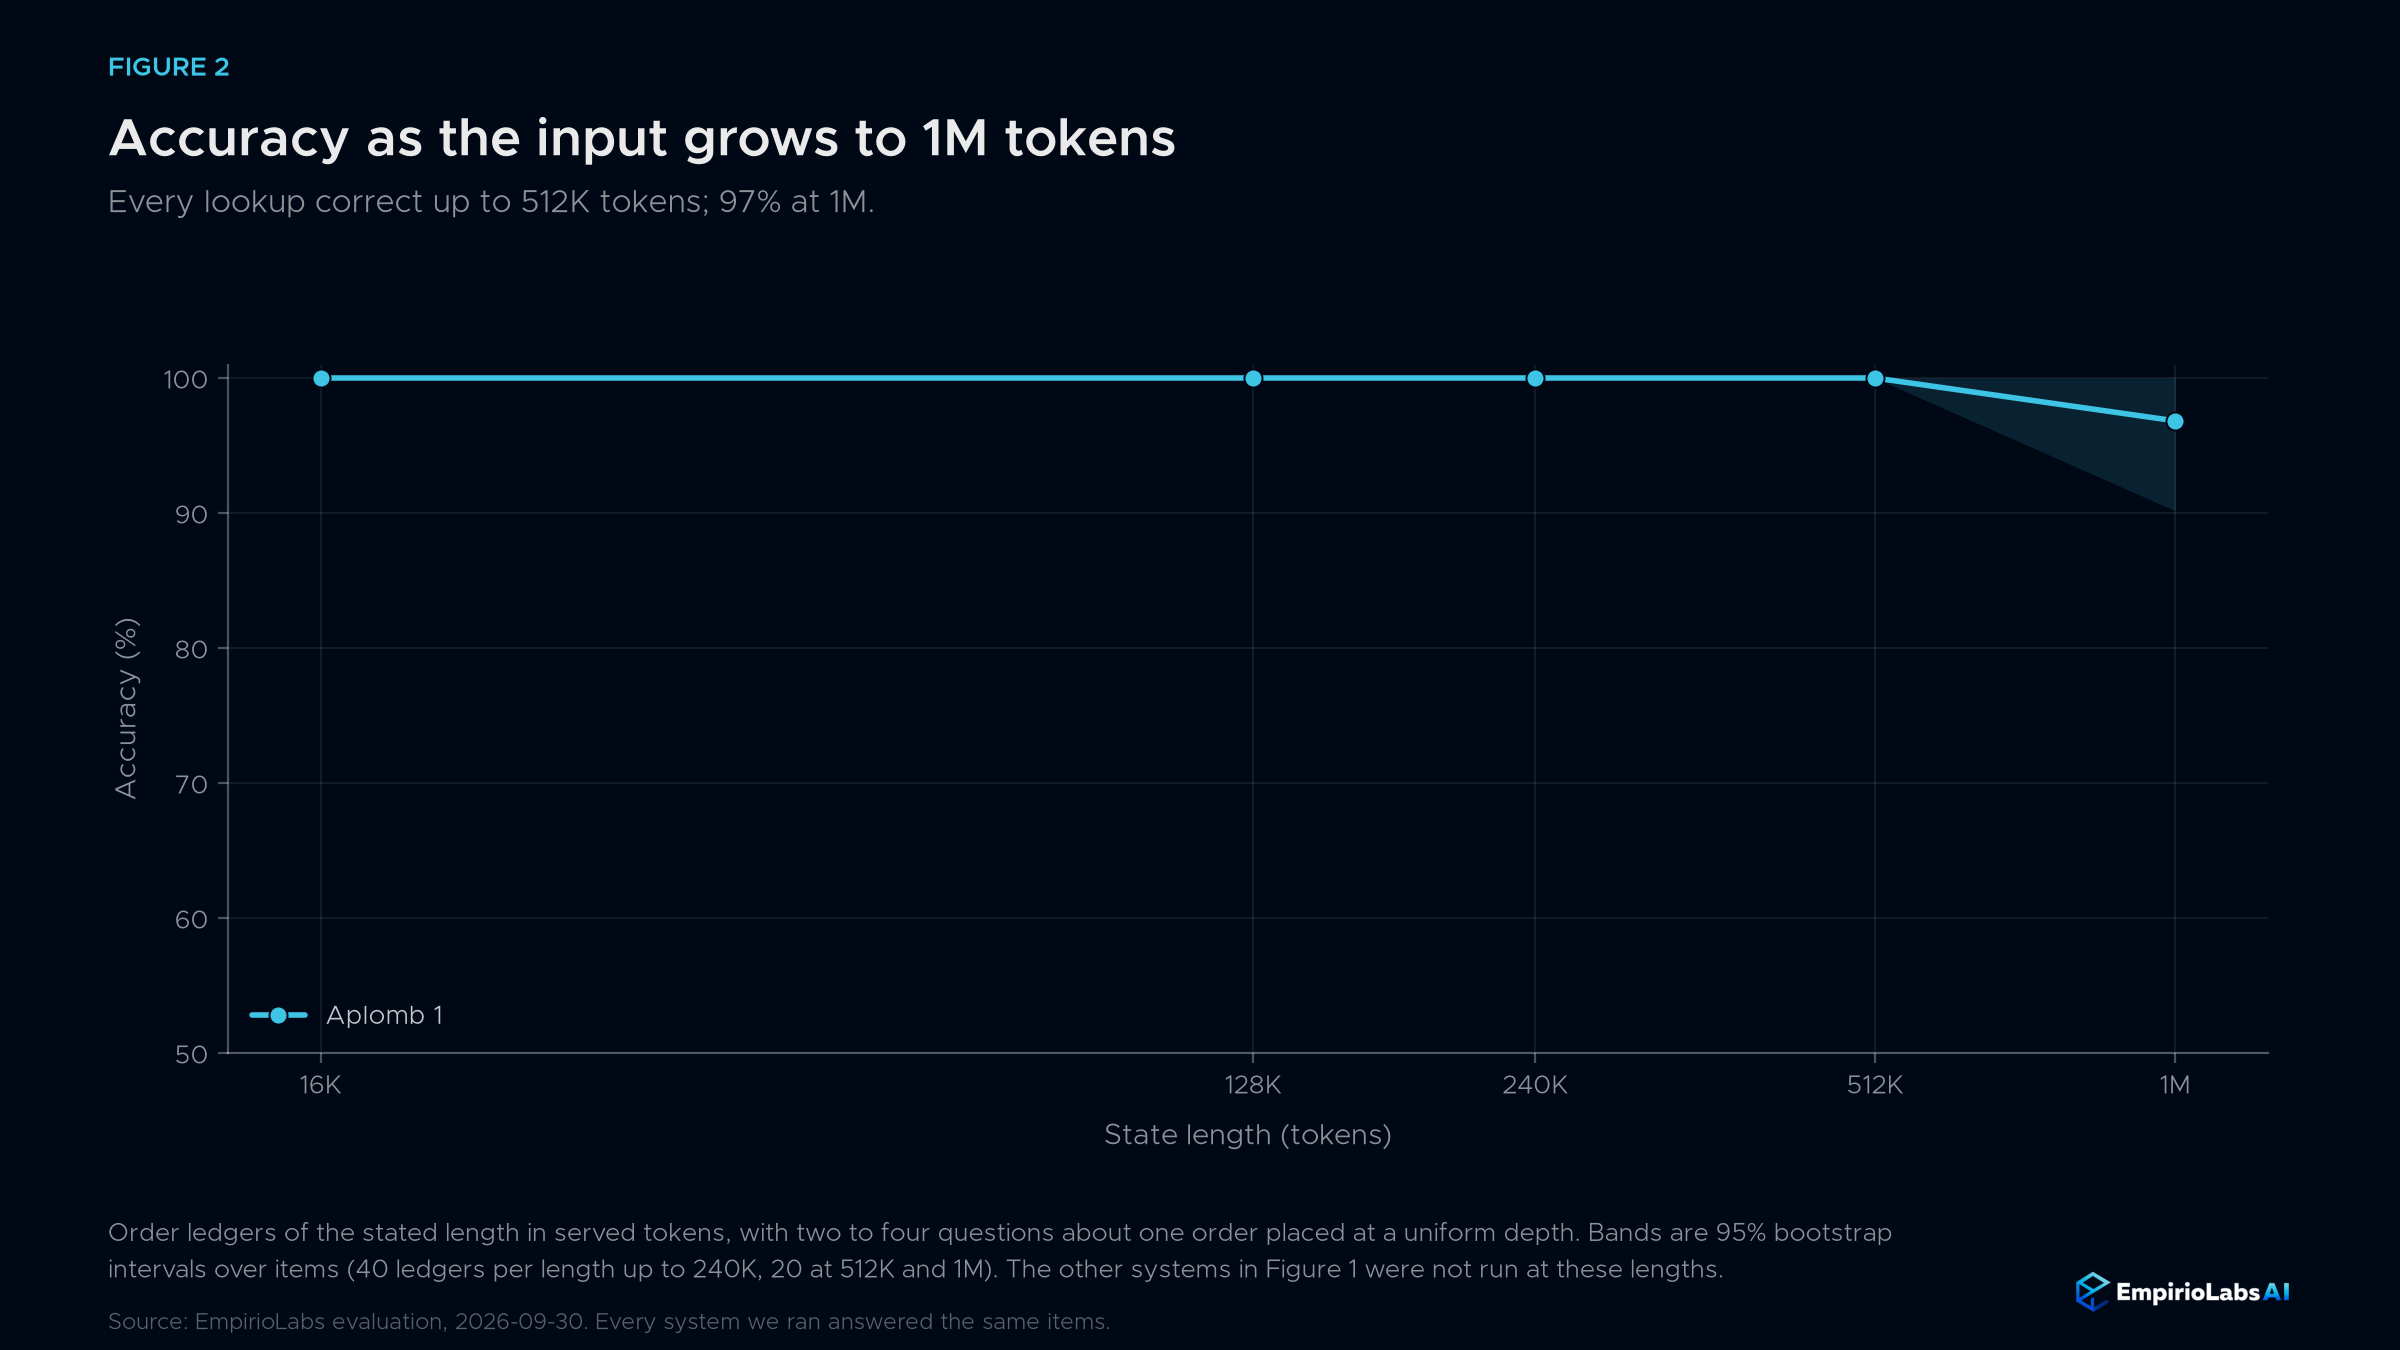
| طول الإدخال (الرموز) | 16 ألف | 128K | 240K | 512K | 1M |
|---|---|---|---|---|---|
| ثقة 1 | 100.0 | 100.0 | 100.0 | 100.0 | 96.8 |
وثائق طويلة في ثوان
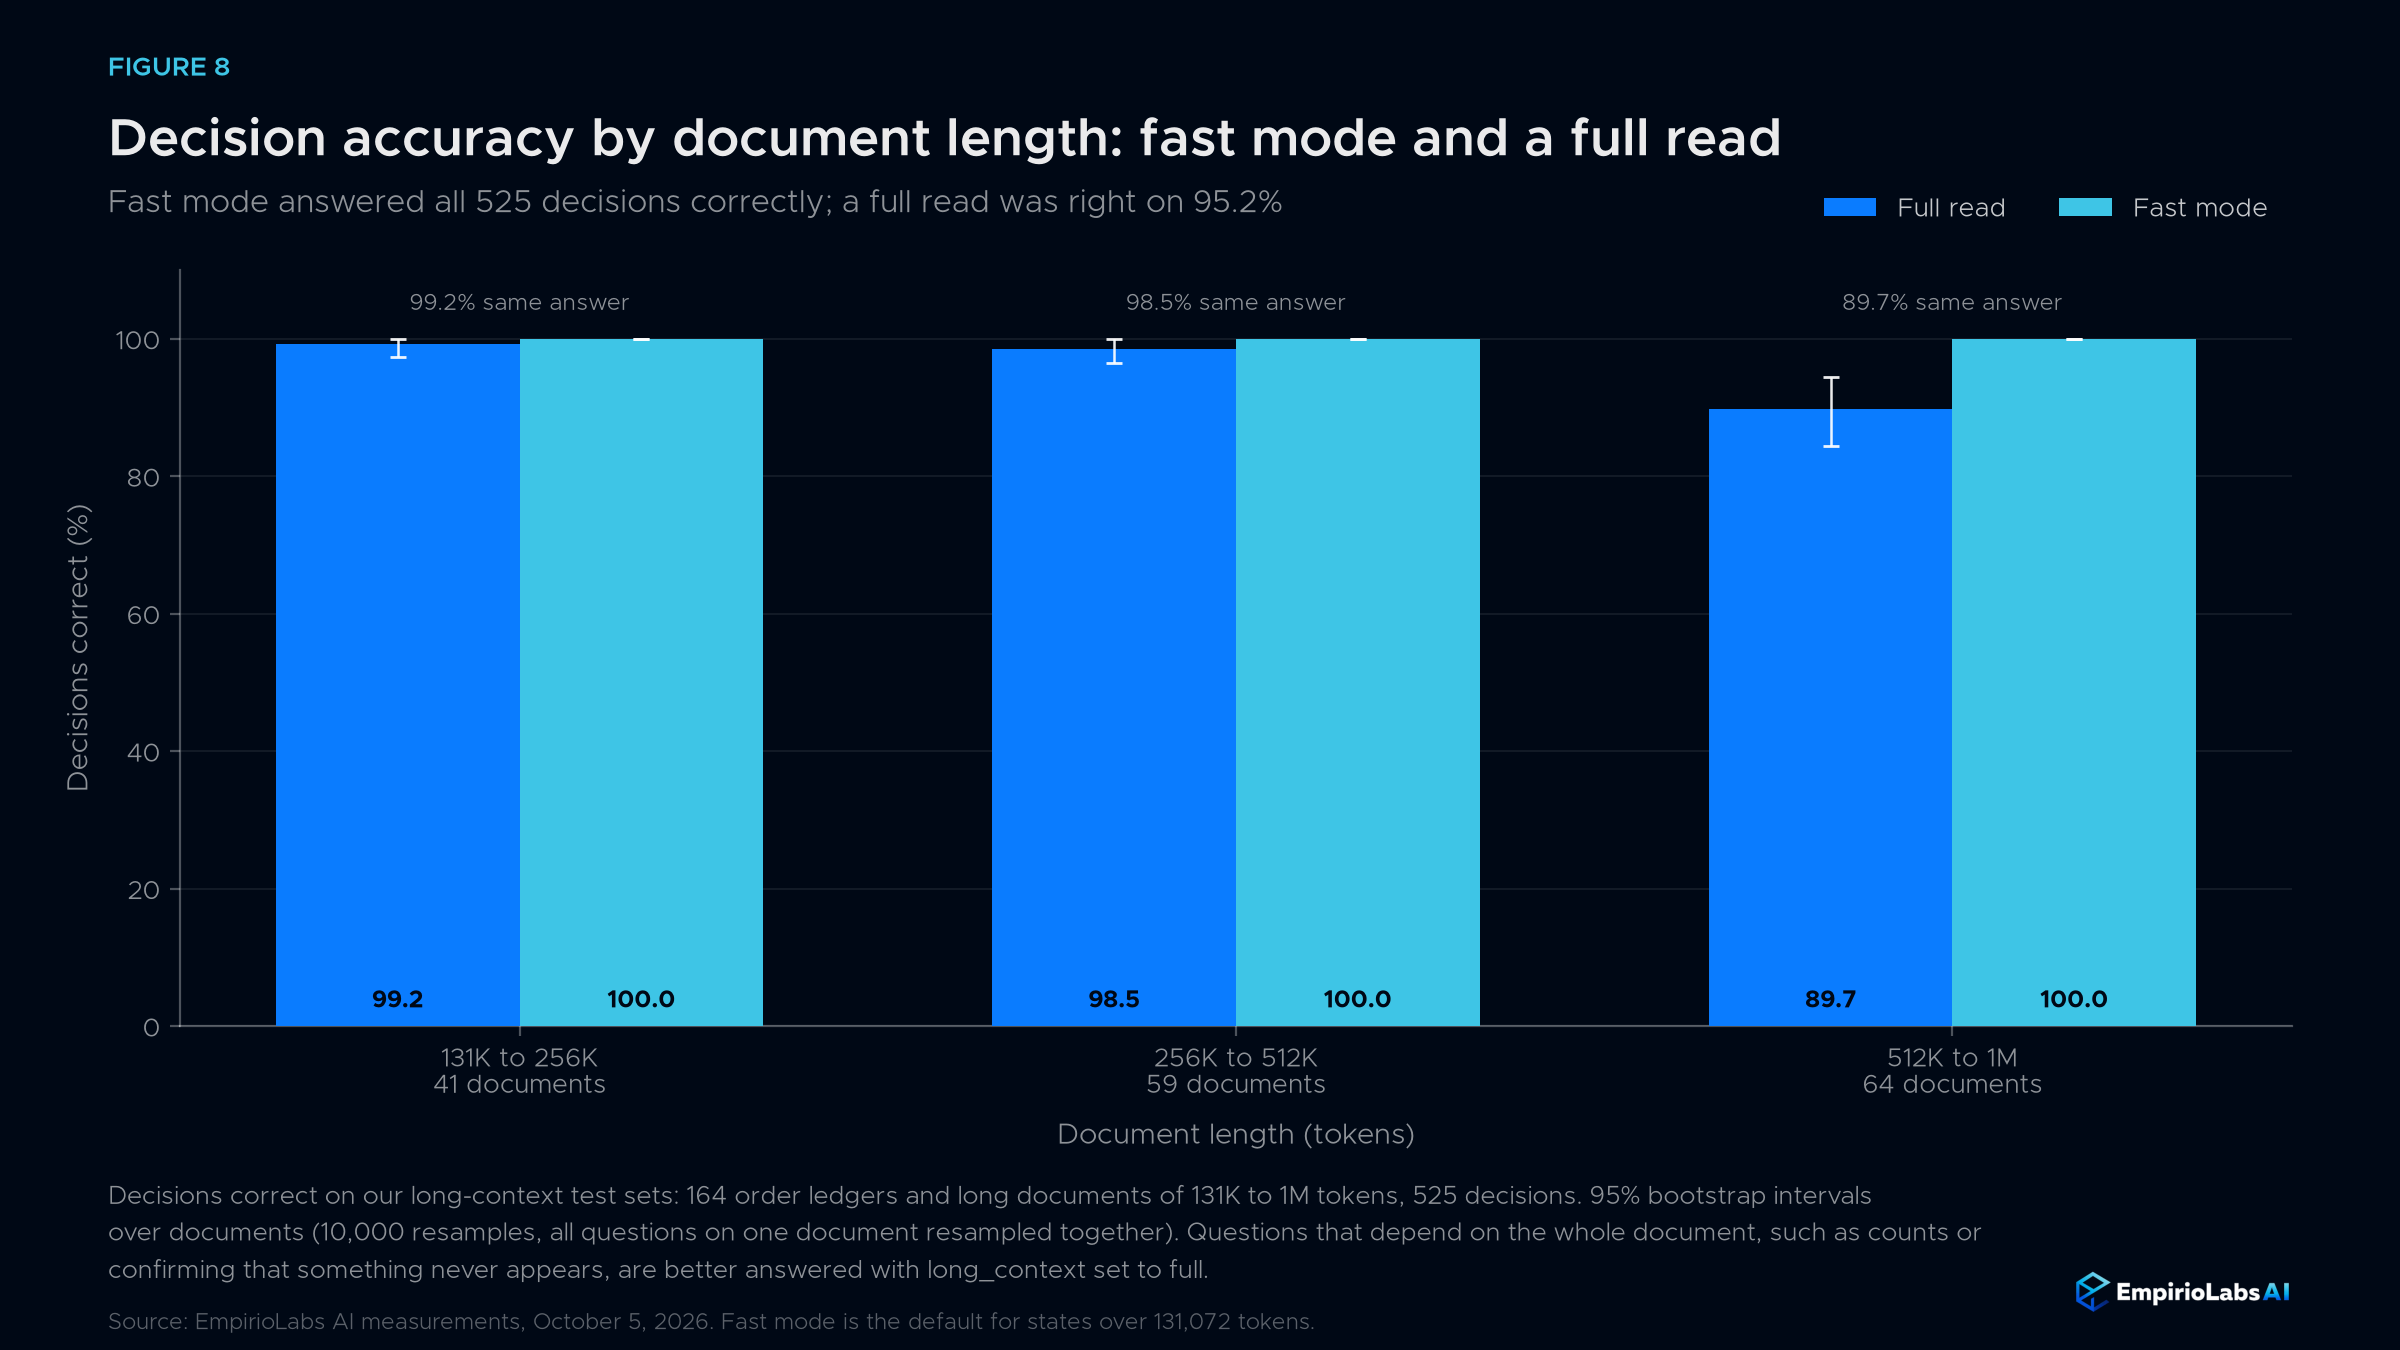
في واجهة برمجة التطبيقات EmpirioLabs وفي Playground، يتم قراءة حالة تزيد عن 131,072 رمزا في وضع السياق الطويل السريع بشكل افتراضي. تستغرق وثيقة 1M رمز حوالي 3 ثوان بدلا من حوالي 111 ثانية للقراءة الكاملة، وفي مجموعات اختبار السياق الطويل لدينا أجاب الوضع السريع على جميع القرارات ال525 بشكل صحيح، مقابل 95.2٪ للقراءة الكاملة.
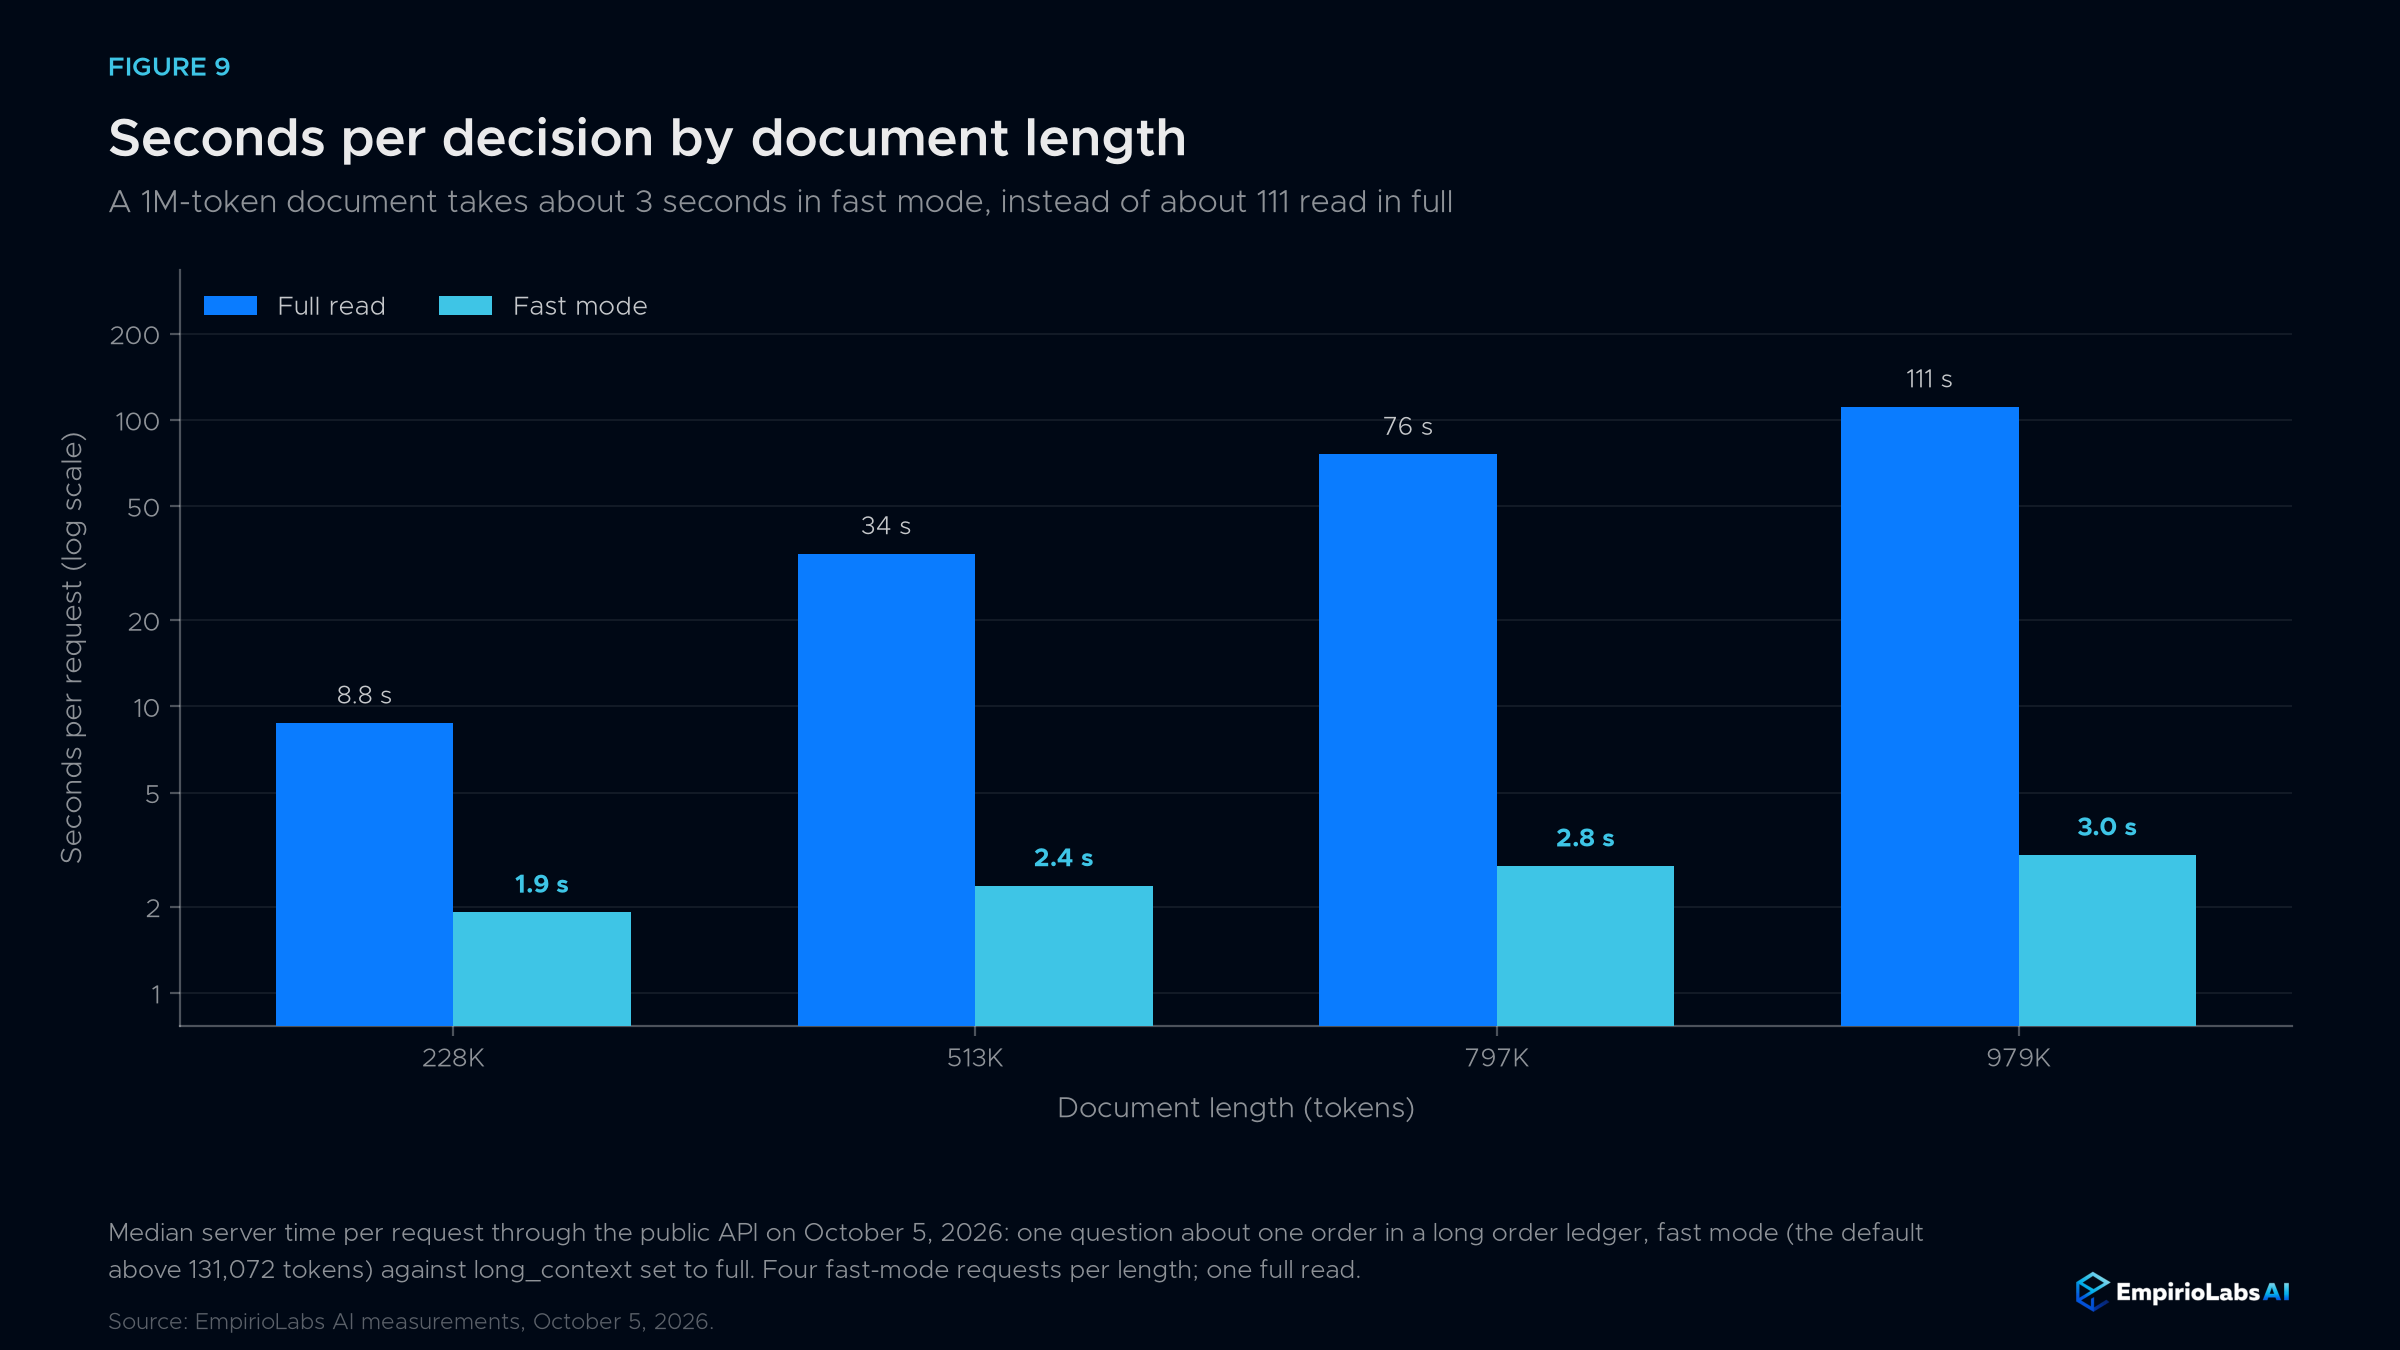
| طول المستند (الرموز) | 228 ألف | 513K | 797K | 979K |
|---|---|---|---|---|
| الوضع السريع | 1.9 ثانية | 2.4 ثانية | 2.8 ثانية | 3.0 ثانية |
| القراءة الكاملة | 8.8 ثانية | 34 ثانية | 76 | 111 ثانية |
أرسلني "long_context": "ممتلئ" لقراءة كل رمز. القراءة الكاملة هي الخيار الأفضل عندما تعتمد الإجابة على المستند بأكمله، مثل العد، النبرة العامة، أو تأكيد أن شيئا ما لا يظهر أبدا: في 24 وثيقة مصممة لاختبار تلك الأسئلة، كان وضع السرعة صحيحا في 50٪ من القرارات والقراءة الكاملة على 61٪. الرد long_context الحقل يوضح الوضع الذي تم استخدامه، ويستخدم حساب الحالة الكاملة في كلا الوضعين. وضع السياق الطويل السريع متاح فقط على واجهة برمجة التطبيقات EmpirioLabs وفي Playground؛ الأوزان المفتوحة تقرأ كل رمز.
المعايرة
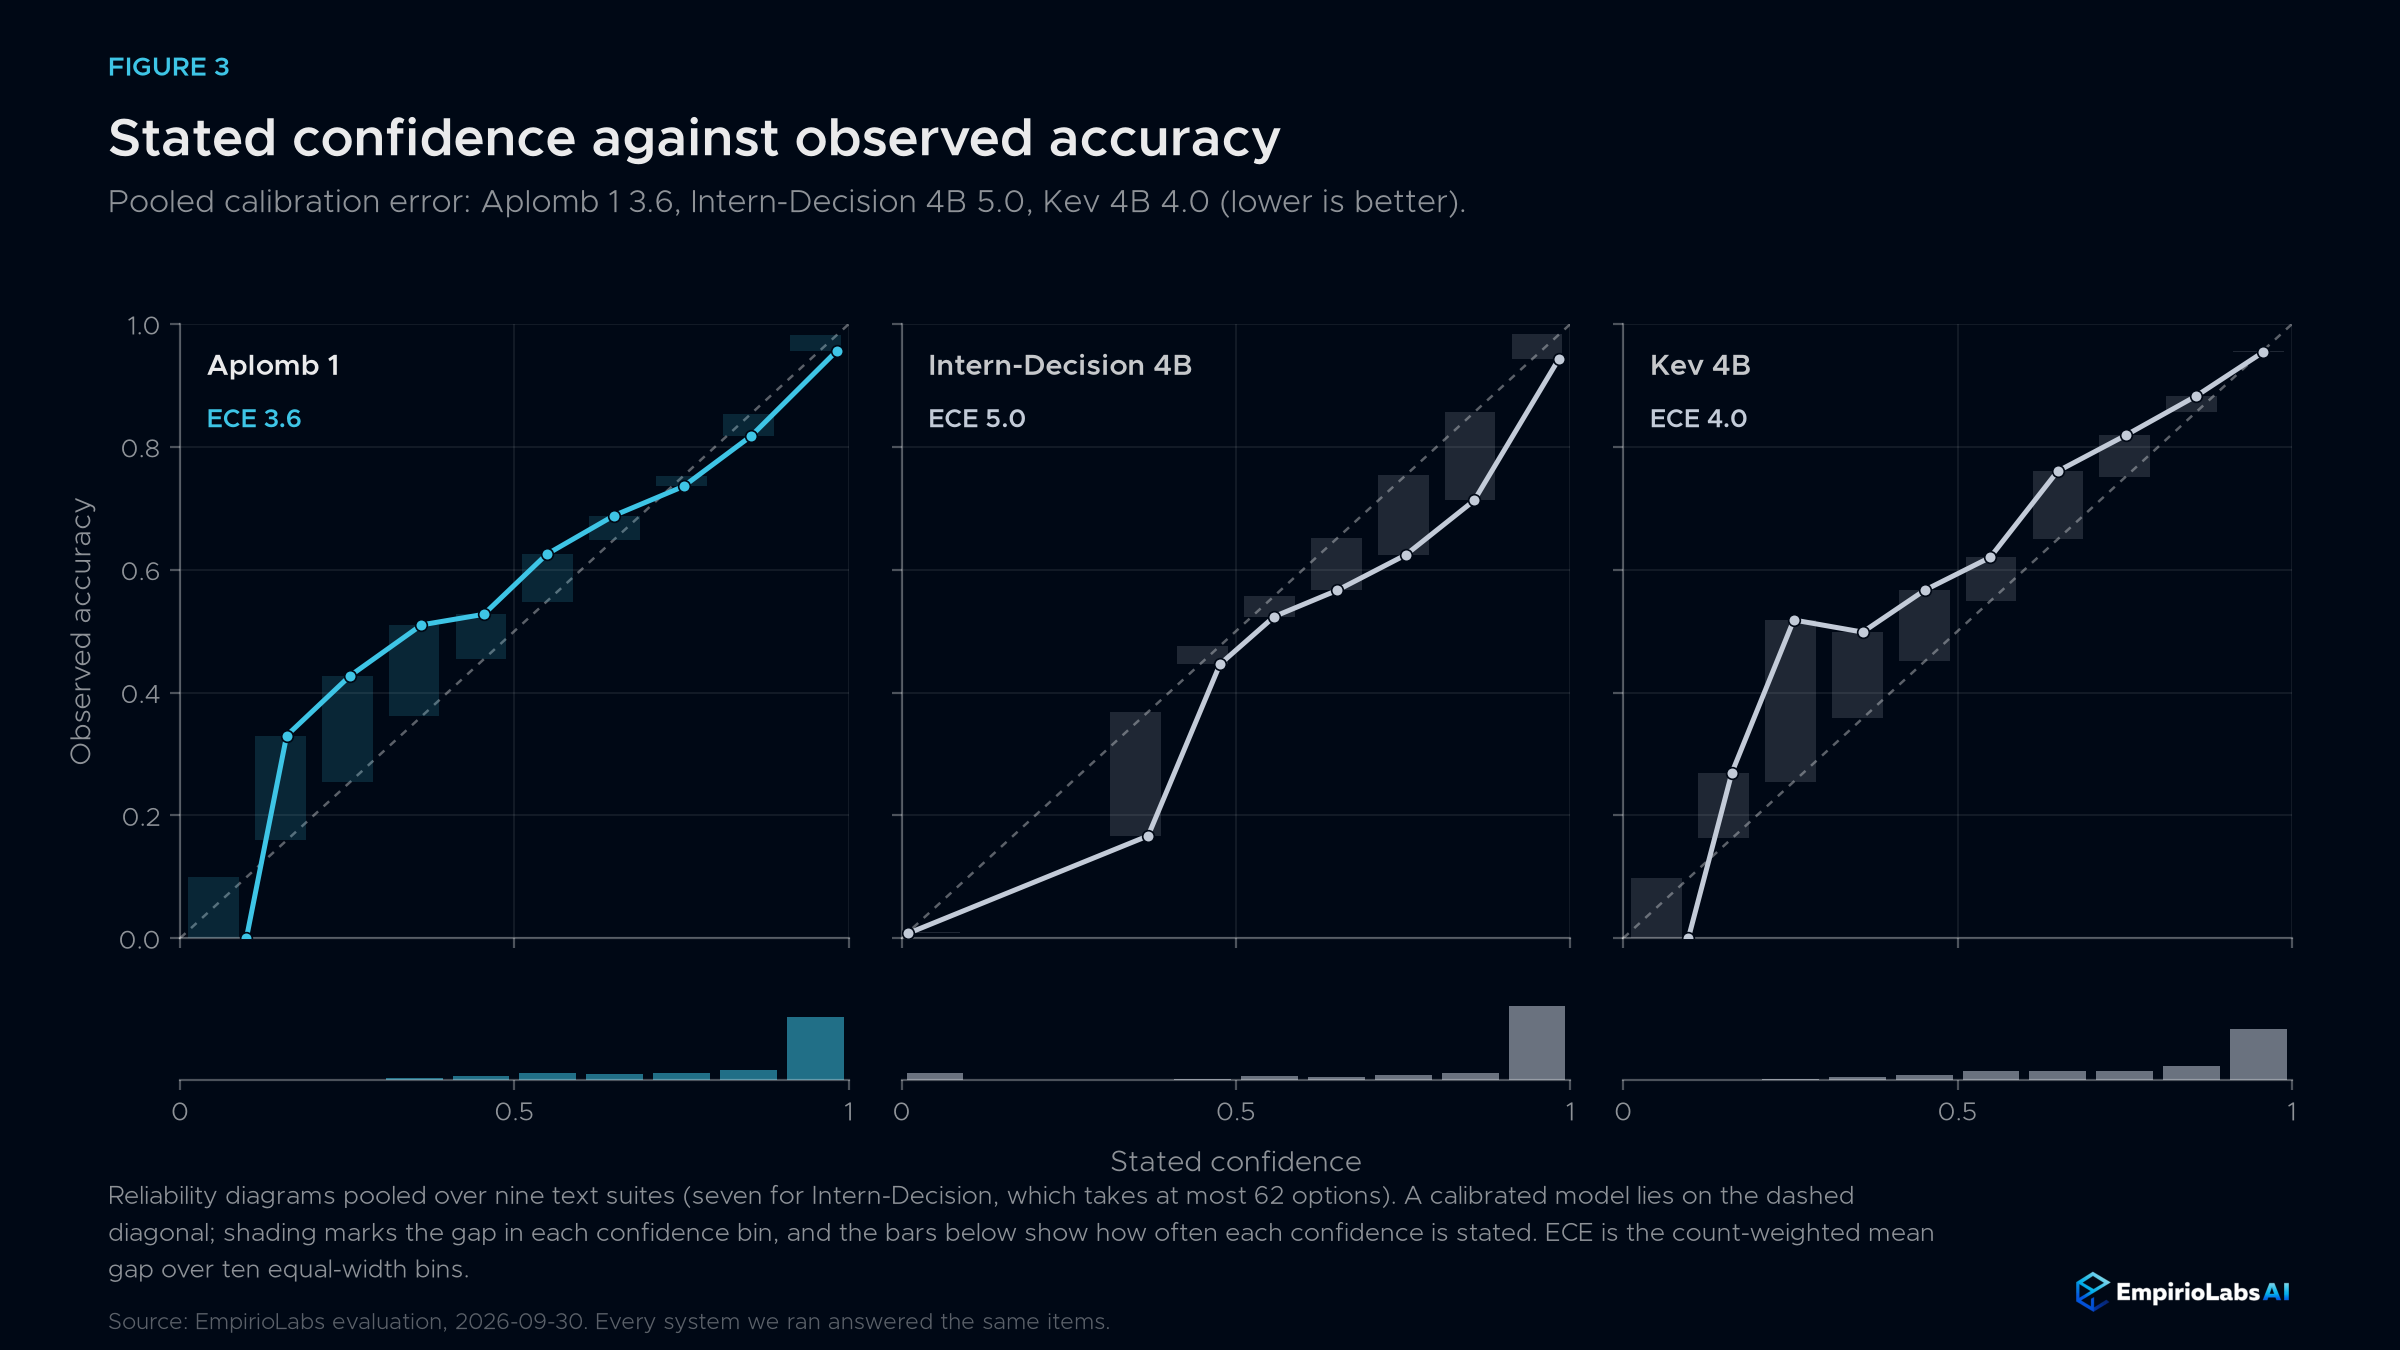
الاحتمال مفيد فقط إذا كان يعني ما يقوله. عبر تسع مجموعات نصوصية، تتابع الثقة المعلنة في Aplomb 1 مدى تكرار صحة النصوص: خطأ المعايرة المجمع 3.6، مقابل 5.0 لقرار المتدربين 4B و4.0 ل Kev 4B (الأقل أفضل).
الصور والفيديو والصوت
| المعيار (أول 500 عنصر) | ثقة 1 | المتدرب - قرار 4B | أومني جيف 4B |
|---|---|---|---|
| البابا | 89.0 | 89.2 | 88.4 |
| MMStar | 68.6 | 65.2 | 64.4 |
| AI2D | 87.0 | 81.0 | 83.4 |
| MMMU | 57.2 | 57.0 | 56.0 |
| منش الهلوسة | 79.8 | 79.4 | 71.2 |
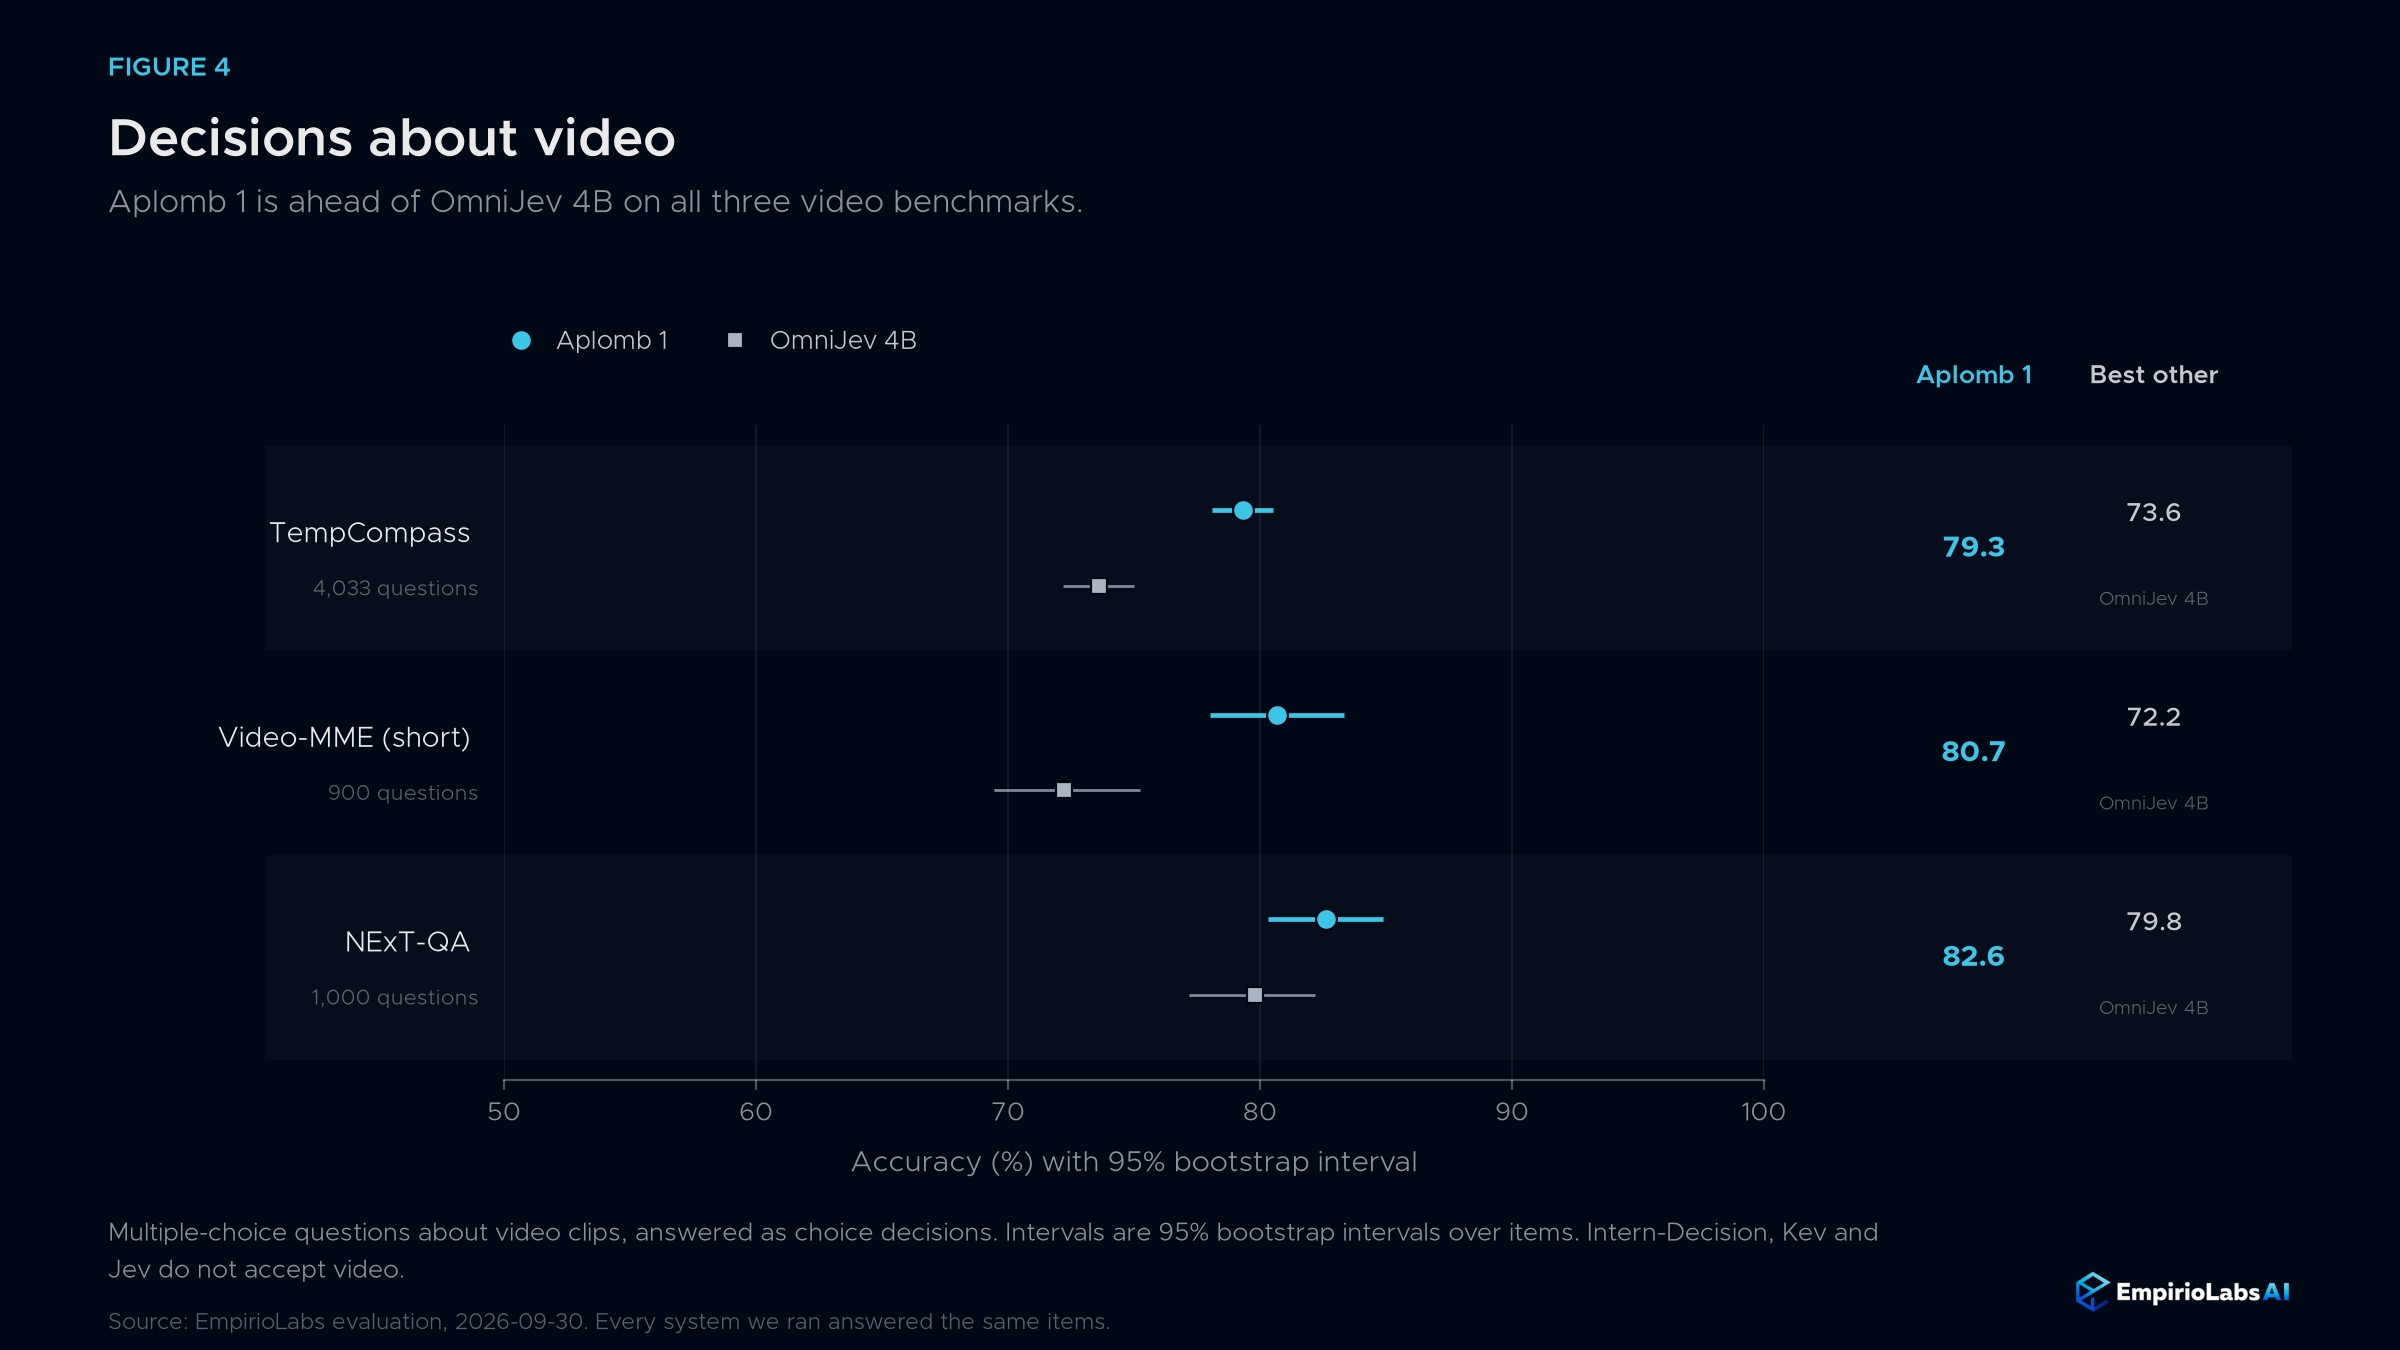
| المعيار | ثقة 1 | أومني جيف 4B |
|---|---|---|
| تمب كومباس | 79.3 | 73.6 |
| فيديو MME (قصير) | 80.7 | 72.2 |
| NExT-QA | 82.6 | 79.8 |
لقد أضفنا الصوت إلى Aplomb 1 بأنفسنا؛ لا أحد من نماذج القرار الأخرى أعلاه يقبله. هو الأقوى في الكلام والأصوات الصوتية؛ الأصوات البيئية والأسئلة المفتوحة حول الصوت أصعب بالنسبة له:
| المعيار | ثقة 1 |
|---|---|
| صوت صوت (أصوات صوتية) | 90.0 |
| كريما-دي (المشاعر في الكلام) | 65.0 |
| ESC-50 (الأصوات البيئية) | 8.4 |
| MMAU (أسئلة صوتية) | 49.1 |
| MMSU (اللغة المحكية) | 43.3 |
51 لغة
Aplomb 1 يقرر النص في العديد من اللغات، وليس فقط الإنجليزية. في MASSIVE، كل طلب إلى مساعد صوتي مكتوب بإحدى 51 لغة بينما يبقى السؤال وتسمية النية ال 59 باللغة الإنجليزية. بدون أي تدريب على MASSIVE، يحقق Aplomb 1 متوسط 75.0٪ عبر 51 لغة عند الاختيار من بين جميع النوايا ال59، و91.0٪ بالإنجليزية، و70٪ أو أكثر في 39 منها.
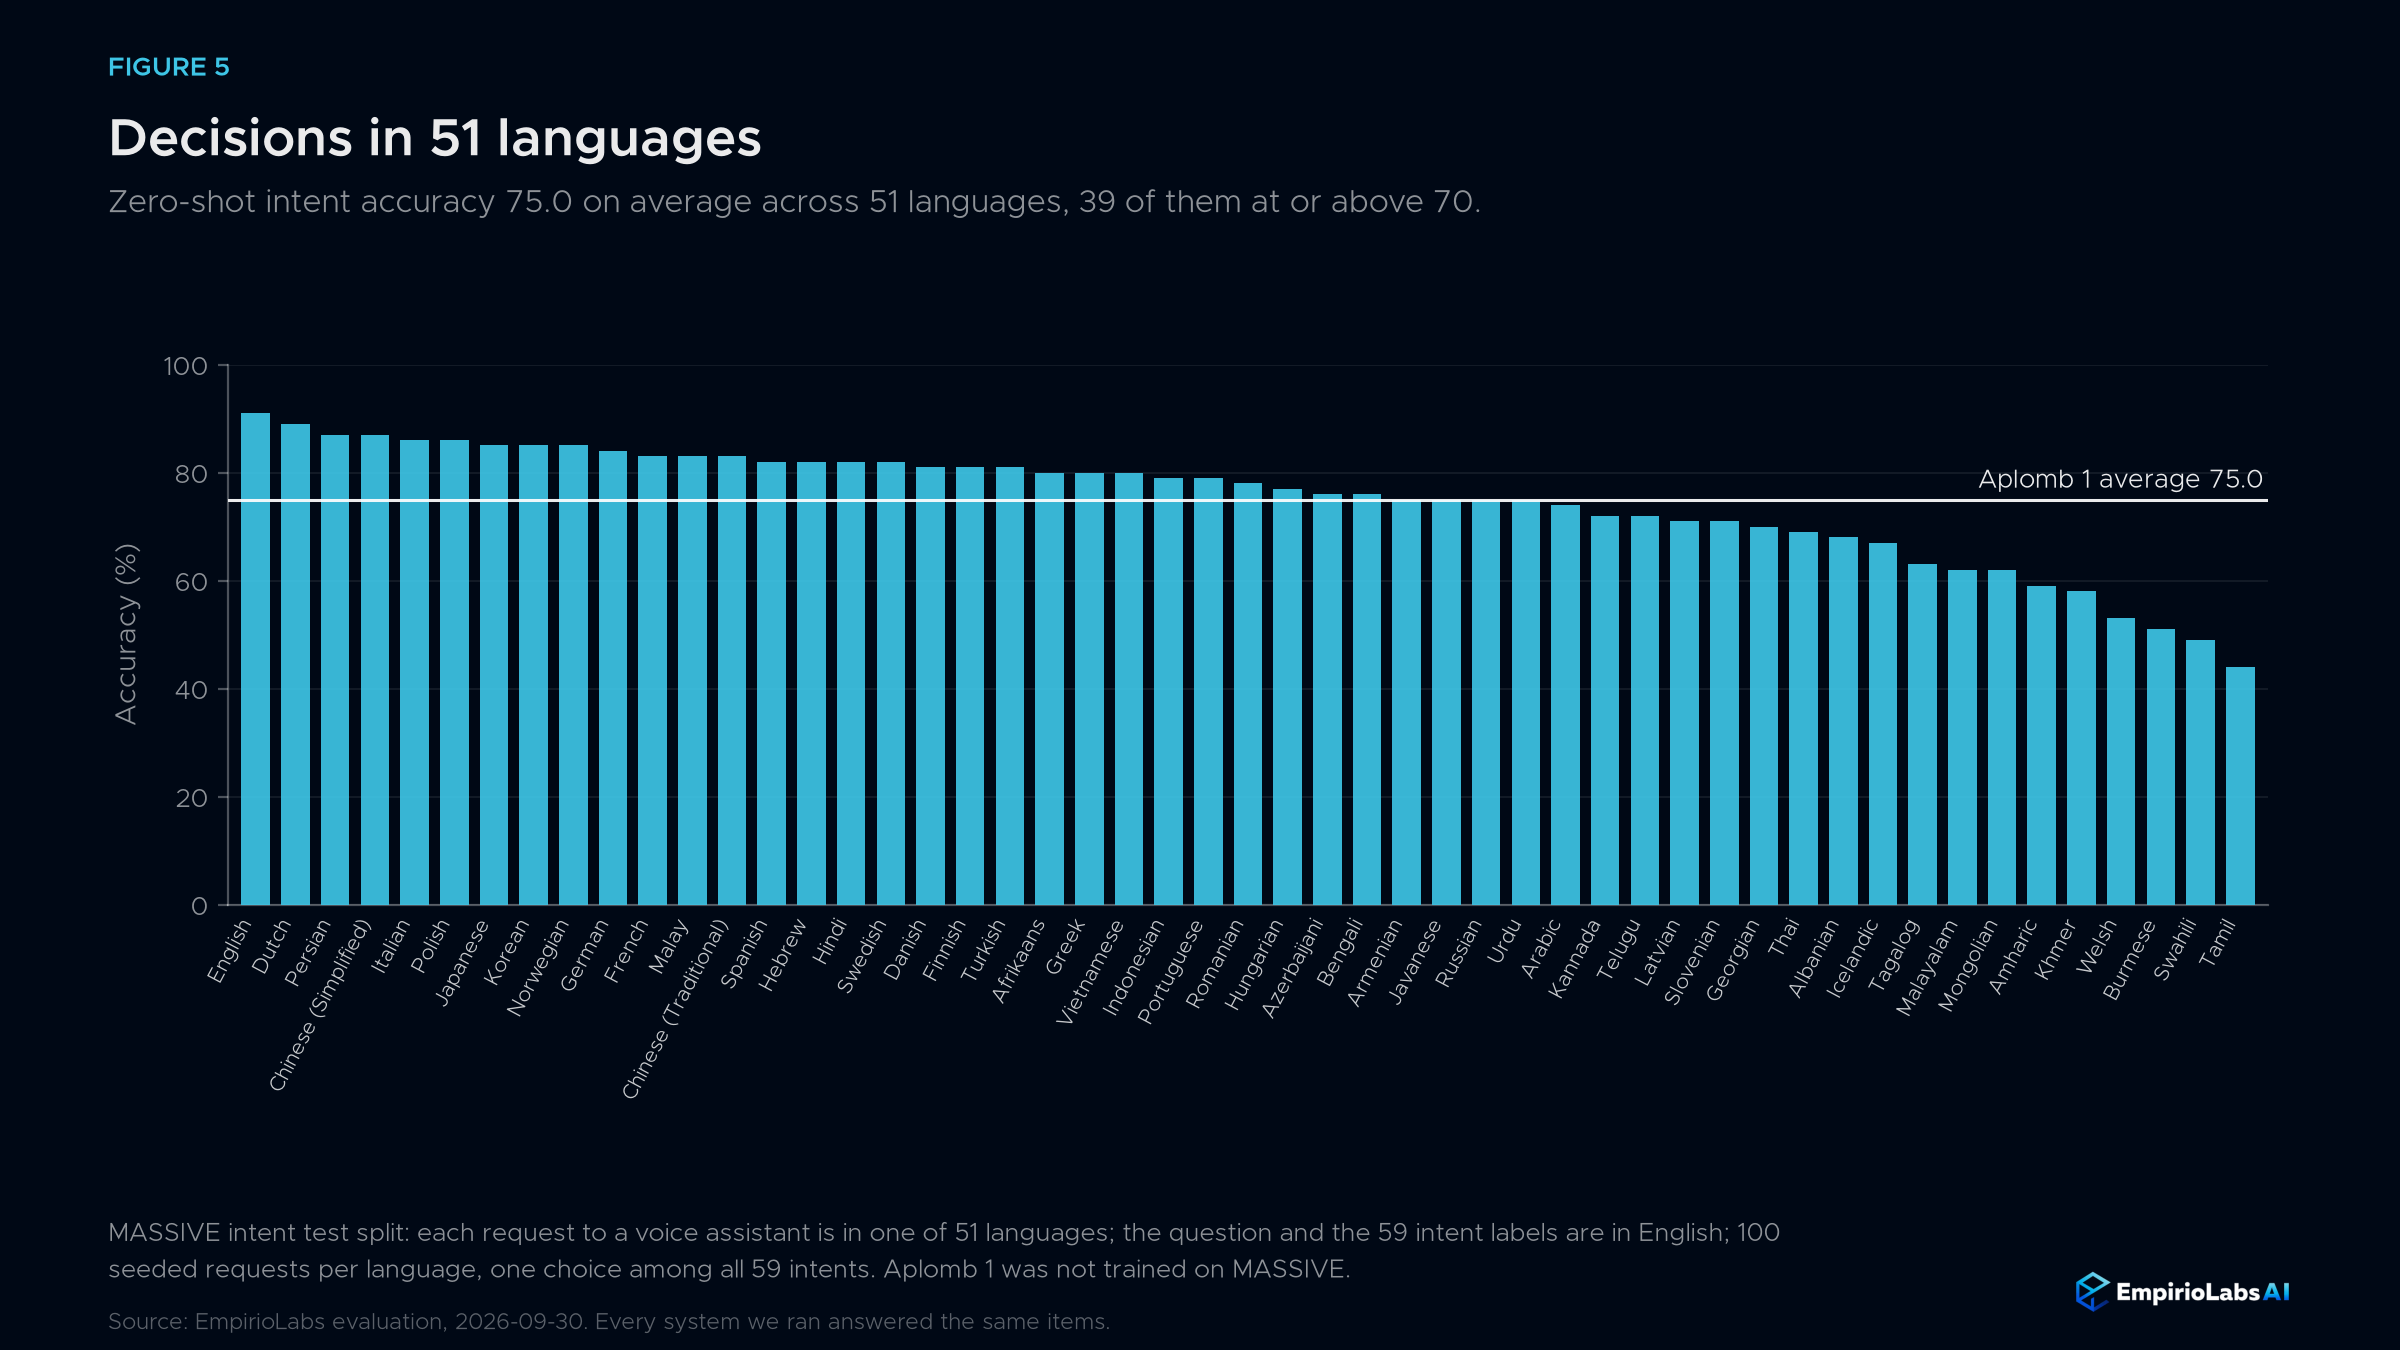
للمعلومية، يبلغ مشروع لايا عن نسبة 40.1٪ لنموذجه متعدد اللغات عبر نفس اللغات ال 51 عند الاختيار من بين 20 هدفا، ويبلغ مشروع JevK5 عن نسبة 73.8٪ بالإنجليزية مع جميع النوايا ال60.
مؤشر القرار
مؤشر القرار 0.2.1 يسجل في المتوسط 38 معيارا عاما في خمسة مجالات: المعرفة والتفكير، فهم اللغة، الاسترجاع والتصنيف، الأدوات والأتمتة، والفنون والذوق البشري. كل معيار يتم تصحيحه بالصدفة، لذا 0 يعني تخمين عشوائي و100 يعني الكمال.
قمنا بتشغيل المجموعة الرسمية في Aplomb 1 في 5 أكتوبر 2026، وأجابت لجميع الطلبات القابلة للتسجيل البالغ عددها 150,317. Aplomb 1 يحصل على تقييم 44.86. هذه نسختنا الخاصة من المجموعة، وليست مشاركة في اللوحة المنشورة.
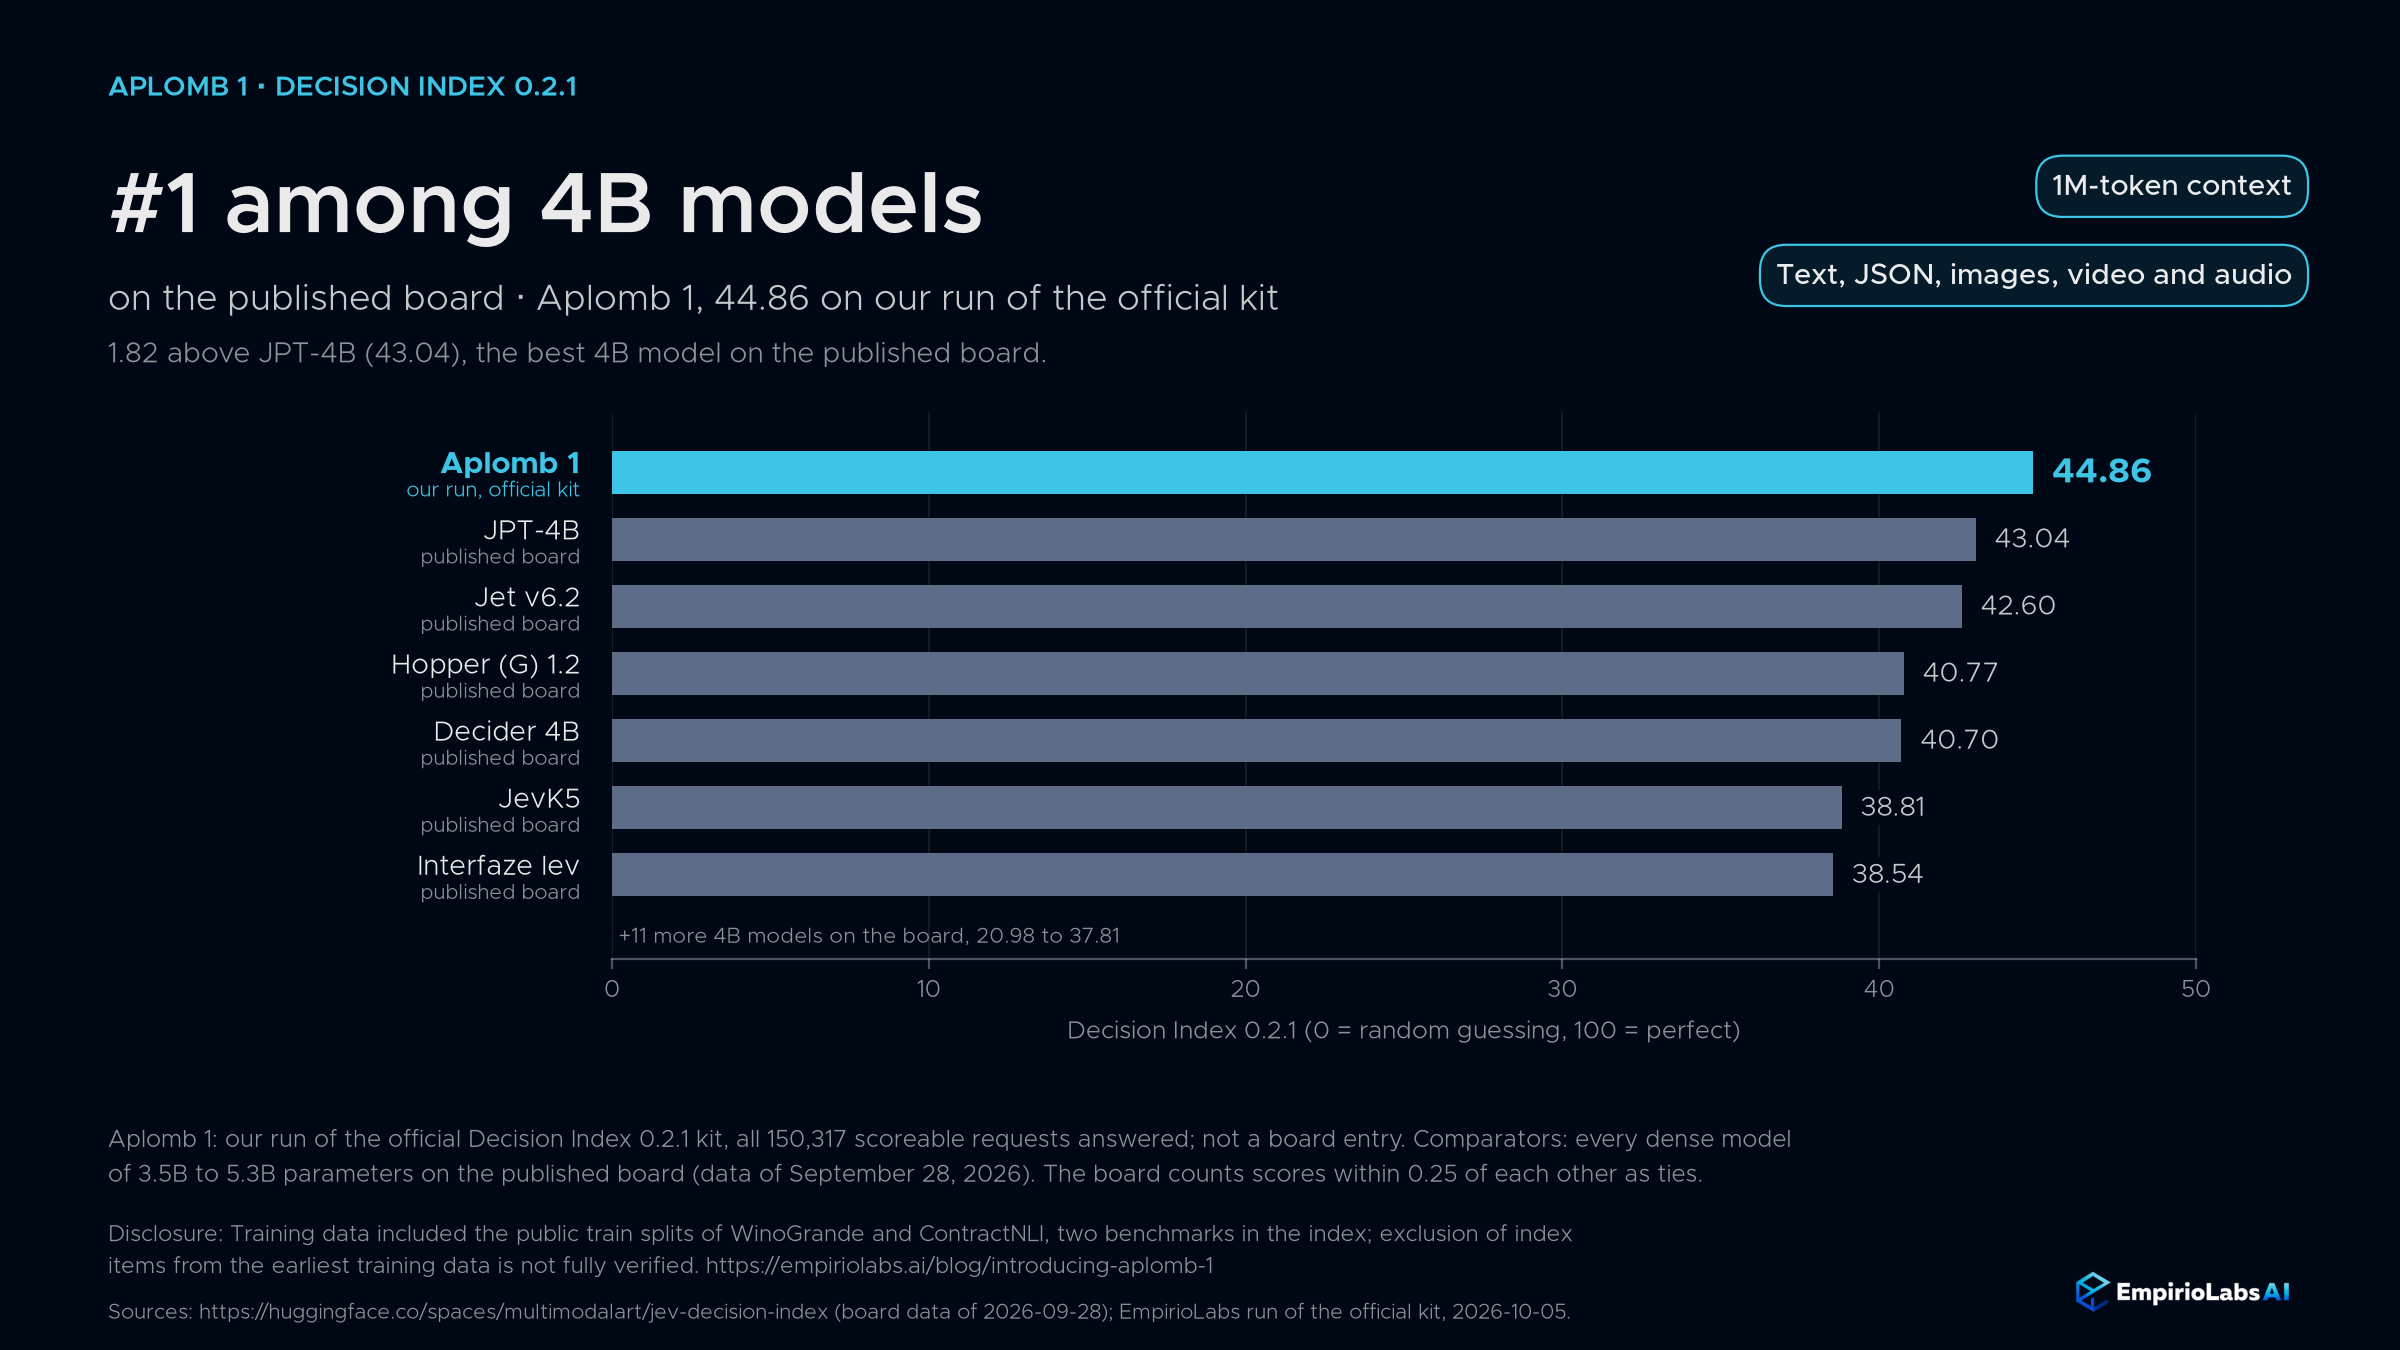
اعتبارا من 6 أكتوبر 2026، فإن Aplomb 1 هو #1 بين نماذج 4B في اللوحة المنشورة، و#1 بين النماذج التي تصل إلى 5.3B معلمات في 8 من أصل 38 معيار، بما في ذلك MMLU-Pro وGPQA Diamond وBBH. في اللوحة المنشورة (بيانات 28 سبتمبر 2026)، أعلى درجة لنموذج 4B هي 43.04 لنموذج JPT-4B، أي أقل ب 1.82 من Aplomb 1.
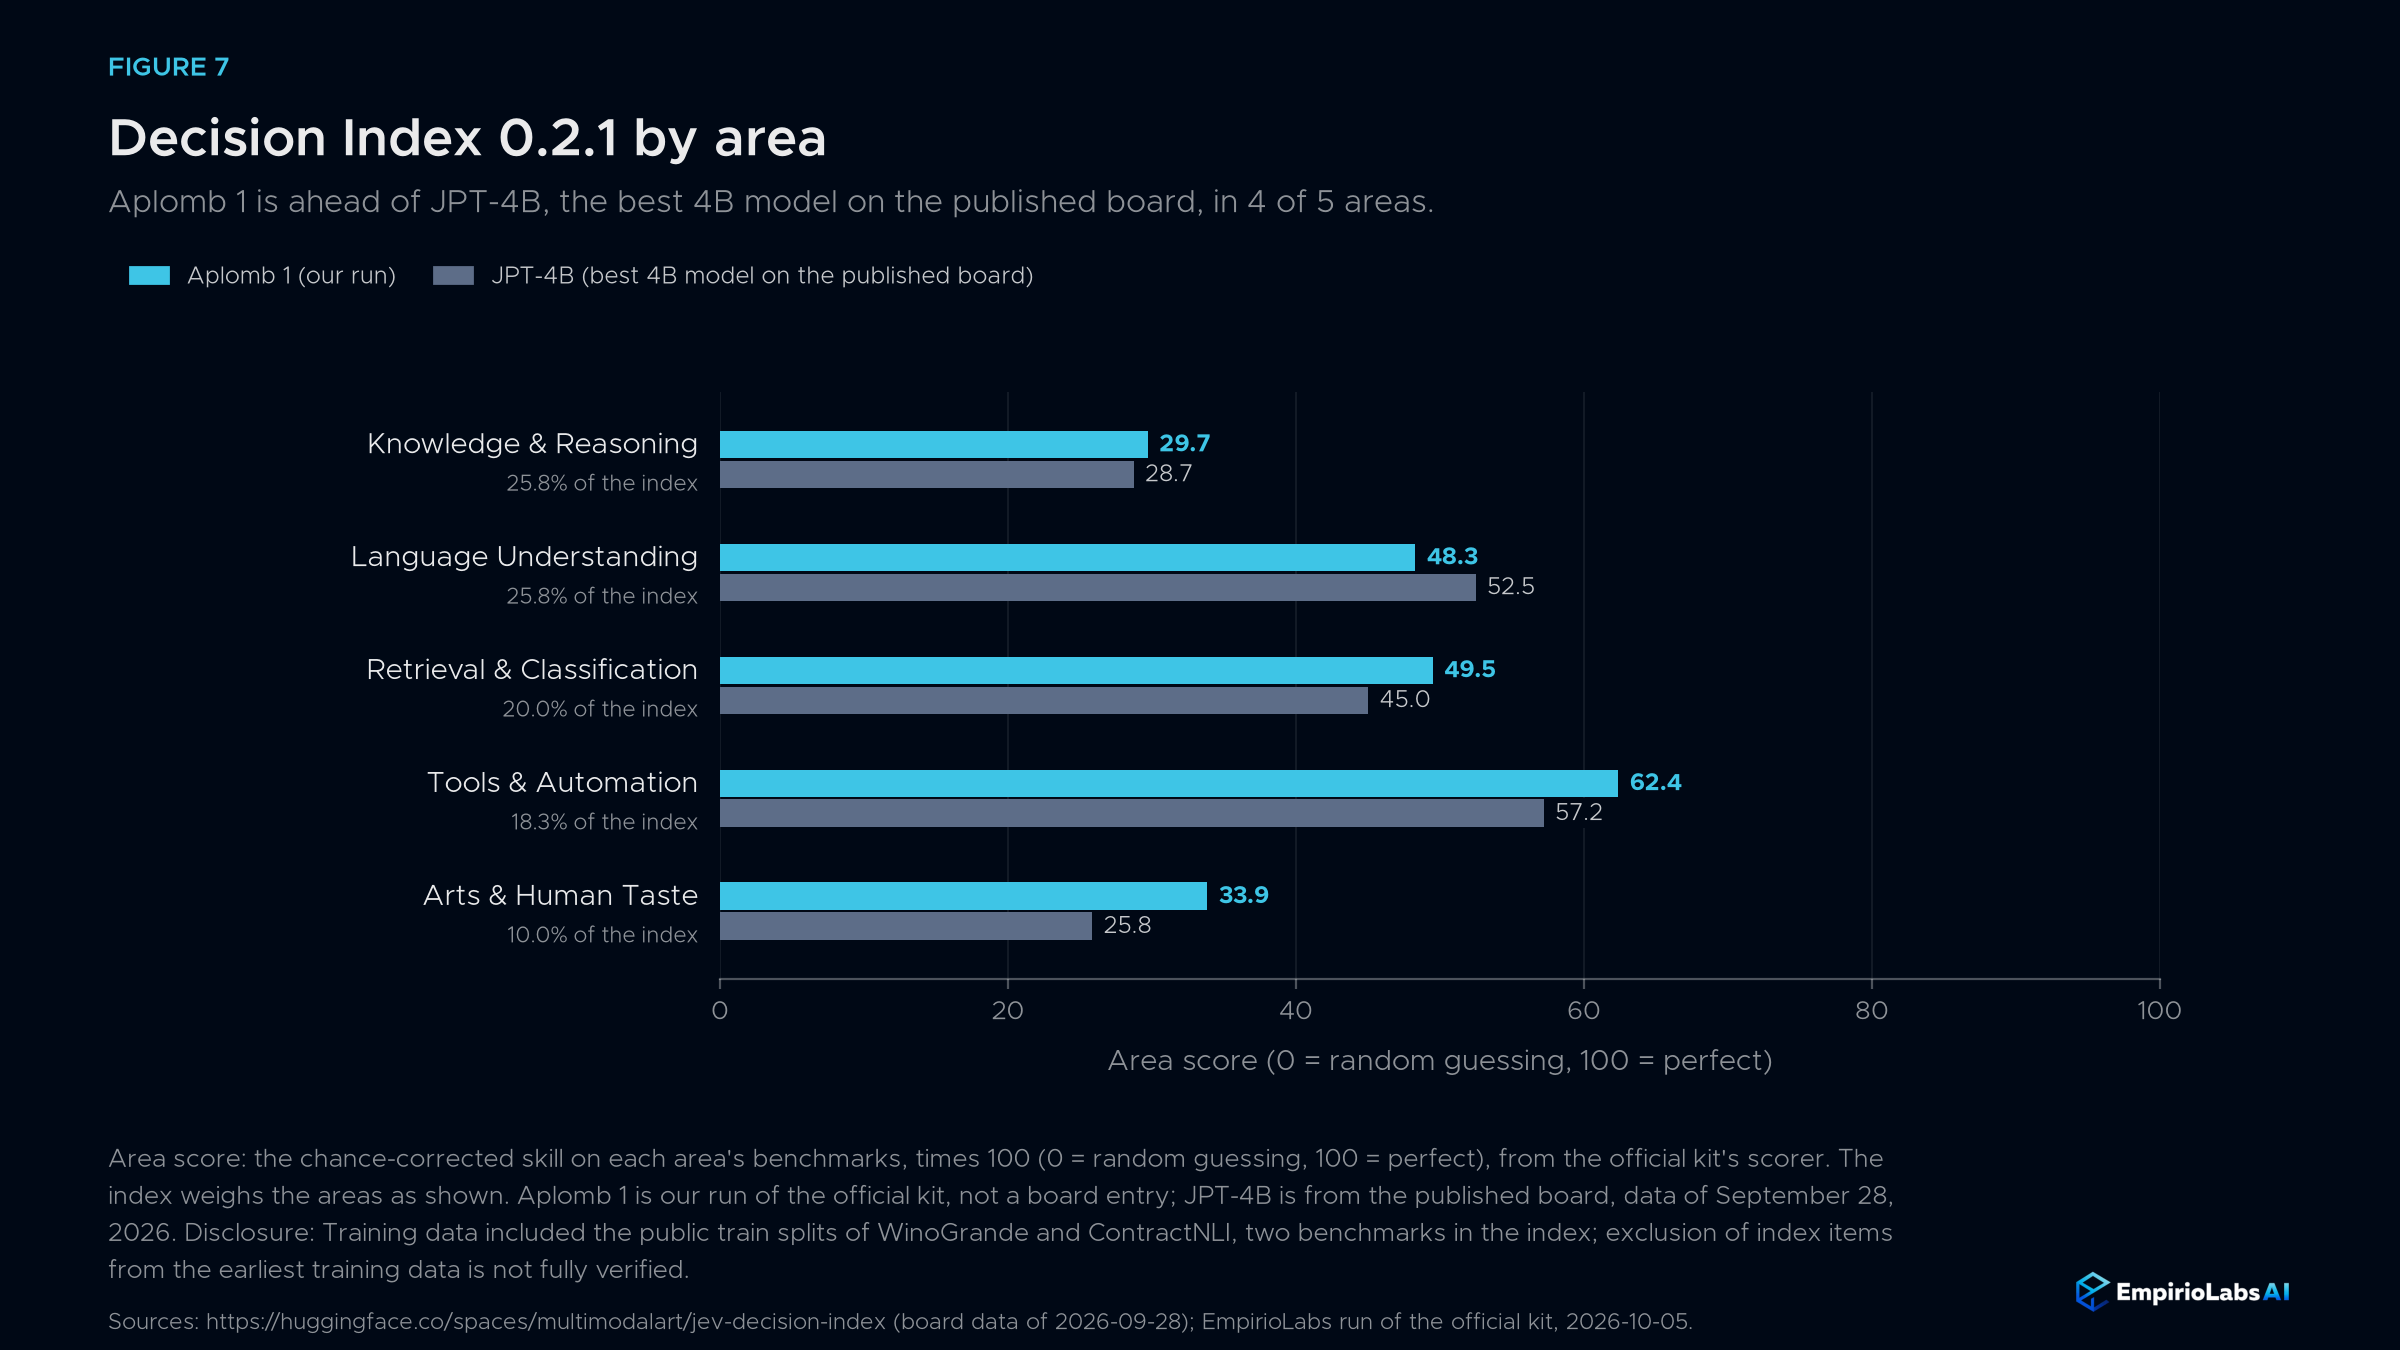
حسب المجال، يحصل Aplomb 1 على أعلى درجات في الأدوات والأتمتة (62.4) والاسترجاع والتصنيف (49.5). مقارنة ب JPT-4B، يتصدر في أربعة من المجالات الخمسة ومتأخرا في فهم اللغة (48.3 مقابل 52.5).
إفصاح. شملت بيانات التدريب الخاصة ب Aplomb 1 تقسيمات القطارات العامة ل WinoGrande وContractNLI، وهما اثنان من 38 معيارا معياريا في المؤشر. لم نتمكن من التحقق الكامل من أن عناصر الفهرس تم استبعادها من بيانات التدريب الأولى.
كيف يقارن
ما يقبله كل نموذج قرار أو واجهة برمجة تطبيقات ويجيب عليه، من خلال وثائقها المنشورة حتى 29 سبتمبر 2026، مع الأسعار حتى 6 أكتوبر 2026:
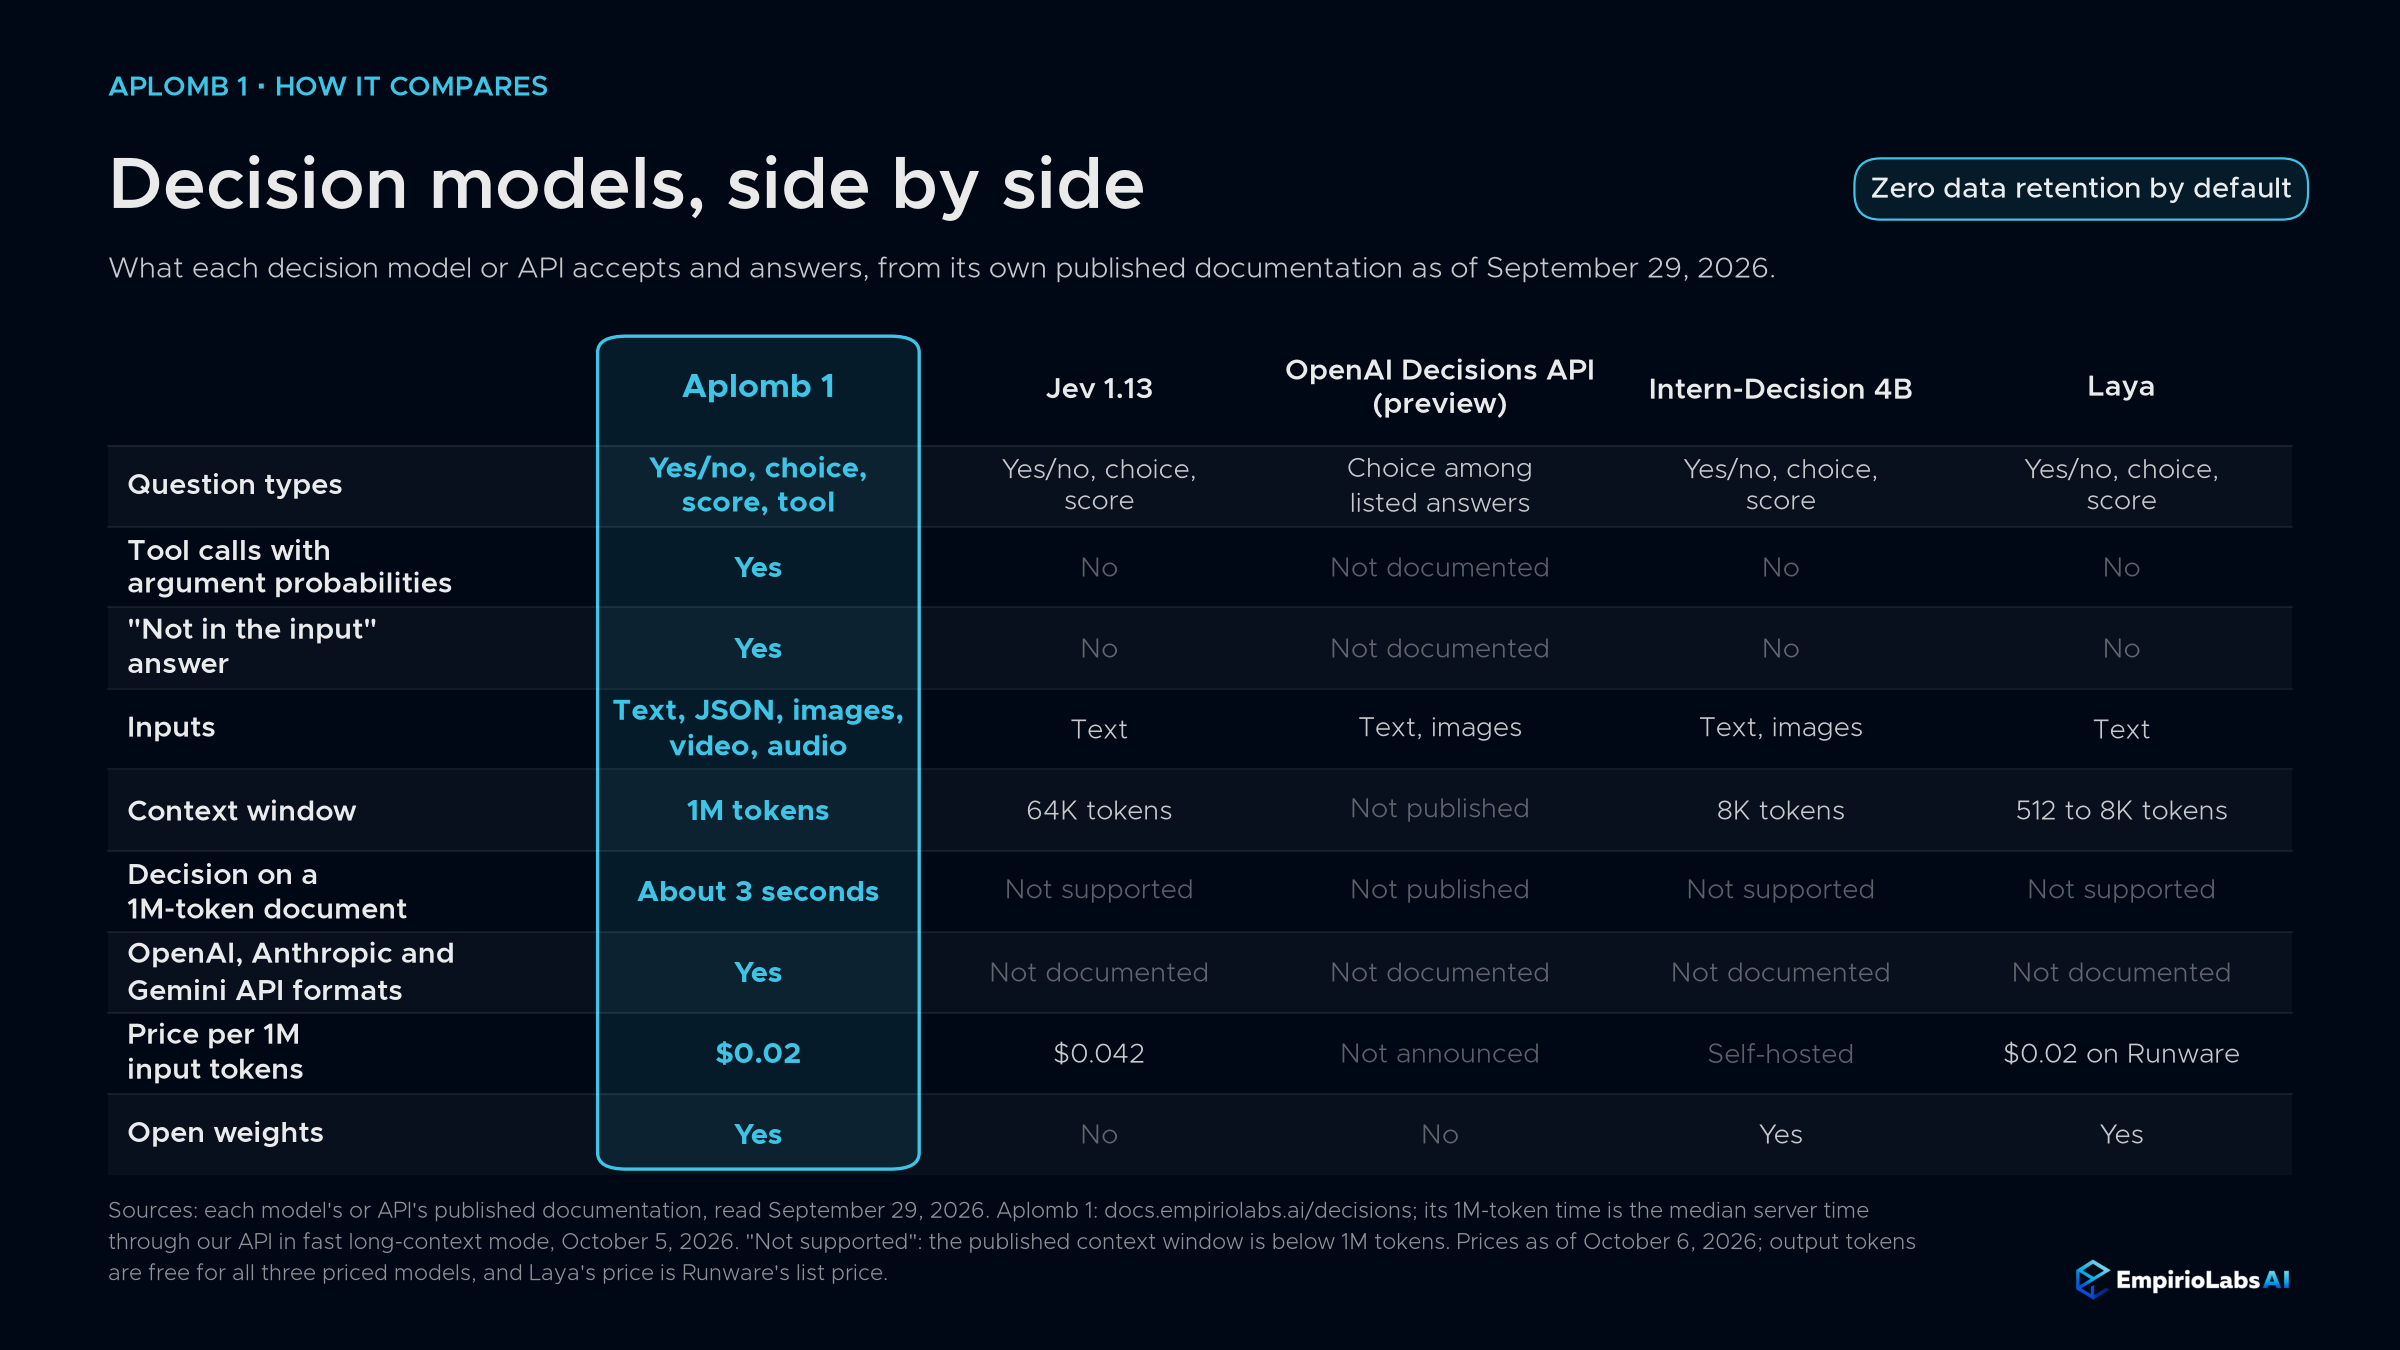
| ثقة 1 | Jev 1.13 | واجهة برمجة تطبيقات قرارات OpenAI (معاينة) | المتدرب - قرار 4B | لايا | |
|---|---|---|---|---|---|
| أنواع الأسئلة | نعم أو لا، الاختيار، الدرجة، الأداة | نعم أو لا، اختيار، النتيجة | اختيار بين الإجابات المدرجة | نعم أو لا، اختيار، النتيجة | نعم أو لا، اختيار، النتيجة |
| اختيار الأدوات مع احتمالات الحجة | نعم | لا | غير موثق | لا | لا |
| ليس في الولاية | نعم | لا | غير موثق | لا | لا |
| المدخلات | النص، JSON، الصور، الفيديو، الصوت | النص | النص، الصور | النص، الصور | النص |
| النافذة | 1,000,000 رمز | رموز 64 ألف | لم ينشر | 8,192 رمزا | من 512 إلى 8,192 رمزا |
| سعر كل مليون رمز إدخال | $0.02 | $0.042 | لم يعلن عنها | استضافة ذاتية | $0.02 على برنامج Runware |
| الأوزان المفتوحة | نعم | لا | لا | نعم | نعم |
السرعة والفوترة
يعمل Aplomb 1 على وقت تشغيل الاستنتاج الخاص EmpirioLabs لنماذج القرار. يستغرق السؤال القصير حوالي 15 مللي ثانية من وقت النموذج، والسؤال الذي يحتوي على صورة حوالي 35 مللي ثانية، ومستند يحتوي على 15,000 رمز حوالي 0.3 ثانية، وحالة رمز 1M حوالي 3 ثوان في وضع السياق الطويل السريع، وهو الوضع الافتراضي فوق 131,072 رمزا، أو حوالي 111 ثانية كاملة في الوضع.
تدفع فقط مقابل رموز الإدخال: الحالة مرة واحدة لكل طلب ونص كل سؤال خاص، وليس قالب مطالبة. رموز الإخراج دائما صفر. المعدل الحالي هو على صفحة النماذج و صفحة الأسعار.
عدم وجود احتفاظ بالبيانات مفعل بشكل افتراضي: نحن لا نحتفظ بمحتوى طلباتك أو ردودك.
الأوزان المفتوحة
يعتمد Aplomb 1 على Qwen3.5-4B. قمنا بتوسيع نافذته من 262K إلى 1M رمز، وأضفنا إدخال الصوت باستخدام مشفر الصوت في Qwen3-Omni، وأضفنا رأس القرار الخاص بنا الذي يعيد كل إجابة كاحتمالات معايرة بدلا من النص المولد، ودربنا النموذج على اتخاذ القرارات، بما في ذلك اختيار الأدوات والإجابة not-in-the-input. بالنسبة لواجهة برمجة التطبيقات وPlayground، قمنا ببناء وتحسين وقت تشغيل الاستدلال الخاص بنا.
الأوزان وسكريبت مرجعي لتشغيلها بنفسك موجودة عند huggingface.co/empiriolabsai/aplomb-1. يمكن أن تختلف إجابات السكريبت قليلا عن واجهات برمجة التطبيقات (API).
البحث والتقييم والاستخدام الشخصي والاستخدام الداخلي من قبل المنظمات التي لديها إيرادات سنوية تقل عن US$1 مليون مجانية بموجب ترخيص نموذج EmpirioLabs؛ استضافة Aplomb 1 كخدمة أو شحنها في منتج يباع للآخرين يتطلب ترخيصا تجاريا.
ابدأ
curl https://api.empiriolabs.ai/v1/decisions \ -H "التفويض: حامل $EMPIRIOLABS_API_KEY" \ -H "CONTENT-TYPE: application/json" \ -d '{ "model": "aplomb-1", "state": {"order": {"id": "B-44120", "status": "شحن", "دفع": "غير مدفوع"}}, "أسئلة": { "مدفوع": {"type": "noul", "تعليمات": "هل تم دفع الطلب B-44120؟", "امتناع": true}, "الناقل": {"type": "اختيار", "تعليمات": "أي شركة توصيل الطلب B-44120؟", "المعايير": {"UPS": null, "Fedex": null, "dhl": null}, "امتناع": true} } }'مدفوع يعود بثقة باللا. الناقل يعود بنشوة الامتناع عن التصويت احتمالية، لأن السجل لا يذكر اسم الناقل. المخطط الكامل، ومدخلات الوسائط، والحدود موجودة في دليل واجهات برمجة التطبيقات للقرارات. Aplomb 1 يقبل أيضا الطلبات بصيغ OpenAI وAnthropic وGemini، لذا يمكنك استدعاؤها من مجموعات SDKs الخاصة بهم؛ الدليل هو صيغ الدردشة يوضح القسم كيف يتطابق طلب الدردشة مع قرار. جرب ذلك بدون كود في الملعب.
شكر وتقدير
بنينا Aplomb 1 بمساعدة حزمة وكلاء الذكاء الاصطناعي لدينا عبر البيانات والتدريب والتقييم والنشر. شكرا لفريق Qwen على Qwen3.5 و Qwen3-Omni، اللذين يبني Aplomb 1 عليهما، وLambda على وحدات معالجة الرسومات التي دربناها وقدمناها عليها، ولبرنامج NVIDIA Inception، وبرنامج الشركات الناشئة Z.ai، وبرنامج StepFun لدعمهم.